
Pythonのリバースエンジニアリングでは、本格解析の前に小規模なPoC(概念実証)で対象の形態とツールの効き方を確かめます。対象の形態で工数が大きく変わるため、この工程が判断材料になります。
- PythonリバースエンジニアリングでPoCが必要な理由
- PoC・プロトタイプの進め方
- 機械学習パイプラインの再現性検証というPython固有のPoC
「まず小さく試してから決めたい」方に向けた内容です。全体像は次の記事にまとめています。
▼全体ガイドの記事
・Pythonのリバースエンジニアリングの完全ガイド
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
PythonリバースエンジニアリングでPoCが必要な理由
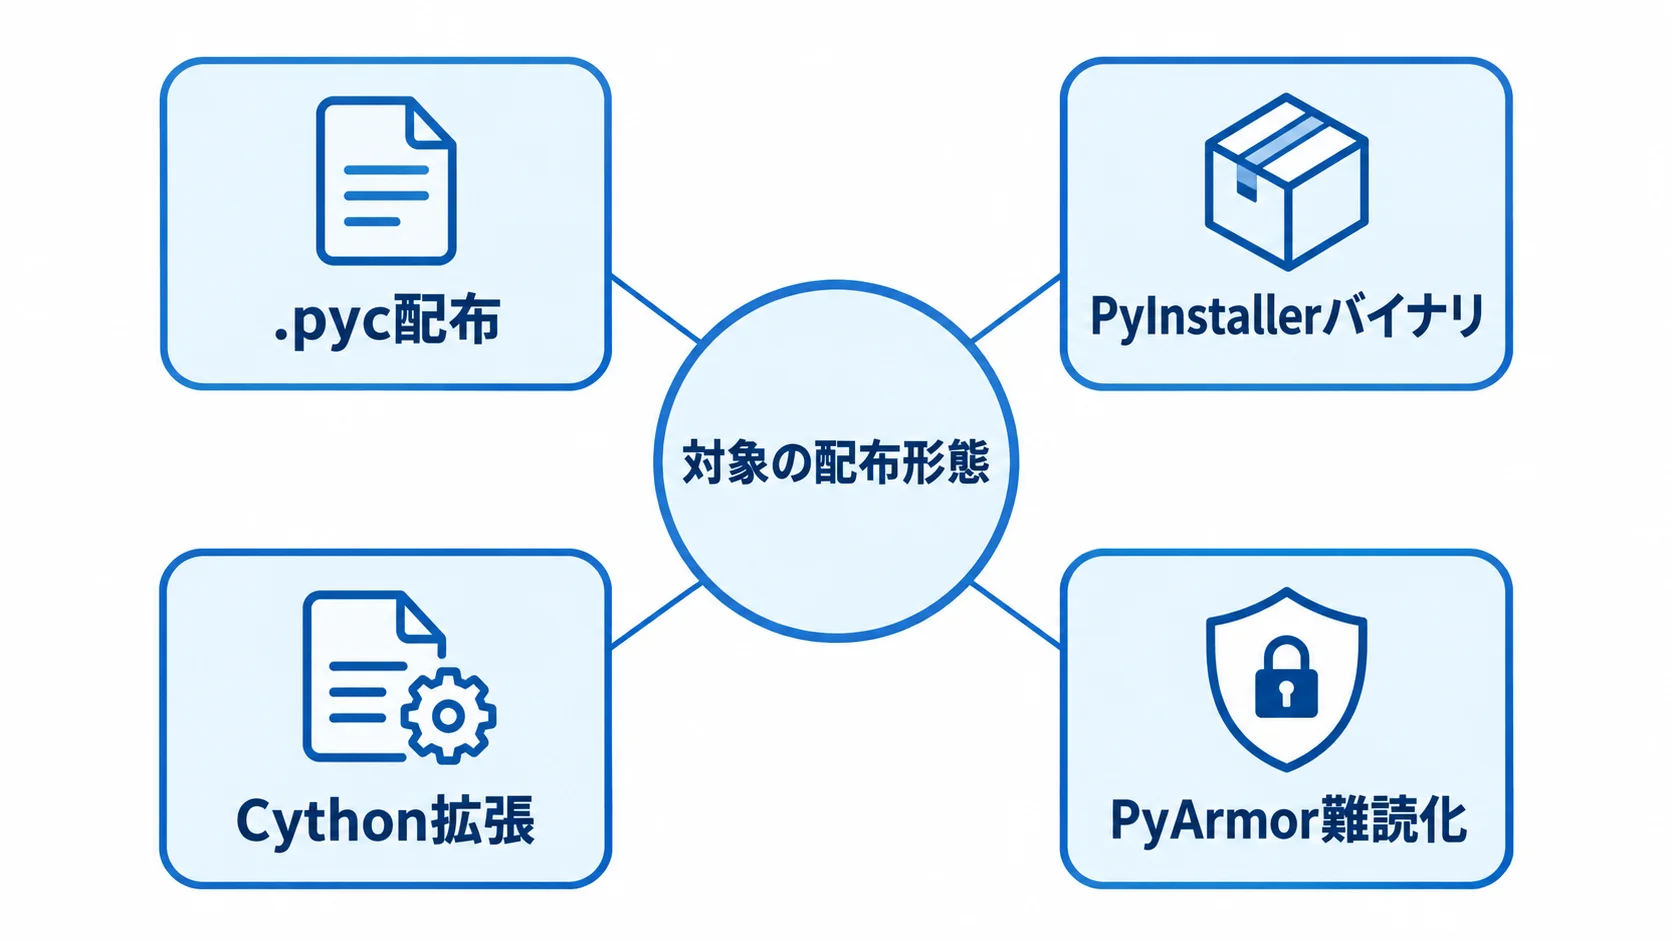
Pythonは「スクリプト言語だから解析は簡単だろう」と見くびられがちです。しかし実際には、.pyc配布、PyInstallerバイナリ、Cython拡張、PyArmor難読化のどの形態に当たるかで、必要な工数もツールも大きく変わります。
対象の形態を見極めないまま本格解析に全面着手すると、想定していなかった難読化や機械学習パイプラインの複雑さが途中で見つかり、当初の見積もりを大きく超えるおそれがあります。
対象システムの一部を使った小規模なPoCを先に行えば、本格着手の前にこうしたリスクを見極められます。
対象形態を見誤ったまま全面解析に踏み切るリスク
「.pyファイルがあるから読めるはず」と着手したら、難読化で変数名が意味のない文字列に置き換えられていたことがあります。eval/exec経由で文字列が動的に生成され、静的解析では処理を追えないことも珍しくありません。逆に、「.pycしかないので難しい」と身構えたら高精度に復元できたこともあります。どちらになるかは手を動かすまで分からず、この不確実性の大きさがPythonの特徴です。
また、発注側と受注側の間で「仕様書」という言葉のイメージが食い違うことも多いです。業務仕様書を期待していたのにフローチャートレベルの資料が納品される(あるいはその逆)というミスマッチも、典型的な失敗パターンです。
対象の配布形態は、プロジェクト開始時点では正確に分からないことが多いです。.pyと.pycの混在や一部のEXE化といった実態は、発注前のヒアリングだけでは把握しきれず、全ファイルの見積もりを取った後に発覚すると、契約範囲の再定義や追加費用の交渉で後ろ倒しになります。そのため、PoCの段階で実態のばらつきを洗い出すことが、後工程のトラブルを避ける最も確実な方法です。
PoCが果たす2つの役割(技術検証と合意形成)
PythonのリバースエンジニアリングにおけるPoCには、大きく分けて2つの役割があります。1つ目は「技術検証」です。対象の.pycを、対応するPythonバージョンの逆コンパイラでどこまで可読なコードに復元できるか、難読化やPyArmor保護がどれほど解析を妨げるかを、実際のファイルの一部で確かめます。
2つ目は「合意形成」です。出来上がりのサンプルを実際に確かめながら、「どこまで復元できれば十分か」というゴールのイメージを発注側と受注側で合わせます。機械学習パイプラインが対象の場合は、これに加えて「モデルの再現性」という3つ目の検証観点も必要になります。この3点を意識してPoCを設計すると、本格解析フェーズでの手戻りやトラブルを大幅に減らせます。
社内では、技術検証をIT部門・情シス部門が中心に評価する一方、合意形成の結果は業務部門や経営層への説明資料にも使えます。「小規模な投資でここまで復元できた」という実物は、本格解析の予算承認を得る材料としても説得力があります。特にPythonは機械学習パイプラインの解析に予算がかかりやすいため、PoCの結果を経営層に説明できるかを設計段階から意識しておくとよいでしょう。
PoC・プロトタイプの進め方
PoCを効果的に行うには、対象範囲の選び方とツールの検証方法を前もって設計しておく必要があります。
パイロットスクリプトの選定基準
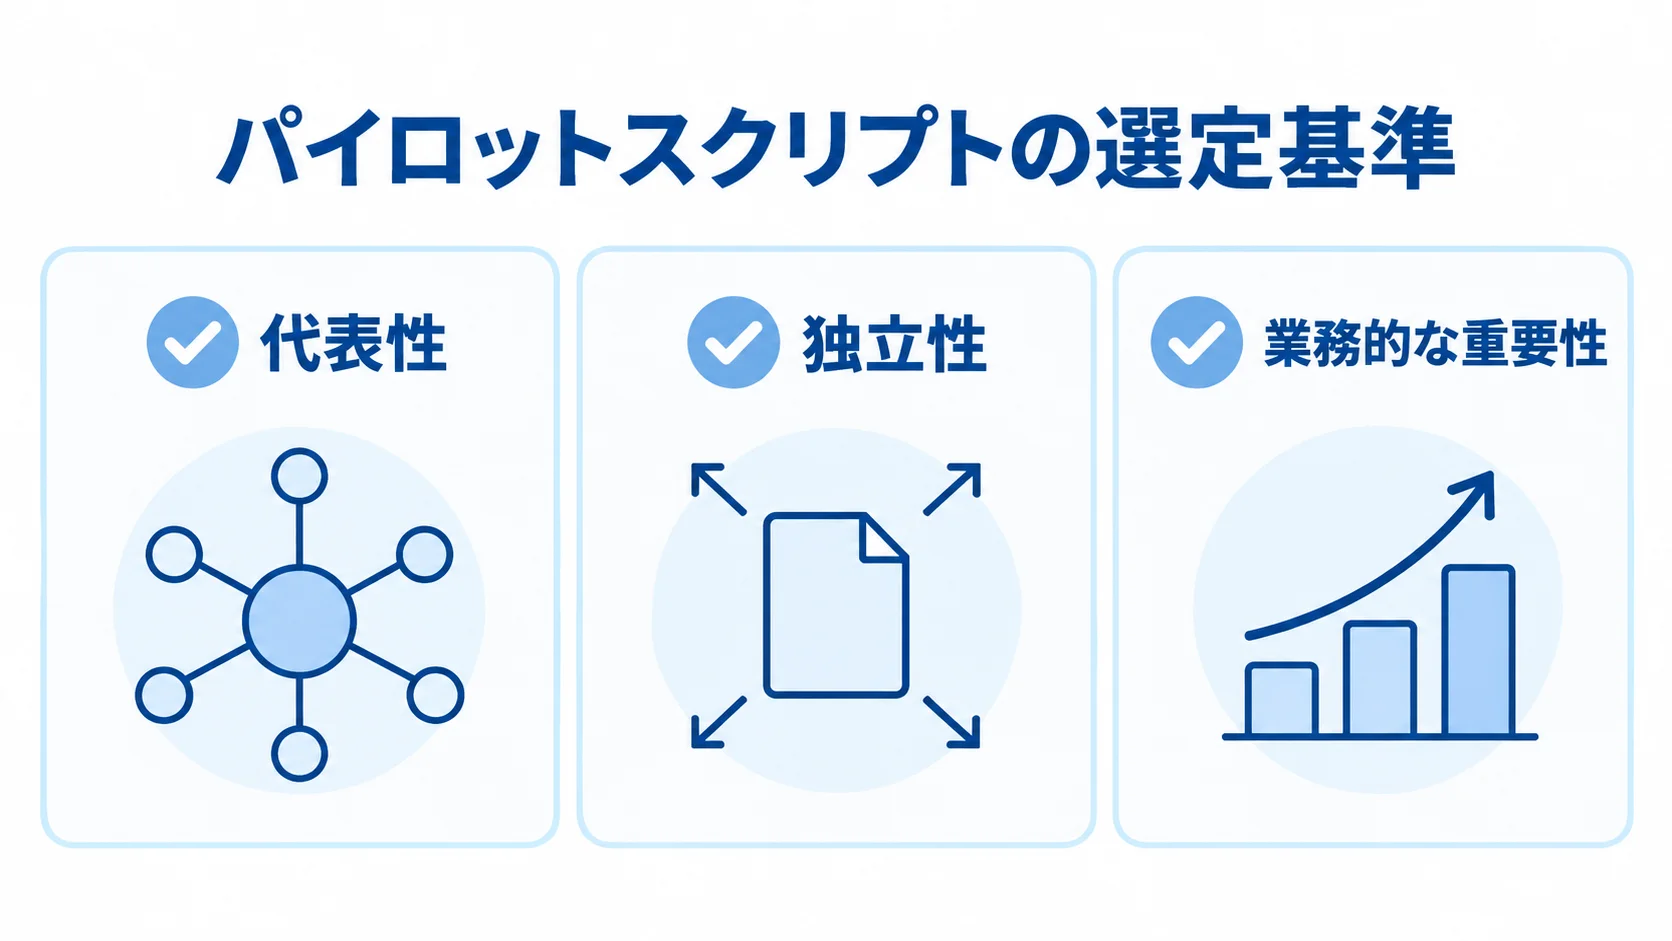
パイロットとして選ぶスクリプトは、明確な基準で決めておくことが大切です。1つ目の基準は「代表性」です。対象システム全体の技術的特徴(対象形態・難読化の有無・機械学習パイプラインの有無など)を代表する、典型的なファイルやモジュールを選びます。
2つ目は「独立性」で、他のモジュールへの依存が少なく単体で解析結果を評価しやすいものを選ぶと、検証結果を解釈しやすくなります。3つ目は「業務的な重要性」で、今後のモダナイゼーション計画で優先度が高いと想定される機能を選んでおくと、PoCの結果をそのまま本格解析の一部に活かせる場合もあります。
多くの場合、数ファイル程度、数百行から数千行規模のスクリプトがパイロットに選ばれます。
逆コンパイラ・解析ツールの精度検証
PoCの中核は、逆コンパイラ・解析ツールの精度検証です。.pycが対象であれば、対象のPythonバージョンを特定したうえで、uncompyle6(Python 2〜3.8対応)またはdecompile3(Python 3.9以降対応)を適用します。逆コンパイル結果の可読性と変数名の消失度合いを確認します。
PyInstaller製バイナリなら、pyinstxtractorでアンパックがどこまで成功するかを確かめます。Cython拡張であれば、GhidraやIDA Proで、どの程度の情報量を得られるかを検証します。PyArmor保護が疑われるなら、静的解析ではなく、sys.settraceやimportlibによる動的解析で実行時のバイトコードをどこまで捉えられるかを確認します。
パイロットで精度を確かめれば、本格解析の期間・費用の見積もり精度が高まります。無料ツールを先に試し、解読が難しい部分だけ商用・準商用ツールを使えば、費用対効果に優れます。高度なツールが要る対象は、必要性を見極めておくと、ライセンス費用と技術者の手配を精緻化できます。逆コンパイル結果を業務担当者に見せて理解できるかを確かめると、復元の精度に加えて実用性も早く分かります。
機械学習パイプラインの再現性検証というPython固有のPoC
COBOLやC言語のリバースエンジニアリングにはない、Python特有のPoCが、機械学習パイプラインの再現性検証です。
訓練済みモデル・特徴量エンジニアリングの復元可能性の確認
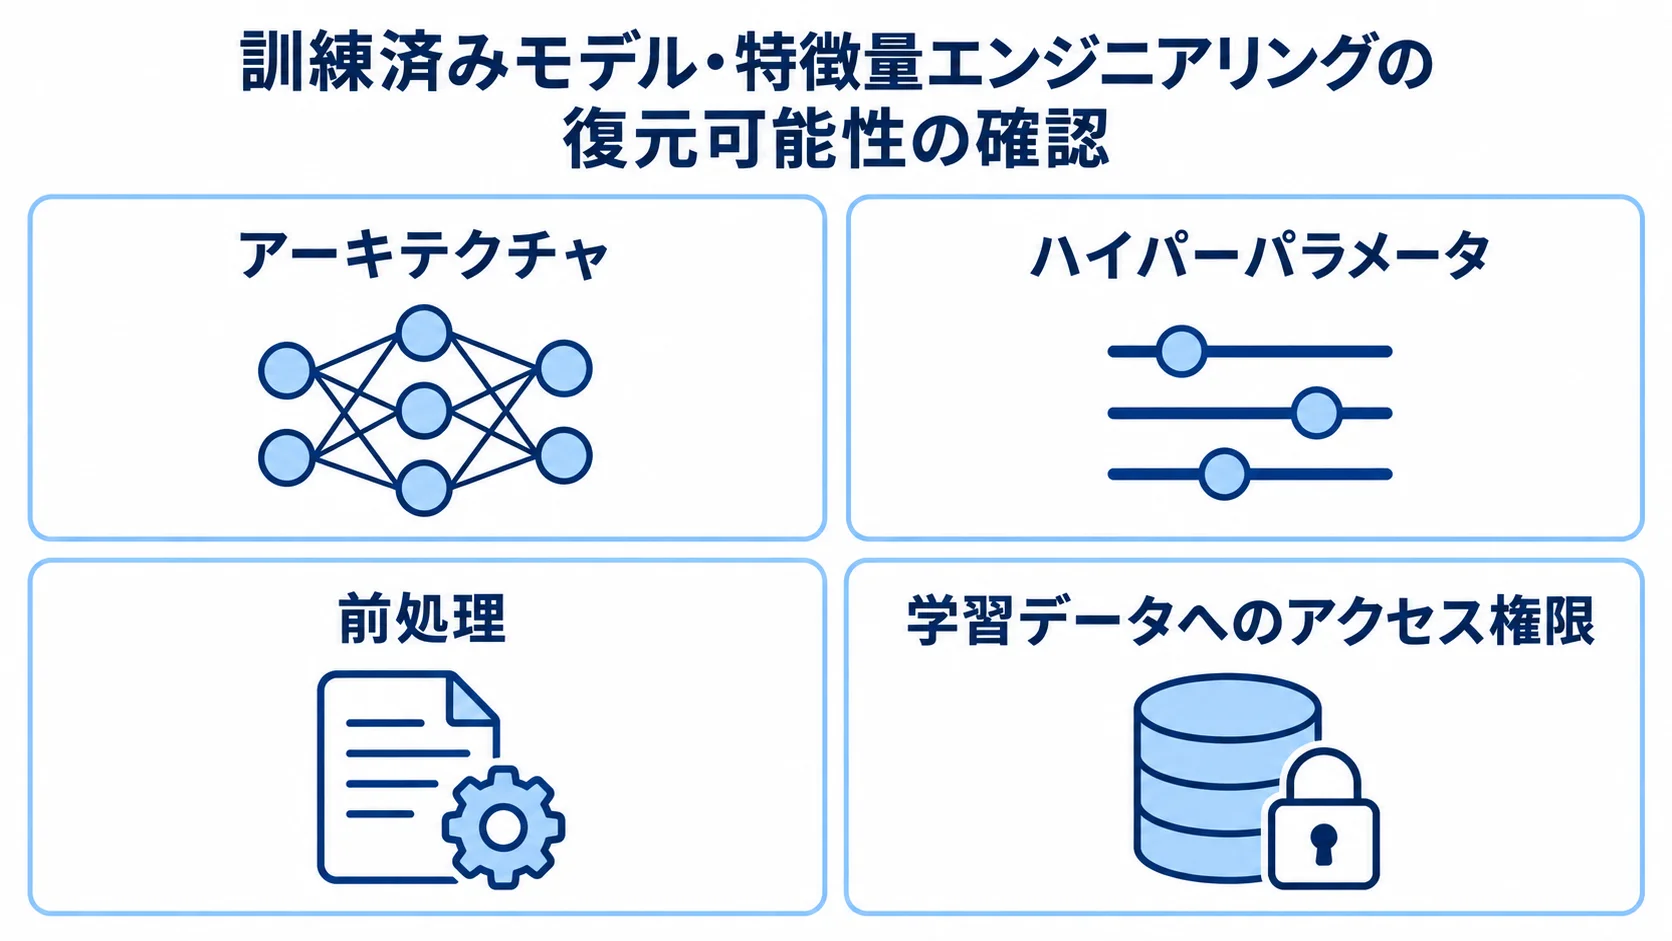
機械学習パイプラインを対象とするPoCでは、コードの逆コンパイルに加えて、訓練済みモデル(.pkl/.h5/.ptなど)からアーキテクチャやハイパーパラメータをどこまで読み出せるかを検証します。前処理や特徴量エンジニアリングの手順をどこまで文書に起こせるかも確かめます。
PyTorchのforward hookやTensorFlowのtf.functionラップで中間層の出力をトレースし、静的解析では分からない処理がどこまで補えるかを確認します。また、学習データやテストデータへのアクセス権限も、初期の段階で確かめる必要があります。コードや重みだけでは、どのデータで学習・検証されたか分からず、再現性の検証が不完全になります。
データサイエンティストの退職後にアクセス権限が失効していたり、データが別のストレージへ移っていたりすることも珍しくありません。PoCの初期段階でデータアクセスを確かめておけば、本格解析での手戻りを防げ、モデルの再現・改良・移植の見通しも本格着手前に得られます。Python2で学習したモデルをPython3で読み込めるか(pickleの互換性問題など)も、移行を見据えたPoCで検証すべき項目です。
仕様書モックアップによる仕上がりイメージのすり合わせ
技術検証と並行して大事なのが、「仕様書モックアップ」を試作して仕上がりのイメージを合わせることです。パイロットスクリプトに対して実際にモックアップを作ってもらえば、粒度・記法・図表の使い方を発注前に確かめられます。
機械学習パイプラインの場合は、モデルアーキテクチャ図と特徴量定義書のサンプルもモックアップに含めてもらうことが大切です。この確認を怠ると、本格解析が終わった後に「想定していた詳細度と違った」となり、追加の解析工数と費用が発生するリスクがあります。
「変数名をどの程度まで意味のある名称に復元できるか」「業務ロジックの背景(Why)をどう文書化するか」まで具体的に合わせておくと、後工程のトラブルを防げます。
PoCの期間・費用感とGo/No-Go判断
PoCは本格解析より小規模に設計するため、期間も費用も抑えられます。そのPoCの結果は、本格着手の可否を判断する材料にもなります。
期間・費用の目安
パイロットの規模にもよりますが、純粋な.pyファイルなら1〜2週間程度が目安です。PyInstaller・Cython・PyArmorの検証まで含めると2〜3週間程度、機械学習パイプラインの再現性検証まで含めると、さらに1〜2週間の余裕を見込むとよいでしょう。
費用は、LOC課金の基本料金レンジ(4,000行程度まで)に収まる規模なら、数万円〜数十万円程度で実施できることが多くなります。ベンダーによっては、PoCの解析結果を本格解析の一部として引き継ぎ、本格発注時の費用から充当してもらえるケースもあるため、提案段階で確認しておくと無駄なく本格着手へ移れます。
PoCの範囲は、小さすぎると対象形態の混在や機械学習パイプラインの有無が検証から漏れ、本格解析の見積もり精度が上がらないこともあります。広すぎると本格解析の前倒しになり、Go/No-Go判断を経ないまま費用だけが先行するリスクもあります。そこで、パイロットの代表性とのバランスを見ながら、対象システム全体の1〜3%程度を目安に設計するのが実務上の落としどころです。
本格着手の判断基準とフルスクラッチ切替の検討
本格着手は、まず逆コンパイラ・解析ツールがパイロットスクリプトに実用的な精度で動いたかを確認して判断します。次に、モックアップで示された粒度・品質が自社の目的に合っていたかを評価します。機械学習パイプラインが対象なら、モデルの再現性がどの程度得られたかも判断に加えます。
判断基準は着手前に明文化し、発注側と受注側で合意しておくとよいでしょう。逆コンパイル精度が著しく低く、手作業でも業務ロジックの意図をほとんど読み解けないと分かったときは、無理に続けず、要件定義からやり直すフルスクラッチ開発への切り替えを検討すべきです。業務ロジックの大半がすでに使われない古い仕様だった場合も、切り替えを考える場面です。
合格基準は、「業務担当者のレビューに耐える可読性か」「刷新・移行に必要な情報量を満たすか」などを、機械学習なら推論結果の許容誤差も含めて、数値や水準であらかじめ定めます。そうすれば、PoC後の判断が「なんとなく良さそうだから」で決まる事態を避けられます。判断に迷うときは、業務ロジックのうち新システムでも必要な機能の割合を試算し、判断材料にするとよいでしょう。
まとめ
PoCでは、技術検証と合意形成という2つの役割を果たします。パイロットの選び方とツールの精度検証、機械学習の再現性と仕様書モックアップによるすり合わせを経て、期間・費用感と本格着手の判断につなげます。
COBOLやC言語の解析であれば、工数見積もりの土台となる前提がある程度共有できます。一方、Pythonは対象形態のばらつきが大きいため、この小さく試す工程を省かないことが成功の分かれ目になります。
対象が.pyc・PyInstaller・Cython・PyArmorのどれに当たるかを見極めるため、まず1〜3週間程度の小規模なPoCで、技術的な実現可能性と完成のイメージを確かめます。この一手間が、全面解析に入ってからの手戻りやトラブルを大きく減らします。
PoCで得られた工数の実績とサンプルは、本格解析の見積もりを精度よくします。さらに、リバースエンジニアリングを続けるか、フルスクラッチ開発に切り替えるかを決める材料にもなります。
「どの形態でも同じ料金です」と説明するベンダーより、PoCで形態ごとの工数差を具体的に示すベンダーの方が、その後のプロジェクト運営でも信頼できる傾向があります。
Python特有の対象形態と機械学習パイプラインの解析実績があるパートナーと、まずは小さく試すところから始めるとよいでしょう。
▼全体ガイドの記事
・Pythonのリバースエンジニアリングの完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。