
Pythonのリバースエンジニアリングは、対象選定と目的の明確化から始め、解析環境の準備、静的解析、動的解析、抽象化、成果物化の6工程で進めるのが基本です。
Pythonは対象の形態によって解析の方法が変わるため、全体の流れと注意点を先に押さえておくと役立ちます。
▼全体ガイドの記事
・Pythonのリバースエンジニアリングの完全ガイド
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
- Python固有の特性と主な用途
- 対象選定から成果物化までの6工程
- 典型的な失敗、難読化、法的リスクへの対処
- 外注と内製の判断軸
Pythonのリバースエンジニアリングの概要
リバースエンジニアリングとは、既存のシステムやソフトウェアを解析して、内部構造・設計意図・業務ロジックを復元する技術的な作業です。
Pythonは他の言語と異なる固有の特性があるため、解析のアプローチも変わります。まずは基本的な考え方と適用場面を理解しておくことが大切です。
他言語との違い・Python固有の特性
Pythonはスクリプト言語のため、通常は.pyファイルとしてソースコードが読める状態で配布されます。この点は、COBOLやC言語のバイナリ解析とは根本的に異なります。しかし実際には、PyInstallerやPy2exe、cx_Freezeなどで単一の実行ファイル(EXE)にパッケージングされた状態で配布されることが多く、その場合はバイナリ解析が必要になります。
Cythonでコンパイルされた.soや.pydファイルは、実質的にC拡張モジュールとなるため、逆コンパイルは困難を極めます。一方で、.pyではなく.pyc(バイトコード)だけが配布されているケースでは、uncompyle6やdecompile3などのバイトコード逆コンパイルツールが有効です。
.pycは、C#やJavaの中間言語(IL/バイトコード)と同様に、比較的高い精度で元のソースに近い形まで復元できます。ただし、変数名の一部は失われ、コメントも欠落することは避けられません。難易度は対象の形態によって大きく異なるため、最初に把握しておく必要があります。
主な用途(レガシー移行・脆弱性診断・仕様書復元)
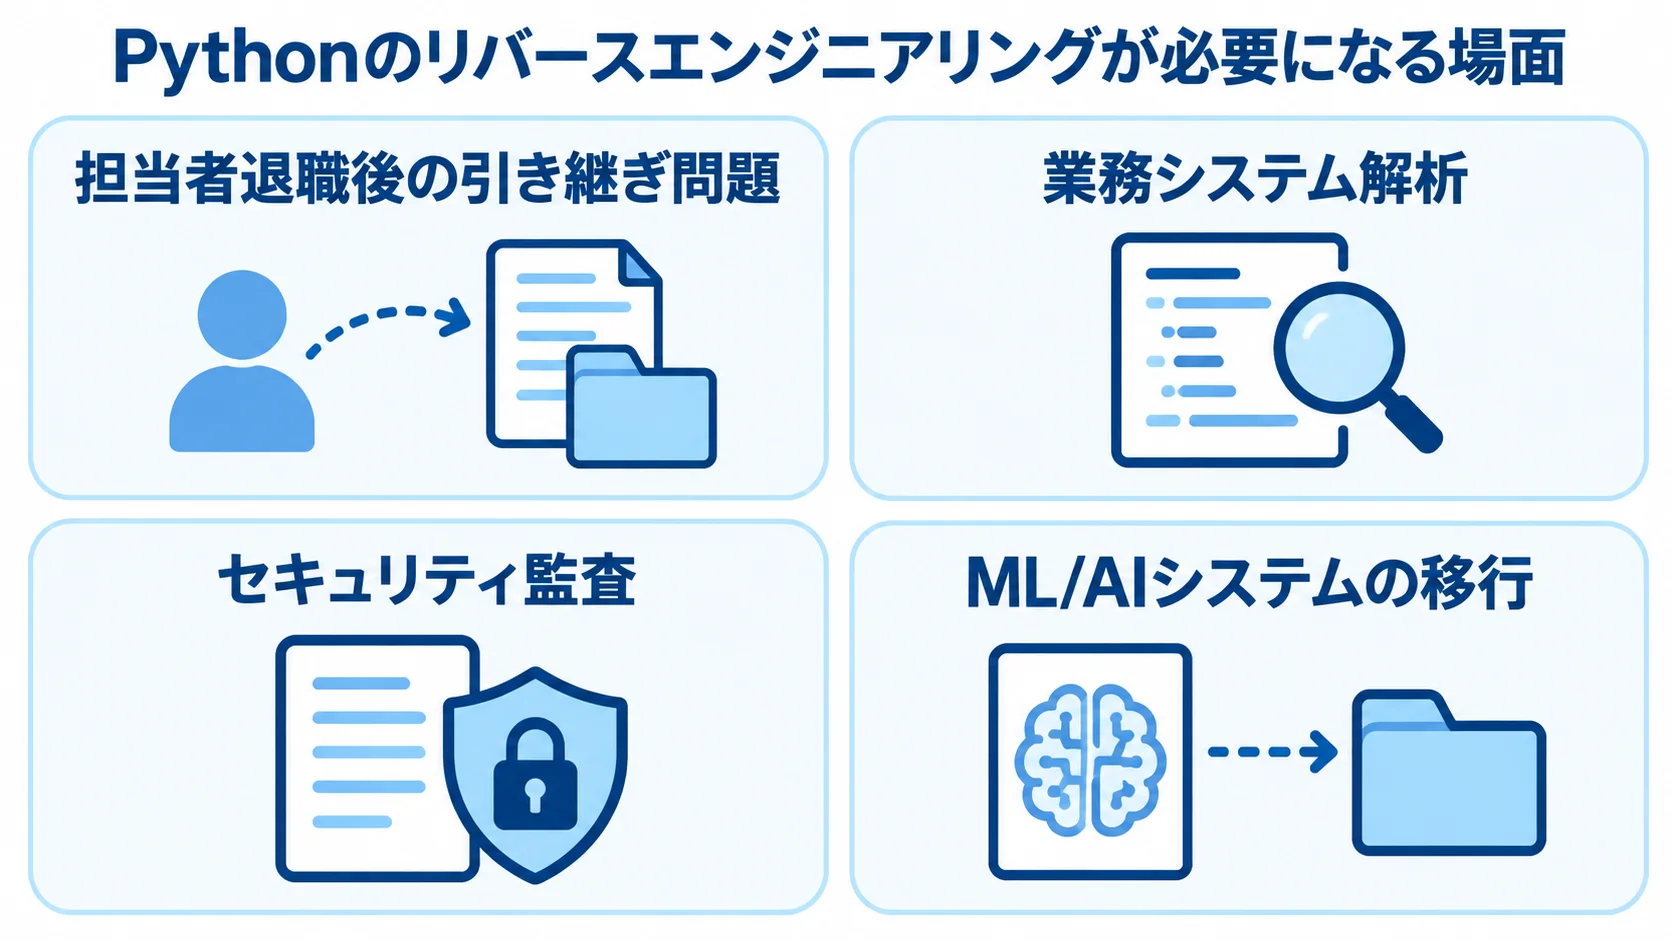
Pythonのリバースエンジニアリングが必要になる場面は、大きく4つに分けられます。
- 担当者退職後の引き継ぎ問題:データサイエンティストや自動化スクリプトの担当者が退職し、引き継ぎ資料がないまま業務用Pythonスクリプトが残されてしまいます。
- 業務システム解析:PyInstallerでパッケージングされた社内ツールの内部ロジックを復元する用途です。
- セキュリティ監査:セキュリティ診断の一環として、Python製Webアプリや自動化スクリプトの脆弱性を洗い出します。
- ML/AIシステムの移行:AIモデルや機械学習パイプラインのコードを解析して、モデルの学習ロジックを再現・移植する用途が、新しく増えています。
特にMLOpsの現場では、Jupyter Notebookや実験スクリプトから本番パイプラインを再構築する必要が生じるケースが多く、Pythonリバースエンジニアリングの重要性は高まっています。
Pythonのリバースエンジニアリングの6工程
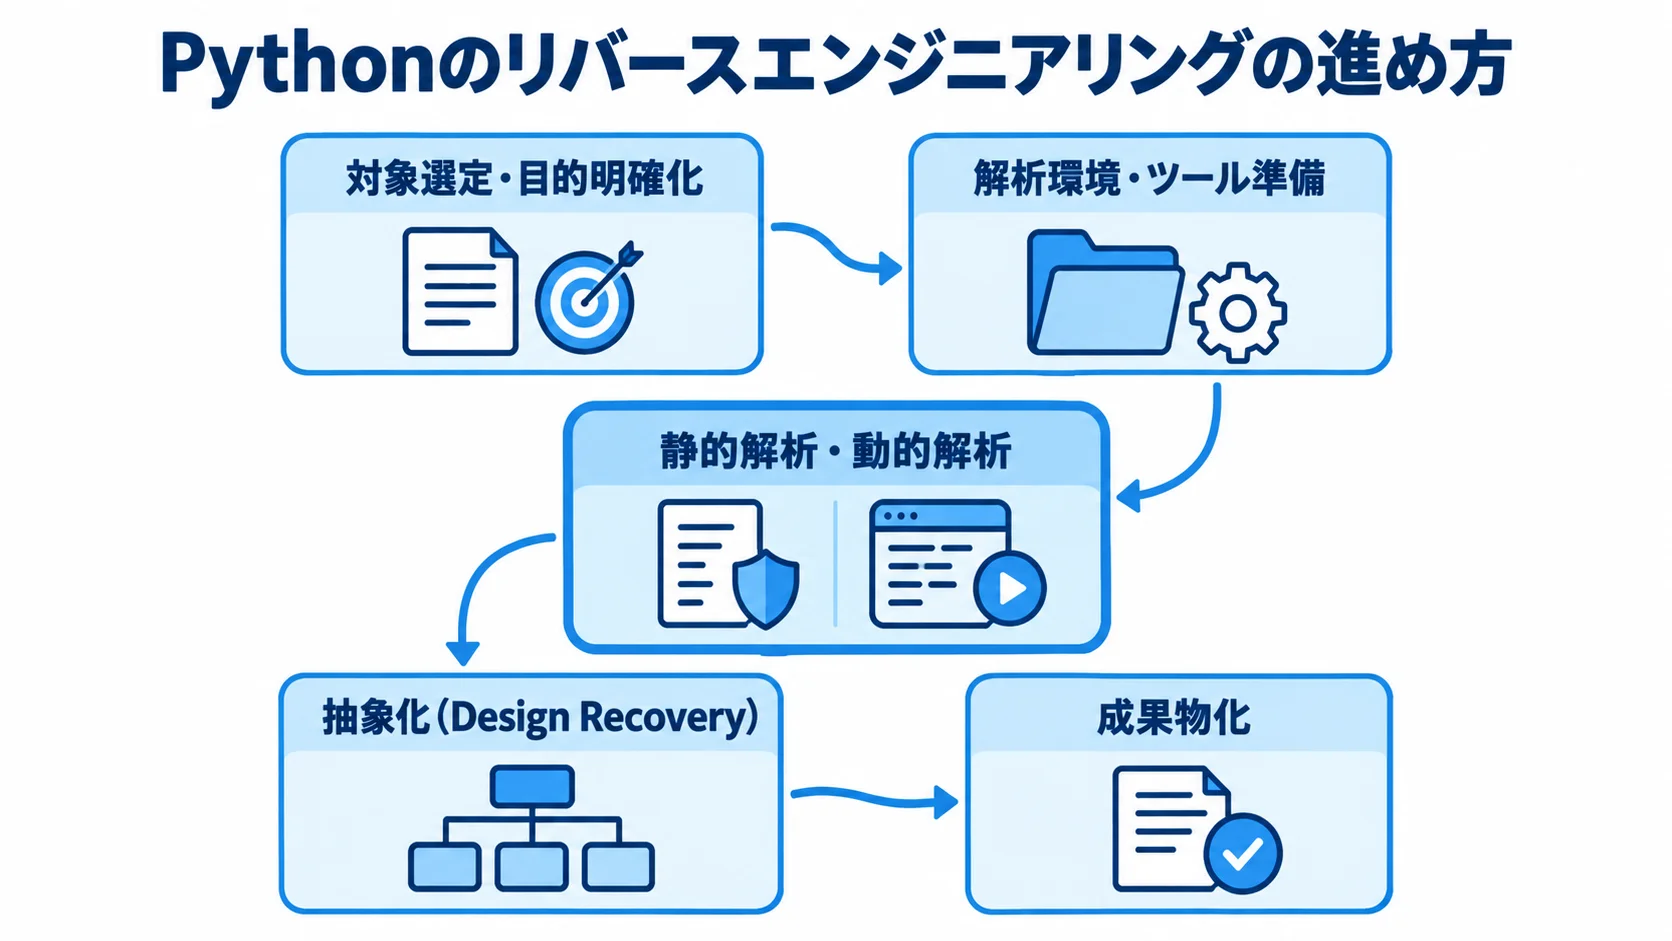
Pythonのリバースエンジニアリングは、場当たり的に進めると途中で方向を見失いやすく、成果物の品質も担保しにくくなります。そこで、この6工程に沿って進めると、解析の抜け漏れを防ぎ、後工程の開発に使える成果物を得やすくなります。
工程1:対象選定・目的明確化
最初の工程では、解析対象のPythonシステムを正確に特定し、リバースエンジニアリングの目的を書面で明確にします。目的が「業務仕様書の復元」なのか、「セキュリティ脆弱性の発見」なのか、「モダナイゼーション(新システムへの移行)のための設計情報取得」なのかで、後続工程の解析の深さや成果物の形式が変わります。
対象のPythonバージョン、依存ライブラリ、実行形態(純粋.py / .pyc / PyInstallerバイナリ / Cython拡張)は、着手前に洗い出しておきます。PyInstaller製EXEファイルが対象の場合は、まずpyinstxtractorでアーカイブをアンパックし、.pycファイルを取り出す前処理が必要になります。
この段階で対象の全ファイル一覧と依存関係を整理しておくと、工程2以降の作業がスムーズに進みます。
工程2:解析環境・ツール準備(Python特化ツール)
解析に使うツールは対象の形態によって変わります。.pycファイルの逆コンパイルには、uncompyle6(Python 2〜3.8対応)かdecompile3(Python 3.9以降対応)が定番です。PyInstallerバイナリの場合は、pyinstxtractorでEXEを解凍して.pycを取り出し、そのうえで逆コンパイルします。
バイナリ全体の構造解析にはBinwalkを、制御フローの解析や難読化済みコードの解読にはGhidraやIDA Proを使います。動的解析には、Pythonデバッガ(pdb / pdbpp)やWireshark(ネットワーク通信解析)を活用します。また、解析環境はインターネット非接続の隔離環境を用意し、解析専用マシンで行うことが法的観点からも推奨されます。
Belkin N300ルーターのファームウェアダンプ事例では、UARTインターフェース経由のアクセスをPythonスクリプトで4,096バイト×512回に分けて行い、一度に大量転送するとクラッシュする制限を避けました。その結果、約2時間で200万バイト全量のプレーンテキスト化に成功しています。
工程3:静的解析(逆コンパイル・逆アセンブル)
静的解析では、システムを実行せずにコードの構造を分析します。.pyファイルが入手できていれば、まずAST(抽象構文木)解析で、クラス・関数・モジュールの依存関係を把握します。.pycファイルの場合は、disモジュールでバイトコードを逆アセンブルし、uncompyle6などで可読なPythonコードに逆コンパイルします。
PyInstallerバイナリの場合は、pyinstxtractorでアーカイブをアンパックすると、メインの.pycとともにすべての依存.pycが展開されます。展開後は、各.pycを個別に逆コンパイルし、import関係を整理してモジュール構造を再構築します。
Cython拡張(.so / .pyd)は、Ghidraの逆コンパイラでC言語レベルのコードを確認します。そのうえで、Python APIとの境界部分(PyArg_ParseTuple等の呼び出し)を手がかりに、引数・戻り値の型と処理内容を推定します。また、変数名の一部はgen_varなどの汎用名に置き換えられていることがあり、その場合は前後の処理内容から命名を補います。
工程4:動的解析(デバッガ・実行トレース)
動的解析では、実際にシステムを実行しながら、その振る舞いを観察します。主なアプローチは、Pythonのpdbデバッガ、ptraceを使ったシステムコール追跡(straceコマンド)、Wiresharkによるネットワーク通信解析です。
難読化されたコードでも、実行時にメモリ上で展開された実際の値を観察すれば、静的解析では分からなかった処理内容を把握できます。特に機械学習パイプラインの解析では、モデルのforwardパス(推論処理)をフックして中間層の出力を記録する手法が有効です。
PyTorchではforward hookを、TensorFlowではtf.functionをwrapしてトレースすることで、学習ロジックの詳細を把握できます。動的解析の結果は静的解析の結果と突き合わせると、解析精度が大幅に向上します。実行ログ、通信ログ、メモリダンプは、後の成果物化でも重要な根拠資料となるため、必ず記録しておきます。
工程5:抽象化(Design Recovery:実装→設計→仕様)
静的・動的解析で得た情報をもとに、実装レベルのコードから設計レベルの情報(クラス図・シーケンス図・データフロー図)、さらに仕様レベルの情報(業務フロー・ユースケース)へと段階的に抽象化します。このDesign Recoveryこそが、リバースエンジニアリングで最も価値を生む工程です。
Pythonシステムの場合、コードからは「How(どう動くか)」が分かりますが、「Why(なぜその実装になっているか)」は当時の担当者にしか分かりません。そのため、データサイエンティストや自動化スクリプトの担当者が退職した後の引き継ぎ問題では、この「Why」の欠落が最大のリスクです。
抽象化の工程では、解析を担当する側が業務部門の担当者にインタビューを行い、「コードからは読み取れないが業務上重要な制約や例外処理の背景」を補うことが必須です。この工程を省くと、復元した仕様書が不完全なまま新システムの開発に進み、本番稼働後に業務ルール違反のバグが多発するリスクがあります。
工程6:成果物化(仕様書・新システム設計)
最終工程では、解析と抽象化の結果を具体的な成果物にまとめます。成果物の粒度は目的によって変わり、「フローチャート」「業務仕様書(画面遷移図・DB設計含む)」「詳細設計書(新システム開発に直接使えるレベル)」の3段階が一般的です。
粒度が上がるにつれてコストと期間は増えますが、後工程の開発効率も大幅に向上します。Pythonシステムでは、SphinxやpdocなどでAPIドキュメントを自動生成し、そこに業務ロジックの背景(Why)を手作業で付記するのが効率的です。
機械学習パイプラインの場合は、モデルアーキテクチャ図、特徴量エンジニアリングの手順、評価指標の定義も成果物に含める必要があります。成果物は、元の担当者や業務部門の有識者がレビューして解析内容の正確性を確かめ、そのうえで最終版を確定します。
Python固有の注意点と典型的な失敗パターン
Pythonのリバースエンジニアリングには、他の言語にはない固有の落とし穴があります。「Pythonはスクリプト言語だから簡単に解析できる」という先入観が、最も大きな危険です。
典型的な失敗パターン
最も多い失敗は、「コードは読めたが業務ルールの意図が分からず、移行後にバグが多発した」というケースです。Pythonの自動化スクリプトや機械学習パイプラインには、当時の担当者が暗黙知として持っていた特殊なデータ処理ルールが埋め込まれていることが多くあります。たとえば、特定顧客への例外処理や季節性を考慮した分岐条件などは、コードから処理は追えても、ビジネス背景は見えてきません。
次に多い失敗は、「Pythonバージョンの違いによる逆コンパイル失敗」です。uncompyle6はPython 3.9以降の.pycに対応していないため、新しいバージョンのバイトコードには別ツール(decompile3)を使う必要があります。
Pythonのマイナーバージョンが変わるだけでバイトコードのオペコードが変わることもあり、逆コンパイラのバージョン選定を誤ると不完全なコードしか得られません。また、PyInstaller 4.x以降ではアーカイブ形式が変わっているため、古いpyinstxtractorでは正しくアンパックできない場合があります。
難読化・暗号化への対処
Pythonの難読化には、変数名や関数名を意味のない文字列に置き換える方法(例:l1I0O形式)、eval/exec経由で文字列を動的に生成する方法、PyArmorによるバイトコードの暗号化があります。PyArmorは.pyファイルをランタイム暗号化し、専用のbootstrap loader経由でのみ実行できるようにするため、静的解析だけでは解読が非常に困難です。
PyArmorで保護されたコードへは、動的解析(メモリダンプ・実行時フック)で対処するのが主な方法です。具体的には、Pythonランタイムのフック機構(sys.settrace、importlib等)を活用し、実行時に展開されたバイトコードをキャプチャする手法が有効です。ただし、これらの手法は法的・倫理的な観点から、自社システムの解析や正当な権限のある範囲内でのみ実施することが前提です。
難読化解除の工数は、通常の解析の2〜5倍になることが多いです。そのため、見積もりの段階で難読化の有無を確かめ、コストを適切に見込むことが重要です。
法的リスクの回避とコンプライアンス
リバースエンジニアリングは、適切な目的と手続きのもとで行えば合法です。ただし、対象・目的・手法によっては、著作権法、不正競争防止法、EULAの違反リスクがあります。
クリーンルーム手法の実務
平成30年の著作権法改正(第30条の4)により、マルウェア解析、セキュリティ調査、仕様書復元などの「非享受目的」のリバースエンジニアリングは、原則として合法とされています。ただし、競合他社のシステムを解析して同等の製品を開発するような「享受目的」は、引き続き違法です。
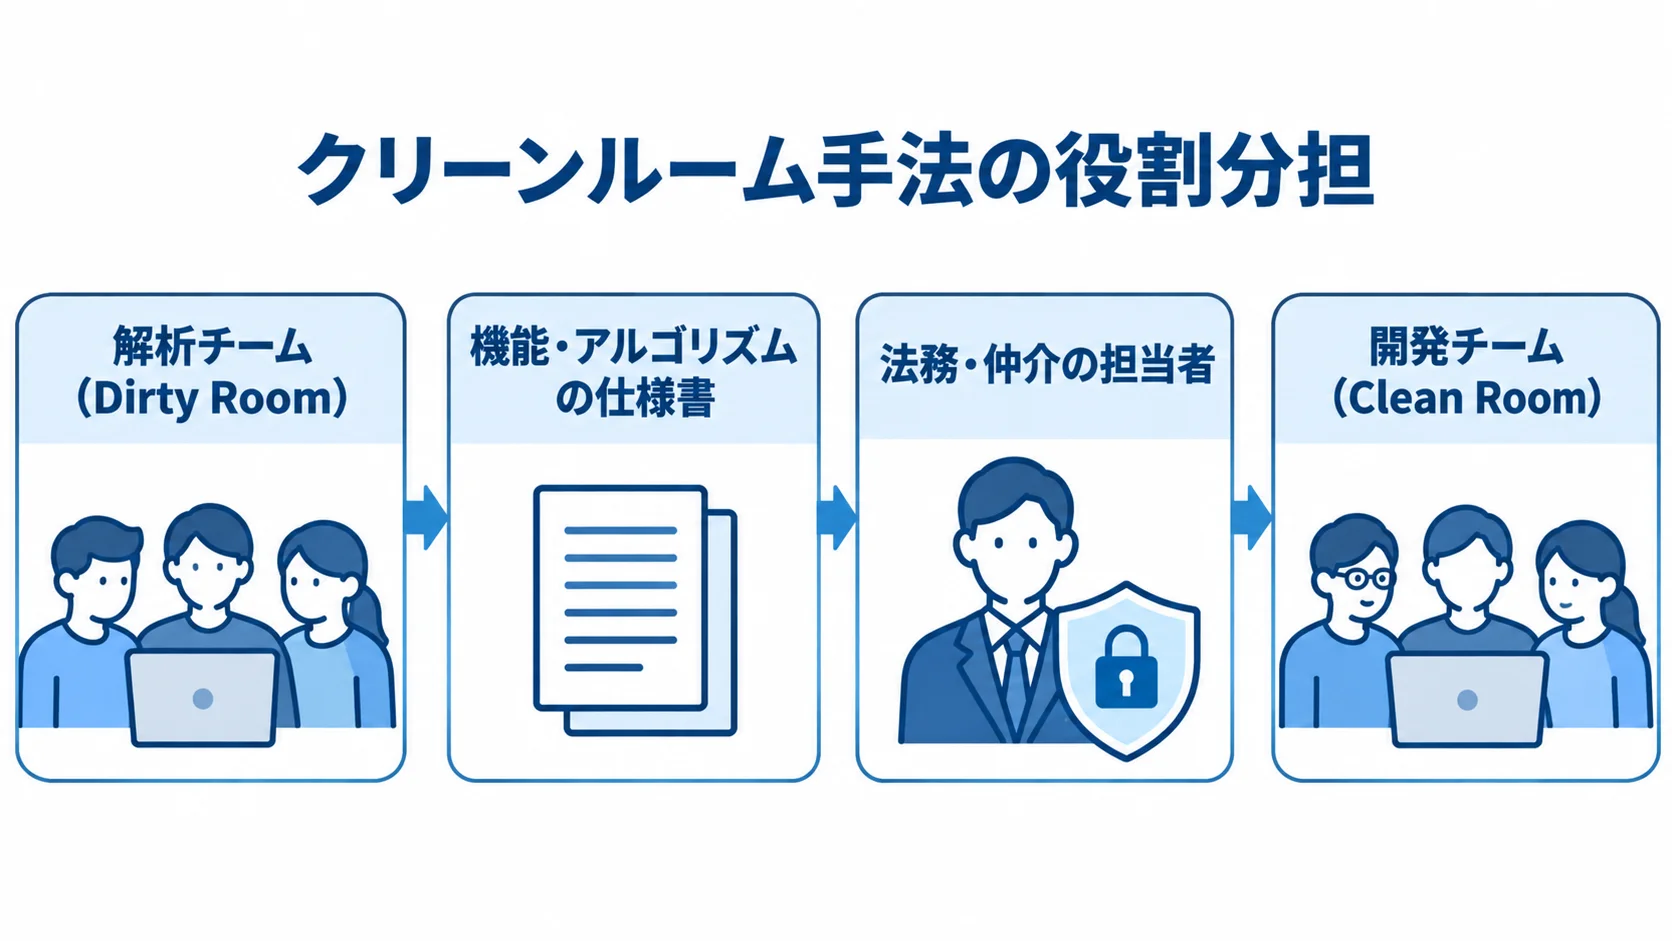
著作権侵害のリスクを完全に避けるには、「クリーンルーム手法」が有効です。解析チーム(Dirty Room)と開発チーム(Clean Room)を完全に分離し、解析チームが作成した「機能・アルゴリズムの仕様書」のみを開発チームに渡します。両チームの間に法務・仲介の担当者を置き、仕様書に著作権保護対象の「表現」が混入していないかを確かめる仕組みを設けることが欠かせません。
この手法は、フェニックス・テクノロジーズ vs IBM BIOS事件(1980年代)で確立された実績ある手法で、現代でも大規模なリバースエンジニアリングのプロジェクトで採用されています。
非享受目的の立証方法と記録管理
「非享受目的」であることを事後に立証するには、解析過程を詳細に記録しておくことが不可欠です。具体的には、解析専用のパソコン(本番環境・ネットワークから隔離)で作業します。解析の各工程でレポートを作成して保管し、解析の目的・依頼元・成果物の用途を書面で明確にしておくことも求められます。
EULAに禁止条項がある場合でも、互換性の確保のためにリバースエンジニアリングが欠かせないときは、その禁止条項自体が無効となる可能性があります。さらに、禁止条項が独占禁止法上の「不公正な取引方法(拘束条件付取引)」に当たる場合も、無効となることがあります。
ただし、この判断には個別の法律専門家への相談が必須であり、プロジェクトを始める前に法的な見解を取得しておくことを強くお勧めします。
外注 vs 内製の判断軸
Pythonのリバースエンジニアリングを外注するか内製するかは、対象システムの複雑さや社内の技術力に加えて、セキュリティ要件とコストのバランスを見て判断します。それぞれのメリットとデメリットを正しく押さえたうえで選ぶことが大切です。
外注が適しているケース
外注が適しているのは、PyInstallerバイナリや難読化済みコードなど技術的難易度が高い場合や、解析結果に品質保証が必要な場合です。また、機密性の高いシステムでクリーンルーム手法を運用できる体制が社内にない場合や、期限が短く専門知識を持つ社内エンジニアを割けない場合も、外注を選ぶ理由になります。外注する場合は、NDAを締結し、解析方法と成果物の品質水準をRFPに明記することが重要です。
外注費用の相場は、対象のコード規模と解析深度によって異なります。基本的なソースコード解析による仕様書復元の場合は、4,000行まで約30万円で、超過分は1行あたり50円が目安です。
例えば、API連携システムの仕様復元が約50万円、複雑な在庫予約システムが約80万円という実績があります。難読化解除や動的解析が必要な場合は、これに追加の工数が発生します。
内製が適しているケース
内製が適しているのは、解析対象が純粋な.pyで技術的難易度が低い場合や、機密情報を含み社外に出せない場合です。また、社内にPython上級エンジニアがいて解析ノウハウがある場合も、内製の選択肢になります。ただし、社内で行う場合も、解析専用環境の構築、解析過程の記録、業務部門への確認は省略してはいけません。
内製のリスクとして多いのは、「自分たちで解析できると思っていたが、予想以上に難しくて時間がかかった」という工数超過です。特に、当初は純粋な.pyだと思っていたシステムが、実際にはPyInstaller+PyArmorで保護されていた場合は、工数が10倍以上になることもあります。
着手前に対象システムの実態を正確につかみ、難易度が高ければ外注に迷わず切り替えることが大切です。
まとめ
Pythonのリバースエンジニアリングは、スクリプト言語だから簡単だと思われがちです。しかし、対象の形態は.pyc、PyInstaller、Cythonなどのほか、PyArmorによる保護もあり、それぞれに適したツールとアプローチが必要です。また、用途も担当者退職後の引き継ぎ、PyInstaller製バイナリの解析、機械学習パイプラインの移行など多岐にわたります。
うまく進めるには、対象選定と目的の明確化から始まる6工程を体系的にたどることが欠かせません。特に抽象化(Design Recovery)では、業務部門の知見を取り入れながら「Why」を補うことが大切です。
法的リスクについては、著作権法第30条の4に基づく非享受目的の立証と、クリーンルーム手法によるプロセスの分離を徹底してください。また、技術的な難易度や社内の人材の状況に応じて外注と内製を組み合わせることで、コストとリスクのバランスをとることができます。
Pythonシステムのリバースエンジニアリングに不安がある方は、まず専門会社への無料相談から始めることをお勧めします。
▼全体ガイドの記事
・Pythonのリバースエンジニアリングの完全ガイド
開発を相談する前に、【2026年最新版】AI駆動開発の完全ガイドブックをご活用ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。