
Reactのリバースエンジニアリングは、対象選定、解析環境の準備、静的解析、動的解析、抽象化、成果物化の6工程を順に進めるのが基本です。
JavaScriptやTypeScriptのフロントエンドは本番環境で難読化されて配布されるため、COBOLやJavaとは異なる難しさがあります。
▼全体ガイドの記事
・Reactのリバースエンジニアリングの完全ガイド
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
Reactのリバースエンジニアリングの概要
リバースエンジニアリングとは、既存のシステムやソフトウェアを解析し、その内部構造・設計思想・業務ロジックを明らかにする手法です。Reactの場合は、JavaScriptまたはTypeScriptで作られたシングルページアプリケーション(SPA)を対象とします。コンポーネント構成、状態管理の仕組み、API通信のデータ構造など、フロントエンド固有の要素を体系的に解析します。
設計書やソースコードが失われたシステムの仕様復元、セキュリティ診断、モダナイゼーションの前段階調査など、さまざまな目的で活用されています。
他言語との違い・React固有の特性
COBOLやJavaなどのサーバーサイド言語と比べると、Reactには大きな違いがあります。最も大きな特徴は、本番環境ではWebpackなどのバンドラーによって、ソースコードが難読化・圧縮された状態で配布される点です。
ソースマップ(.mapファイル)が公開されていれば、元のソースコードへ逆マッピングできます。ただし、本番ビルドではセキュリティ上の理由から、ソースマップは通常無効化されています。そのため、ブラウザのDevToolsで難読化されたバンドルファイルを直接読み解く必要があり、解析の難度が大幅に上がります。
Reactはフロントエンド重視のため、「UI設計の意図」の復元がビジネス観点で非常に重要になります。COBOLでは業務ロジックがサーバー側に集中していますが、Reactでは、表示条件、ユーザー操作の処理、状態遷移のルールなど、フロントエンドに分散した業務ロジックを一つひとつ読み解く必要があります。これはバックエンド中心のシステムとは異なる、React固有の難しさです。
主な用途(レガシー移行/脆弱性診断/仕様書復元)
Reactのリバースエンジニアリングは、大きく3つの場面で使われます。1つ目はレガシーシステムの移行です。古いReactバージョン(React 15以前など)や依存ライブラリが老朽化し、セキュリティリスクやパフォーマンス問題が起きているシステムは、現代的なReact(18以降)やNext.jsへの移行対象になります。
移行では、既存の設計を解析して移行計画を立てます。2つ目は脆弱性診断・セキュリティ監査です。APIエンドポイントや認証フローの実装を解析し、セキュリティ上の問題点を特定します。
3つ目は仕様書復元・ドキュメント化です。開発会社が撤退した後や、長期間メンテナンスが放置されたシステムでは、内部仕様を文書化して、後継の開発チームが引き継げる状態にします。
Reactのリバースエンジニアリングの6工程
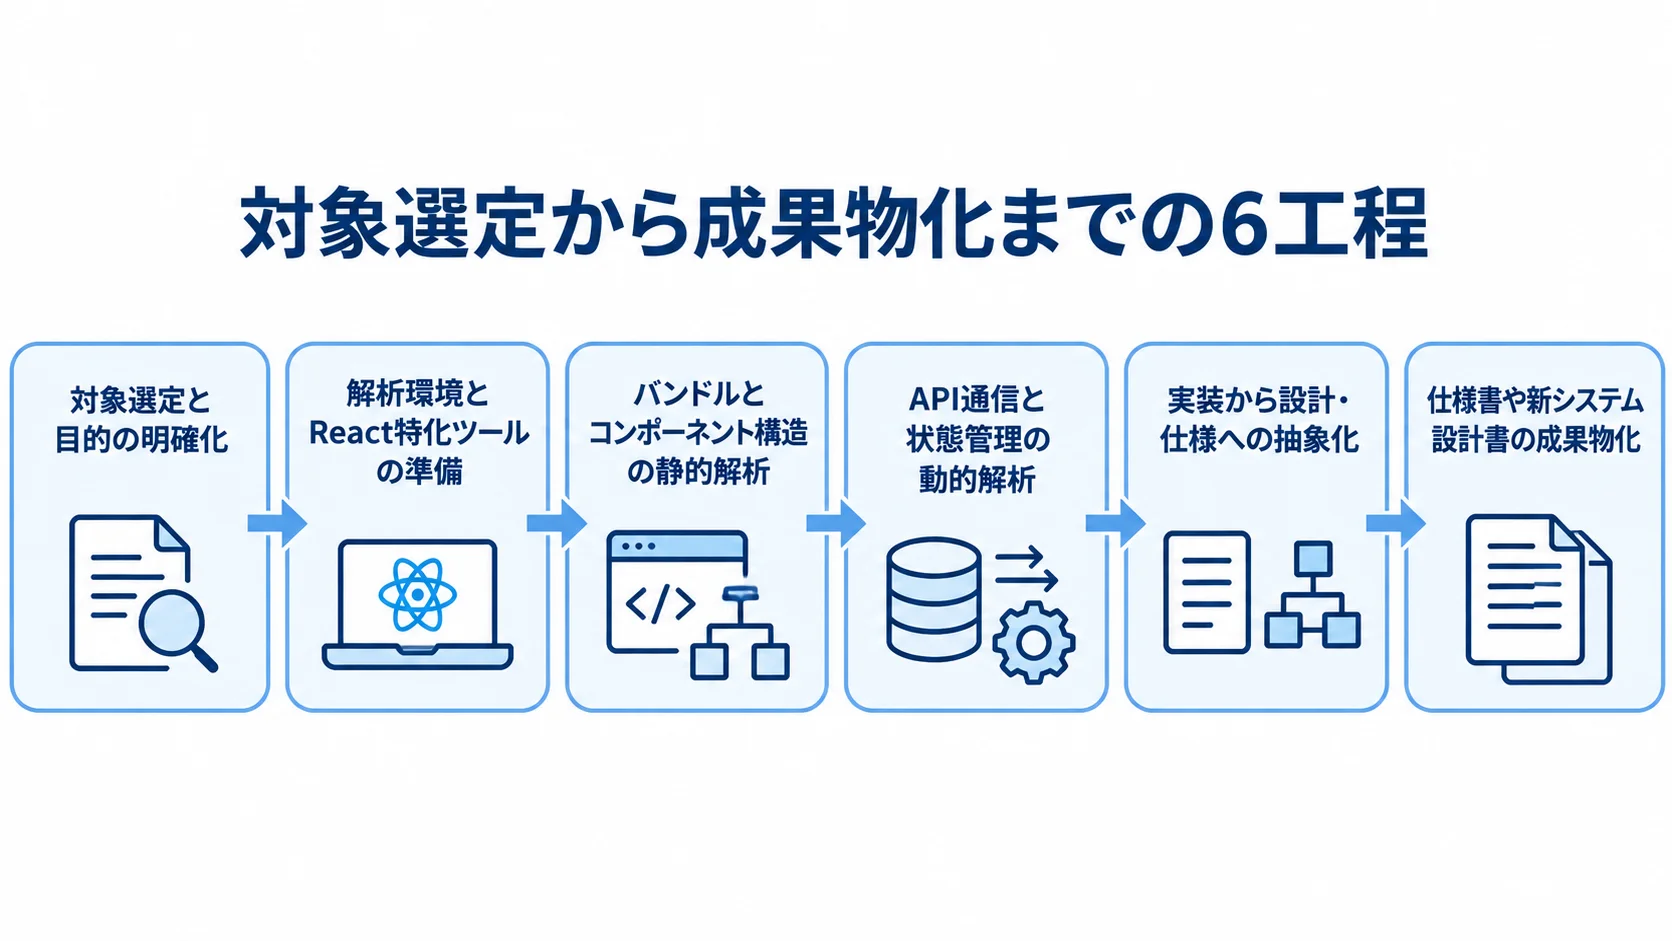
Reactのリバースエンジニアリングは、明確な工程に沿って進めることで、品質と効率を両立できます。実務では、対象選定から成果物化まで6つの工程で進めます。
- 工程1:対象選定と目的の明確化
- 工程2:解析環境とReact特化ツールの準備
- 工程3:バンドルとコンポーネント構造の静的解析
- 工程4:API通信と状態管理の動的解析
- 工程5:実装から設計・仕様への抽象化
- 工程6:仕様書や新システム設計書の成果物化
各工程を省略すると、後の工程で手戻りが増えます。そのため、順序を守って進めます。
工程1:対象選定・目的明確化
最初の工程では、対象範囲と目的を明確にします。目的が「システム全体の仕様を復元したい」なのか、「決済処理・認証フローなど特定の機能だけを解析したい」なのか、「セキュリティ診断として脆弱性を特定したい」なのかで、解析の深さと必要なリソースが大きく変わります。
Reactアプリでは、まず技術スタックを把握します。使用しているReactのバージョンや、状態管理にRedux・Zustand・Recoilのどれを採用しているか、ルーティングにReact RouterかNext.jsを使っているかを確認します。
また、ブラウザのDevToolsのコンソールで「React」「__REDUX_DEVTOOLS_EXTENSION__」などを検索すると、使用しているライブラリの種類をある程度特定できます。
工程2:解析環境・ツール準備(React特化ツール)
ブラウザのDevTools(Chrome DevToolsまたはFirefox DevTools)は基本中の基本です。ネットワークタブでAPIリクエストとレスポンスを記録し、Sourceタブで難読化されたバンドルファイルを確認します。
React Developer Tools(ブラウザ拡張機能)を使うと、コンポーネントツリーの構造と、各コンポーネントのpropsとstateをリアルタイムで確認できます。Redux DevToolsが有効な場合は、アクションの発火履歴とストアの状態変化を時系列で追えます。
ネットワーク解析には、Charles ProxyやBurp Suiteも有効です。HTTPSの通信を傍受し、API通信の詳細を記録できます。また、難読化されたJavaScriptは読みにくいため、「prettier」や「js-beautify」などのフォーマッタで整形し、可読性を上げます。
工程3:静的解析(バンドル解析・コンポーネント構造の把握)
静的解析では、実行せずにコードそのものを読み解きます。Reactの場合は、本番環境のバンドルファイル(通常 main.xxxxxxxx.js のような形式)をダウンロードし、フォーマットをかけてから読み解いていきます。
ソースマップが公開されていれば、bundle.js.map ファイルを使って、Webpackが出力した難読化コードを元のファイルと行数に逆マッピングできます。そのぶん解析効率も大幅に上がります。ただし、本番ビルドではセキュリティ上の理由から通常公開されていないため、難読化されたコードを直接解析する必要があります。
コンポーネント命名規則(大文字始まりの関数)を手がかりに、コンポーネント階層を手動でマッピングします。加えて、Webpack Bundle Analyzerでバンドルの構成を視覚化するのも有効です。どのライブラリが何%の容量を占めているかが分かります。
工程4:動的解析(API通信解析・状態管理トレース)
動的解析は、Reactのリバースエンジニアリングで特に欠かせない工程です。実際にアプリケーションを操作しながらAPIリクエストを記録し、バックエンドのデータ構造を解析します。REST APIの場合は、ネットワークタブでエンドポイントURL、HTTPメソッド、リクエストボディ、レスポンス構造を記録します。
GraphQLを採用している場合は、クエリのスキーマ構造を解析することで、バックエンドのデータモデルを推測できます。状態管理の解析(Redux・Zustand)では、Redux DevToolsが有効な場合に、アクション名、ペイロード構造、ストアの状態変化を時系列で記録します。
Zustandはブラウザの開発者ツールと連携できる場合があるため、ミドルウェアの設定状況を確認します。そのうえで、これらのAPI通信データと状態管理データを組み合わせると、バックエンドのビジネスロジックを間接的に復元できます。
工程5:抽象化(Design Recovery:実装→設計→仕様)
解析で得た情報を段階的に抽象化し、設計レベル・仕様レベルの知識として整理するのがこの工程です。まず実装レベルでは、「このコンポーネントがどのpropsを受け取り、どのAPIを呼ぶか」という具体的な情報を把握します。
次に設計レベルでは、「このコンポーネントがどの業務機能を担っているか」「画面遷移のフローはどのようになっているか」を整理します。さらに仕様レベルでは、「ユーザーがこの操作をすると、どのようなビジネスルールが適用されるか」という業務要件を文章にします。
Reactの場合は、UIコンポーネントの状態遷移図、API連携仕様書、画面遷移図の3点セットを成果物として作ることが多いです。これにより、後継の開発チームが理解し、引き継げる水準まで情報を整理できます。
工程6:成果物化(仕様書・新システム設計書の作成)
最終工程では、解析で得た情報を目的に応じた成果物として文書にまとめます。成果物の粒度は大きく3段階に分けられます。最もシンプルな「フローチャート」レベルでは、主要な処理フローと画面遷移を図にします。
「業務仕様書」レベルでは、各機能の入出力、業務ルール、エラーハンドリングを文書にします。最も詳細な「詳細設計書(画面遷移図・コンポーネント設計・API仕様・DB設計)」レベルでは、新システム開発にそのまま使える設計書に仕上げます。
粒度が上がるほど費用と工数が増えるため、「このシステムをどう活用するか」という目的に合わせて、成果物の粒度を事前に決めておくことが大切です。
React固有の注意点と失敗パターン
Reactのリバースエンジニアリングには、他言語にはないReact固有の壁があります。事前に把握しておけば、プロジェクトの失敗リスクを大きく下げられます。
典型的な失敗パターン
最も多い失敗は、「APIレスポンスだけを見てバックエンドのロジックを推測してしまう」ケースです。APIから返るデータがどの業務ルールに基づいて生成されているかは、フロントエンドの解析から直接読み取れないことがあります。特にGraphQLでは、クライアントが必要なフィールドを指定してデータを取得するため、バックエンドにどのようなデータモデルがあるかを完全には把握できません。
次に多い失敗は、「状態管理の復元を見誤る」ケースです。Reduxのストアにどのようなデータ構造があるかを把握しても、どのユーザー操作やサーバーイベントで更新されるかを完全にたどらなければ、業務ロジックの再現に大きな漏れが生じます。
さらに、「UIの見た目だけを復元して、ビジネスロジックの復元を後回しにする」という判断ミスも頻発します。Reactは見た目を作りやすいフレームワークのため、見た目の再現に工数をかけすぎて、業務ルールの文書化が不十分なまま終わるケースもあります。
難読化・バンドル圧縮への対処
Webpackのproductionビルドでは、変数名が1〜2文字に短縮され、コードが1行に圧縮されます。加えてterserなどのMinifierが、デッドコードの除去や関数のインライン展開を行うため、元のコードとは大きく異なる構造になります。
この難読化を解除するには、まずChrome DevToolsの「Pretty Print」機能({}ボタン)でコードを整形します。続いて、変数名の使われ方やパターンから元の意味を推測します。例えば`t.type === “INCREMENT”`というコードは、Reduxのアクションタイプ定数だと推測でき、数量を増加させるビジネスロジックの手がかりになります。
ソースマップがある場合は、DevToolsの「Map」機能で元ファイルに対応付けできます。一方、ない場合は地道にコードを読み解く以外に方法はありません。なお、難読化が高度な場合には、解析に要する工数が数倍〜数十倍に膨れ上がることを念頭に置く必要があります。
法的リスクの回避方法
リバースエンジニアリングでは、法的リスクを把握して回避することが欠かせません。特に他社のReactアプリを対象とする場合は、慎重に対応する必要があります。
クリーンルーム手法の実務
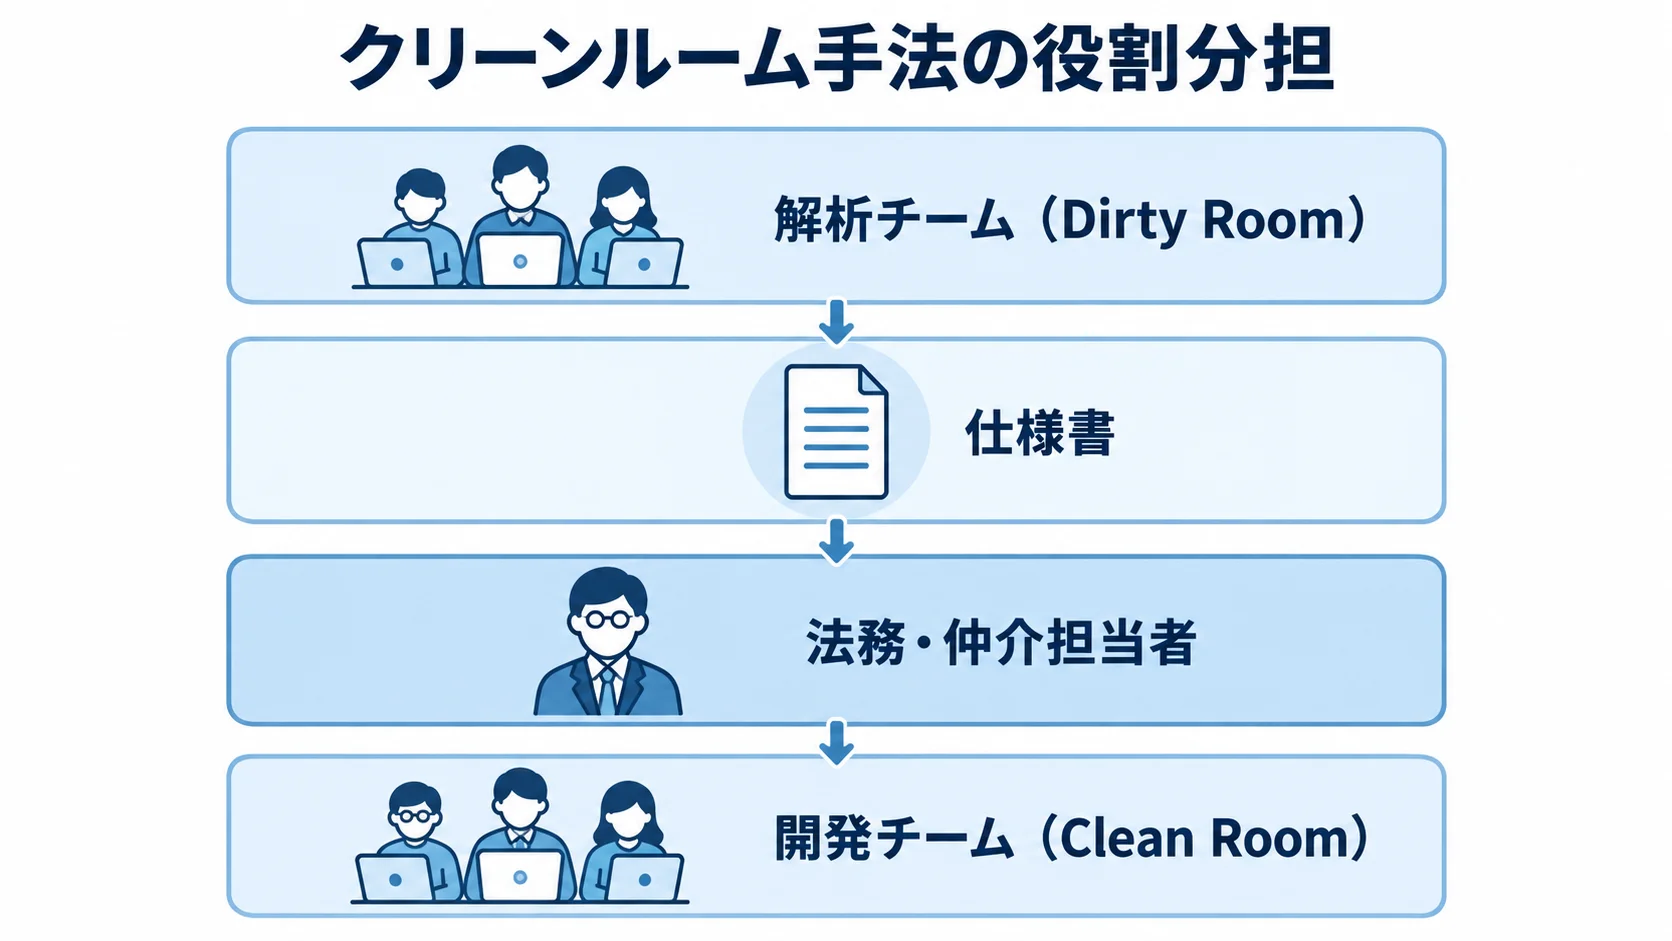
著作権侵害(依拠性)を法的に回避する手法が、「クリーンルーム手法」です。解析チーム(Dirty Room)と新システム開発チーム(Clean Room)を完全に分け、開発チームは解析チームが作成した仕様書だけを見て開発します。元のソースコードは一切参照しないというルールを徹底します。
この手法は、1980年代にフェニックス・テクノロジーズがIBMのBIOS互換製品を開発した際に使われ、著作権侵害を完全に回避しながら互換製品を完成させた歴史的な先例です。
実務では、解析チームと開発チームの間に法務・仲介担当者を置き、仕様書に著作権保護対象の表現(コードの具体的記述など)が混入していないかを検査します。そのため、仕様書は「機能」「アルゴリズム」「データ構造」だけを純粋に記述したものにすることが大切です。
「非享受目的」での記録方法と著作権法30条の4
2018年(平成30年)の著作権法改正で第30条の4が新設され、マルウェア解析・セキュリティ調査・仕様書復元などの「非享受目的」によるリバースエンジニアリングは、原則として合法になりました。ただし、この合法性を後から証明するには、解析の過程を適切に記録しておく必要があります。
具体的には、解析専用の隔離された環境(専用マシンまたは仮想マシン)でリバースエンジニアリングを行い、作業ログ、スクリーンショット、出力ファイルを時系列で記録します。また、解析の目的(仕様書復元、セキュリティ診断など)と対象範囲を文書で定義し、プロジェクト開始時に関係者と合意しておきます。
EULA(使用許諾契約)にリバースエンジニアリング禁止条項がある場合でも、互換性確保に不可欠なときや、その禁止条項が独占禁止法上の不公正な取引方法に当たるときは、無効となるケースがあります。法務専門家への相談を強く推奨します。
外注 vs 内製の判断軸
内製で行うか外注するかは、プロジェクトの規模、社内リソース、機密性の要件によって判断が変わります。各観点をもとに、どちらが合うかを見極めるための判断軸を挙げます。
内製が適しているケースと前提条件
内製が適しているのは、社内にReact・TypeScriptの深い経験を持つエンジニアが複数名いる場合です。特に、対象システムの業務ドメインを熟知した社内エンジニアが解析を担当できれば、「コードは読めたが業務ルールの意図が分からない」という典型的な失敗を避けられます。
また、解析対象が自社開発したシステムで、部分的にでも過去のコミットログや設計メモが残っている場合も、内製で効率よく解析を進められます。逆に、難読化が高度な場合、GraphQLの複雑なスキーマを解析する必要がある場合、クリーンルーム手法の法務運用が必要な場合は、専門ベンダーへの外注が現実的です。
外注する場合のベンダー選定チェックリスト
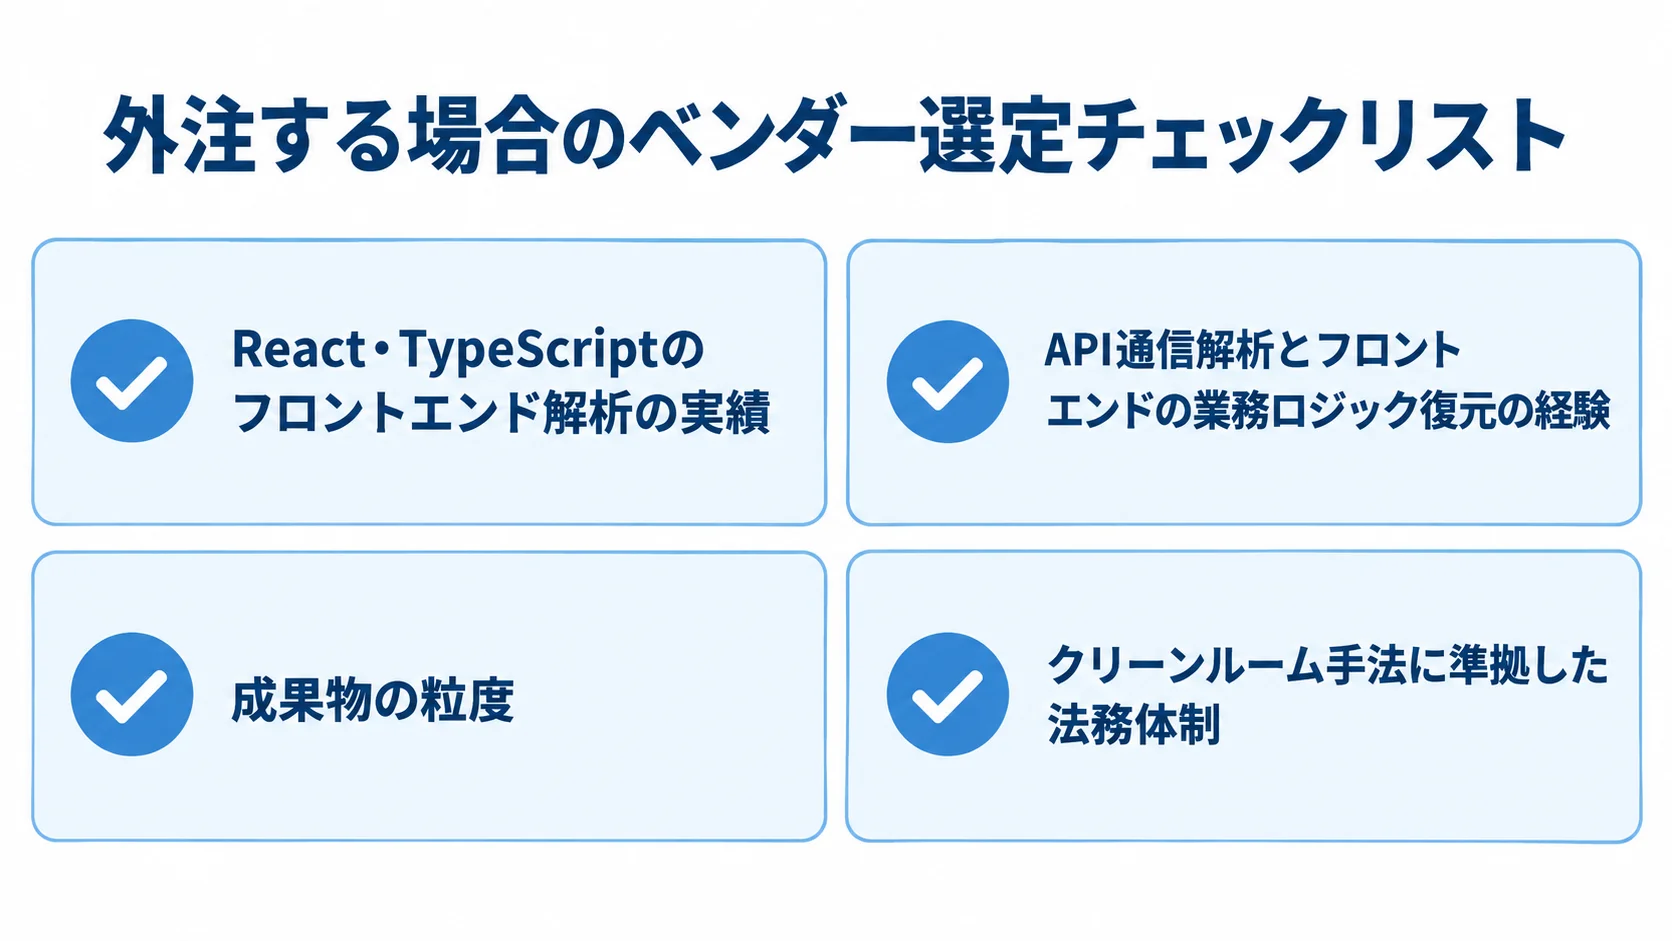
外注する際は、まず「React・TypeScriptのフロントエンド解析の実績が具体的にあるか」を確認します。COBOLやJavaの解析に強いベンダーが、Reactにも同じように対応できるとは限りません。そのため、次に「API通信解析とフロントエンドの業務ロジック復元の経験があるか」を問います。
Reactの場合は、フロントエンドのビジネスロジックを正確に復元できるかどうかが、成果物の品質を大きく左右します。加えて、「成果物の粒度(フローチャート・業務仕様書・詳細設計書)をどの水準で提供できるか」と「クリーンルーム手法に準拠した法務体制が整っているか」を見ておきます。見積もりについては、「LOC(コード行数)以外の複雑さ指標で出せるか」も確認しておきます。
LOC課金の場合、難読化・圧縮されたReactコードの行数で数えると、適正な見積もりになりません。
まとめ
Reactのリバースエンジニアリングには、JavaScriptの難読化、バンドル圧縮、業務ロジックのフロントエンドへの分散といった固有の難しさがあります。それでも、対象選定からツール準備、静的解析、動的解析、抽象化、成果物化までの6工程を体系的に進めれば、高品質な成果物を得られます。
特に、API通信解析(REST/GraphQL)と状態管理(Redux・Zustand)のトレースは、React固有の重要工程です。法的リスクの観点では、著作権法30条の4の「非享受目的」原則と、クリーンルーム手法の実践が欠かせません。内製か外注かの判断は、社内のReact技術力、業務ドメインの知識、法務対応力を総合的に評価してから行うことを推奨します。
Reactのリバースエンジニアリングを成功させれば、失われた仕様を復元し、システムの近代化や安全な引き継ぎにつなげられます。
▼開発を相談する前に読みたい無料ホワイトペーパーはこちらをご覧ください。
・【2026年最新版】AI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。