
倉庫管理システムのリアーキテクチャの開発期間は、本番移行まで12〜18ヶ月が目安です。3つのフェーズに分けて拠点を段階的に切り替えるのが標準的で、納期を左右するのは拠点ごとのデータ正規化です。
- 全体工程:データレイク構築からダッシュボード提供までの3フェーズ
- 拠点展開:ストラングラーフィグパターンによる段階的なロールアウト
- 技術要因:スキーマ正規化とCQRSが納期に与える影響
- 遅延対策:データクレンジングと発注前準備の進め方
本テーマの全体像は、次の全体ガイドでも確認できます。
▼全体ガイドの記事
・倉庫管理システムのリアーキテクチャの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
倉庫管理システムのリアーキテクチャの位置づけ(複数拠点データ集約という論点)
開発期間を検討する前に、まず本記事が扱う論点の位置づけを確認しておきます。「倉庫管理システム」の関連テーマは複数あり、言葉が近くても論点は異なるためです。
倉庫管理システムは、荷主企業が複数の倉庫・物流拠点をまたいで「どの拠点の棚に何個あるか」を横断的に把握する仕組みです。入荷検品やピッキングなど庫内作業に特化した高機能版の「WMS」とは違い、より基本的・汎用的な位置づけになります。対象範囲が違えば、期間を左右する変動要因も変わります。
倉庫管理システムのモダナイゼーション(5手法総論)との違い
「倉庫管理システムのモダナイゼーション」は、リホストやリファクタリングなど5つの技術的アプローチを横並びで比べる総論です。既存の棚番マスタや在庫データを新しい環境へどう引き継ぐかという移行論に、重心を置いています。これに対して本記事は、この5手法のうちリファクタリングとリビルドを深掘りし、複数拠点の在庫データをどう統合し、どう可視化する構造に作り変えるかを扱います。
具体的には、設計の選択肢が二つあります。一つは、各拠点のシステムを独立した境界づけられたコンテキスト(Bounded Context)として扱い、在庫変動イベントをデータレイクへ集約するイベント駆動アーキテクチャです。もう一つは、拠点ごとのデータベースを直接つなぐ同期バッチ処理にとどめる方法です。
どちらを選ぶ場合でも、ドメイン駆動設計(DDD)による拠点間の境界設計が欠かせません。5手法の使い分けを知りたい場合はモダナイゼーションの記事群を、複数拠点をどう構造的に統合するかを知りたい場合は本記事を読むと、目的に合った情報を得やすくなります。
刷新・更改・リニューアル、そしてWMSのリアーキテクチャとの違い
「倉庫管理システム刷新」は、在庫可視性の低下という経営インパクトを数値でどう示し、経営層の稟議承認を得るかという意思決定(WHY・WHEN)を扱います。「倉庫管理システム更改」は、保守サポート契約の満了やEOS/EOLといった外部から強制される期限から逆算する点を中心に据えています。これらはいずれも、システムの内部構造そのものには深く踏み込みません。
「倉庫管理システムのリニューアル」は、複数拠点の在庫状況を俯瞰する管理者向けダッシュボードのUX/UIを取り上げています。また、いずれも、同じ第5波「リアーキテクチャ」に属する近接記事「WMSのリアーキテクチャ」とは、明確に異なります。
「WMSのリアーキテクチャ」は、単一倉庫内のロケーション管理・ピッキング・入出庫の境界設計と、マテハン機器(自動倉庫・ロボット)とのリアルタイム連携基盤に焦点を当てます。一方、本記事が扱う倉庫管理システムのリアーキテクチャは、単一倉庫の内部構造ではなく、複数拠点の在庫データを統合し、経営・在庫最適化の意思決定を支える可視化基盤を作る設計です。
開発期間・スケジュールの全体像(3フェーズで進行する12〜18ヶ月)
複数拠点の在庫を横断的に管理・可視化する基盤を、データレイクとイベント駆動アーキテクチャで作り替える場合、本番環境へ安全に移行し終えるまでの目安は12〜18ヶ月です。全拠点と全機能を一度に切り替えるのではなく、3つのフェーズに分けて進めるのが標準的です。
パイロット〜MVP〜本番移行という3フェーズの期間目安
パイロットフェーズ(期間の目安は3〜6ヶ月)では、まず各拠点のシステム(レガシーの倉庫管理システムなど)から在庫変動イベントを取り出します。それを、Kafkaなどのイベントストリーミング基盤を通じて、Snowflake、Amazon Redshift、Google BigQueryなどのデータレイクへ、ニアリアルタイムに集約する基盤を構築します。
MVPフェーズ(6〜12ヶ月)では、データ基盤の構築と並行して、リアルタイム在庫可視化ダッシュボードを作ります。アーキテクチャにはCQRS(コマンド・クエリ責務分離)を採用します。各拠点での「書き込み(状態変更)」と、データレイク側での「読み取り(ダッシュボード表示)」を分けることで、複数拠点をまたぐ数百万件規模の在庫データでも遅延なく可視化できるようになります。
本番移行フェーズ(12〜18ヶ月)では、すべての拠点からのデータ同期が安定して動き、運用効率の向上や在庫最適化といった具体的なビジネス価値(ROI)が実現します。一方で、パイロットとMVPの段階では投資が先行する期間が必ず生じるため、その前提を経営層と現場の双方へ事前に共有しておくことが大切です。
データ準備(拠点ごとの形式正規化)への先行投資が工程の鍵
パイロットフェーズのデータ収集・統合は、プロジェクトの最難関で、開発期間全体を左右する最大の変動要因です。拠点ごとに商品コードの桁数や日付形式、在庫の計上ルールが異なります。そのため、データ形式の正規化や欠損データのクレンジングといった事前準備に、プロジェクト全体の期間・予算の40〜60%を先行投資するのが成功のセオリーとされています。
この事前準備を怠ると、後になってデータの不整合が見つかり、本番移行が6〜12ヶ月遅れる原因になります。特に、拠点数が多い企業や、M&Aなどで異なるシステムを使う拠点が混在する企業では、この正規化工程を楽観的に見積もりすぎないことが、現実的なスケジュールを描く出発点になります。
段階的な拠点ロールアウトの進め方(ストラングラーフィグパターン)
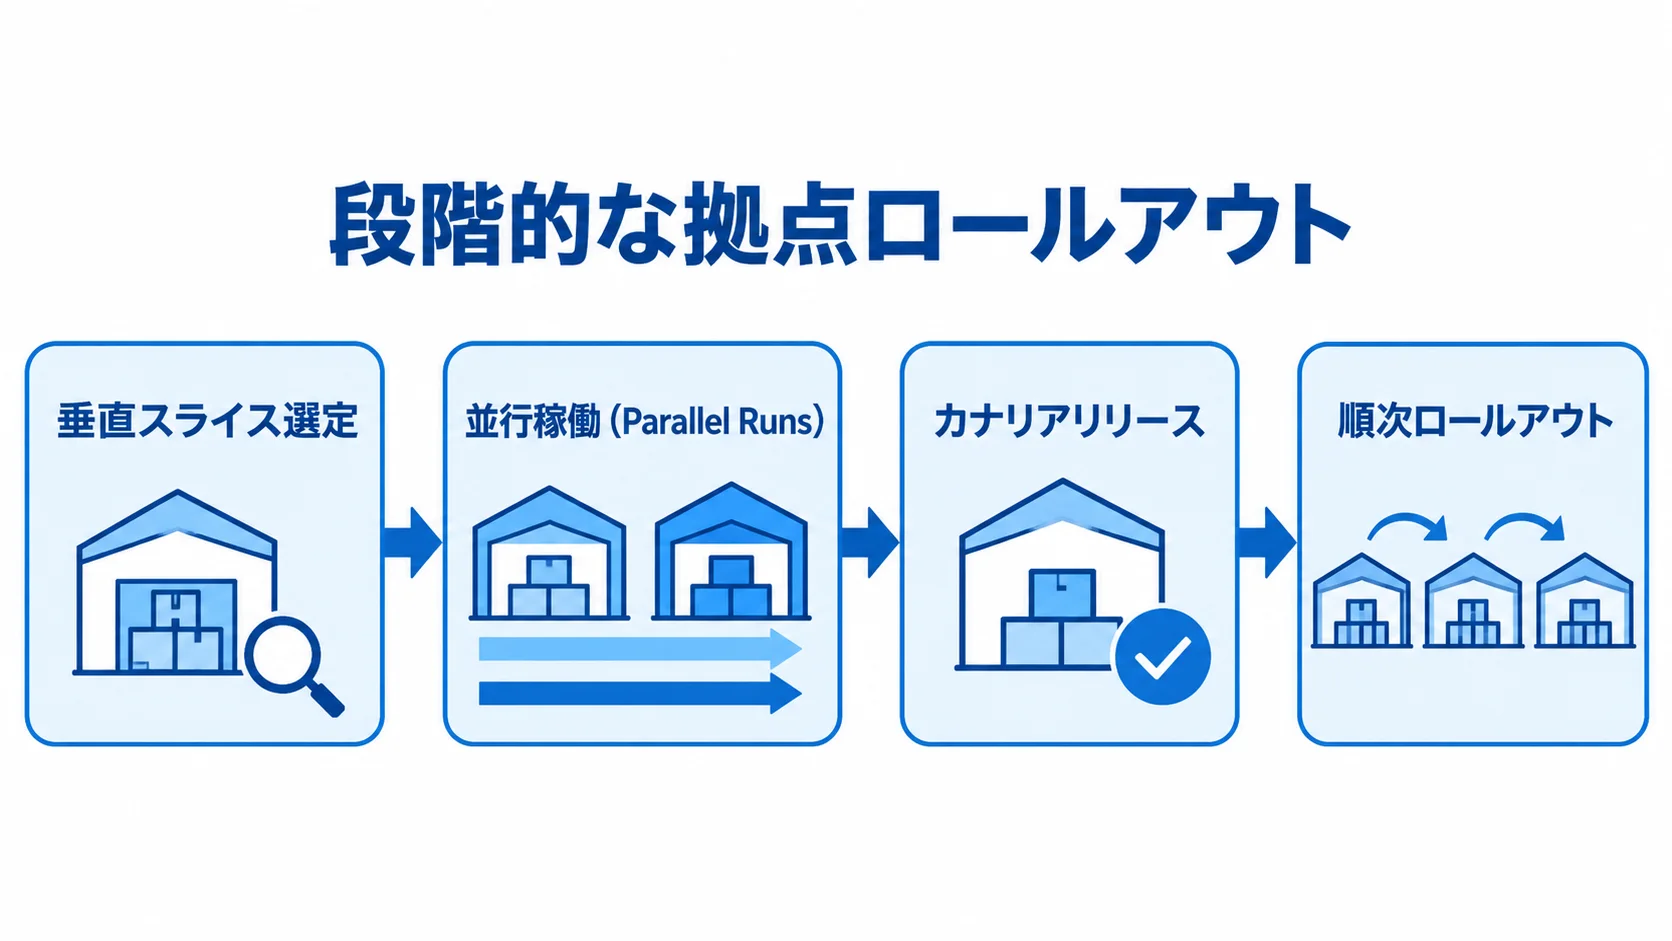
全拠点を一斉に切り替える「ビッグバンリリース」は、障害が起きれば全社の在庫管理業務が停止する致命的なリスクがあるため、避けるべきです。代わりに用いられるのが、既存のシステムを稼働させたまま、新しい基盤へ徐々にトラフィックを移していく「ストラングラーフィグパターン」です。このパターンで段階的に展開するのが、標準的な進め方になります。
最初の垂直スライス選定と並行稼働(Parallel Runs)による検証
最初のステップは、「最も価値が高く、かつ複雑度が低い」拠点や特定のユースケースを一つ選ぶことです。たとえば、メインの大規模拠点と、それに紐づく少数の営業所の在庫同期機能だけで、最初のリリースを行います。
切り出したスライスは、既存の夜間バッチなどによる在庫集約システムと、新しいリアルタイムのイベント駆動基盤を同時に動かす「並行稼働(Parallel Runs)」で検証します。両者の出力する在庫データが完全に一致するか、ニアリアルタイムの同期がミリ秒〜秒単位の許容範囲に収まるかを、一定期間比べ続けます。これにより、本番切り替えの前に不整合を見つけて取り除けます。
カナリアリリースと順次ロールアウト
新しい可視化ダッシュボードは、まず一部の管理者や特定拠点のユーザーだけに公開する「カナリアリリース」で展開します。そのうえで、システム負荷やエラーを監視します。
問題が起きた場合は、フィーチャートグル(機能の切り替え設定)で新機能を即座にオフへ戻し、業務への影響を最小限に抑えます。最初の拠点で安定稼働とROIの創出が確認できたら、そこで得た知見を生かして、残りの拠点へ順次展開していきます。
この段階移行を前提にスケジュールを組むと、開発期間は「いつ完成するか」という単一の締め切りではなく、「どの拠点を、いつまでに、どの順序で切り出すか」という意思決定の積み重ねとして描けます。こうすると、途中のフェーズで得たフィードバックを後続の拠点展開に反映しやすくなります。
納期を左右する技術要素(スキーマ正規化とCQRS・API-First)
複数拠点を横断する在庫可視化基盤では、ダッシュボードの機能開発とは別に、データの土台に関わる技術要素が納期の大部分を左右します。
スキーマレジストリによるデータ正規化にかかる期間
拠点ごとに異なるデータ形式を吸収するため、Confluent Schema Registryなどを導入して、イベントのスキーマ(データ構造の契約)を一元管理します。この設計には、パイロットフェーズの初期で相応の期間を割く必要があります。
この設計があると、プロデューサー(各拠点)とコンシューマー(データレイク)が互いに影響を与えず、独立して進化できます。ただし、そのためには拠点側の既存システムを調べ、ヒアリングを重ねることが欠かせません。拠点数が多いほど、この工程の期間は線形に増えやすい点に注意が必要です。
さらに、レガシーシステムからデータを抜き出すには、CDC(Change Data Capture)などの技術が使われることが多いです。本番のデータ量に耐えられる形で正規化できるかを、アーキテクチャスパイクとして一部で先に検証しておくと、後工程の手戻りを防げます。
API-First設計による並行開発の短縮効果
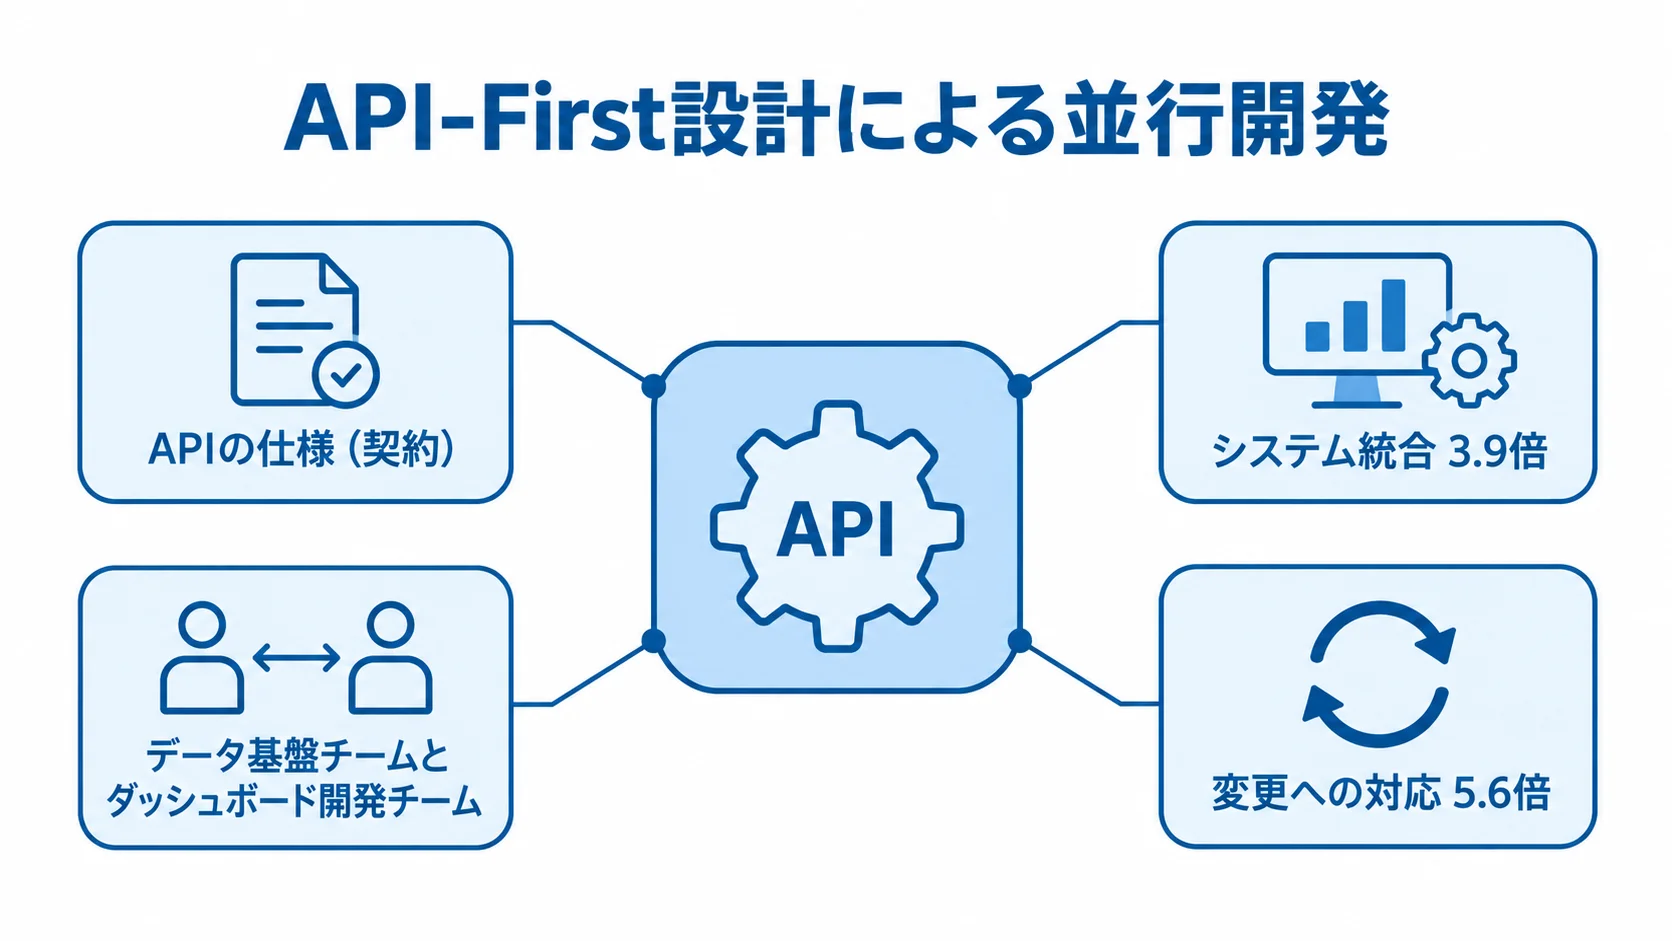
バックエンドのデータレイク構築を待たずにダッシュボード側を開発するには、APIの仕様(契約)を先に定めるAPI-First設計を採用します。これが、納期短縮の有効な手段になります。
API-First設計によって、システム統合が3.9倍、変更への対応が5.6倍速くなるとされています。データ基盤チームとダッシュボード開発チームが仕様のずれなく並行して作業できる体制を早期に作れるかが、プロジェクト全体の納期に直結します。
また、着手前に「在庫確認にかかっている時間」や「データの不整合・欠品による損失」のベースラインを3〜6ヶ月間測っておくと、新基盤稼働後の効果を経営層に客観的に示せます。そのため、追加の予算や期間の確保についても、合意を得やすくなります。
納期遅延を招く落とし穴と実務的な進め方
複数拠点を横断するデータ統合プロジェクトでは、見落とされがちな落とし穴が納期の遅れに直結します。代表的な落とし穴と、それを避けるための進め方を順に見ていきます。
データクレンジングの過小見積もりという最大の失敗パターン
リアーキテクチャで最も多い納期遅延の原因は、アプリケーション機能の開発に予算とスケジュールを偏らせることです。そのため、データクレンジングと正規化という地味に見える工程が後回しになります。後回しにすると、拠点ごとに異なる商品コード体系や単位表記、在庫の計上タイミングのずれを、実装フェーズに入ってから発見することになり、複数拠点にまたがる大規模な手戻りを招きます。
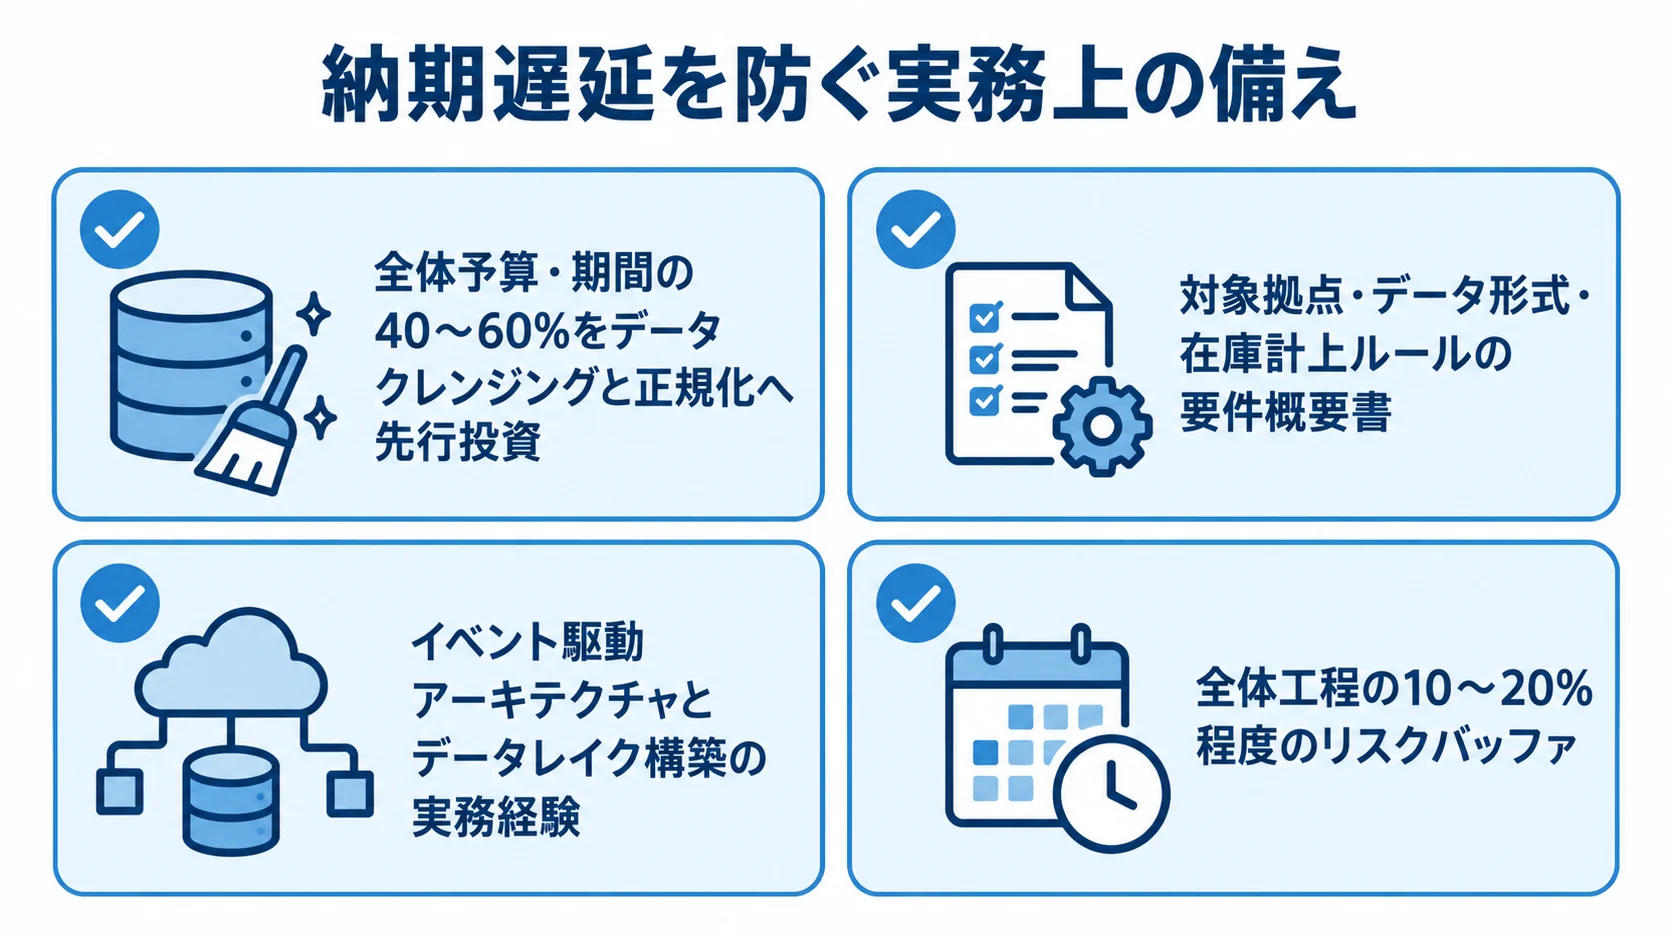
これを防ぐには、プロジェクトの初期に全拠点のデータを洗い出し、正規化の対象範囲と優先順位を文書にまとめます。そのうえで、前述のとおり全体予算・期間の40〜60%をこの工程に先行投資する方針を、経営層を含めて事前に合意しておくことが欠かせません。
発注前の準備と依頼先選定のポイント
発注前に、対象拠点の数、各拠点で稼働中のシステムの種類とデータ形式、拠点間の在庫計上ルールの差異をまとめた要件概要書を作っておくと役立ちます。複数の開発会社から、比べやすい提案とスケジュールを得やすくなるためです。
依頼先を選ぶ際は、イベント駆動アーキテクチャとデータレイク構築の実務経験を確認します。そのうえで、拠点をまたぐデータ正規化やスキーマ設計の実績と、ストラングラーフィグパターンで段階的な拠点展開を安全に伴走できる実績も見ておきます。
プロジェクトが始まったら、各フェーズの完了条件を数値で定めます。拠点ごとの並行稼働検証が終わってから次の拠点に進むことを徹底し、全体工程には10〜20%程度のリスクバッファを組み込んでおきます。これは、拠点数の多いプロジェクトで納期を守るための、現実的な備えになります。
まとめ
本記事では、複数拠点データ集約という位置づけを出発点に、3フェーズの全体スケジュールを見てきました。あわせて、拠点展開の進め方、納期に影響する技術要素、納期遅延を招く落とし穴と進め方も扱いました。
全体スケジュールは、パイロット3〜6ヶ月、MVP6〜12ヶ月、本番移行12〜18ヶ月の3フェーズで進みます。納期を守る鍵は、プロジェクト全体の予算・期間の40〜60%を、拠点ごとのデータ正規化に先行投資することです。
単一倉庫内のロケーション管理・ピッキング・入出庫を扱うWMSのリアーキテクチャとは異なり、本記事は複数拠点をまたぐデータ統合という論点を扱います。この違いを踏まえて、自社の拠点数とシステムの分散の度合いを洗い出し、イベント駆動アーキテクチャとデータレイク構築の実装実績が豊富なパートナーに、早めに相談することをお勧めします。
▼全体ガイドの記事
・倉庫管理システムのリアーキテクチャの完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。