
倉庫管理システムのリアーキテクチャにおけるフルスクラッチ・オーダーメイド開発は、複数拠点の在庫データを統合する基盤を、ゼロから作り直す選択肢です。
実装複雑度は「高い(High)〜非常に高い(Very High)」に分類されるため、採用の条件を先に明確にしておく必要があります。
- 設計単位:拠点別のBounded Contextと在庫集約コンテキストを、ゼロから設計する場合
- 技術選定:データメッシュ/データレイクアーキテクチャを採用する場合
- 依頼先選定:開発会社に確認すべき実績と、規模別の費用・進め方
独自ロジックの完全再現を主眼とするモダナイゼーションのフルスクラッチ記事に対し、本記事は複数拠点のデータ統合というアーキテクチャ上の選択に焦点を当てます。どの規模の企業が、どう判断すべきかを扱います。テーマ全体の流れは、次の全体ガイドで確認できます。
▼全体ガイドの記事
・倉庫管理システムのリアーキテクチャの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
倉庫管理システムのリアーキテクチャにおけるフルスクラッチの位置づけ
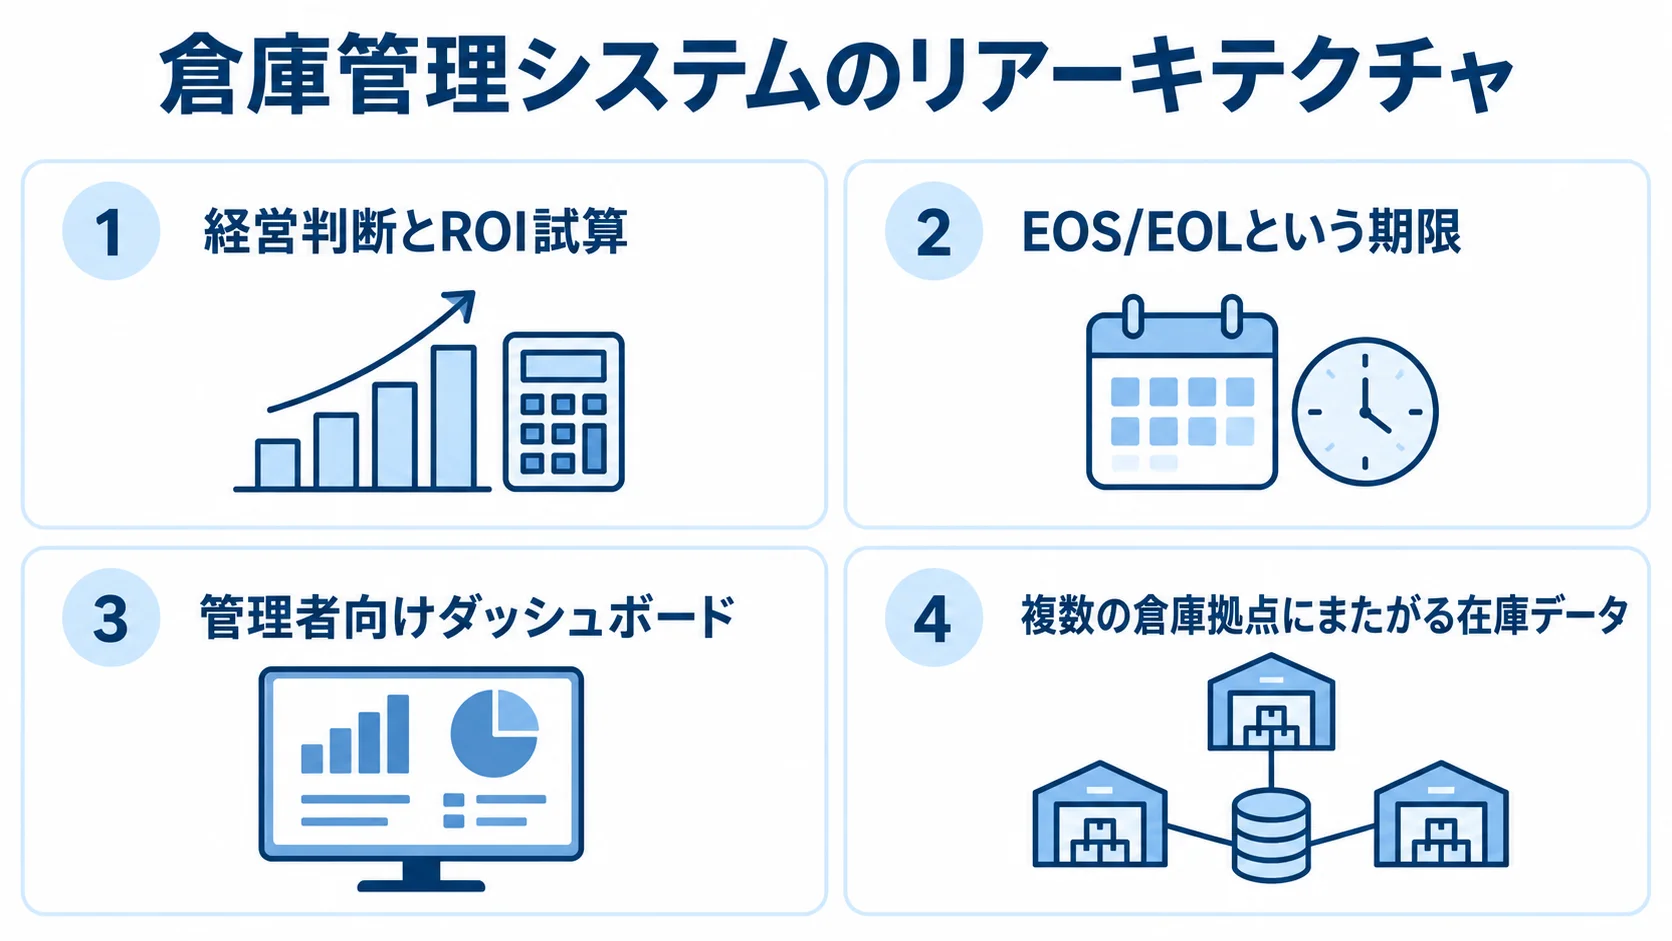
フルスクラッチという選択肢を検討する前に、隣接する記事群で扱われるフルスクラッチと何が違うのかを整理しておく必要があります。
倉庫管理システムのモダナイゼーション(リビルド全般)との違い
「倉庫管理システムのモダナイゼーション」が扱うフルスクラッチは、5つの技術的アプローチのうち「リビルド」に当たります。既存の棚番マスタや在庫データを引き継ぎながら、老朽化したロジックを根本から作り直すもので、独自ロジックの完全再現に主眼があります。
本記事が扱うリアーキテクチャのフルスクラッチは、そのリビルドのなかでも、さらに一段踏み込んだものです。拠点ごとのドメイン境界をどう切るか、拠点横断の在庫集約コンテキストをどう設計するかといった点に、焦点を当てます。さらに、データメッシュ/データレイクで、フロントのダッシュボードとバックエンドのデータ統合基盤を並行して開発する進め方も含まれます。
拠点数の多さや拠点間のシステム差異からリビルドを選ぶという判断は、モダナイゼーションの記事群で扱われています。一方で、リビルドを選んだあとに「では具体的にどんな構造で作るのか」を決めるのが、本記事の役割です。
刷新・更改・リニューアル、そしてWMSのリアーキテクチャとの違い
「倉庫管理システム刷新」は、フルスクラッチという選択そのものより、それに踏み切るべきかという経営判断とROI試算に重心を置きます。「倉庫管理システム更改」は、EOS/EOLという期限のなかでフルスクラッチが現実的な選択肢になり得るかを逆算します。「倉庫管理システムのリニューアル」は、管理者向けダッシュボードをフルスクラッチで作り込むか、テンプレートを使うかという体験面の判断に重心を置きます。
同じ第5波の近接記事「WMSのリアーキテクチャ」のフルスクラッチは、単一倉庫内のロケーション管理・ピッキング・入出庫というドメインをマイクロサービスへ分解します。あわせて、マテハン機器とのリアルタイム連携基盤の構築に焦点を当てます。
これに対して本記事が扱うリアーキテクチャのフルスクラッチは、経営判断・期限・デザインのいずれとも独立した論点です。単一倉庫の内部構造ではなく、「複数の倉庫拠点にまたがる在庫データを、DDD・データメッシュという技術選択でどう統合するか」を扱います。経営層が刷新を決め、更改の期限も定まったあとに、アーキテクトが拠点間データ統合の技術を選ぶ場面で、本記事の論点が直接必要になります。
拠点別Bounded Contextと在庫集約コンテキストの費用感
拠点ごとの「Bounded Context」と、拠点横断の「在庫集約コンテキスト」をDDDを用いてゼロから設計・実装するアプローチは、実装複雑度が「High(高)〜Very High(極めて高い)」に分類されます。
初期開発コストとイベントソーシング・データベース分割のコスト
分散インフラ(Kubernetesやデータパイプライン等)をゼロから構築する必要があるため、従来のモノリス開発と比べて、初期投資が約40%高くなります。
各拠点に専用のデータベースを持たせる「Database per Service」パターンや、状態変化を記録する「イベントソーシング」を実装する場合、イベントログ用のストレージや専門的なツールの要件が高くなります。そのため、この高度なデータ基盤とPoC(概念実証)の構築には、10万〜50万ドル(約1,500万〜7,500万円)規模の先行投資を見込むのが、エンタープライズの標準的な目安とされています。
開発の初期段階では、ドメイン分析フェーズに数週間〜1.5ヶ月程度を要します。このフェーズでは、EventStormingなどのワークショップを通じてビジネスプロセスを可視化し、境界とユビキタス言語を定義します。
フルスクラッチを正当化するGo/No-Goライン
「1日のリクエスト数が100万回を超える」かつ「開発エンジニアが50名以上いる」ことが、拠点別Bounded Contextの完全な物理分割を正当化する損益分岐点とされています。この2つの条件は、両方が揃って初めて投資を正当化します。拠点数が多くてもエンジニアが少なければ、分割によって生まれる運用の複雑さを支えきれません。
逆に、エンジニアは多くても拠点数やトラフィックが少ない企業では、分割によって得られるスケーラビリティの利点を活かす場面がありません。
この条件を満たさない場合は、DDDによる完全な物理分割を見送る判断が必要になります。そのかわり、単一のコードベース内で拠点ごとの論理的な境界を分離する「モジュラーモノリス」にとどめれば、納期とコストの両面で安全な選択肢になります。
データメッシュ/データレイクアーキテクチャ採用時の技術選定のポイント
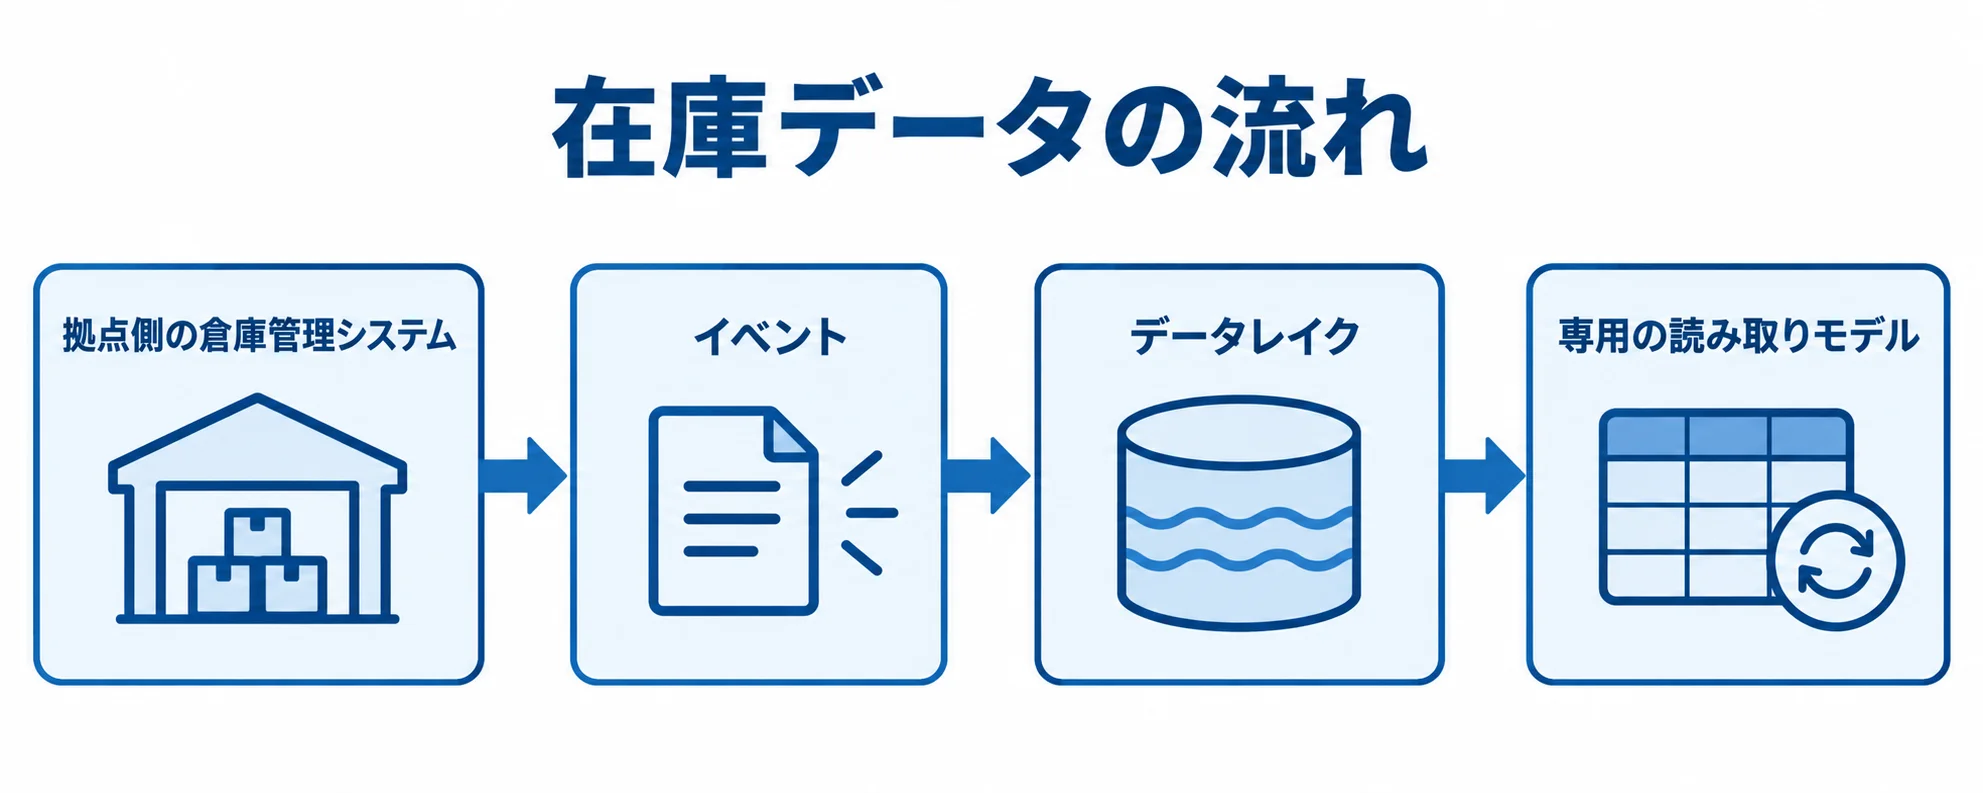
複数拠点に分散する在庫データを、リアルタイムに集約・分析するデータメッシュやデータレイクを構築するには、いくつかの技術的アプローチが欠かせません。
CQRSと非同期メッセージング基盤の採用
基本設計になるのは、CQRS(コマンド・クエリ責務分離)の採用です。各拠点の倉庫管理システムが状態の変更・書き込み(Command側)を担い、中央の集約基盤がデータの検索・読み取り(Query側)を担うように、両者のデータベースと経路を分離します。
拠点側で在庫が変動したらイベントを発行し、クエリ側(データレイク)がそのイベントを消費して、UIや検索に最適化された専用の読み取りモデルを更新する構成です。これらを実現するには、拠点と集約基盤のあいだをKafkaやRabbitMQなどのメッセージブローカーによる非同期通信(イベント駆動アーキテクチャ)でつなぎ、疎結合にする必要があります。
ポリグロット(多技術)スタックの活用
フルスクラッチでマイクロサービス化する場合でも、システム全体を単一の言語に縛る必要はありません。柔軟な技術選定(ポリグロットスタック)を行うことが、成功の鍵となります。たとえば、拠点からの高並行・高スループットなメッセージ処理にはJavaやGoを使い、データレイク側の需要予測や在庫最適化の機械学習モジュールにはPythonを使います。
拠点数や取扱データ量が今後も増える見込みがある企業ほど、初期段階から技術選定の自由度を確保しておく設計が、将来の機能拡張のコストを抑えることにつながります。
開発会社選定で確認すべき実績
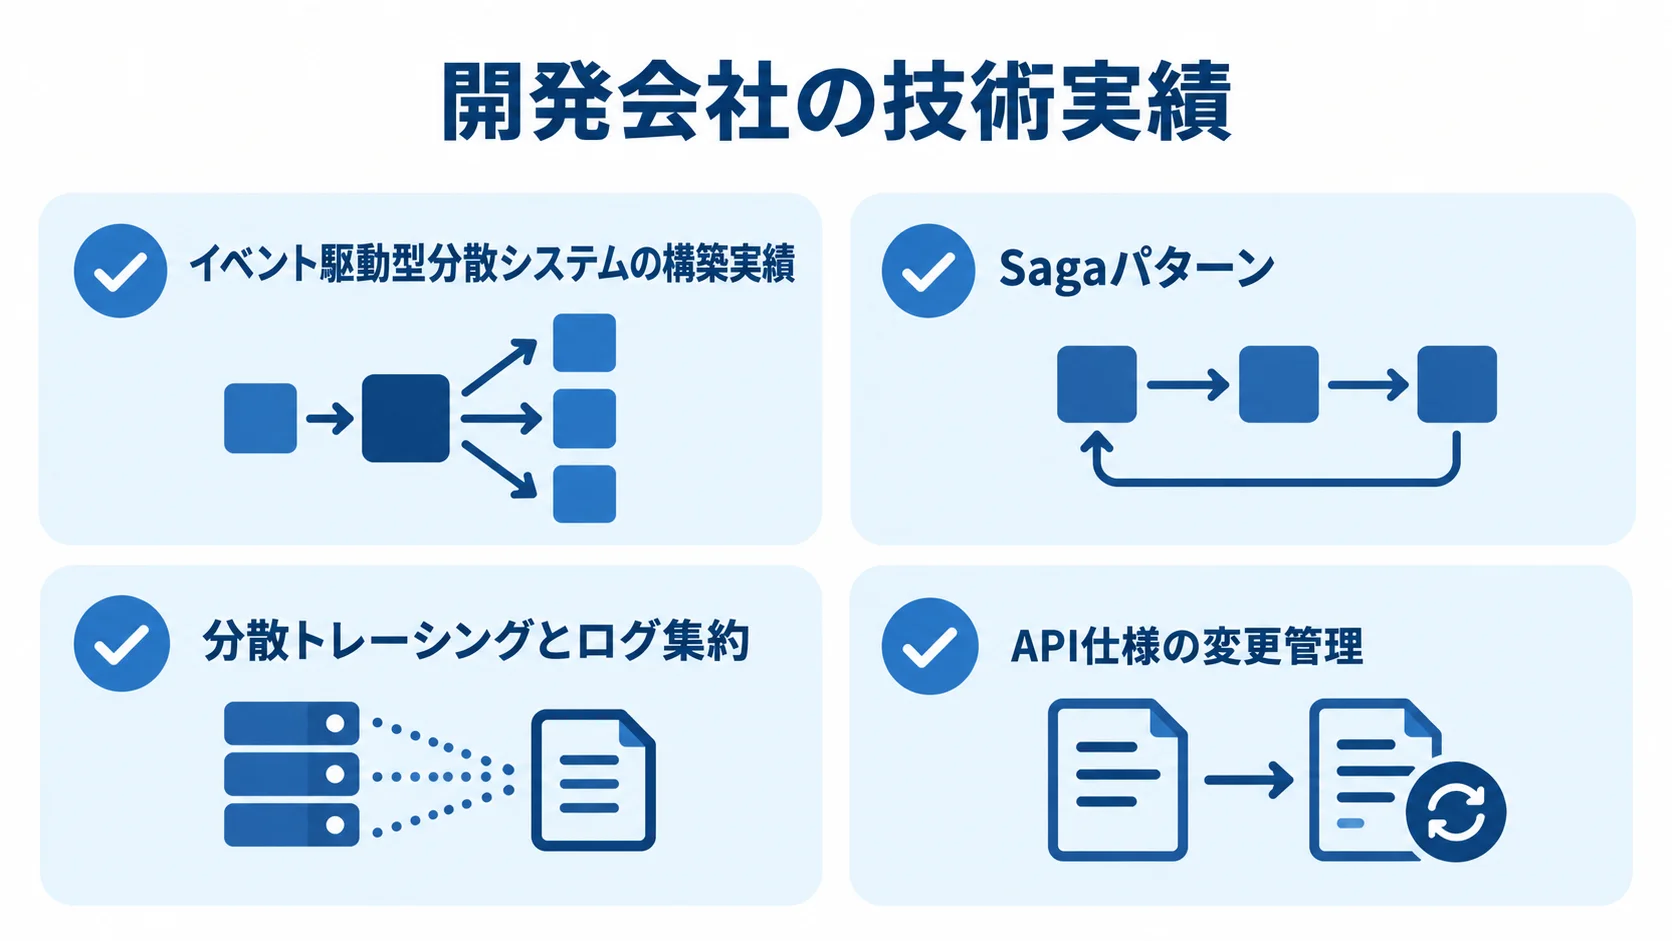
この規模の複雑な分散システムを成功させるには、単なるWeb開発スキルではなく、高度な分散システムの専門知識を持つ開発パートナーを選ぶ必要があります。
イベントソーシング・CQRSと可観測性の実装実績
Kafkaなどのメッセージブローカーを使った、複雑なイベント駆動型分散システムの構築実績があるかを確認する必要があります。加えて、Sagaパターンでデータ整合性を担保する深い専門知識を持つエンジニアが、実際にアサインされるかも確かめます。
さらに、分散された複数拠点からのリクエストを追跡するには、OpenTelemetryやJaegerを用いた分散トレーシングとログ集約のダッシュボード構築が必須です。これを設計・運用できるSRE人材がチームに含まれているかも、重要な選定基準になります。
SRE人材の市場相場は月額80万〜130万円程度です。専任のプラットフォームチームを継続的に維持する費用は、中長期のP&L(損益計算)に組み込んでおく必要があります。
API-First設計とコントラクト駆動開発の習熟度
拠点側の倉庫管理システムと中央の集約基盤のチームが並行して開発できるよう、APIの契約(コントラクト)を先に設計し、自動テストでガバナンスを効かせる開発体制があるかを確認します。設計ツールやモックサーバー(Prismなど)を使い、API仕様を単なるドキュメントで終わらせず、コントラクトテストとしてCI/CDパイプラインに組み込める技術力があるかどうかは、稼働後の保守性を大きく左右します。
過去のプロジェクトで、複数拠点・複数チームが同時並行で開発を進めた実績があるかを、具体的にヒアリングします。あわせて、API仕様の変更管理をどのようなプロセスで行っているかも確かめます。単に技術力があるだけでなく、複数拠点をまたいだプロジェクトマネジメント能力を備えているかを見極めることが欠かせません。
規模別の費用と進め方
拠点数が異なるプロジェクトでの投資配分と、リスクを抑えた進め方の考え方を、順に見ていきます。
データ基盤への先行投資というセオリー
拠点数が多い企業ほど、データクレンジングとスキーマ正規化という地味な工程に、予算とリソースを先行投資することが成功のセオリーです。さらに、過去のエンタープライズ事例でも、プロジェクト全体の予算やリソースの40〜60%を「初期のデータクレンジングと基盤整備」に充てるのが一般的とされています。
ダッシュボードなどのアプリケーション機能の開発に予算を偏重させ、この土台部分への投資を後回しにしてしまうと、稼働直前になって拠点間のデータが計画どおりに統合できないという、致命的な事態を招きかねません。
結論としての判断基準と代替アプローチ
複数拠点を横断する倉庫管理システムのフルスクラッチでデータ統合基盤を構築するのは、組織規模(50名以上の開発者)とトラフィック(100万リクエスト/日以上)の条件を満たす場合にだけ、その真価を発揮します。
条件を満たさない場合は、既存のクラウドサービスやSaaS型のデータ統合ツールを組み合わせるコンポーザブルなアプローチを検討するのが推奨されます。あるいは、モジュラーモノリスで段階的にリファクタリングする進め方もあります。
自社の拠点数、各拠点のシステムの分散度合い、開発体制の規模を客観的に評価したうえで、フルスクラッチという選択が本当に適しているかを、複数の開発会社との対話を通じて見極めることが欠かせません。
まとめ
ここまで、倉庫管理システムのリアーキテクチャにおけるフルスクラッチ・オーダーメイド開発を見てきました。リビルド全般との違いから、費用感、技術選定、開発会社選定で確認すべき実績、規模別の費用と進め方までを順に扱っています。
初期投資はモノリス比で40%高く、高度なデータ基盤とPoCの構築には1,500万〜7,500万円規模の先行投資が目安になります。ただし、「1日100万リクエスト以上」「エンジニア50名以上」というGo/No-Goラインを満たす場合は、CQRS・データメッシュ・ポリグロットスタックが、拠点横断の在庫可視化基盤として真価を発揮します。
単一倉庫内のマイクロサービス化を扱うWMSのリアーキテクチャとは違い、本記事は複数拠点のデータ統合という層を扱います。この違いを踏まえて、まずは自社の拠点数とエンジニア体制を客観的に評価し、DDD・データメッシュの実装実績が豊富な開発会社に相談することをお勧めします。
▼全体ガイドの記事
・倉庫管理システムのリアーキテクチャの完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。