
Webサービス/SaaSの運用保守体制は、要件確定、引き継ぎ、監視基盤整備の順に進めると、一般に6〜8か月で定常運用へ移行できます。利用者増加に応じたスケーラビリティの確保や、グロースに伴う機能改善も必要になります。規模や可用性の目標によって、期間は変わります。
パートナー選定者や、社内でSRE(サイト信頼性エンジニアリング)的な体制を組む方に向けて、立ち上げ期間の内訳、工程別のスケジュール、CI/CDによる納期への影響をまとめます。
▼全体ガイドの記事
・サービス運用保守の完全ガイド
Webサービス開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「Webサービス開発の完全ガイドブック」で詳しく解説しています。
サービス運用保守の立ち上げ期間の全体像
Webサービス/SaaSの運用保守における「開発期間」は、新規開発とは意味が異なります。ゼロから作る期間ではなく、体制立ち上げと定常運用中の改善・機能追加にかかる期間を指します。
外部ベンダーの選定からSLA合意、引き継ぎを経て定常運用に入るまで、一般に6〜8か月を見込みます。内訳は、ベンダー選定とSLA合意に4〜6か月、実務の引き継ぎに約2か月です。
内製の場合も、人員確保とツール選定に加えて、監視基盤の構築とランブック整備にも同程度の期間がかかります。
運用保守は立ち上げ後も、サービスの成長に合わせて続きます。特にWebサービス/SaaSでは、アジャイル開発のように短い周期で機能を追加するため、運用側もその速度に追従する体制が必要です。
週次・隔週・月次などのリリース周期に加えて、障害対応やセキュリティパッチ適用の流れも設計しておくと、後の手戻りを防げます。
現実的なスケジュールは、立ち上げを工程に分けて組むと立てやすくなります。具体的な立て方は、後の節で工程ごとに見ていきます。
運用保守フェーズにおける「開発期間」の捉え方
運用保守の期間は、どの段階の作業を指すかによって中身が変わります。
- 立ち上げ期間:監視とSLAを定め、インシデント対応とオンコール体制を整える期間です。
- 定常運用期間:監視と障害対応を続けながら、機能改善や性能向上のリリースを重ねます。
定常運用中は小さなリリースが頻繁にあり、納期は案件ごとの一括納品ではなく、スプリント(1〜2週間程度の開発サイクル)ごとに積み重なります。そのため、短い周期でデリバリーする考え方が欠かせません。CI/CDや自動化への投資が納期の短縮につながるのは、この前提があるからです。
規模別の立ち上げ期間と費用の目安
必要な監視時間や可用性は規模によって異なるため、立ち上げ期間と費用の目安も規模ごとに確認します。
- 小規模:単一Webアプリ、平日日中の監視で足りる場合
- 中規模:複数マイクロサービス、24時間の自動監視と一次対応が必要な場合
- 大規模:高可用性が必要なSaaS、24時間365日の有人オンコールが必要な場合
小規模では立ち上げ1〜2か月、月額10万〜30万円程度が目安です。中規模では3〜4か月、月額30万〜100万円程度が相場です。
一方で、大規模では選定から引き継ぎまで6〜8か月かかり、月額100万円以上になることもあります。いずれも目安で、可用性目標やオンコールの有無で変わります。
運用保守費用は、一般に初期開発費用の年間5〜15%程度です。ただし、高度にカスタマイズされた複雑なシステムでは、年間20%程度まで高騰する傾向があります。
立ち上げ期間を左右する変数
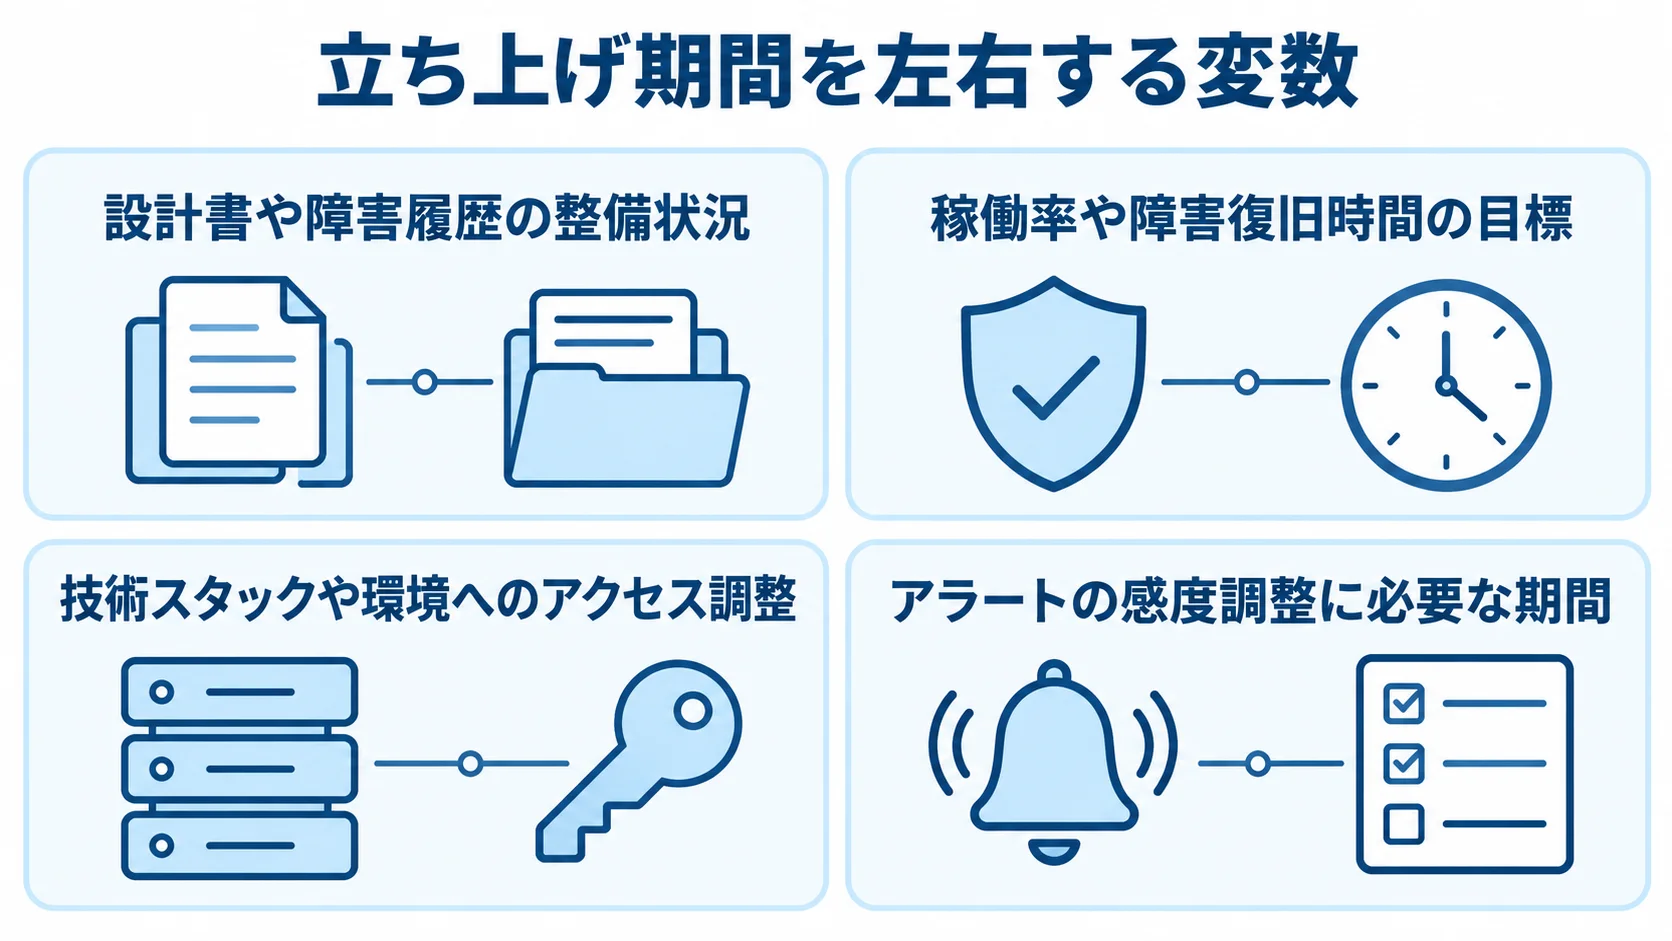
同じ中規模のWebサービスでも、立ち上げが3か月で済む場合と半年以上かかる場合があります。そこで、この差を生む変数を理解することが、現実的な日程を組む前提になります。
- 第一の変数・文書:設計書や障害履歴の整備状況
- 第二の変数・可用性:稼働率や障害復旧時間の目標
- 第三の変数・技術と権限:技術スタックや環境へのアクセス調整
- 第四の変数・監視:アラートの感度調整に必要な期間
設計書、構成図、障害履歴、運用手順が揃っていれば、引き継ぎは短くなります。反対に不足があると、現行担当者への聞き取りや実機調査に時間がかかります。
稼働率99.9%以上や障害復旧6時間以内のように厳しいSLAほど、監視設計、冗長構成、オンコール体制の整備に時間がかかります。さらに、クラウドアカウントの発行や本番アクセス権、セキュリティ審査も、立ち上げ期間を左右します。
アラートは、誤検知と見逃しのバランスを取りながら、数週間かけて調整します。見積もり段階で期間に影響する条件を洗い出しておくと、遅延の防止につながります。
運用保守体制立ち上げの工程別スケジュール
期間を正しく見積もるには、立ち上げを工程に分け、それぞれの所要期間を把握します。立ち上げは2段階で、SLA合意と体制要件の確定に約4〜6か月、引き継ぎと基盤整備に約2か月をかけます。
前半では、発注側がSLAの要件と24時間365日対応(オンコール体制)の必要性を定め、RFP(提案依頼書)でベンダーを選びます。加えて、監視精度や応答品質を検証するPoCを2〜4週間行います。
次に、応答時間や復旧目標を契約に記し、未達時のペナルティとエスカレーション体制も含めてSLAを合意します。契約後は、開発チームと現行の運用チームから新体制へ引き継ぎます。
工程ごとの標準的な期間配分は、次の節で確認します。
引き継ぎ・移行の8週間ロードマップ
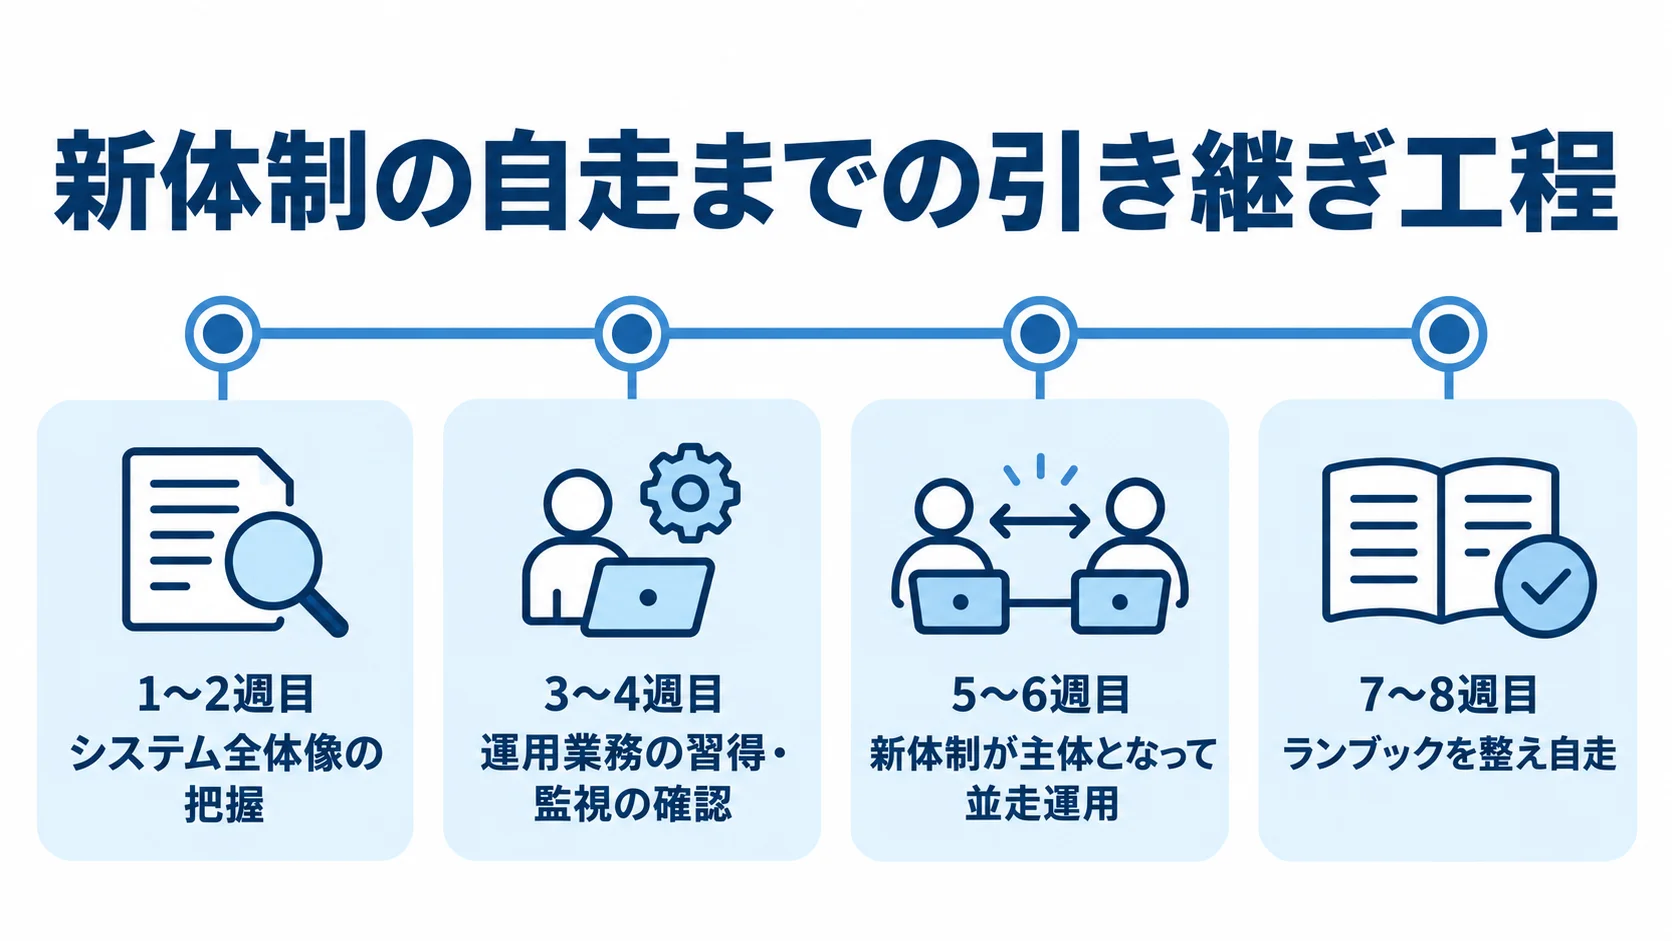
引き継ぎは品質を保って段階的に進めます。一般に4ステップで約8週間かけ、新体制が自走できる状態を目指します。
- 1〜2週目:システム全体像を把握します。
- 3〜4週目:運用業務を習得し、監視を確認します。
- 5〜6週目:新体制が主体となって並走運用します。
- 7〜8週目:ランブックを整え、自走を目指します。
1〜2週目は構成と技術スタックを理解し、設計書、構成図、過去の障害履歴を確認します。クラウド環境とデプロイ基盤へのアクセス設定や動作確認も行います。
3〜4週目は定期メンテナンスや障害レベルの判定、エスカレーションルールを学びます。並行して監視・アラート基盤を構築し、調整します。
5〜6週目は現行担当者の支援を受け、新体制が実際に発生したインシデントの一次対応を担います。また、不明点を確かめながら実務知識を蓄積します。
7〜8週目は手順をランブック(運用手順書)にまとめ、新体制だけで運用できる状態に仕上げます。
8週間を圧縮しすぎると、引き継ぎ漏れが定常運用後の重大障害につながるおそれがあります。特に可用性要件が高いサービスでは、並走期間を十分に確保することが求められます。
監視・SLA設計に要する期間
Webサービス/SaaSの運用保守では、監視とSLAの設計に最も時間をかける必要があります。その設計で決める目標と監視項目を、5つに分けて見ていきます。
- 稼働率:一般的なSaaSでは99.8%〜99.99%。計画停止を除く実稼働時間で算出します。
- 復旧目標:RTO(目標復旧時間)は復旧までの目標(例:24時間以内)、RPO(目標復旧時点)はデータ時点(例:24時間前)です。
- 合意期間:目標を調整し関係者が合意するまで、通常は数週間から1か月かかります。
- 監視基盤:CPUやディスクを自動で監視して月次レポートを作成し、障害は10〜60分以内に検知します。
- アラート調整:感度の見直しに数週間かけます。近年導入が進むAIOps(AIによる運用)は、正常動作から異常を検知し、最適化を早めます。
障害の自動通報は、ハードウェア障害やリソースの閾値超過を検知します。一方で、アラート感度が低いと異常を見逃し、高すぎると対応工数が膨らみます。
オンコール・ランブック整備の期間
24時間365日の安定稼働を求めるサービスには、夜間や休日の障害に即応するオンコール体制が欠かせません。
- 当番体制:当番制と連絡経路を決め、エスカレーションルールと対応手順を整えます。
- 受付範囲:平日日中のみから24時間365日の専任体制まで、重要度に応じて設計します。
- 月額費用:24時間365日対応は、平日日中のみの契約より2倍以上になる場合があります。
- ランブック:障害ごとに、検知から事後報告までの手順を文書にまとめ、属人化や対応品質の差を抑えます。
- 整備時期:引き継ぎ後半の4〜8週目を中心に、実際の対応を通じて手順を磨きます。
24時間365日対応では、夜間・休日の待機要員をベンダーが確保します。
継続的デリバリー(CI/CD)による運用保守の納期への影響
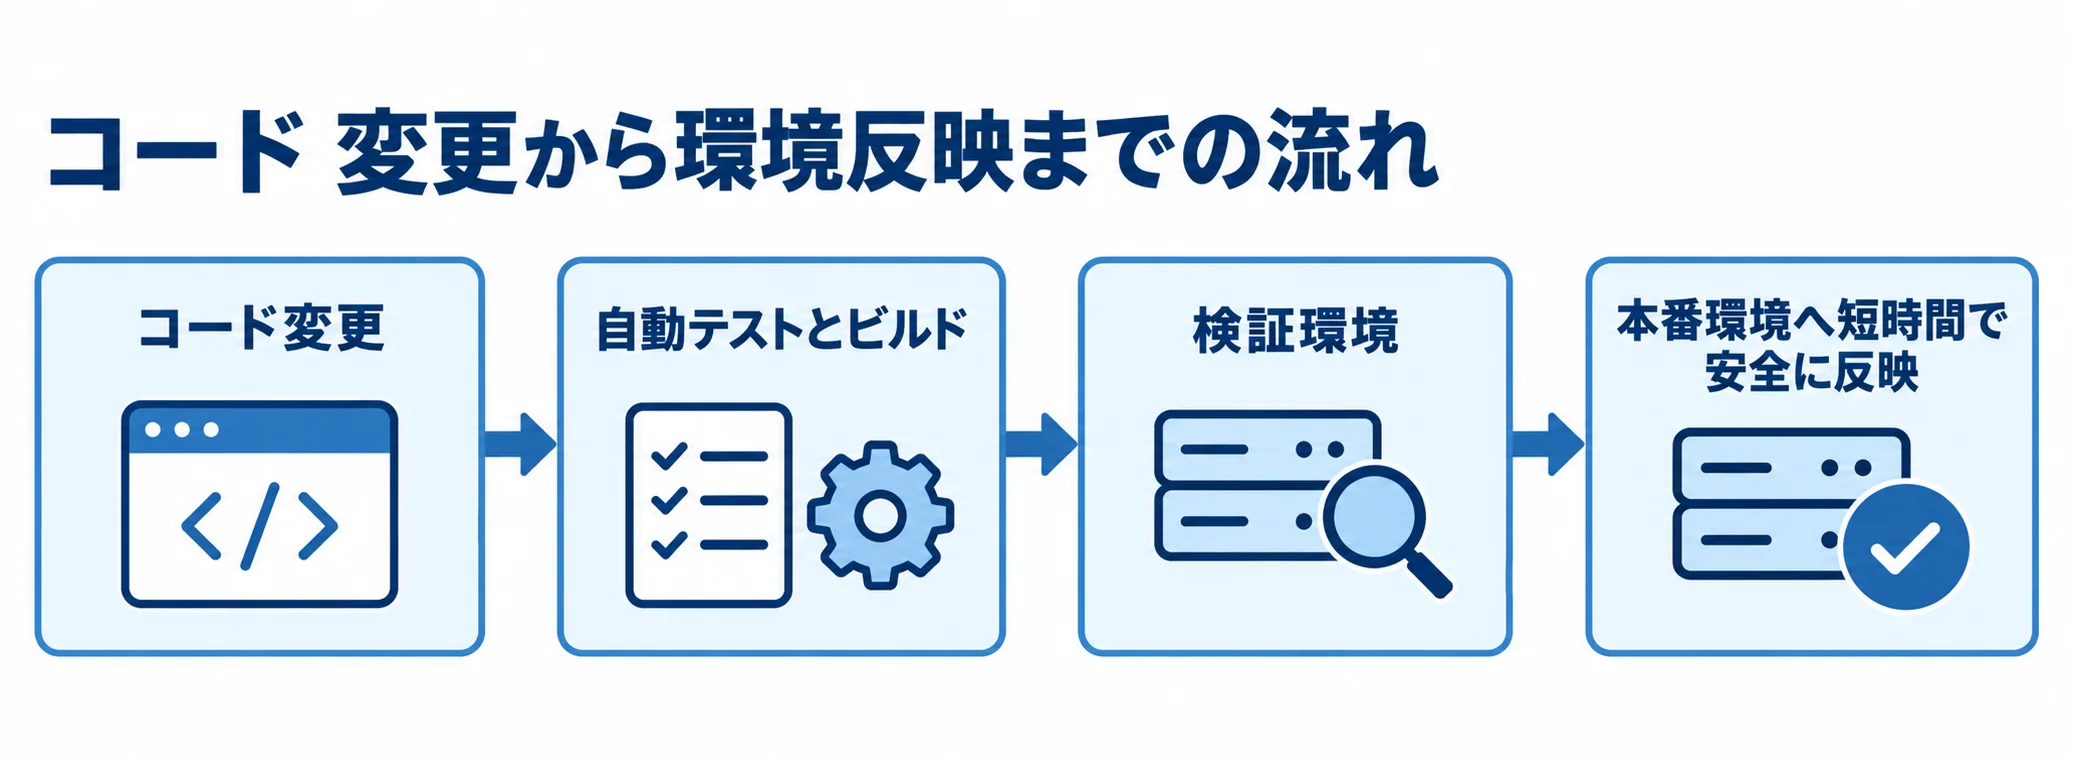
運用保守の納期は、機能改善やバグ修正を短いリードタイムで本番に届けられるかどうかで決まります。その仕組みを支えるのが、継続的インテグレーション・継続的デリバリー(CI/CD)です。
CI/CDがない場合、変更のたびにビルド、テスト、デプロイを手作業で行います。そのため、小さな変更でも数日かかり、人為的なミスのリスクもあります。
CI/CDパイプラインがあれば、コード変更を契機に自動テストとビルドを実行し、検証環境や本番環境へ短時間で安全に反映できます。
成長を続けるWebサービス/SaaSでは、CI/CDへの投資が、効率化にとどまらず、運用保守の納期を根本から短くする基盤になります。
リリースサイクルの短縮
リリース周期の長短によって、障害原因の特定や納期管理のしやすさが変わります。周期ごとの方式の違いと、納期管理・事前準備の要点を、順に見ていきます。
- ビッグバンリリース:従来は月次・四半期ごとに変更をまとめる方式が一般的でした。
- 短い周期:成長中のWebサービス/SaaSでは、週次・隔週・日次で出す方式が主流です。
- 納期管理:次のスプリント(1〜2週間)までの短い単位で管理できます。
- 事前準備:短い周期の実現に向け、リリース方針と切り戻し計画を決めます。
一度に多くの変更を入れると、障害時に原因を特定しにくくなり、切り戻し(ロールバック)の影響範囲も大きくなります。
反対に、小さな変更では問題の原因を特定しやすくなります。開発サイクルが短いWebサービスでは、運用側も同じ速度に追従します。
自動化による恒常的な納期短縮
運用保守の納期を恒常的に短縮するには、繰り返し行う作業を自動化するのが効果的です。テストや環境構築、日々の運用を自動化したときの効果を、順に見ていきます。
- 自動テスト:ユニットテストや結合テスト、E2EテストをCI/CDで実行し、変更ごとに既存機能を検証して回帰工数を減らします。
- IaC:Infrastructure as Codeで環境構成をコード化し、環境を短時間で構築・複製できます。
- 運用自動化:監視や障害対応の定型作業を減らし、機能改善や性能向上へ工数を回します。
- 投資効果:初期の立ち上げは延びますが、定常運用後のリリース時間を継続的に縮めます。
環境の設定差を抑えれば、環境の違いから生じる不具合も減らせます。さらに、サービス期間全体で見ると、納期面での利益は大きくなります。とくに、継続的に成長するサービスほど、投資の見返りが大きくなります。
段階的リリースとロールバック
稼働中のWebサービス/SaaSへの変更は、一度に全ユーザーへ反映せず、影響を確かめながら段階的に広げると安全です。
- カナリアリリース:一部のユーザーやサーバーに新バージョンを先行適用します。
- ブルーグリーン:新旧2つの環境を用意して切り替えます。
- 切り戻し:問題時に旧版へ戻せる設計で、障害からの復旧時間を短縮します。
- 納期の区分:本番反映と全ユーザーへの展開完了を分け、後者は数日かけて広げます。
- 計画の準備:毎回切り戻し計画を用意し、信頼性を保ってリリース頻度を高めます。
運用保守の納期を短縮する具体的な方法
立ち上げや定常運用のリリースを速めるには、一時的な準備を通じて、継続的な対応速度を高めます。主な方法は、ランブックの整備、監視の自動化、並走運用です。
ランブック整備による属人化の排除
担当者が不在でも対応を止めず、納期のばらつきを抑えるには、手順を共有して更新し続けることが大切です。
- 属人化の影響:休暇や離職で障害対応や定例作業が止まる場合があります。
- 文書化する手順:障害対応や定期メンテナンスの手順を、デプロイやバックアップ・リストアとあわせてまとめます。
- 自動化:手順をスクリプト化すると、復旧や定例作業をさらに速められます。
- 更新ルール:機能追加のたびにランブックを更新し、情報の陳腐化を防ぎます。
ランブックがあれば、担当が替わった後も一定の品質と時間で対応でき、納期のばらつきを減らせます。
監視自動化とAIOpsによる検知の高速化
検知から復旧までを短縮するには、監視指標と通知方法を整え、アラートを継続的に調整します。
- 自動監視:CPUなどのリソース状況と応答時間を監視し、閾値超過を通知します。
- 通報時間:10〜60分以内の障害自動通報で、初動と復旧を早めます。
- AIOps:正常動作の学習やログ分析で異常を捉え、原因候補を示して特定を速めます。
- 感度調整:過剰通知は工数を増やし、見逃しは重大障害につながるため、設定を見直します。
並走運用と知識移管
現行担当者と新体制が並走すると、品質を保ちながら知識を移し、自走を早められます。
- 新体制の単独移行:想定外の事象に対応できず、障害が長引く恐れがあります。
- 実地の知識移管:新体制が一次対応し、現行担当者の支援下で実例を学びます。
- 共有資料:構成図、障害と対応の記録、問い合わせのナレッジベースを整えます。
- 継続的な共有:新機能のたびに知識を記録・共有し、定常運用の対応速度を高めます。
対応内容と解決策は、ランブックに反映します。並走期間が適切であれば、全体日程を延ばしすぎずに定常運用へ移れます。
納期遅延・スケジュール超過の典型要因と対策
遅延の主な原因は、文書の不足と属人化に加え、SLA交渉や監視調整です。アクセス権や環境の準備も遅れを招きやすく、事前に予測して対策すると影響を抑えられます。
ドキュメント不備と属人化
文書が不足していたり、知識が担当者に集中していたりすると、新体制がシステムを理解するまでの時間が延びます。そこで、予防策を具体的に決めておきます。
- 不足の影響:古い設計書、未記録の障害、担当者だけが知る仕様が理解を遅らせます。
- 契約時の合意:文書の担当者、期限、詳しさを決め、聞き取り時間も計画します。
- 不足の補完:引き継ぎ中に見つけた内容をランブック等へ追記し、調査の重複を防ぎます。
- 日程の余裕:解消には時間がかかるため、2〜3週間程度のバッファを確保します。
SLA条件交渉の長期化
SLA交渉では、条件の種類とサービスに見合う目標を、交渉の前に整理しておく必要があります。
- 交渉条件:稼働率と復旧時間を決めたうえで、未達時の減額・違約金やエスカレーション体制を定めます。
- 努力目標型:ペナルティを設けず、改善努力を促します。
- 目標保証型:未達時に費用減額などのペナルティが生じます。
- 社内で決めること:可用性要件と許容停止時間を交渉前に固めます。
- 目標水準:重要度に合う水準を選びます。可用性目標を1段階上げると、費用と立ち上げ期間が大きく増えます。
条件は発注側と受注側の利害が異なるため、合意に時間がかかることがあります。選ぶ目標型によって、交渉の難しさも変わります。
未達時にペナルティがない契約は、実質的にSLAがないのと同じとみなされる点に注意が必要です。また、過剰に厳しい条件も避ける必要があります。
監視アラートのチューニング反復
感度調整は反復する可能性があるため、優先する指標と調整期間を先に決めておきます。
- 誤検知:通知が多すぎると対応工数が増えます。
- 見逃し:閾値が緩いと重要な異常を検知できません。
- 調整期間:立ち上げ計画に2〜4週間を確保します。
- 優先順位:停止や応答劣化など影響の大きい指標から整え、その後対象を広げます。
- AIOps:学習から閾値を動的に調整し、反復期間を縮める場合があります。
調整の反復は、定常運用への移行を遅らせることがあります。定常運用に入った後も最適化は続くため、立ち上げ時に完璧を求めすぎないことが、日程を守る助けになります。
まとめ
運用保守の期間は、立ち上げの約6〜8か月と、定常運用で続くリリースのリードタイムに分けて考えます。
立ち上げでは、SLAと監視、引き継ぎを段階的に進めます。オンコールとランブックも、あわせて整えます。引き継ぎは、4ステップ・約8週間の並走運用で品質を保ちます。
定常運用では、CI/CDと自動化が納期の短縮を支えます。段階的リリースと切り戻しも、リスクを抑えるのに役立ちます。文書不足、SLA交渉、アラート調整には、合意形成やバッファで対応します。
体制を構築する際は、複数社に相談し、自社サービスの可用性要件に合う体制と期間を見極めることが大切です。
▼全体ガイドの記事
・サービス運用保守の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・Webサービス開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。