
サービス運用保守の事例は、ベンダー乗り換え、障害からの立て直し、ひとり情シスの運用委託の3つに分けて見ると、自社に近い事例を探しやすくなります。Webサービスやクラウドサービスの運用保守を外部に委託したい、あるいは内製体制を立て直したいと考えるときに、参考になる見方です。
本記事で扱うのは、SaaSやWebサービス全般の運用保守(監視・インシデント対応・SLA管理・継続的改善の総称)における導入事例・開発事例・活用事例です。だからこそ、抽象的な理論よりも、乗り換え前後で障害件数がどう変わったかを見ることが大切です。全体像をまだ把握していない方は、サービス運用保守の完全ガイドから読むことをおすすめします。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えでTCOを逆転させた事例
サービス運用保守でもっとも投資判断が難しいのが、既存ベンダーからの乗り換えです。保守費が割高だと感じていても、「乗り換えには移行コストがかかる」「いまのシステムを一番理解しているのは現行ベンダーだ」という理由で、踏み切れない企業は少なくありません。
しかし事例を見ると、目先の移行コストにとらわれず、中長期のTCO(総保有コスト)で判断した企業が、運用品質とコストの両面で成果を出しています。
移行コスト300〜500万円が5年TCOで逆転した事例
乗り換えの効果をもっとも具体的に示すのが、TCOのBefore/Afterです。一次データでは、運用保守ベンダーを切り替える際の移行コストは300〜500万円程度かかる一方、月々の保守費が下がることで、5年間のTCOでは逆転し、トータルで安くなるケースが報告されています。
重要なのは、乗り換えの是非を初年度の支出だけで判断しないことです。移行に一時的な費用がかかっても、その後の数年間で保守費や障害対応費が下がれば、累積では十分にペイします。
この判断を支えるのは、TCOを数字で比べることです。まず、現行ベンダーへの年間保守費、障害発生時の追加対応費、改修1件あたりの費用を洗い出し、5年スパンで累計を比べます。
さらに、ベンダー選定では既存ベンダーをあえてRFP(提案依頼書)に参加させ、条件を見直したうえで継続を選ぶケースも30〜40%あるとされます。現行ベンダーとの競争で条件を引き出すことも、乗り換えを検討した立派な成果です。事例を読むときは、こうしたTCOの数字を自社に当てはめて試算してみるとよいでしょう。
乗り換えを検討するときは、移行コストと、既存ベンダーに条件を見直させる選択肢を並べて比べます。
- 移行コスト:一時的な移行費を、5年間のTCOで回収できるかを見る
- 既存ベンダーの条件見直し:乗り換えの代わりに、条件を見直して継続する選択も比べる
8週間の段階引き継ぎで無停止移行した事例
乗り換えの成否を分けるのは、価格よりもむしろ引き継ぎの設計です。
ベンダー選定そのものも、余裕をもって始めることが成功の条件です。
契約切れ直前に慌てて乗り換えようとすると、引き継ぎが雑になり、移行直後に障害が頻発する典型的な失敗に陥ります。乗り換えの事例から学べるのは、「安いベンダーを探すこと」より「十分な時間をかけて引き継ぎを設計すること」が、運用の連続性を守る鍵だという点です。
引き継ぎを軽視した結果は、後述する失敗・リスクの観点とも深く関わるため、関連記事もあわせてご覧ください。
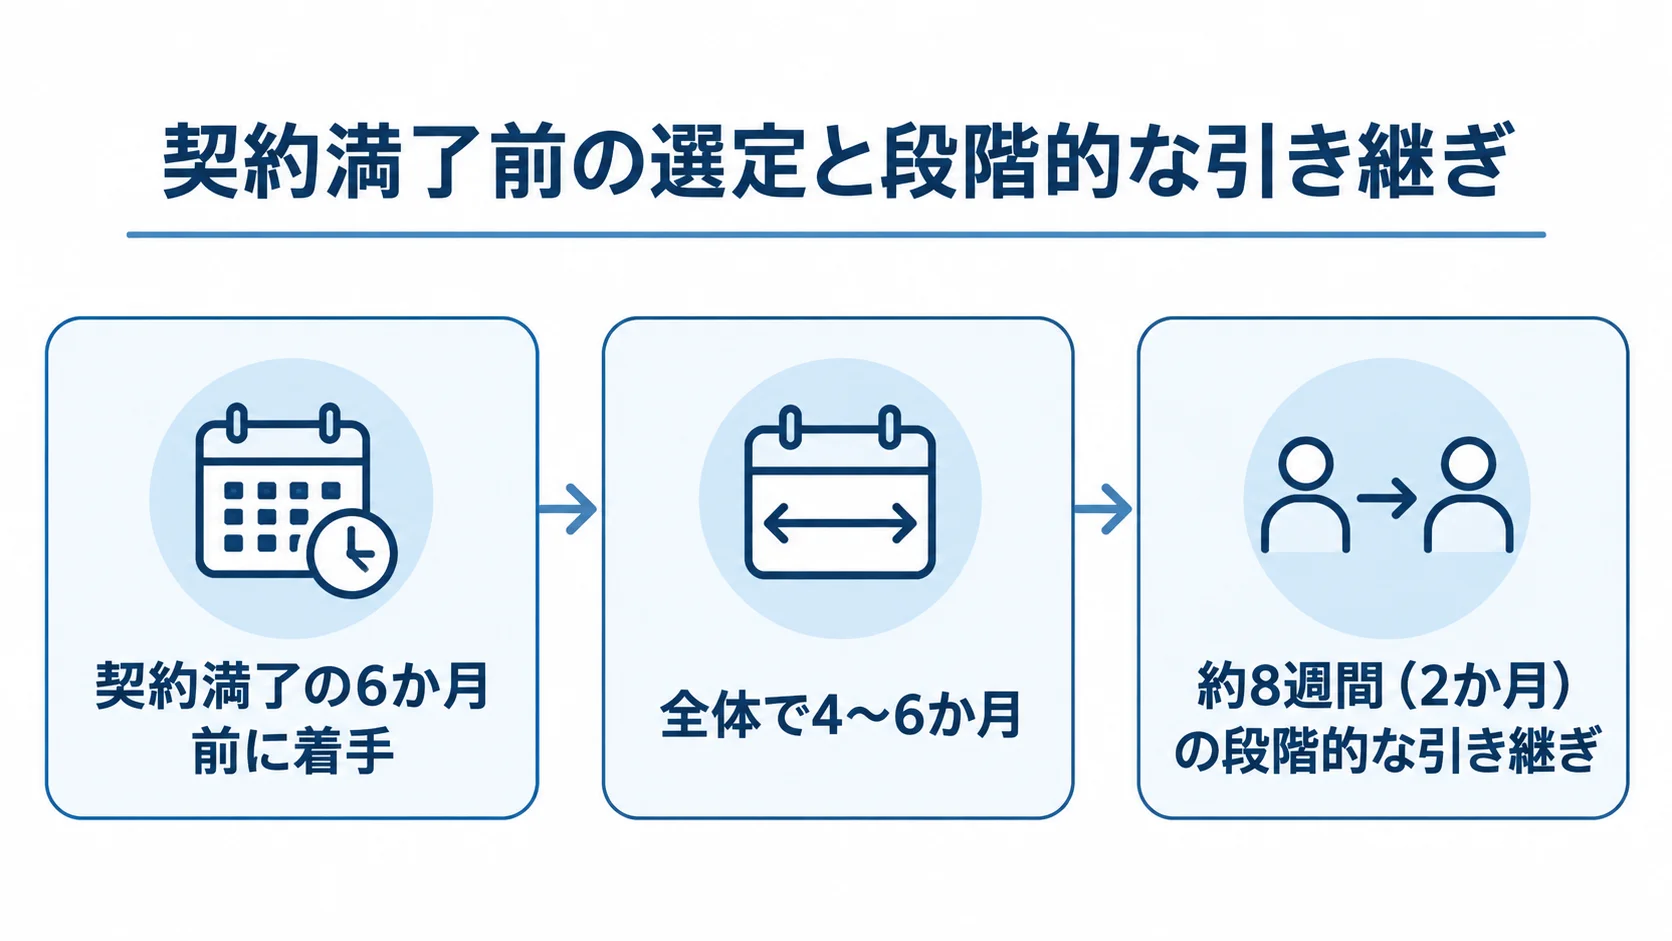
成功事例が押さえていたのは、引き継ぎの期間と、選定を始める時期です。
- 段階的な引き継ぎ:約8週間(2か月)かけて、運用を段階的に移管する
- 選定の開始時期:契約満了の6か月前に着手し、全体で4〜6か月かけて進める
一次データでは、この引き継ぎに委託先のPM0.25人月とリードエンジニア1.0人月を充て、現行担当者には週2日の協力を求める体制が一つの目安とされます。そのうえで、ドキュメントの引き渡し、監視設定の移行、障害対応手順の共有は、一度にまとめて行うより、フェーズを分けて並走させるほうが、サービスを止めずに移行できます。
大規模障害からの火消しと立て直し事例
発注側がもっとも学べるのは、頻発する障害をどう収束させ、どう再発防止の体制に変えたかという、リアルな火消しの経験です。安定運用の成功談と合わせて読むと、事例の価値がつかみやすくなります。
SLAが守れず、深夜の障害対応に現場が疲弊し、得意先から信頼を失いかけた状態から、定量管理に基づく運用へ立て直した事例には、再現可能な打ち手が詰まっています。
SLA指標を導入して障害対応を定量化した事例
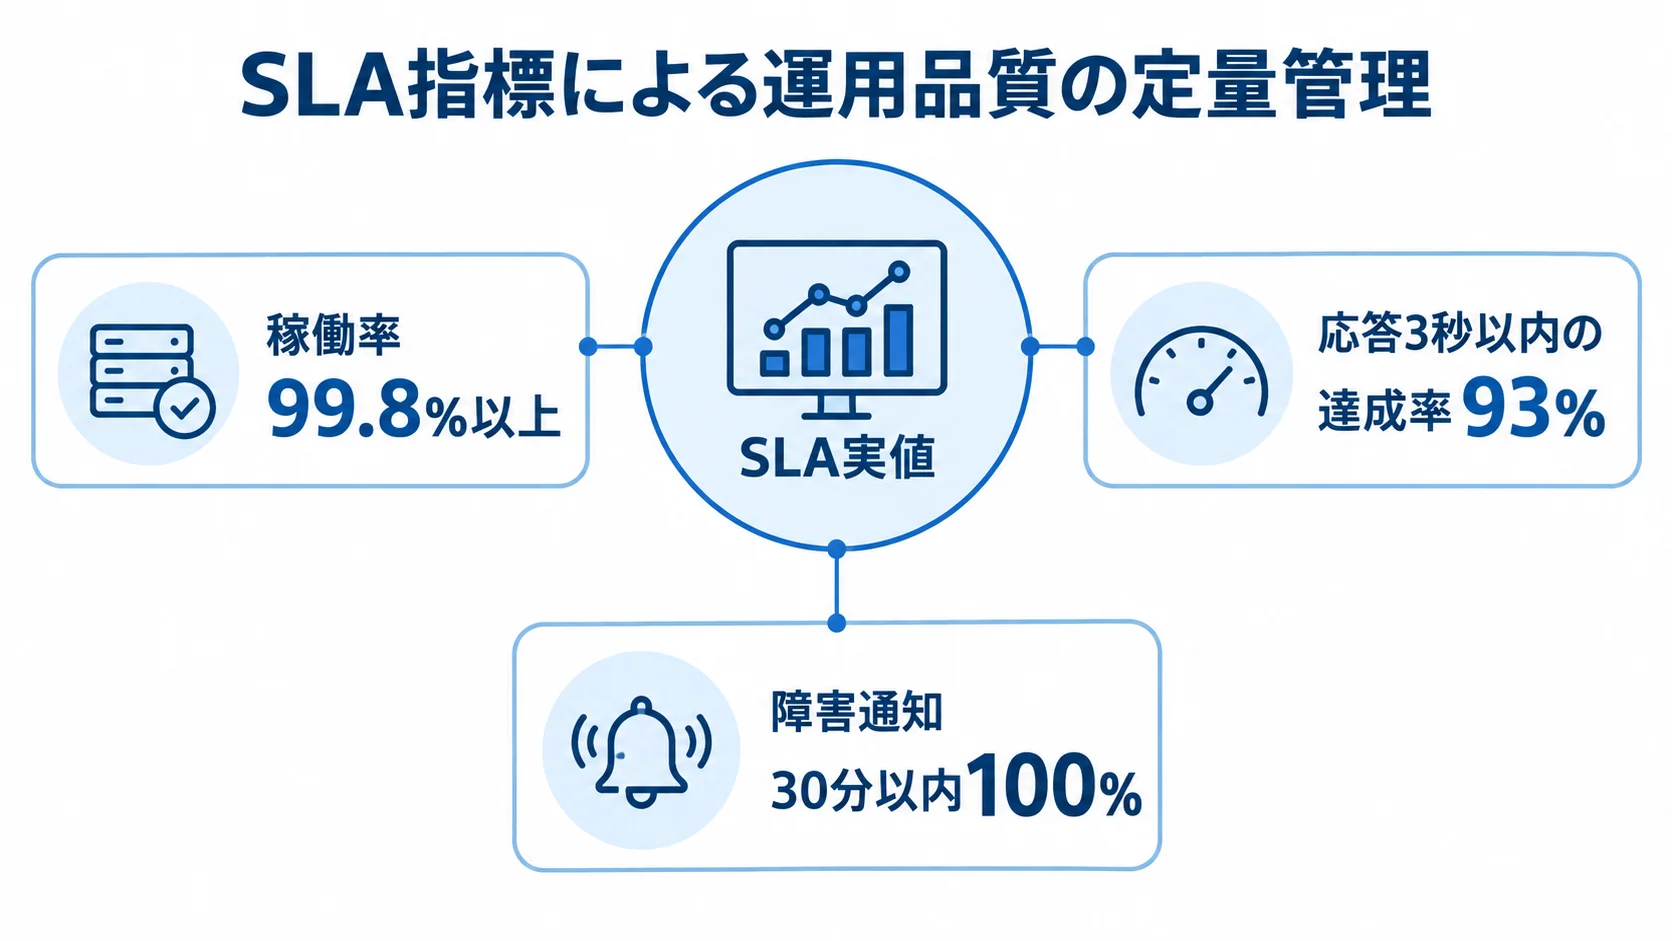
立て直し事例に共通するのは、まず運用品質を測る物差しを導入したことです。大阪市のガイドラインに示されるSLA実値を参考にすると、稼働率99.8%以上、応答3秒以内の達成率93%、障害通知30分以内100%という水準が並びます。
さらに、重大障害は年2回まで、復旧6時間以内・4時間以内の遵守率95%、電話応答20秒以内、24時間以内の解決率95%といった指標も示されています。立て直しに成功した企業は、こうした指標を自社のサービスに当てはめ、「いまどこが守れていないか」を数字で把握することから始めています。
感覚的に「最近障害が多い」と言っているうちは、改善のしようがありません。障害通知が30分以内に100%できているか、重大障害が年2回を超えていないかを確かめると、何から手を付けるべきかが見えてきます。また、復旧時間の遵守率が95%に届いているかを月次で測ることで、初めて改善の優先順位が決まります。
火消しの事例から学べるのは、気合いで頑張るのではなく、指標で守れていない箇所を特定してそこに集中投資するという、定量管理の威力です。SaaSの場合はこれにRTO(目標復旧時間)・RPO(目標復旧時点)が加わり、障害時にどこまでデータを戻し、どれだけ早く復旧させるかを設計に織り込みます。
立て直しの進み具合は、通知の達成状況と障害件数の推移で数字として追えます。
- 障害通知の達成状況:30分以内の通知が100%に届いているかを見る
- 重大障害の年間件数:年2回までに収まっているかを、推移で確かめる
調査・分析に工数を割き再発防止した事例
火消しに成功した企業は、目先の復旧だけでなく、根本原因の調査・分析に十分な工数を割いています。一次データでは、保守作業全体の約30%が調査・分析に費やされるとされ、これは無駄ではなく再発防止の核心です。
障害のたびに対症療法で復旧させるままでは、同じ障害が繰り返し起き、現場は疲弊し続けます。一方で、なぜ起きたのかを掘り下げ、設計や監視の不備を恒久対策で潰すことが、障害件数のBefore/Afterを生む分岐点になります。
火消しの事例が教えるのは、障害をゼロにすることより、障害を確実に検知し、根本原因まで遡って潰す仕組みを回し続けることが、結果的に障害件数を減らすという原則です。riplaはフルスクラッチ受託と国内運用保守の立場から、この調査・分析を起点とした継続的改善を重視しています。
立て直しの過程では、障害の記録を蓄積し、傾向を分析する文化も根づきます。根本原因を潰すには、その傾向を見ることと、設計や監視そのものを直すことの両方が要ります。
- 障害の傾向の分析:障害の記録を積み重ね、起きやすい場面を見つける
- 設計・監視の不備への恒久対策:原因まで遡って直し、同じ障害を繰り返さないようにする
この分析によって、どの時間帯に、どのコンポーネントで、どんな条件で障害が起きやすいかを把握でき、監視のしきい値や自動復旧のロジックを改善できます。
ひとり情シス・極小体制の運用アウトソーシング事例
運用保守の事例で見落とされがちなのが、ひとり情シスや極小体制で運用を回している企業の現実です。大企業の華やかな事例とは別に、担当者がたった一人で監視・障害対応・改修依頼の窓口をすべて抱え、休暇も取れずに疲弊している現場は数多くあります。
こうした企業が運用の一部または全部をアウトソースして救われた事例こそ、同じ境遇の担当者にとって最も参考になります。
監視と一次対応を委託し属人化を解消した事例
ひとり情シスの最大のリスクは、その一人が倒れたり退職したりすると、運用が完全に止まる属人化です。そこで、立て直し事例では、まず監視と障害の一次対応をアウトソースし、担当者を24時間の張り付きから解放しています。
一方で、自社の担当者は事業に直結する改善や業務部門との調整といった付加価値の高い仕事に集中できます。この役割分担が、極小体制の持続可能性を高めます。
特に重要なのは、すべてを丸投げするのではなく、何を委託し何を内製に残すかを明確にすることです。サービスの仕様や事業上の判断が必要な部分は自社に残し、定型運用は委託します。
この切り分けができれば、ひとり情シスでも安定運用が実現します。事例から学べるのは、極小体制では「全部を一人で抱える」のではなく「定型を外に出し、判断を内に残す」という発想の転換が突破口になるという点です。
委託範囲を曖昧にすると責任の所在が不明確になり、トラブルの元になります。そのため、契約書で範囲を明記しておくことが前提になります。
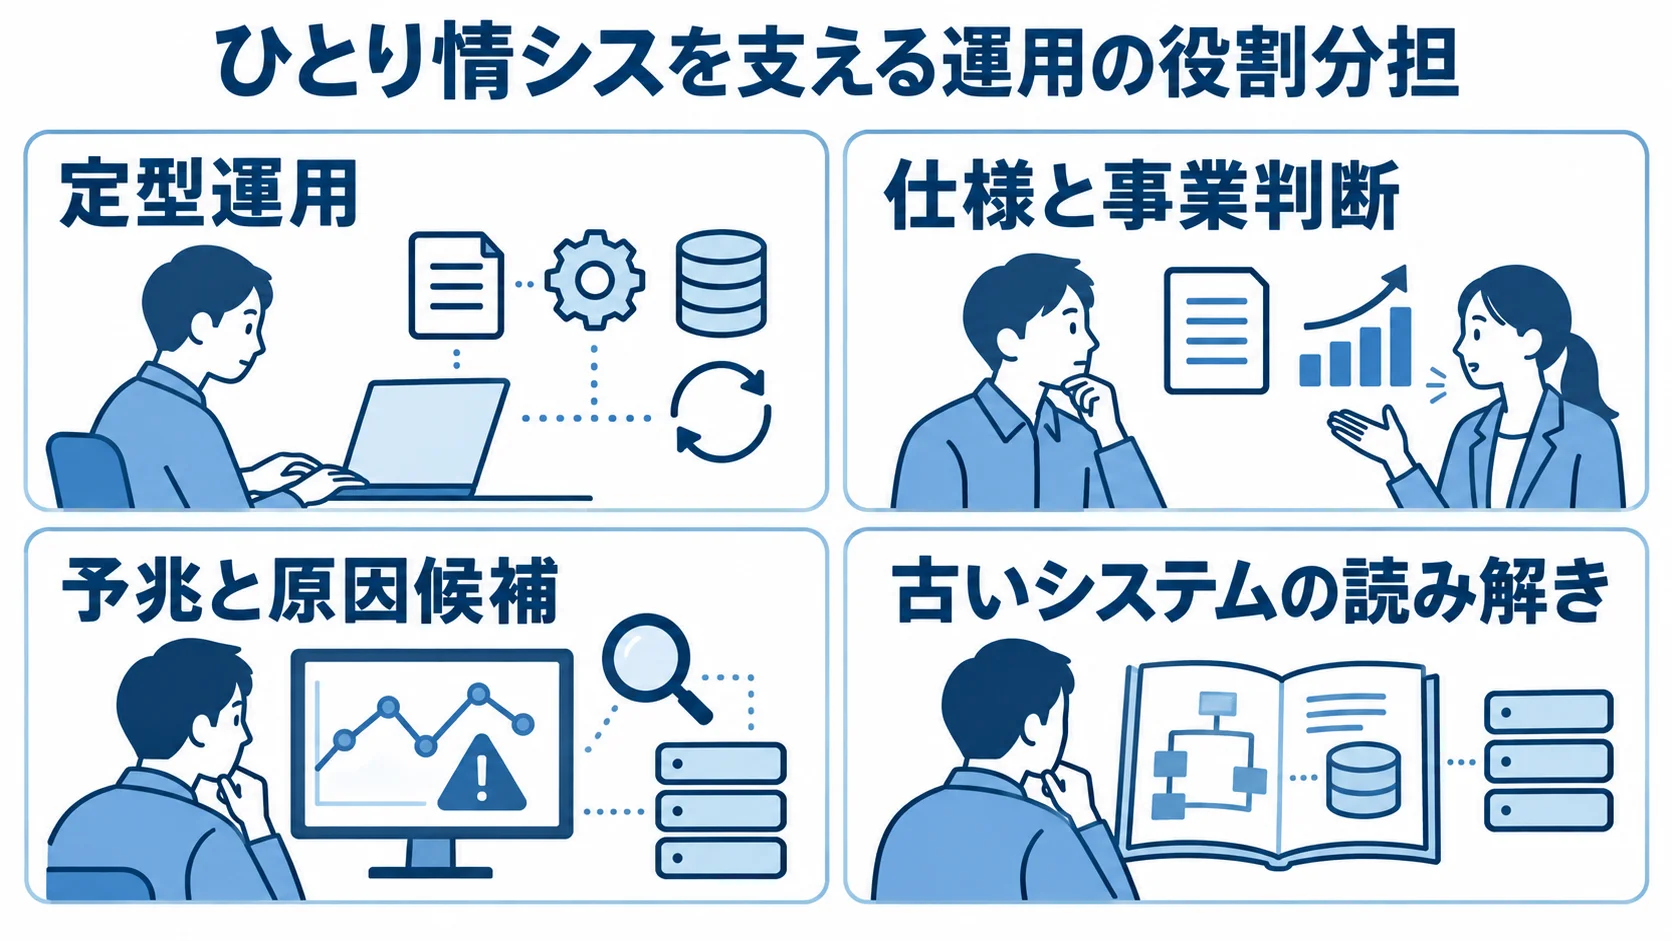
委託と内製は、定型的な作業と判断を要する作業で分けて考えます。
- 定型運用:生死監視やリソース監視など、手順が決まっている作業を委託する
- 仕様と事業判断:サービスの仕様や事業上の判断は、自社に残して任せきりにしない
定型作業には、しきい値超過のアラート受信も含まれます。
AIOps活用で運用を省力化した事例
近年の運用保守事例で増えているのが、AIOps(AIを活用した運用自動化)や生成AIによる省力化です。一次データでも、AIOpsや生成AIを用いたリバースエンジニアリングによって、運用保守の工数を削減できる流れが示されています。
とくにドキュメントが整備されていない古いシステムでは、生成AIによるコードの読み解きが、属人化したブラックボックスの解消に役立ちます。これまで「作った本人しか分からない」状態だった処理も、AIの支援で中身が分かるようにすれば、引き継ぎや改修の難易度を下げられます。
ひとり情シスの事例が示すのは、人手を増やせない制約下でこそ、委託とAIOpsを組み合わせて運用の生産性を底上げする、現実的な打ち手の有効性です。自社の体制と予算に応じて、最適な省力化の入り口を選ぶことが大切です。
AIを使った省力化は、次の2つの場面で役立ちます。
- 予兆と原因候補:異常の兆しを見つけ、原因の候補を示す
- 古いシステムの読み解き:ドキュメントが不足する場合に、生成AIで処理の中身を把握する
AIが大量のログやメトリクスを分析し、過去の障害との類似性も手がかりにすることで、少人数でも高度な運用が可能になります。極小体制ほど、この自動化の恩恵は大きいといえます。
まとめ
サービス運用保守の事例を振り返ると、成功も立て直しも、「受け身の障害対応からSLAに基づく定量管理へ移行し、乗り換えや内製の判断を5年TCOで行い、調査・分析を起点に継続的改善を回す」という一点に集約されます。事例では、ベンダー乗り換えは移行コスト300〜500万円を投じても5年TCOで逆転します。また、SLA指標の導入は、火消しと再発防止の物差しになります。
ひとり情シスは、委託とAIOpsの併用で持続可能になります。保守費用はソフトウェア全体コストの40〜80%を占めるからこそ、運用保守の巧拙が事業の収益性を左右します。
事例を読むときに大切なのは、「どんなツールを入れたか」ではなく「なぜ運用が安定したのか」という視点です。自社のサービス規模と体制に照らし、まずはSLA指標を数字で追うことと、定型運用の切り分けから一歩を踏み出してください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、定量管理と継続的改善で「作った後も止まらないサービス」づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。