
発注企業の視点で運用保守の事例を見ると、乗り換えによるコスト削減、障害件数の改善、火消し型の立て直し、ひとり情シスの委託の4つに分けられます。
導入・開発・活用・成功の事例を発注企業の視点で掘り下げ、各事例でどこから着手し何を狙ったかを、一次データとあわせて紹介します。全体像はシステム運用保守の完全ガイドから確認できます。
▼全体ガイドの記事
・システム運用保守の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ベンダー乗り換えでTCOを削減した運用保守事例
運用保守の事例のなかで経営層にもっとも響くのが、ベンダーを乗り換えて総保有コスト(TCO)を下げた事例です。
長年同じベンダーに保守を任せていると、保守費が「言い値」のまま高止まりしがちです。さらに、その内訳もブラックボックス化していきます。
乗り換え事例は、この高止まりした保守費に切り込み、適正な水準まで引き下げた実例です。自社の保守費を見直すときの参考になります。
開発費の15〜20%という相場で保守費を見直した事例
運用保守費の適正水準を測る一つの目安が、「年間保守費=開発費の15〜20%」という相場です(出典:ripla)。3,000万円で開発したシステムなら、年間450〜600万円程度が基準になります。
中堅システムの保守は月額15〜50万円の幅で示されており(出典:ripla)、自社の月額がこの幅から外れていれば、内訳を精査する余地があります。
あわせて確認したいのが保守費の内訳です。一般に保守費は、定期保守が20〜30%、監視が15〜25%、障害対応が25〜35%を占めます。ほかに、問い合わせ対応(10〜20%)、軽微改修(10〜15%)、管理・報告(5〜10%)が含まれます(出典:ripla)。
乗り換え事例で成果を出した企業は、この内訳をベンダーに開示させ、「ほとんど障害が起きていないのに障害対応の枠が大きい」といった点を見つけています。そのうえで、実態に合わせて再設計しています。
内訳を一覧にするだけで、待機要員に払っているムダなコストを削れるケースは少なくありません。
見直しで確かめたいのは、次の2点です。
- 相場との比較:開発費の15〜20%と自社の年間保守費の差
- 内訳の枠:障害対応などの項目が、実態に合った大きさかどうか
初期コストより総保有コストで判断した乗り換え事例
乗り換え事例から学べる最大の教訓は、「目先の月額の安さ」ではなく、総保有コスト(TCO)で判断したことです。
保守ベンダーを変えるときには、移管にともなう一時的な二重コストや、ドキュメントの整備費、引き継ぎ期間中のリスクが必ず発生します。
移管にともなう一時的な負担を織り込まずに「月額が安くなる」だけで飛びつくと、初年度は逆にコストが膨らみます。
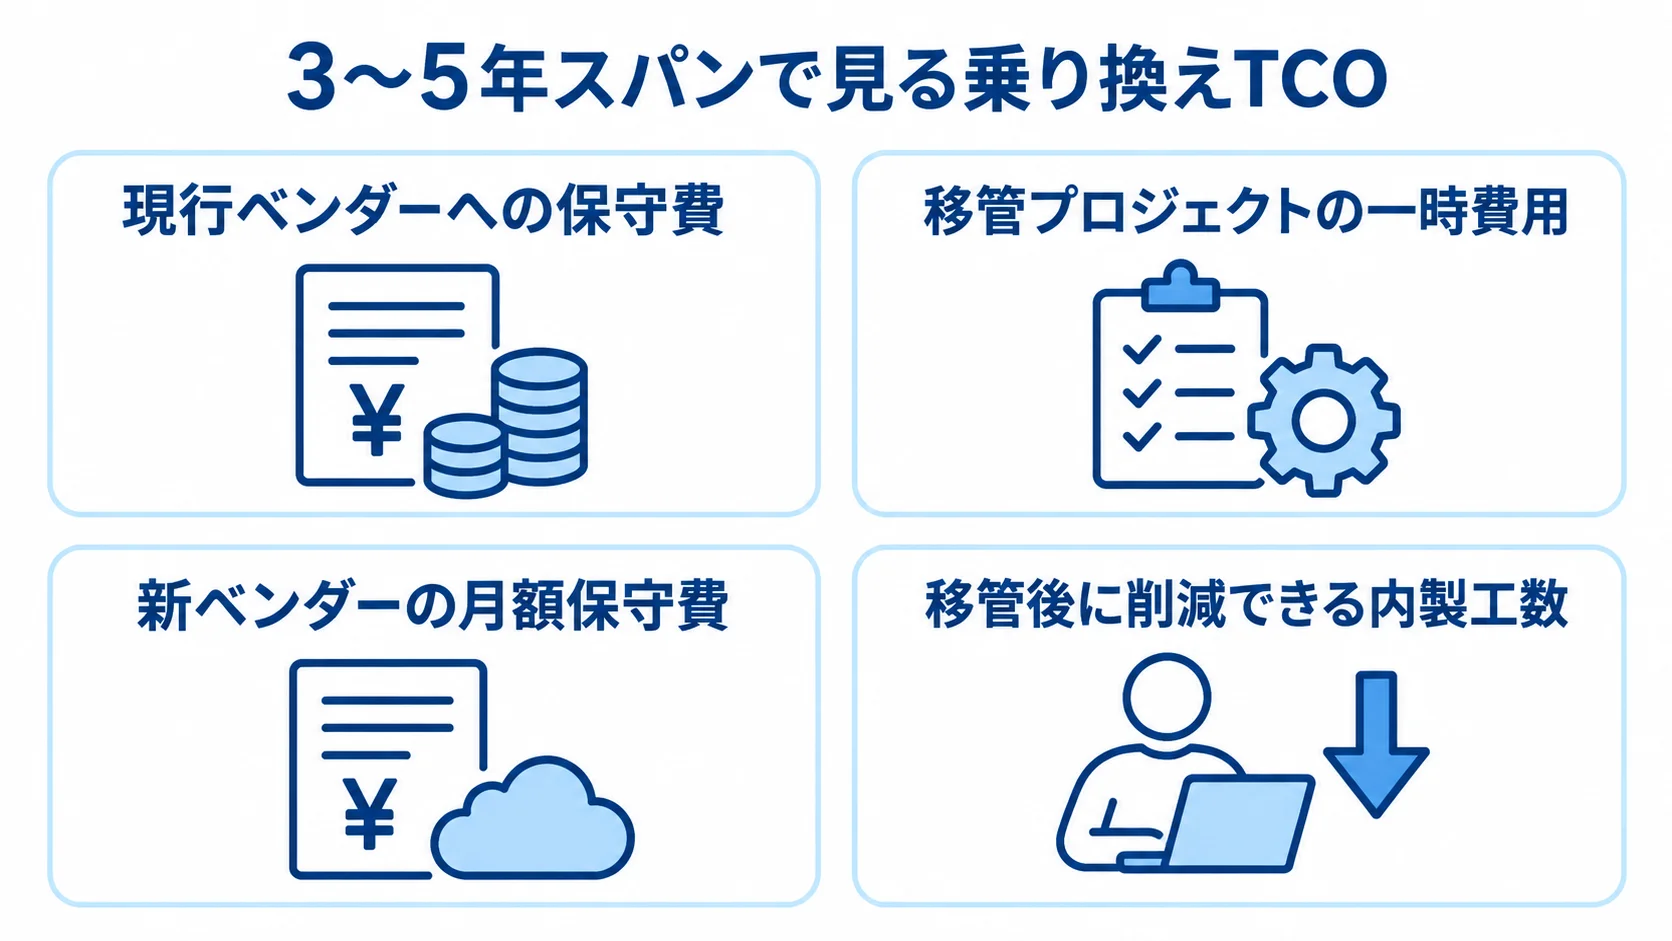
成功した企業は、移管初年度を含めた3〜5年スパンのTCOで比較し、長期で見て本当に下がるかを検証しています。
具体的には、現行ベンダーへの保守費と移管プロジェクトの一時費用を並べ、新ベンダーの月額保守費と移管後に削減できる内製工数も加えて、年度ごとの累積コストを試算します。
試算を一覧にすると、「2年目以降は明確に下がる」「移管しても3年では回収できない」といった判断が定量的にできるようになります。
運用保守の乗り換えは感情論になりがちですが、TCOという共通の言葉に落とすことで、経営層も納得できる意思決定になります。
移管の判断では、次の2点を比べておきます。
- 移管の初年度:一時的な負担が重なり、コストがもっとも膨らむ時期
- 回収までの期間:移管後に下がる月額で、移管費を取り戻せる時期の見通し
障害件数をBefore/Afterで改善した事例
運用保守の価値は、コストの削減に加えて、事業への貢献で測るものです。なかでも、障害の発生件数や復旧時間が改善したかどうかが本質です。
事例を読むときは、保守体制を変えた前後で、月あたりの障害件数、平均復旧時間、計画外の停止回数がどう変化したかというBefore/Afterに注目してください。
稼働率99.9%をSLAで担保し停止を減らした事例
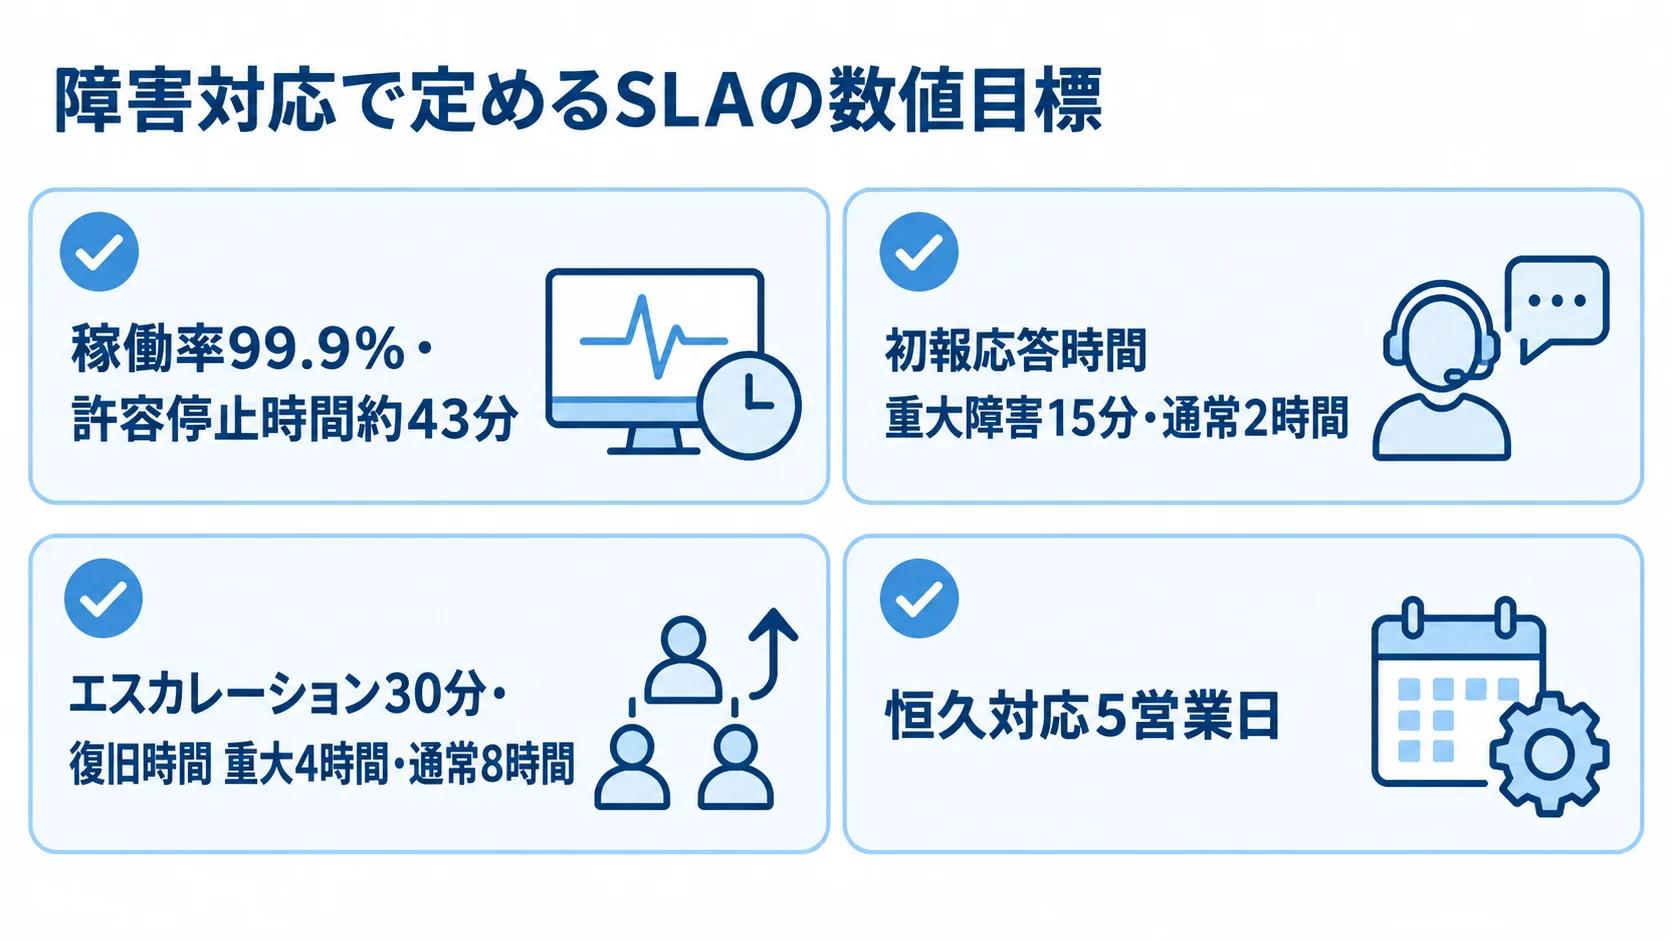
障害改善事例の多くは、SLA(サービス品質保証)の数値を明確に定めたことから始まっています。たとえば稼働率99.9%という指標は、月あたりの許容停止時間が約43分という厳しい水準を意味します(出典:ripla)。
稼働率99.9%を契約に明記し、達成状況を毎月レポートする運用に切り替えた企業では、ベンダー側に「止めない」という当事者意識が生まれ、結果として計画外停止が減りました。
SLAを設けず「がんばります」という努力目標だけだった頃は、障害が起きても誰の責任かが曖昧なまま放置されがちでした。
SLAは稼働率だけでなく、初報応答時間や復旧時間まで定めるのが効果的です。一次データでは、重大障害の初報応答が15分、通常は2時間です。エスカレーションは30分、復旧は重大4時間・通常8時間とされています。
運用基準には、恒久対応5営業日といった水準が用いられます(出典:ripla)。
事例企業は、こうした応答・復旧の時間目標を見える形にし、未達が続くベンダーには改善を求めています。その結果、障害の「件数」だけでなく「一件あたりの影響時間」も縮めています。
SLAを契約に落とすときは、次の2点を分けて決めておきます。
- ベンダーの責任範囲:どこまでを相手が受け持つかを、契約の線引きで示す
- 未達時の扱い:目標を外れたときに、改善をどう求めるかの取り決め
予防保守と監視強化で障害を未然に防いだ事例
障害件数を構造的に減らした事例に共通するのは、障害が起きてから直す「事後保守」から、兆候を捉えて先回りする「予防保守」へ重点を移したことです。
ディスク使用率やメモリ、レスポンスタイムを常時監視し、閾値を超える前にアラートを上げる仕組みを整えると、深夜にサービスが落ちて慌てて対応する事態そのものが減っていきます。
監視は保守費の15〜25%を占める領域ですが(出典:ripla)、ここへの投資が結果的に障害対応コストを圧縮します。
より進んだ事例では、過去のログやメトリクスを分析して異常の予兆を検知する、いわゆるAIOps的な自動検知を取り入れています。
人間が目視で気づく前に、システムが「いつもと違う挙動」を検出してエスカレーションするため、障害が小さいうちに手を打てます。
事例を読むときは「何件直したか」だけでなく「何件未然に防いだか」という予防の視点で評価すると、運用保守の真の価値が見えてきます。
予防保守を進めるときに分けて考えたいのは、次の2点です。
- 監視の対象:サーバーの状態だけでなく、業務に直結する処理の動き
- 検知の役割分担:システムの自動検知と、担当者による最終判断
火を噴いた基幹システムを立て直した火消し事例
運用保守の事例で、もっとも臨場感があるのは、すでにトラブルが頻発している「火を噴いた」システムを引き継いで立て直す、火消し型の事例です。
前のベンダーが匙を投げた、担当者が退職して属人化したまま放置された、といった状態のシステムを安定稼働まで戻す流れは、運用保守の総合力が問われる場面です。
属人化したブラックボックスを現状可視化した事例
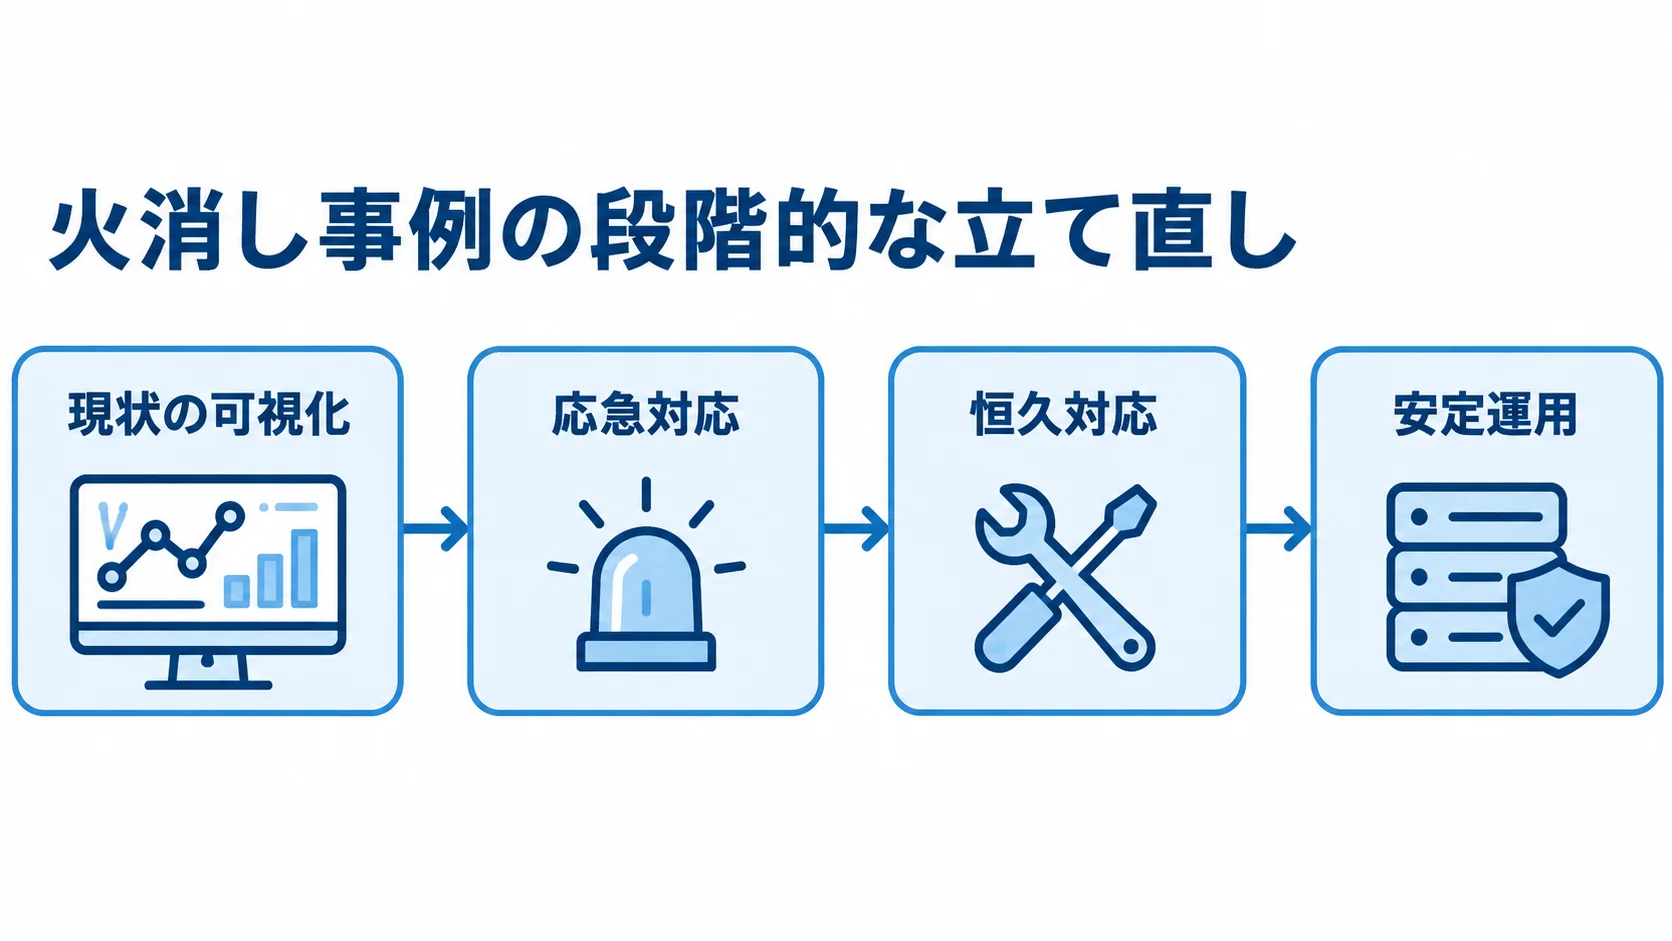
火消し事例の第一歩は、例外なく「現状の可視化」です。前任ベンダーや退職者しか把握していなかったのは、システム構成やサーバー設定です。
バッチの依存関係や運用手順も、ヒアリングとソースコード調査で一つずつ洗い出し、ドキュメントとして作り直します。
この作業を飛ばして場当たり的に火を消そうとすると、「直したつもりが別の箇所を壊す」という二次災害を招きます。構成図と運用手順が見えていて初めて、安全に手を入れられます。
立て直しに成功した企業は、可視化の過程で見つけた「触ると壊れる箇所」「設計上の地雷」を一覧にし、優先度をつけて順番に解消していきました。
まず事業継続を脅かす重大リスクから潰し、残りは段階的に進めます。この優先順位づけが、限られた予算と時間で状況を確実に好転させる鍵になります。
可視化は、立て直しの戦略そのものを描くための設計図です。
可視化の結果は、次の2つの形で残しておきます。
- 構成図と運用手順:後から安全に手を入れるための、基本となる資料
- 触ると壊れる箇所の一覧:優先度を付けて、解消の順番を決める材料
応急対応から恒久対応へ段階的に安定化した事例
火消し事例の典型的な流れは、まず止血のための応急対応で目の前の障害を抑え、その後に再発を防ぐ恒久対応へ進む二段階です。火消し事例は派手な成功談ではありませんが、運用保守の実力がもっとも問われる現場です。ベンダーを選ぶ際には、この現場での対応力が判断材料になります。
たとえば深夜にバッチが落ちる障害では、まず手動リカバリの手順を整えて当面の業務を回せるようにします。並行して、根本原因であるデータ不整合やリソース不足を解消していきます。この応急と恒久の切り分けが、現場を疲弊させずに状況を着実に改善するコツです。
riplaはフルスクラッチ受託と国内開発の立場から、こうした火消し案件でも「現状を可視化し、優先度をつけて段階的に立て直す」進め方を重視しています。
重大障害が落ち着いたあとは、監視やSLAの仕組みを整えて再発防止に転じ、平時の安定運用へ移します。
応急から恒久へ移るときに押さえたいのは、次の2点です。
- 応急対応の範囲:当面の業務を回すために、手順として残すもの
- 恒久対応の対象:同じ障害を繰り返さないための、根本原因の特定
ひとり情シスがマネージド委託で本来業務に集中できた事例
中小企業や成長中のスタートアップでよく見られるのが、情シス担当者が実質一人しかいない「ひとり情シス」の状態です。
この担当者は、ヘルプデスクや障害対応、ベンダー折衝まで一人で抱え込み、本来やるべきDX推進やシステム企画に手が回らない状態になりがちです。こうした悩みは、普遍的なものです。
運用保守を外部のマネージドサービスへ委託した事例は、このボトルネックを解消する一つの解決策になります。
定型運用を委託しコア業務に専念した事例
ひとり情シスの委託事例では、まず「自分でやるべき仕事」と「外に出せる仕事」を切り分けています。外に出しやすいのは、日々の監視やバックアップの確認、定型的な問い合わせの一次対応などです。
定期メンテナンスといった作業は、専門の委託先に任せることで、担当者は事業に直結する企画や社内調整に集中できます。
サービス委託型の運用は、月20万〜50万円程度の幅で示されており(出典:ripla)、一人を採用するコストと比べても現実的な選択肢です。
重要なのは、どこまでを委託し、どこを社内に残すかを決めておくことです。すべてを丸投げすると運用がブラックボックス化しかねず、逆に抱え込みすぎると担当者が疲弊します。
事例企業は、判断をともなう意思決定は社内に残し、手順が定まった定型作業を委託する、という切り分けで両者のバランスを取りました。
ひとり情シスは、「運用の番人」から「事業を前に進める企画者」へと役割を変えられたのです。
委託の範囲を決めるときに見ておきたいのは、次の2点です。
- 委託先の体制:定型作業を任せられる人員と手順が、きちんと整っているか
- 委託範囲の見直し:決めた線引きを、運用の状況に合わせて更新する
属人化リスクを外部委託で分散した事例
ひとり情シス最大のリスクは、その一人が休職・退職した瞬間にシステムが止まることです。
委託事例では、運用ノウハウを外部のチームと共有することで、「人が一人辞めたら終わり」という属人化リスクを分散させています。加えて、委託先がドキュメントを整備し、複数の担当者で運用を回す体制を組めば、社内の一人に依存しない継続性が生まれます。
運用サポートを外部に委ねるとき、定常的な運用の契約形態としては、準委任契約が一般的です(出典:ripla)。成果物の完成責任を負う請負とは異なり、準委任は「専門的な役務を継続的に提供する」契約で、日々の運用保守の実態に合っています。
事例から学べるのは、委託が人手不足の穴埋めにとどまらず、属人化リスクの分散と事業への集中という二重の効果をもたらす点です。自社のひとり情シスが疲弊しているなら、委託は前向きな経営判断になり得ます。
委託先を選ぶときに確かめたいのは、次の2点です。
- ドキュメントの整備:担当者が代わっても、運用の手順が回る状態であるか
- 契約の形態:定常的な運用を、どの契約で任せるかの取り決め
まとめ
運用保守の事例を振り返ると、成果を出した企業に共通するのは、コストと品質の両面を数字で捉え、現状を見える形にしたうえで段階的に改善している点です。ベンダー乗り換えでは月額の安さではなくTCOで判断し、障害改善ではSLAの数値(稼働率99.9%、初報応答15分など)を契約に落とし込んで、予防保守へ重点を移しています。
また、火消し案件では現状の可視化と応急・恒久の二段階で立て直し、ひとり情シスはマネージド委託によって属人化リスクを分散しながら、本来業務に集中していました。いずれも一次データの相場(保守費=開発費の15〜20%)を物差しに、自社の数字へ置き換えて判断しています。
事例を読むときは、「どんな手法を使ったか」よりも、「自社の状況にどう当てはまるか」という視点で見ることが大切です。自社のシステム規模や保守費の水準、情シス体制に照らして、まずは保守費の内訳を一覧にする、障害件数を洗い出すといった、効果の見えやすい一歩から始めてください。
riplaはフルスクラッチ受託と国内開発を組み合わせ、作ったあとも継続して伴走する運用保守を一貫して支援しています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。