
ソフトウェア運用保守は、契約すれば安心というものではありません。障害時に責任の所在が曖昧なまま復旧が長引いたり、ベンダーから抜けられず保守費が高止まりしたりといった失敗が起きます。また、「移管が泥沼化した」「予算化していなかった費用が突然降ってきた」という深刻な失敗も起きます。
これらは数年かけて表面化するため、後戻りが難しくなりがちです。全体像はソフトウェア運用保守の完全ガイドで確認できます。
▼全体ガイドの記事
・ソフトウェア運用保守の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
責任分界の曖昧さで障害が長引くリスク
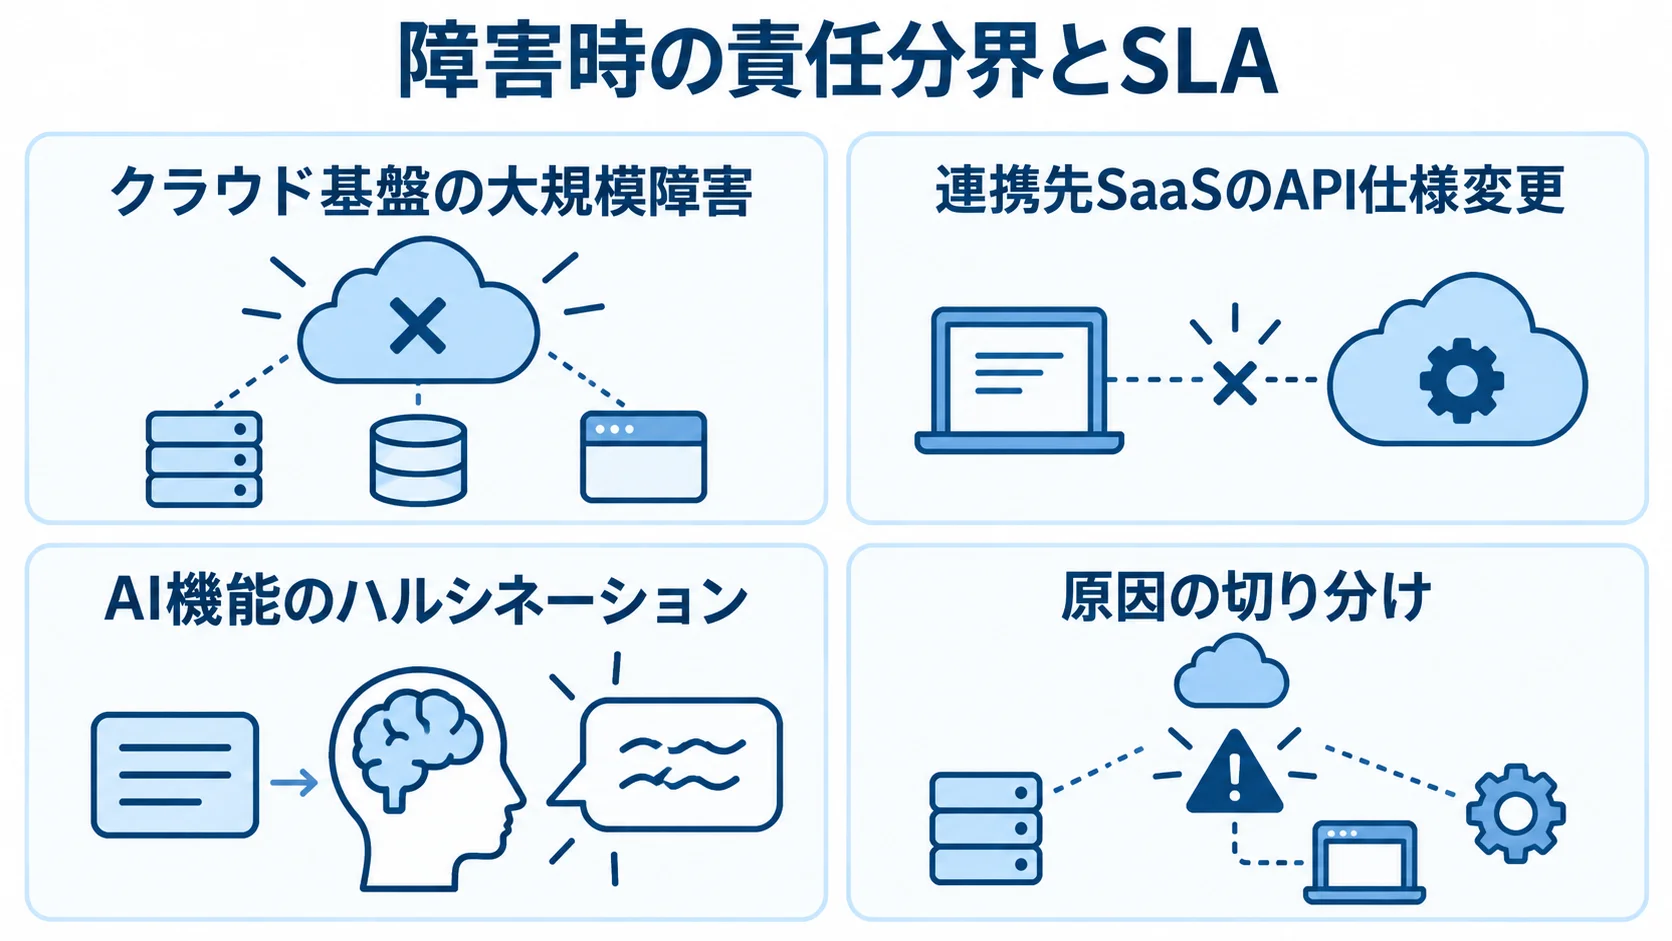
いま最も深刻化しているのが、責任分界点が曖昧なまま障害が起き、ベンダーと発注側が責任を押し付け合ってしまうリスクです。
いまのシステムは、クラウド基盤の上で動き、外部のSaaSと連携し、AI機能を組み込んでいることが多くあります。そのため、障害の原因がどこにあるのかが複雑になり、責任の所在も曖昧になりがちです。
ベンダーのコントロール外の障害という盲点
最も見落とされやすいのが、ベンダーのコントロール外で起きる障害です。たとえば、クラウド基盤の大規模障害や、連携先SaaSのAPI仕様が予告なく変わり、システムが動かなくなるケースがあります。
AI機能が事実と異なる内容を出力するハルシネーションなども、運用保守ベンダーが直接コントロールできません。
多くの契約は、こうした事象を想定していないため、いざ起きたときに「それはうちの責任範囲外です」とベンダーに突き放され、発注側は復旧の見通しも立たないまま放置されかねません。
このリスクを避けるには、契約前にコントロール外の障害の扱いを明文化しておくことが欠かせません。クラウド基盤やSaaS連携の障害は、「ベンダーは対象外」と切り捨てるのか。それとも、「直接の復旧責任は負わないが、状況の検知、原因の切り分け、利用者への報告、代替策の提示までは行う」と定めるのかで、運用保守の価値は大きく変わります。
SLAの稼働率を約束していても、原因が「コントロール外」とされればその約束は適用されません。この盲点を契約段階で解消しておくことが、障害時に放置されないための最大の防衛策です。
- 責任範囲の線引き:対象外とするか、検知や報告まで担うかを契約で示す
- SLAとの関係:稼働率の約束が、コントロール外の原因にも及ぶかどうか
SLAペナルティが適用されない現実
SLAを結んでいても、いざというときにペナルティが機能しないことがあります。
多くのSLAは努力目標型で、稼働率99.9%や復旧4時間(出典:ripla)といった水準を掲げていても、未達時の減額や補填は定められていません。
保証型であっても、ペナルティの減額相場は月額の一定割合にとどまることが多く、実際の事業損失を補うには到底足りないのが実情です。
「SLAがあるから安心」と思い込むと、いざ障害が起きたときに「約束はあったが実効性はなかった」と気づくことになります。
障害の原因があいまいにされ、ペナルティが適用されなくなることが、さらに厄介です。
障害時に、原因が「利用者側の操作」「コントロール外のクラウド障害」とされれば、ペナルティの対象外になります。原因の切り分けをベンダー側が握っていると、発注側に不利な認定がなされかねません。
SLAで大事なのは、数値を掲げることよりも、未達時に何が起きるかと、原因をどう公平に切り分けるかを契約で定めることです。
ペナルティの効きめを過信せず、月次報告で達成状況を継続的に確かめ、原因を認定する手順を契約に盛り込んでおくことが、責任の曖昧さを防ぎます。
- 未達時の扱い:減額や補填が、何を基準に発生するか
- 原因認定の手順:切り分けの進め方を契約に入れ、ベンダー側だけで決めない
ベンダーロックインと法的トラブルのリスク
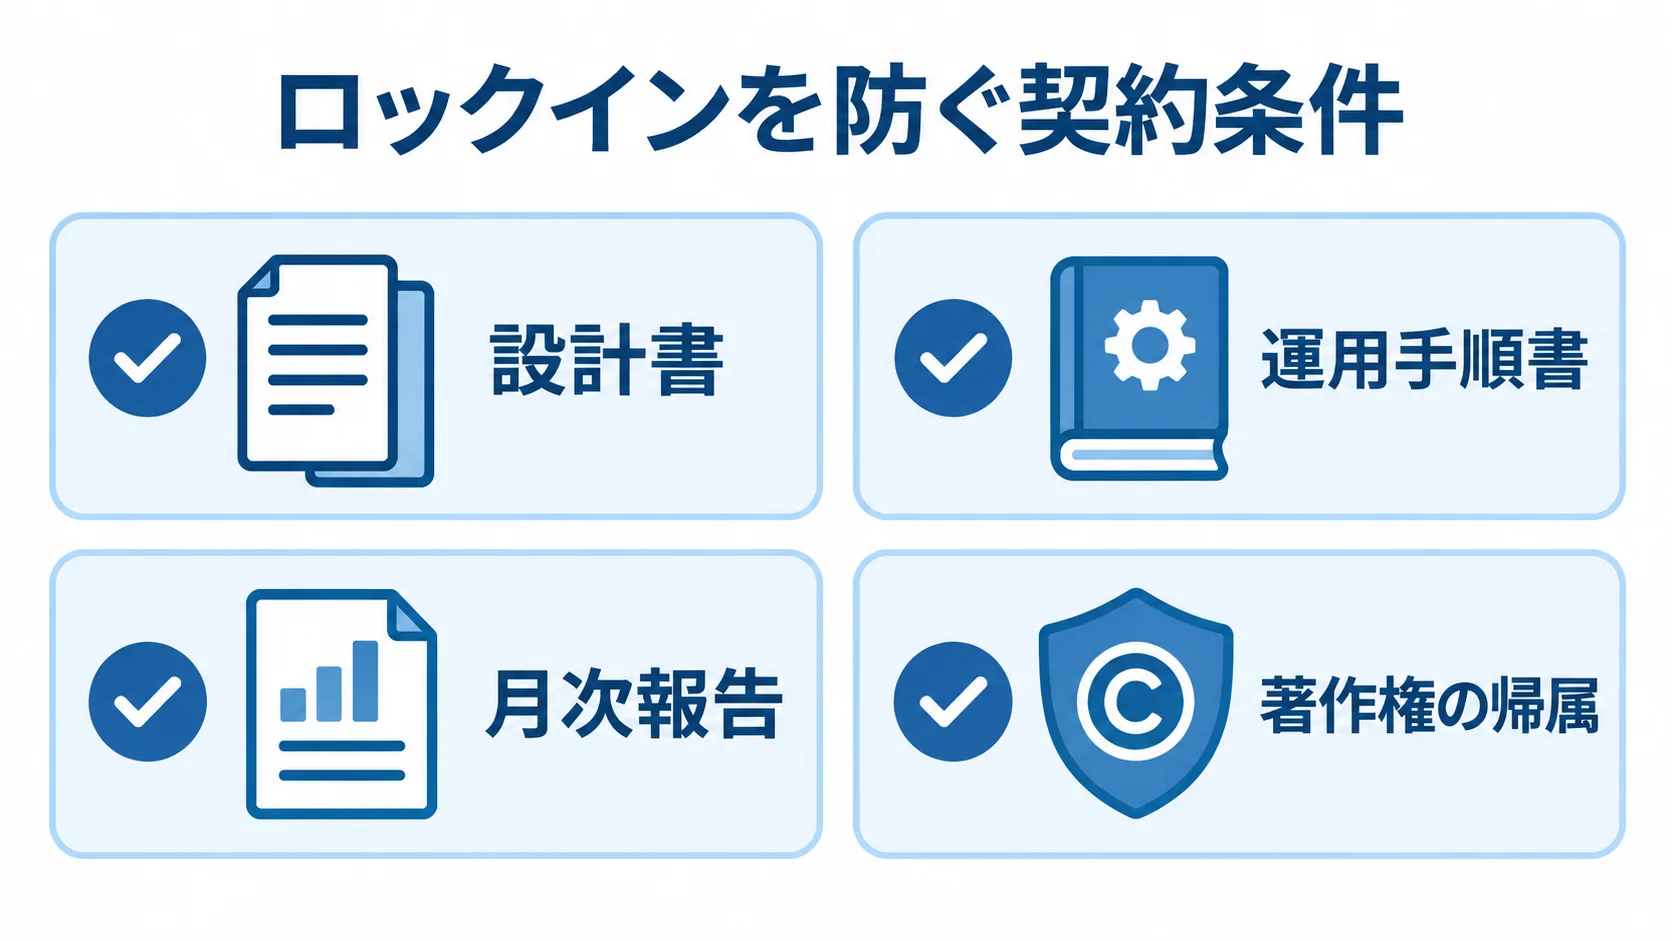
運用保守を一社に任せ続けるうちに、そのベンダーから抜け出せなくなる「ベンダーロックイン」は、運用保守の長期リスクの代表格です。
ロックインに陥ると、保守費が高止まりしても交渉の余地がなく、不満があっても変えられないまま、塩漬けの状態が続きます。さらに、いざ離脱しようとすると、法的なトラブルに発展することすらあります。
ブラックボックス化で塩漬けになるリスク
ロックインの根本原因は、システムの知見がベンダーに集中し、社内がブラックボックス状態になることです。
設計書や運用手順が整備されず、システムの中身を理解しているのがベンダーだけになると、発注側は交渉の主導権を失います。
保守費が開発費の15〜20%という目安(出典:ripla)を上回り続けても、「このベンダーしか触れない」という事実が、値下げ交渉も乗り換えも不可能にします。
気づけば、不満を抱えたまま毎年高額な保守費を払い続ける、塩漬けの構図ができあがっています。
この塩漬けを避けるには、契約時から「知見を社外に独占させない」仕組みを組み込むことです。
こうした地道な働きかけが、いざというときに別のベンダーへ移れる選択肢を残し、交渉力を保ちます。ロックインは、ベンダーの問題である以上に、発注側がドキュメントと知見の確保を怠った結果でもあります。
- ドキュメントの納品:設計書や運用手順書を契約条件に含め、定期的に最新化
- 月次報告での把握:運用の中身とシステムの構造を、発注側も理解しておくこと
納品の対象には、監視設定などのドキュメントも含めます。
著作権を盾にした移管拒否の法的リスク
ロックインがもっとも深刻化するのが、ソースコードの著作権を盾にした移管拒否です。
契約でソースコードの著作権の帰属が曖昧なまま開発を進めると、いざベンダーを変えようとしたときに、問題が表面化します。
「ソースコードは当社の著作物であり、開示・引き渡しはできない」と主張され、移管そのものが不可能になることがあります。
とくに、ベンダー独自のパッケージやフレームワークをベースに開発されている場合、その派生物の権利関係が複雑で、泥沼の交渉に発展します。
すでに曖昧な契約で運用が始まっている場合は、契約解除に向けて、著作権条項や保守契約の解約条件を法務の観点から精査したうえで、引き渡しを求める交渉を段階を踏んで進める必要があります。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走する立場から、ソースコードや成果物の権利関係を明確にしています。また、発注側が将来にわたって選択肢を持てる契約のあり方を重視しています。
著作権をめぐる法的ロックインは、運用保守で見落とされやすい問題です。
- 著作権の帰属:開発と契約の段階で、ソースコードの権利の帰属を明確にすること
- 移管時の開示義務:引き渡しの範囲と条件を、契約で明文化
保守移管の失敗と想定外費用のリスク
運用保守を見直すときに起こりやすいのが、保守移管(ベンダー変更)の失敗と、予算に入れていなかった想定外費用の発生です。
これらは、動き出してから「こんなはずではなかった」と気づくタイプのリスクで、事前の備えが明暗を分けます。
ドキュメント不足で移管が難航するリスク
保守移管の失敗でもっとも多いのが、引き継ぎ資料の不足による難航です。
新しいベンダーに移管する際、旧ベンダーから設計書や運用手順、障害履歴といった資料が十分に得られないと、新ベンダーはシステムをゼロから解読することになります。その結果、キャッチアップに膨大な時間がかかります。
この間、旧ベンダーへの保守費と新ベンダーのキャッチアップ費用が重なる「二重コスト」が発生し、想定以上に費用がかさみます。さらに、移管の難航はサービスの不安定化にも直結します。
移管を成功させるには、移管を決める前から準備を始めることが鍵です。
また、移管を段階的に進めることも有効です。まず監視や一次対応を新ベンダーに引き継ぎ、安定を確認してから改修まで移す、という慎重な進め方です。
移管は「思い立ってすぐできる」ものではなく、計画的な準備があって初めて成功します。
- 引き継ぎ資料:現ベンダーとの契約に、移管時のドキュメント引き渡し義務を明記
- 段階的な移管:監視や一次対応から始め、安定を見てから改修を移す
日頃から月次報告で運用状況を把握しておくことも、いざ移管するときの難航を防ぎます。
OSS保守・データ復旧・クラウド障害の想定外費用
運用保守の予算でつまずきやすいのが、契約の月額に含まれない想定外費用です。代表的な例が、OSS(オープンソースソフトウェア)の保守です。
システムが利用しているOSSに脆弱性が見つかった場合、その対応は月額の定常保守に含まれないことがあり、緊急のアップデート対応として別費用が発生します。
障害でデータが破損した場合のデータ復旧も、バックアップの「取得」は標準に含まれていても「復元作業」は別費用となるケースがあり、いざというときに想定外の請求が来ます。
前述したクラウド側の障害への対応や、AIモデルを含むシステムの保守も、想定外費用が生じやすい領域です。
AIや機械学習モデルの運用保守(MLOps保守)は月50万〜200万円が一つの相場とされ(出典:ripla)、通常のシステム保守より高額になります。
これらを防ぐには、契約の段階で「月額に含まれる範囲」と「別費用になる作業」を洗い出しておくことが欠かせません。OSS保守やデータ復旧、クラウド障害対応などの項目ごとに確かめておくと確実です。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせた立場から、SaaS・クラウド・AI連携が前提の現代のシステムについて、想定外費用になりやすい項目を契約前に明示しています。また、予算の不意打ちを防ぐ進め方も重視しています。
運用保守の失敗の多くは、契約前に潰せたはずの曖昧さから生まれるのです。
- 月額に含まれる範囲:保守料金に何が入り、何が別費用になるかの一覧
- 別費用になりやすい作業:OSSの緊急対応、データの復元作業、AIモデルの再学習など
日々の運用現場で品質が劣化していく失敗
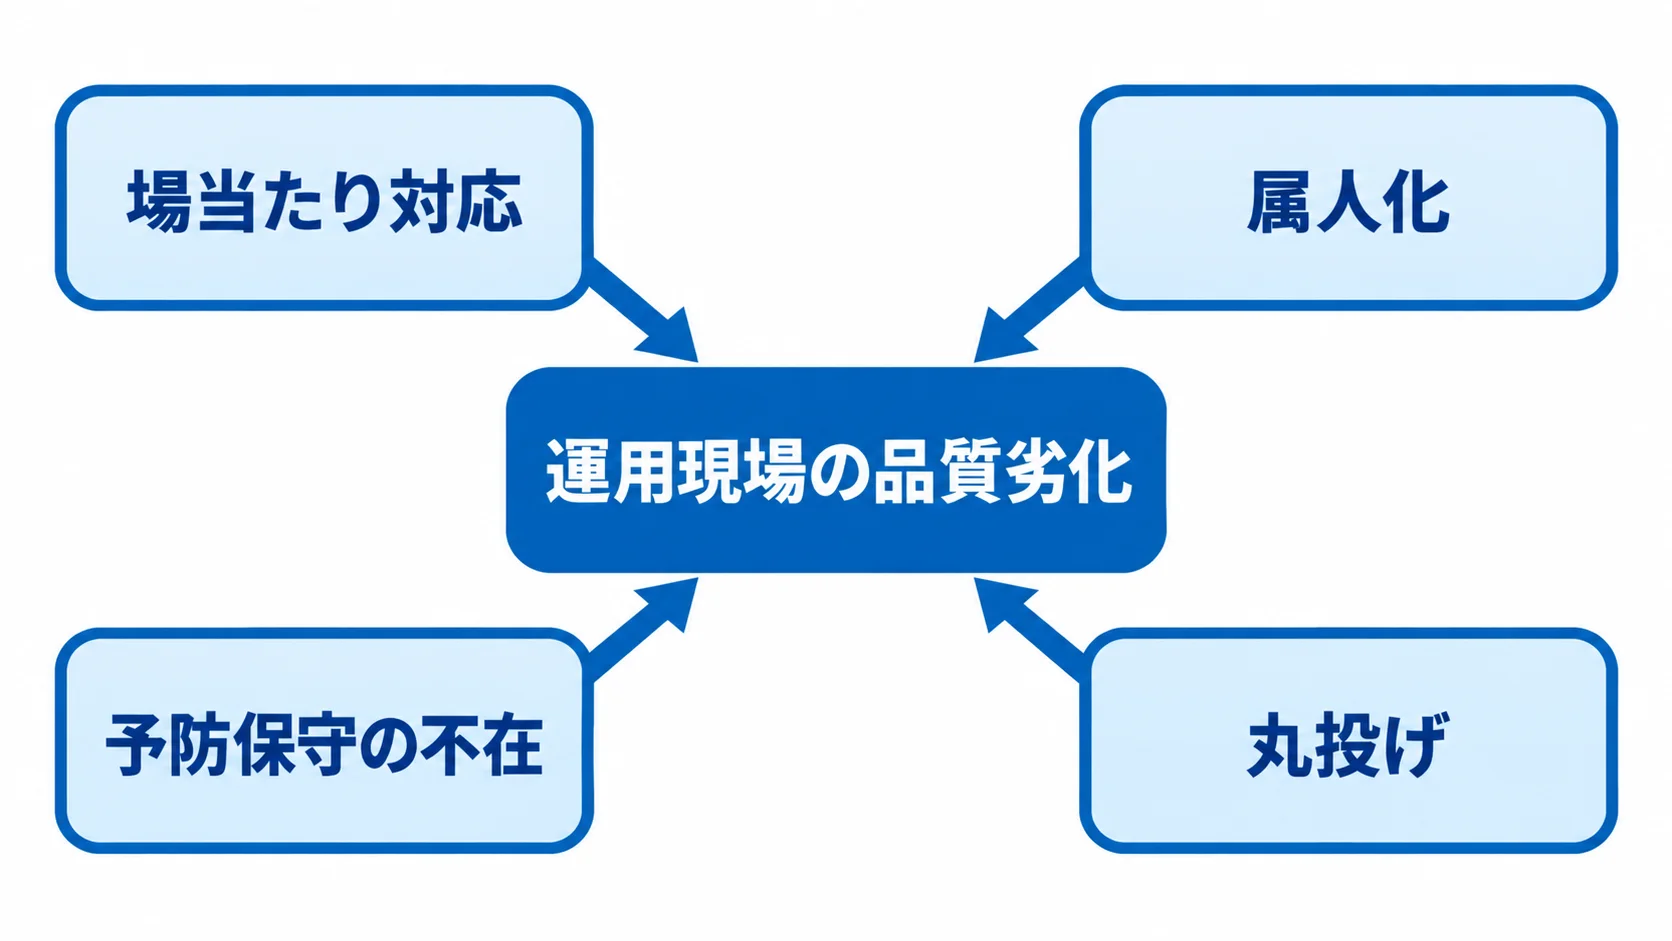
契約の失敗だけでなく、日々の運用現場でじわじわと品質が劣化していく失敗もあります。
契約は整っていても、運用の進め方が場当たり的だと、障害が繰り返され、対応が属人化し、システムが少しずつ不安定になっていきます。
これらは大きな事故として表面化しにくいぶん、気づかぬうちに進行するのが厄介です。運用現場で起きる失敗の型も、あわせて見ておきます。
運用現場の劣化は、契約上の責任分界やロックインといった分かりやすいリスクと違って、数年単位でゆっくり進むため、当事者も気づきにくいのが特徴です。
毎月の保守費はきちんと払われ、障害が起きれば一応は復旧します。表面上は問題がないように見えても、根本原因は手つかずのまま、属人化と技術的負債だけが積み上がっていきます。
気づいたときには、立て直しに大きなコストがかかる状態になっています。だからこそ、現場で何が起きているかを早めに見抜くことが重要です。
場当たり対応による障害の繰り返し
運用現場でありがちな失敗が、障害のたびに「とりあえず復旧させて終わり」という場当たり対応です。
暫定的にサービスを戻すことだけに追われ、根本原因の究明や恒久対応を後回しにすると、同じ障害が何度も繰り返されます。
SLAでは暫定復旧と恒久対応が区別され、恒久対応は5営業日以内といった目安があります(出典:ripla)。この恒久対応が形骸化すると、表面的には復旧していても、根本の問題は残り続けます。
障害対応は保守費内訳の25〜35%を占める大きな領域であり(出典:ripla)、ここが場当たり的だと、コストをかけても品質が積み上がりません。
この失敗を防ぐには、障害ごとに原因と恒久対応を記録し、再発防止を運用の仕組みに組み込むことが欠かせません。
障害報告書で根本原因を分析し、同種の障害を防ぐ改善を積み重ねていけば、時間とともに障害は減っていきます。
月次報告で障害の発生件数と再発状況を確認し、減らない障害があれば恒久対応の進捗を問う、という発注側の関与も大切になります。
場当たり対応を放置すると、運用保守は後始末に追われるだけで、システムは安定に向かいません。
- 恒久対応の期限:暫定復旧のあとに、恒久対応の目安をSLAで定めておくこと
- 形骸化の兆し:同じ障害が続き、恒久対応が形だけになっていないかという点
属人化と予防保守の不在による劣化
もう一つの現場の失敗が、運用の属人化です。特定の担当者だけがシステムの勘所を把握している状態が続くと、その人が異動・退職したとたんに対応の質が落ち、引き継ぎもままならなくなります。
属人化はベンダー側でも発注側でも起こり得る問題で、「あの人に聞かないと分からない」状態が、運用保守の継続性を静かに損ないます。
属人化したまま放置すると、いざというときに誰も動けない、という事態を招きます。
あわせて、予防保守の不在も劣化を招きます。OSSやライブラリの更新、ストレージ容量の監視、性能の劣化チェックといった「壊れる前の手当て」を怠ると、ある日突然、脆弱性や容量不足、処理速度の低下といった形で問題が噴き出します。
処理速度については、RFPの例で全画面3秒以内といった要件が定められることもあります(出典:ripla)。
データ量の増加とともに劣化する性能を、予防的に監視しておかないと、ユーザー体験が知らぬ間に悪化します。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走する立場から、場当たり対応ではなく、再発防止と予防保守を組み込んだ運用を重視しています。属人化を避けるドキュメントの整備も大切にしています。
運用保守の品質は、契約の整備と、現場での地道な運用設計の両方で守られるのです。
- 属人化の解消:手順書や構成情報を整え、特定の担当者に頼らない状態
- 予防保守:OSSやライブラリの更新と、容量・性能の監視を、壊れる前に行うこと
丸投げで運用が見えなくなる失敗
運用現場の失敗の根底にあるのが、発注側の「丸投げ」です。ベンダーに任せきりにして、月次報告も読まず、システムの状態を把握しないままにしておくと、品質の劣化に気づくのが遅れます。
場当たり対応が常態化していても、属人化が進んでいても、丸投げのままでは表面化するまで分かりません。気づいたときには障害が頻発し、ベンダーへの依存も深まっていて、立て直しが難しくなっています。
運用保守は委託しても、監督までは手放してはいけません。
丸投げを避けるには、発注側がベンダーの運用に最低限の関与を続けることです。月次報告の内容を読み、気になる点は質問します。
年に一度は契約内容と運用品質を振り返り、必要に応じて体制を見直します。こうした関与が、ベンダーに緊張感を与え、品質の劣化を早期に発見させます。
運用保守の失敗の多くは、契約の曖昧さと現場の運用設計の甘さ、そして発注側の丸投げという三つが重なったところで起きます。委託先と適度な距離を保ちながら関わり続けることが、長く安定して運用するための前提になります。
- 月次報告で見る項目:稼働率の実績、障害件数の推移、改修の消化状況
- 年次の振り返り:契約の条件と運用品質を並べて比べ、体制の見直しを検討する
まとめ
ソフトウェア運用保守の失敗は、責任分界の曖昧さによる障害の長期化や、ベンダーロックインによる塩漬け、著作権を盾にした法的トラブルが代表的です。
保守移管では、ドキュメント不足による移管の難航が起きやすいほか、OSS保守やデータ復旧、MLOps保守などの想定外費用も生じます。
場当たり対応や属人化、予防保守の不在によって、日々の運用品質がじわじわ劣化していく失敗もあります。
運用保守の失敗に共通するのは、開発時ではなく運用が始まってから数年かけて表面化し、気づいたときには後戻りが難しくなっている点です。
SLAのペナルティが実効性を欠く現実や、月額に含まれない費用の存在を知っておくだけでも、問題を避けやすくなります。
これらの失敗の大半は、契約前に「曖昧さを潰す」ことで防げます。とくに、コントロール外の障害の扱い、ソースコードの著作権の帰属、移管時のドキュメント引き渡し義務は、契約書に明記しておくべき項目です。
また、月額に含まれない作業の範囲を契約段階で明文化しておくことも、想定外費用を防ぐ大切な備えです。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、作った後も継続して伴走する立場から、責任分界点の明確化、知見の社内への残し方、想定外費用の事前の洗い出しまで、一貫して支援しています。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。