
データ分析システムの開発・導入で起きやすい失敗は、データ品質、生成AI特有のリスク、評価体制の不備に大きく分けられます。これらを事前に整えておくと、経営判断の高度化や業務効率化につながります。
全体像はデータ分析システムの完全ガイドもご覧ください。
▼全体ガイドの記事
・データ分析システムの完全ガイド
データ基盤構築の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「データ基盤構築の完全ガイドブック」で詳しく解説しています。
最大の失敗要因「データ品質」とPoC死の構造
データ分析システムの失敗原因で最も多いのは、分析対象データの品質の低さです。入力データが不正確だと、高度な分析エンジンや生成AIを使っても、分析結果を信頼できません。
「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」という原則は、データ分析システムで特に強く当てはまります。
データ品質の不備は、PoC段階で頓挫する「PoC死」の原因にもなります。
調査データが示すデータ不足という壁
複数の調査データを見ると、データ品質が失敗の中心にあることがわかります。具体的な数字からも、その深刻さが読み取れます。
- Gartnerは、AIプロジェクトの60%が2026年までにデータ不足で失敗すると予測しています(出典:Gartner)。
- Canon ITソリューションズがRAG(検索拡張生成)228件を調べた調査では、成功(Good)は33%でした(出典:Canon ITソリューションズ)。
- 同じ調査では、失敗原因の46%が回答品質、42%がデータ連携の不備でした(出典:Canon ITソリューションズ)。
AIの性能不足よりもデータ準備の不足が、失敗の大半に関わっていることを、調査の数字が示しています。
分析の前提となるデータが量と質の両面で整っていないと、多くの失敗につながります。
生成AIを組み込んだ分析システムでも、データ準備の不足は同じ問題を引き起こします。
「最新のAIなら賢く分析してくれる」と期待して整備を後回しにすると、PoCで精度が出ず、原因に気づく頃には予算と期間を消費してしまいます。そのため、失敗を避けるには、分析エンジンの選定よりデータ整備を優先します。
データクレンジングという泥臭い実務
データ品質の課題を解消するには、地道なデータクレンジングが欠かせません。基幹システムの取引データや、部門ごとに形式が違うExcelは、そのままでは分析に使えないからです。
手入力による表記揺れを含むマスタデータも、分析の前に整える必要があります。
分析精度は、名寄せや欠損値の補完、表記の統一などの作業で決まります。重複の排除も、同じく精度を左右します。
分析と聞くと華やかなイメージがありますが、成否を分けるのは泥臭い前処理です。
関係者全員が、データ整備は泥臭い作業だという認識を共有しておくことが大切です。
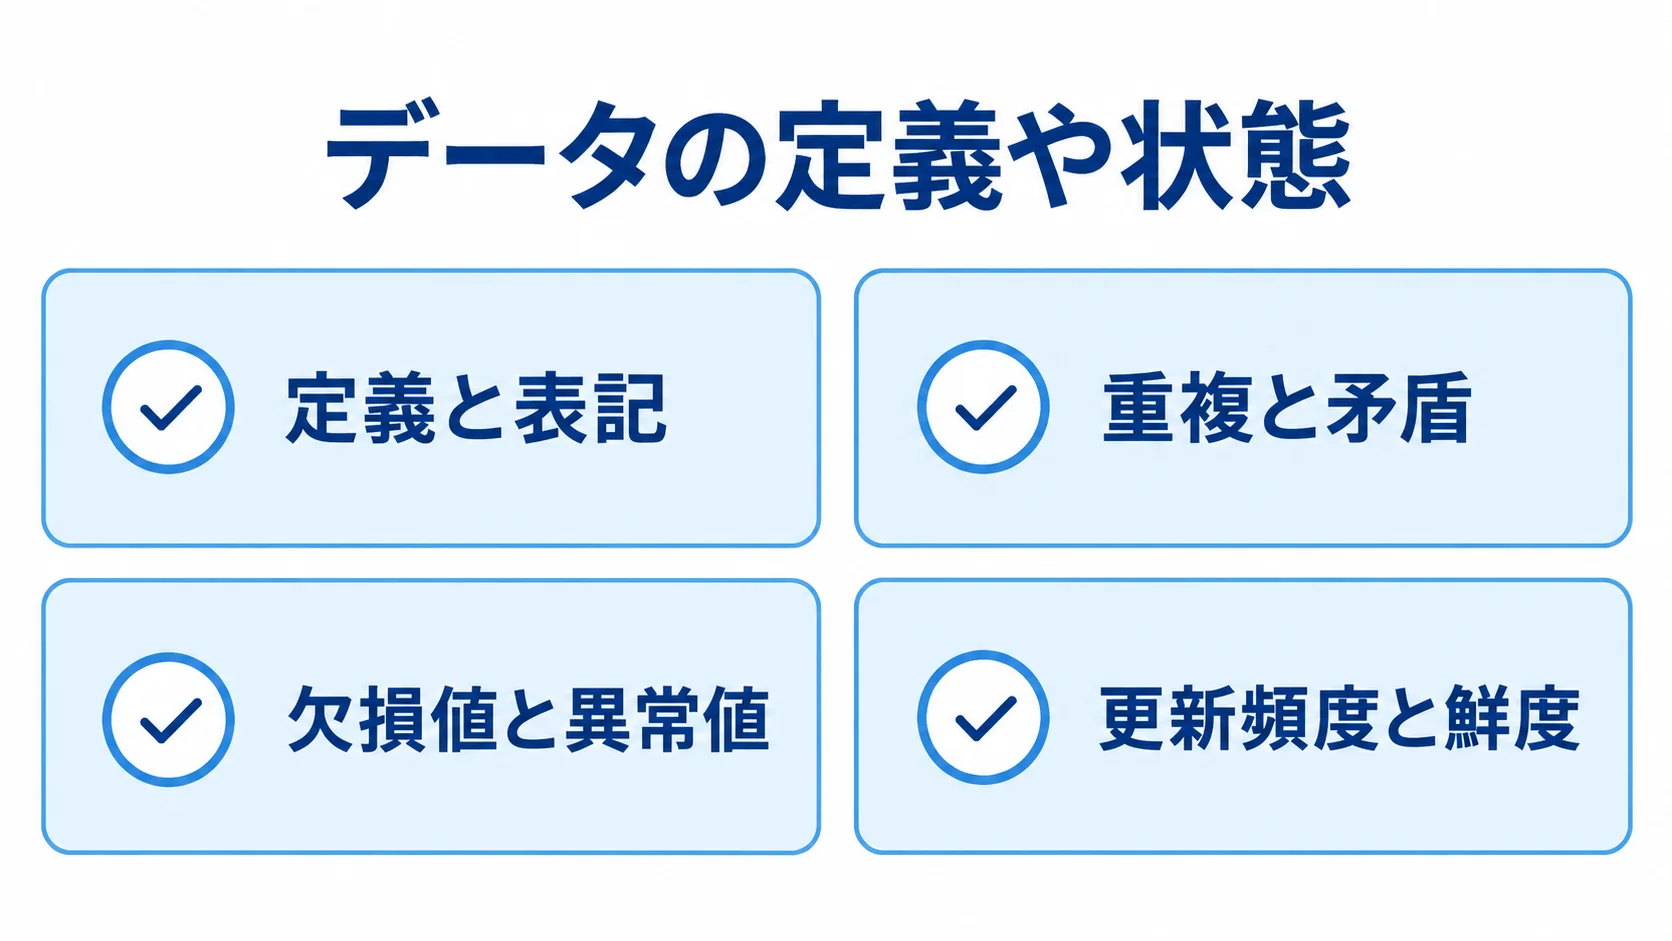
具体的な対策としては、データの定義や状態を次の観点から揃える取り組みが有効です。
- 定義と表記:部門ごとのデータ定義を統一し、用語や単位をそろえる作業
- 重複と矛盾:該当データの洗い出しと、正本の一本化
- 欠損値と異常値:扱いのルールの策定と、分析の前提の明確化
- 更新頻度と鮮度:古いデータが混入しない管理
こうした作業を軽視すると、「動くデモ」はできても、実データを投入した後に精度が崩れる「PoC死」に陥ります。PoC死とは、概念実証では成果が出たように見えても、本番データの汚れや量に耐えられず、実運用に移れない現象です。
PoC死を避けるには、PoC段階から実データに近いデータを使い、データ準備に十分な工数と期間を確保することが最も確実です。
生成AI特有のリスク(情報漏洩・著作権・ハルシネーション)
近年は、自然言語で分析結果を要約したり、対話形式でデータに問い合わせたりする生成AI機能が使われています。
分析のハードルを下げる一方で、従来型のシステムにはなかったリスクも生じます。
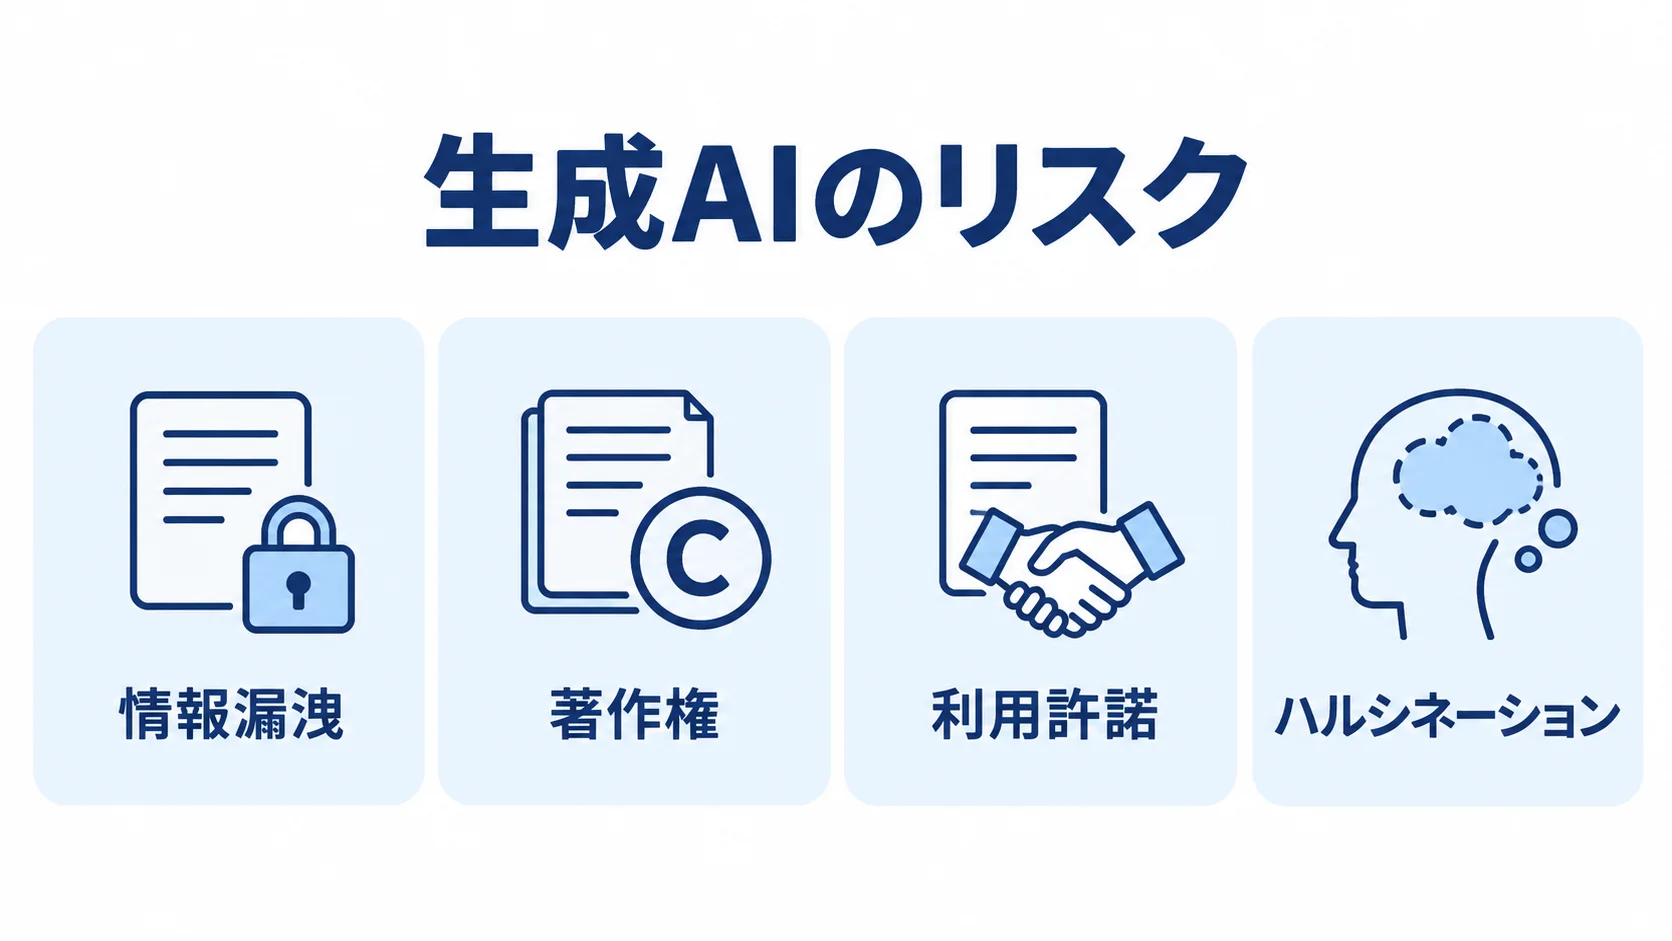
生成AIのリスクに備えるには、情報漏洩、著作権、利用許諾という代表的な3つの論点を理解しておく必要があります。
情報漏洩と著作権をめぐる構造的リスク
クラウドへの入力やAIの出力、分析データの利用許諾では、それぞれ情報管理と権利の確認が欠かせません。
- 情報漏洩:外部のクラウド型生成AIに機密性の高い分析データを送ると、顧客情報や経営データが社外に渡るおそれがあります。
- 著作権:AIの出力が第三者の著作物に類似し、社外資料へ転用する際に問題となる恐れがあります。
- 利用許諾:外部から取得したデータを許諾の範囲外で基盤に取り込むと、契約違反となる恐れがあります。
入力した情報がAIの学習に使われたり、ログとして保持されたりする仕様だと、意図せず外部へ流出しかねません。そのため、発注する会社は、サービスのデータ取り扱いポリシーを確認し、学習利用を停止する設定や、社内に閉じた環境を開発会社と検討しておく必要があります。
リスクを防ぐには、技術的な対策に加えて、発注する会社が社内ルールを用意する必要があります。どのデータをどのAIにどこまで入力できるかを明文化し、従業員に周知しておきます。
ルールが曖昧なまま現場に任せると、便利さが先行し、機密データの入力から重大な漏洩事故を招きます。
ガバナンスの整備は、生成AI型分析システムを導入する前提条件です。
ハルシネーションが意思決定を誤らせる危険
ハルシネーションとは、生成AIが事実に基づかない情報を、もっともらしい形で出力する現象です。
分析結果は経営判断の根拠になるため、誤った数字や存在しない傾向を断定すると、判断そのものを誤らせる危険があります。
文章が流暢で説得力があるほど、利用者は疑わずに信じてしまう傾向があります。誤った内容が組織全体を誤った方向へ動かすおそれがあるため、運用の段階で備えます。
- 根拠の表示:数値や結論に元データの出典を付け、ワンクリックで検証できる状態。
- 人による確認:重要な意思決定の前に、出力を一次データと照合するレビュー。
- 利用者への教育:AIの出力は下書きで、最終検証は人が担うという認識の組織への浸透。
現状の技術では、ハルシネーションを完全になくすことは困難です。
発生を前提とした運用設計に重心を置き、AIを過信せず分析の補助ツールと位置づけることが、失敗を避ける鍵です。
データポイズニングへの備えと評価による失敗の切り分け
「精度が出ない」という曖昧な状態が続くと、原因を特定できず、改善も進みません。
継続的に改善するには、セキュリティ上の脅威に備えつつ、失敗原因を定量的に切り分ける仕組みが必要です。そのために押さえておきたいのが、新しいセキュリティリスクと、失敗原因を可視化する評価手法です。
BadRAG攻撃に代表されるデータポイズニングの脅威
生成AI型の分析システムには、データポイズニングというセキュリティリスクがあります。これは、参照データに悪意ある情報を混入させ、AIの出力を攻撃者の意図する方向へ操作する手口です。
特に深刻なのが、BadRAG攻撃です。研究では、検索対象データのわずか0.04%を汚染しただけで、プロンプトインジェクションの攻撃成功率が98.2%に達したと報告されています。
このように、ごく少量の汚染データでも、分析システム全体の信頼性を損ないえます。
社外のデータや、複数の部門が書き込めるデータソースを基盤に組み込むと、悪意あるデータが混入するリスクがあります。
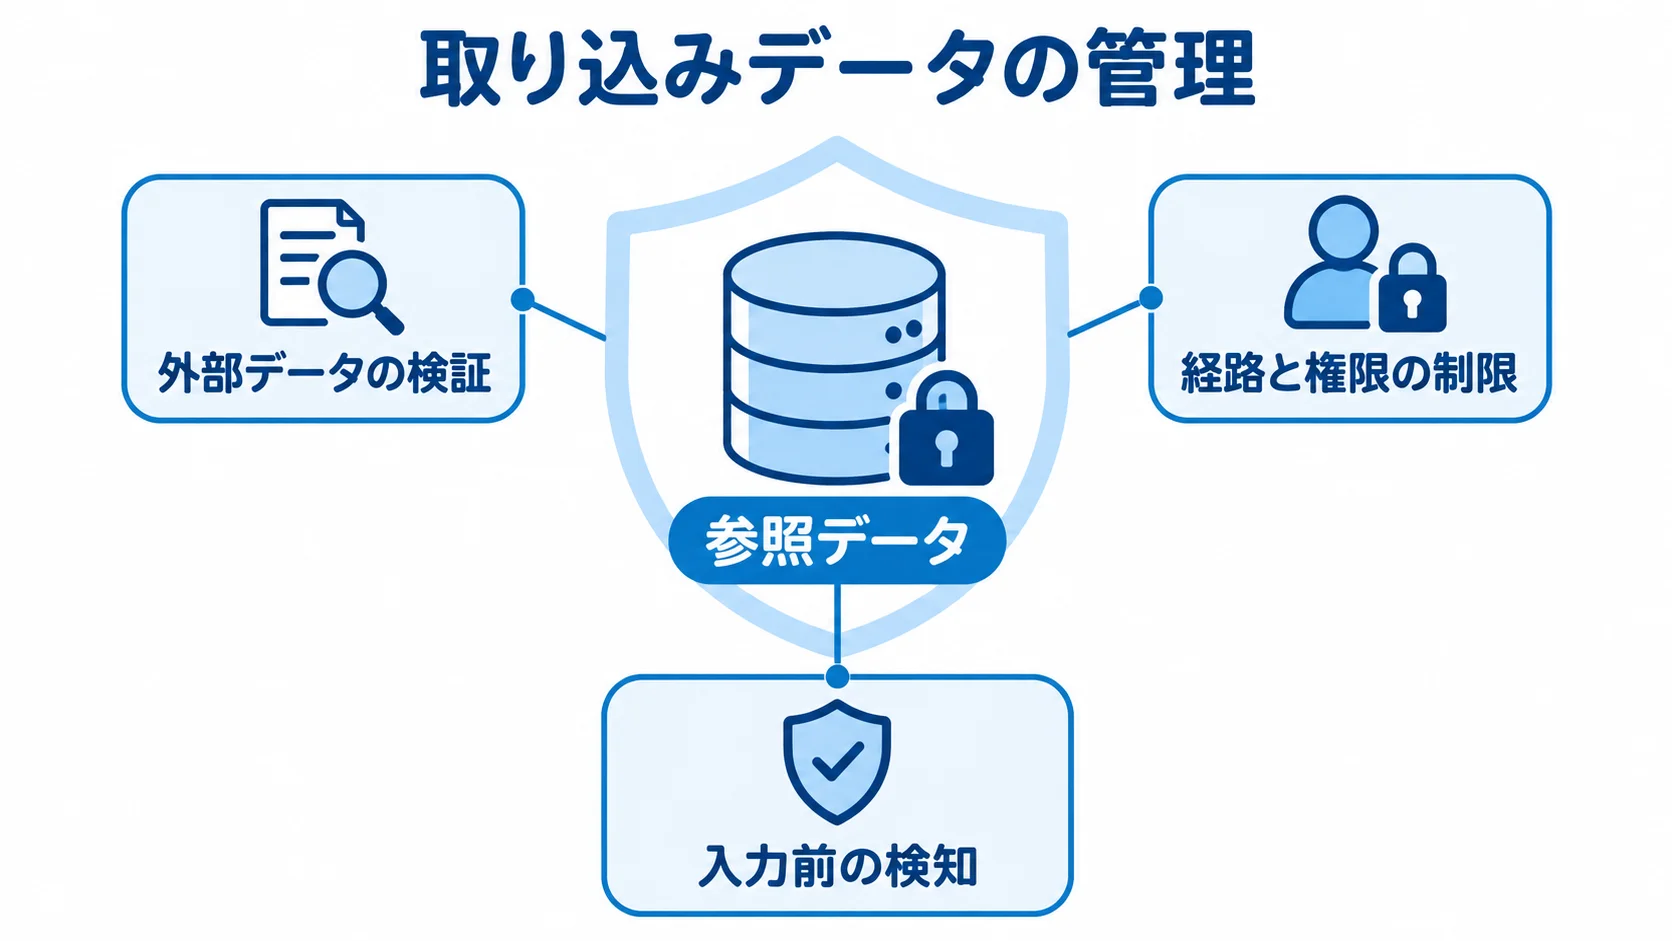
攻撃を受けると、AIは誤った分析結果や機密情報を漏らす応答を返すよう仕向けられます。だからこそ、取り込みデータの管理が基本になります。
- 外部データの検証:隔離して内容を確認してから取り込む。
- 経路と権限の制限:経路を限定し、各データの追加・更新権限を最小限に絞る。
- 入力前の検知:AIに渡す前に、プロンプトインジェクションを見つけるフィルタを設ける。
評価指標による失敗原因の切り分け
「精度が出ない」という失敗を放置しないためには、原因を定量的に切り分けることが必要です。生成AI型システムでは、Ragasのような評価フレームワークで出力の質を測ります。
検索精度や根拠への忠実度を指標で確かめると、精度低下の原因に応じた見直しにつなげられます。
- Context Precision:検索精度を測る指標。低い場合は、検索や元データの整備に課題がある。
- Faithfulness:生成内容が根拠に忠実かを示す指標。検索が正しくても低ければ、生成側に問題がある。
評価指標で失敗原因を分解すると、「なんとなく精度が悪い」という感覚的な議論を避けられます。
検索が正しくてもFaithfulnessが低い場合は、AIが根拠を無視して誤った結論を生成している可能性があります。開発会社は、その場合に生成側のプロンプトやモデルを見直します。
原因が元データにあればデータクレンジングへ、検索にあれば検索ロジックの調整へ進みます。
評価の仕組みを最初から運用に組み込めば、失敗原因に応じて対策を振り分けられます。さらに、評価によって失敗を改善可能な課題に変えられます。
まとめ:失敗の構造を理解して回避する
ここまで、データ分析システム開発・導入の失敗、課題、注意点、リスクを、データ品質、生成AI特有のリスク、セキュリティと評価の各観点から見てきました。
Gartnerの予測では、AIプロジェクトの60%が2026年までにデータ不足で失敗するとされています(出典:Gartner)。
本番データに耐えられず頓挫する「PoC死」を避けるには、分析エンジンの選定よりデータクレンジングを優先することが大切です。また、生成AIを使う場合は、情報漏洩、著作権、ハルシネーションのリスクにも備える必要があります。
BadRAG攻撃に代表されるデータポイズニングにも備えつつ、Ragasなどの評価指標で失敗原因を切り分けます。
データ整備に工数を割き、ガバナンスと人間によるレビューを用意することが、分析システムを成果につなげる近道です。
これらの失敗には共通する構造があるため、事前に知っておけば多くは回避できます。この教訓を自社の計画に取り込み、落とし穴を避けながら、価値を生む分析基盤を築いていきましょう。
▼開発を相談する前に読みたい無料ホワイトペーパー
・データ基盤構築の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。