
データ管理システムは、次の四つの機能がそろって初めて、現場の意思決定を支えます。
- データ収集・クレンジング:分散したデータを集めて、使える状態に整えます。
- 可視化・予測:データから現状と将来を読み取ります。
- RAG検索:社内データや文書を、自然言語で問い合わせられます。
- 権限管理:利用者ごとに、参照できる範囲を制御します。
各機能が何を担い、費用や難しさがどこに集まるかは、機能ごとに違います。全体像から知りたい方は、まずデータ管理システムの完全ガイドをご覧ください。
▼全体ガイドの記事
・データ管理システムの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
データ収集・クレンジングの機能
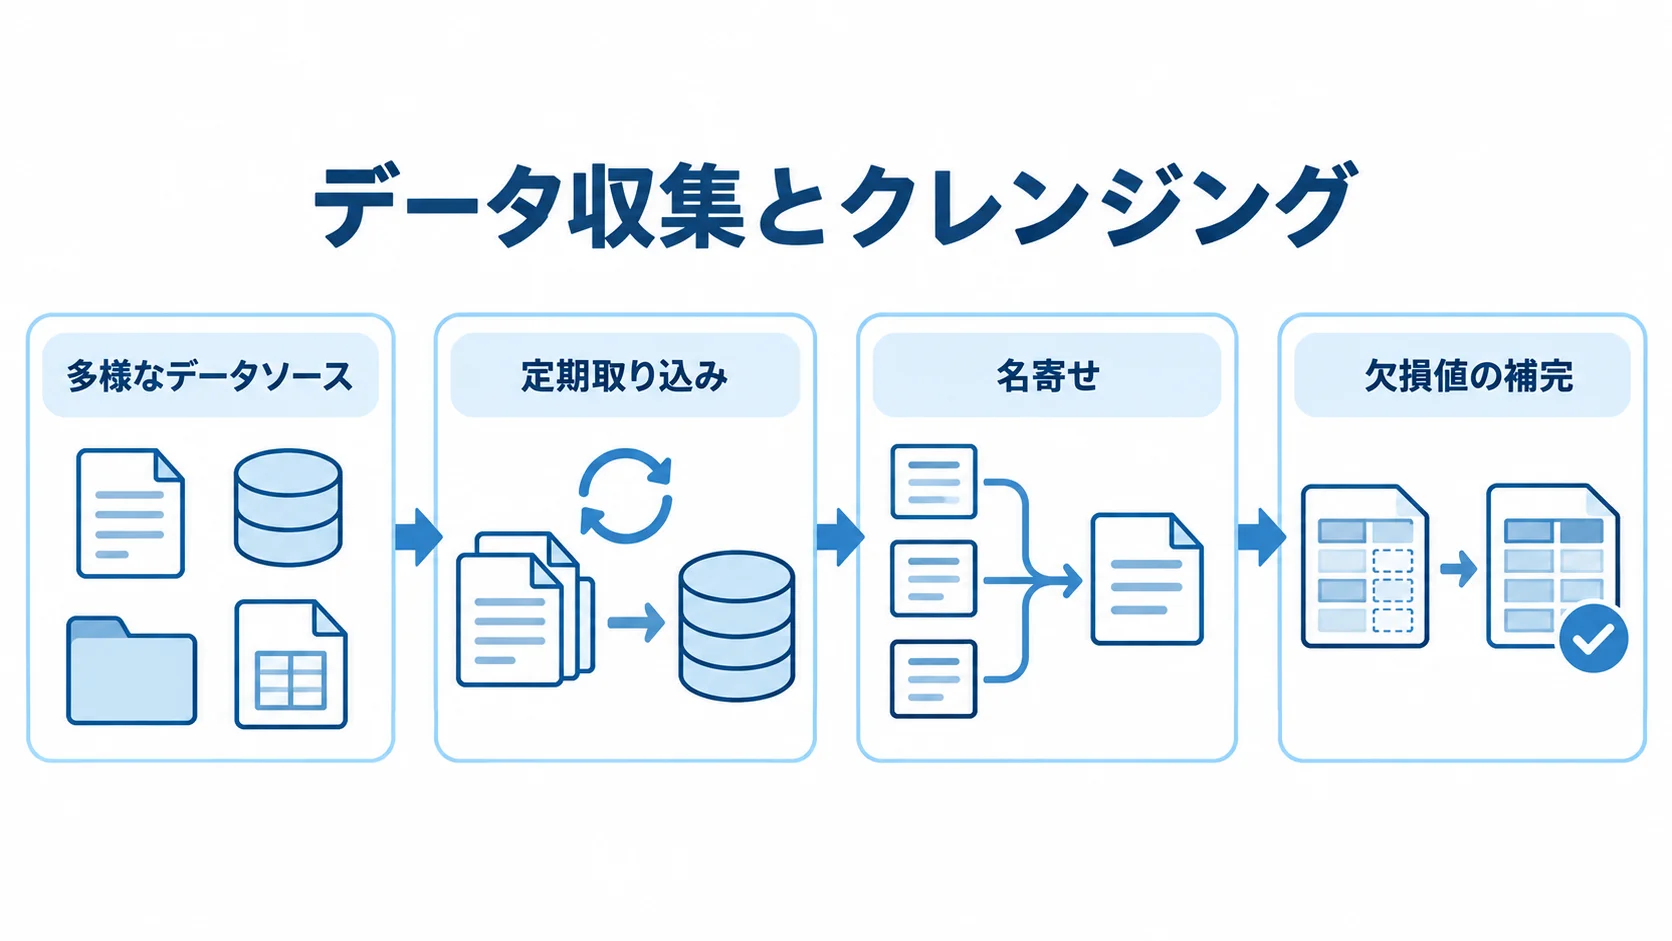
データ管理システムのすべての機能の土台になるのが、データ収集とクレンジング(前処理)です。どれほど高度な分析や予測を載せても、入力されるデータが汚れていれば、正しい結果は得られません。
データ収集とクレンジングは、見た目こそ地味ですが、投資効果を左右するもっとも重要な部分です。
一次データでも、社内データの収集・クレンジングには全体予算の2〜3割を見込む必要があるとされており、機能の評価でここを軽く見るのは禁物です。
多様なデータソースを取り込む連携機能
データ収集機能の中核は、社内に散らばった多様なデータソースを一つの基盤に取り込む連携の仕組みです。基幹システムや販売管理、Excelファイル、CSV、外部のWeb APIなど、形式も置き場所もバラバラなデータを、定期的かつ自動で集める必要があります。
手作業でコピー&ペーストを続けると、更新が止まり、基盤が陳腐化します。そこで、スケジュール実行による定期取り込みや、取り込み失敗時の検知・通知が標準機能として備わっているかを確認しましょう。
非デジタル環境から始める場合は、そもそもデータがデジタル化されていないという壁にぶつかります。そのため、紙の帳票やバラバラのExcelからデータを起こす工程は、収集機能の前段として避けて通れません。機能を評価するときは、「すでにある綺麗なデータを連携する機能」だけでなく、「散在し汚れたデータを取り込める形に整える前処理機能」まで含めて見ることが、現実的な検討につながります。
名寄せ・欠損補完などのデータ品質機能
取り込んだデータがそのまま使えることはほとんどないため、クレンジング機能が表記ゆれの統一、重複レコードの名寄せ、欠損値の補完、異常値の検出を担います。たとえば同じ取引先が「株式会社○○」「(株)○○」「○○」と複数登録されると、集計が分散して正しい数字が出ません。これを一つにまとめる名寄せは、データ品質を担保する代表的な標準機能です。
データ品質機能の充実度は、後工程すべての精度を決めます。一次データでは、品質が不良なまま開発を進めると開発費が20〜30%上昇するとされており、品質機能への投資はコストの面でも合理的です。
機能を比べるときは、クレンジングルールを業務に合わせて柔軟に設定できるか、品質チェックの結果をレポートで可視化できるかといった、運用のしやすさまで評価することをおすすめします。データを「集める」だけでなく「綺麗に保ち続ける」機能こそ、データ管理システムの背骨だと言えます。
可視化BI・予測モデルの機能
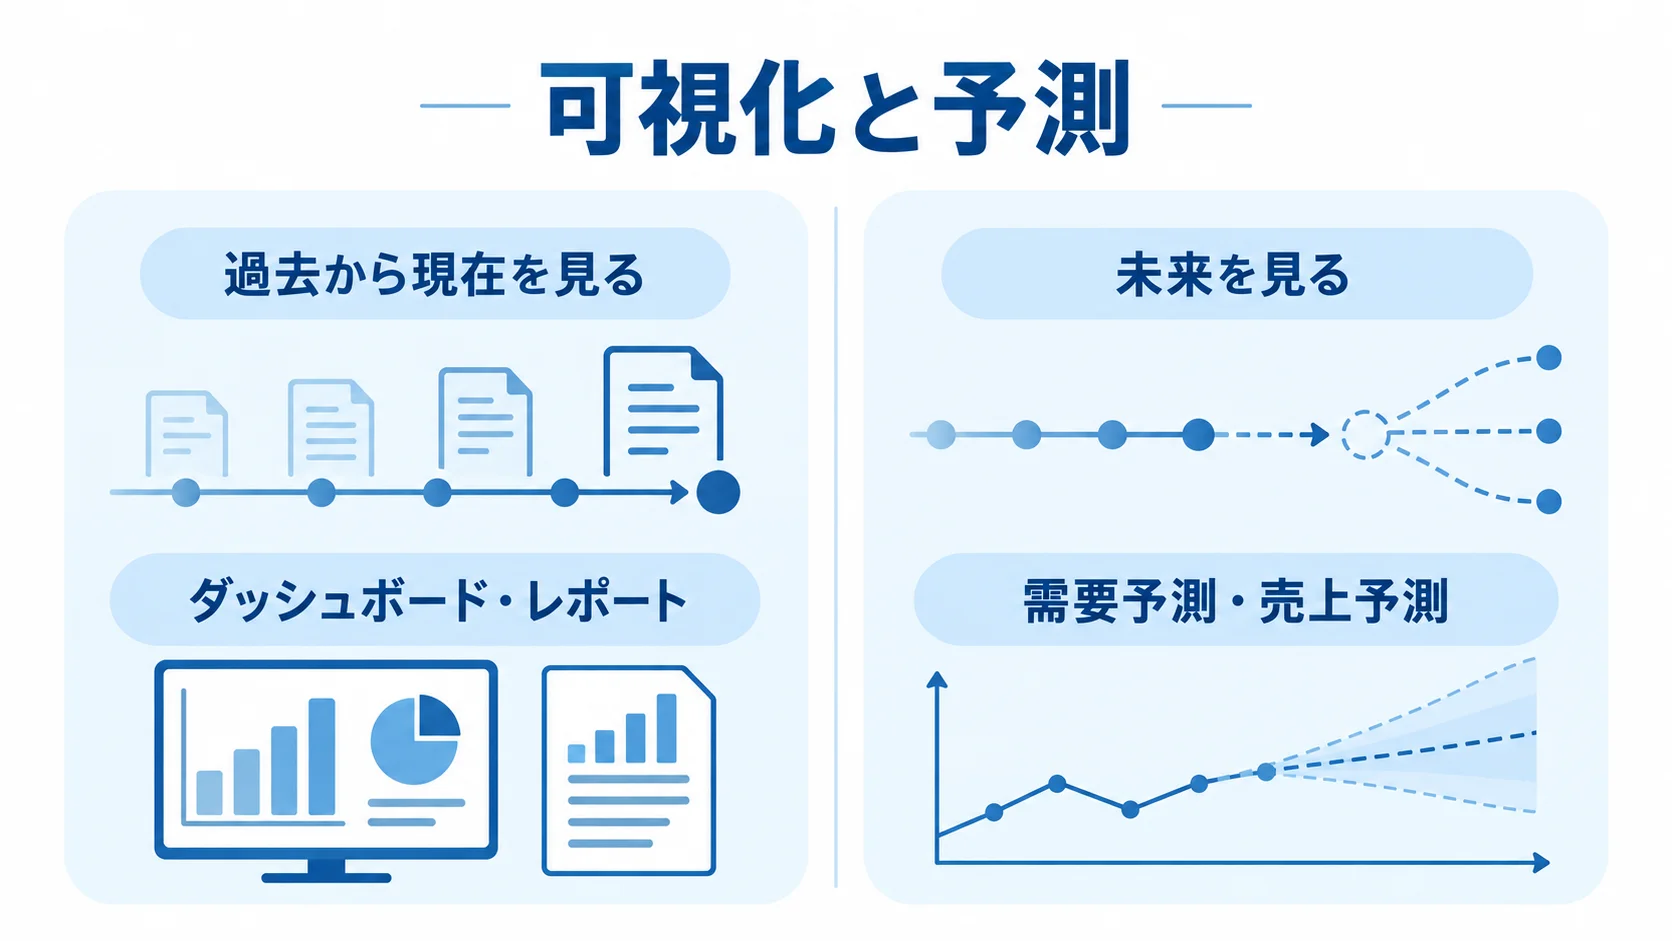
整えたデータを価値に変えるのが、可視化BIと予測モデルの機能です。可視化は「過去から現在を見る」機能、予測は「未来を見る」機能であり、この二つがそろって初めて、データが意思決定に直結します。
どちらも標準的な分析基盤に欠かせませんが、求めるレベルによって費用が大きく変わる領域でもあります。
ダッシュボード・レポートの可視化機能
可視化機能の標準は、BIツールによるダッシュボードとレポートです。Looker Studio、Tableau、Power BIといったBIをデータ基盤に接続し、売上・在庫・KPIをグラフや表でリアルタイムに表示します。
経営層や現場が、欲しい数字を欲しいタイミングで自分で見られる状態を作るのが、この機能の目的です。BIの利用料は月数万円から数十万円以上と幅があり、利用者数や必要なライセンス種別によって変動します。
機能の評価で重要なのは、「誰が、どんな単位で、どこまで深掘りして見たいか」という分析要件で、一次データでも、この要件やKPI設計の複雑さがデータ管理システムの難所として挙げられています。ドリルダウン(集計から明細へ掘り下げる)やフィルタの自由度、業務に合わせたカスタムの可否は、現場が継続的に使うかどうかを左右します。そのため、可視化は作って終わりではなく、使われ続ける機能設計が肝心です。
需要予測・売上予測の予測モデル機能
予測モデル機能は、蓄積したデータから未来を推定し、需要予測や売上予測、在庫の適正量算出などを、機械学習や統計モデルで実装します。予測は可視化より高度なため、開発費も上がります。
一次データでは、在庫最適化目的の分析システムが300万〜500万円、売上予測目的なら400万〜600万円が相場とされ、目的によって必要な機能の深さが異なることが分かります。また、AIエンジニアの人月単価は80万〜120万円で、高度な統計・機械学習を要する場合はさらに20〜40%高くなります。
予測モデルは作って終わりではなく、継続的なチューニングが前提です。市場や業務の変化に合わせて再学習させないと、予測精度は徐々に劣化します。さらに、一次データでは、自社開発したシステムの維持費としてチューニングに月10万〜30万円、データクレンジングに月5万〜15万円がかかるとされています。予測機能は、初期構築費だけでなく、精度を保つ運用機能と継続コストまで見て評価することが欠かせません。
RAG検索・シミュレーションの機能
近年のデータ管理システムには、数値分析に加えてAI検索(RAG)やシミュレーションといった発展的な機能が組み込まれるようになっています。
これらは「データを蓄積した先で、人がどう問いかけ、どう試行錯誤するか」を支える機能であり、データ基盤の投資価値を一段引き上げます。
AI検索(RAG)やシミュレーションは、標準必須とまでは言えず、自社の活用方針によっては中核機能になります。
自然言語でデータを問えるRAG検索機能
RAG検索機能は、社内のドキュメントやデータを生成AIと組み合わせ、自然言語の質問に根拠つきで答える仕組みです。たとえば「先月の関東の売上トレンドは」「この規定はどこに書いてあるか」といった問いに、AIがデータや文書を参照して回答します。
実装には、社内データをベクトル化して保存するベクトルDBや、回答を生成するLLMのAPI連携が必要です。一次データでは、API活用型の構築費は200万〜600万円とされています。また、運用費は、API利用料にベクトルDBや監視を加えて月30万〜130万円が目安です。
RAG機能で注意すべきは、運用コストの読みづらさです。一次データによれば、社内ナレッジへの1リクエストで数千〜数万トークンを消費し、AIエージェントによる多段処理やリトライが重なると、消費量が想定の5〜30倍に膨らむこともあります。そのため、機能を評価する際は、便利さだけでなく、トークン消費を抑える設計や利用量の監視機能まで備わっているかを確認することが、後の従量課金の暴騰を防ぎます。
条件を変えて試せるシミュレーション機能
シミュレーション機能は、予測モデルを応用して「条件を変えたらどうなるか」を試す機能です。たとえば「発注量を1割増やしたら在庫と欠品はどう変わるか」「価格を変えたら需要はどう動くか」を、実際に動かす前にデータ上で検証できます。シミュレーションは、データ活用を「見る」から「試す」へ進める機能だと言えます。
予測が一つの未来を示すのに対し、シミュレーションは複数のシナリオを比べて意思決定を支える点が特徴です。多くは予測モデルの一機能として実装され、独立した大規模機能というより、予測基盤の上に「条件入力と結果比較のインターフェース」を載せる形になります。在庫最適化では、安全在庫の水準や発注リードタイムを変えながら最適点を探るのが代表的な使い方です。
導入の判断は自社の意思決定の性質によるもので、発注量や価格、人員配置など「条件を変えるとどうなるか」を頻繁に検討する業務があるなら、シミュレーションの価値は高くなります。機能を検討するときは、次の2点を重視するとよいでしょう。
- 操作性:現場が直感的にパラメータを変えて試せるUIになっているか
- 結果の提示:結果を意思決定に使える形で提示できるか
過去と現在の可視化で足りる段階なら、無理に作り込む必要はなく、自社の意思決定にどの機能が効くかを見極めて取捨選択することが、無駄のない投資につながります。
権限管理・データガバナンスの機能
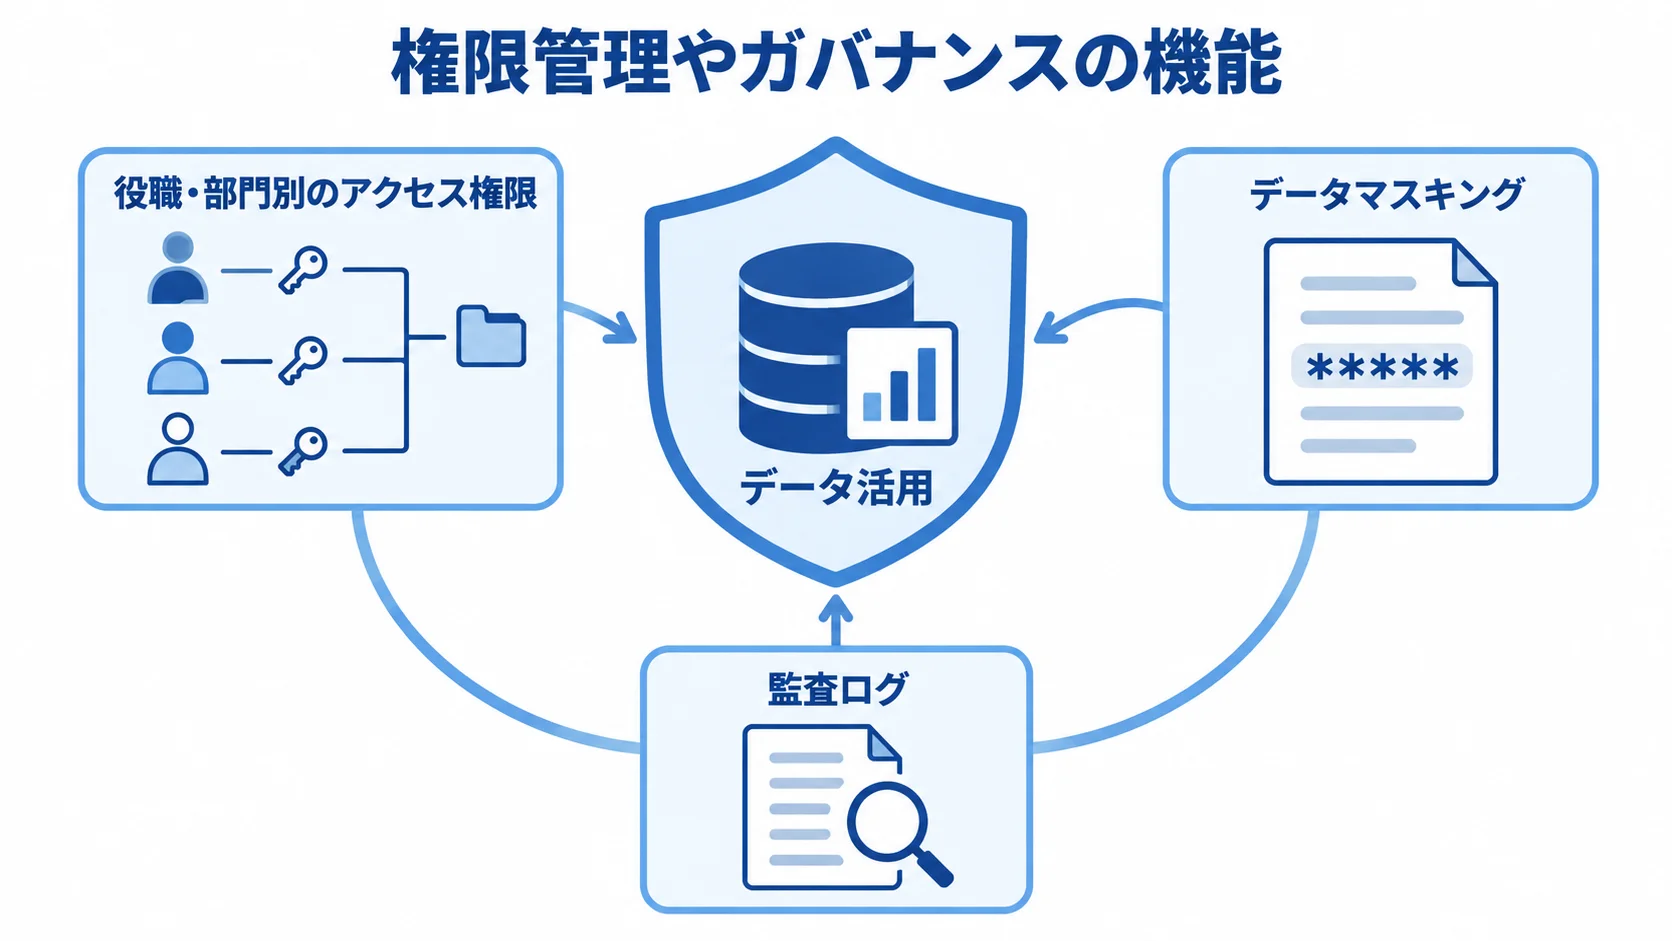
データを全社で活用するほど、誰がどのデータを見てよいかを制御する権限管理やガバナンスの機能が重要になります。
データ収集や分析といった「攻め」の機能に注目が集まりがちですが、機密情報を守る「守り」の機能が欠けると、便利な基盤が情報漏えいの温床になります。
権限管理は、データ活用を安全に広げるための前提機能です。
役職・部門別のアクセス権限機能
アクセス権限機能の標準は、役職・部門に応じて参照できるデータの範囲を制御する仕組みです。たとえば人事データは人事部と経営層だけ、エリアの売上は担当部署だけ、というように、ユーザーの属性に応じて見える範囲を絞り込みます。
これをAI検索やダッシュボードと連動させ、「権限のない人には、そもそもデータが見えない・回答に含まれない」状態を作ることが、安全な活用の鍵になります。実装面では、ログイン認証をIdP(認証基盤)と連携させ、社内のアカウントと権限をまとめて管理する設計が一般的です。
これにより、入退社や異動に伴う権限変更を、認証基盤側の操作だけで反映できます。機能を評価するときは、権限を細かい単位で設定できるか、設定が複雑になりすぎず運用できるかという、現実的な運用の負荷まで見ることが大切です。権限管理は作り込みが甘いと後から全体を作り直すことになりやすいため、要件定義の初期から織り込む必要があります。
データマスキング・監査ログの機能
権限管理を補完するのが、データマスキングと監査ログの機能です。マスキングは、個人情報や機密性の高い項目を、表示や分析の段階で隠したり置き換えたりする機能です。たとえば氏名や口座番号を伏せたまま分析できるようにすれば、データの利便性を保ちつつプライバシーを守れます。
また、AI検索で回答にこうした情報が混ざらないよう制御するうえでも、マスキングは欠かせません。監査ログ機能は、誰がいつどのデータにアクセスしたかを記録します。これにより、不正アクセスの検知や、万一の情報漏えい時の追跡が可能になります。
ガバナンスとAI活用の共存を実現するには、攻めの分析機能と、この守りの記録・統制機能を一体で設計することが欠かせません。そのため、機能比較の最終段階では、こうしたセキュリティ・ガバナンス機能が標準で備わっているか、追加開発が必要かを必ず確認しましょう。守りの機能の充実度が、全社展開できるデータ管理システムかどうかを分けます。
機能を連携させて相乗効果を生む設計
ここまで挙げた機能は、それぞれ単独でも価値がありますが、共通のデータ基盤の上で連携させると相乗効果が生まれます。たとえば予測モデルが算出した需要データを、RAG検索を通じてAIエージェントに読ませ、「来月の発注はどう調整すべきか」と自然言語で対話する、という次世代のフローが実現します。
可視化・予測・検索を別々に作らず、一つの基盤に積み上げておくと、機能の価値を最大化できます。この連携を見据えると、機能選定の段階で「将来どの機能を足すか」をある程度想定しておくことが重要になります。後から機能を追加するたびにデータを集め直す設計だと、無駄な手戻りが発生します。
最初の基盤構築時に、予測・検索・ダッシュボードが同じデータを参照できる土台を整えておけば、機能を段階的に足しても効率を保てます。機能を個別の点で評価するのではなく、連携した面として捉える視点が、長期の投資効率を左右します。
まとめ
データ管理システムの機能は、四つの柱にまとめられます。土台になるのはデータ収集・クレンジングで、価値を生むのは可視化BIと予測モデル、活用を広げるのはRAG検索とシミュレーション、安全を担保するのは権限管理・データガバナンスです。
なかでも収集・クレンジングは全体予算の2〜3割を占める背骨であり、予測モデルやRAGは継続的なチューニングと従量課金という運用コストまで見て評価する必要があります。また、全社展開を安全に進めるには、権限管理とマスキングが前提になります。
機能を選ぶときは、流行の機能を全部盛りにするのではなく、自社の業務とデータの実態に照らして必要なものを見極めることが大切です。そこで、小規模なMVPで必須機能から始め、効果を確認しながら段階的に機能を足していくのが、無駄のない進め方です。
riplaはフルスクラッチ受託と国内開発を組み合わせ、自社に本当に必要な機能の見極めから、データ基盤の設計・構築までを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。