
予測分析システムで起こりやすい失敗は、PoC死やデータ品質の軽視を含め、大きく4つの型に分けられます。
PoCの期限や判定基準、データの整備、運用体制を確かめながら段階的に進めると、これらの失敗を避けやすくなります。失敗の型を知って先に対策しておくことは、貴重な投資を守る最大の保険です。
▼全体ガイドの記事
・予測分析システムの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
PoC死:実証実験で止まり本番に乗らないリスク
予測分析で多い失敗は、PoC(実証実験)後に本番運用へ進まない「PoC死」です。PoCは本開発に進むかを判断する手段で、ゴールではないことを、開始前に関係者全員で共有しておく必要があります。
Gartnerの調査(一次データ)では、AIプロジェクトの30%がPoC後に放棄されています。そのため、投資した費用が成果を生まない事態を避けるには、PoCの目的を最初に確かめておくことが大切です。
PoCが長引いて結論が出ない失敗
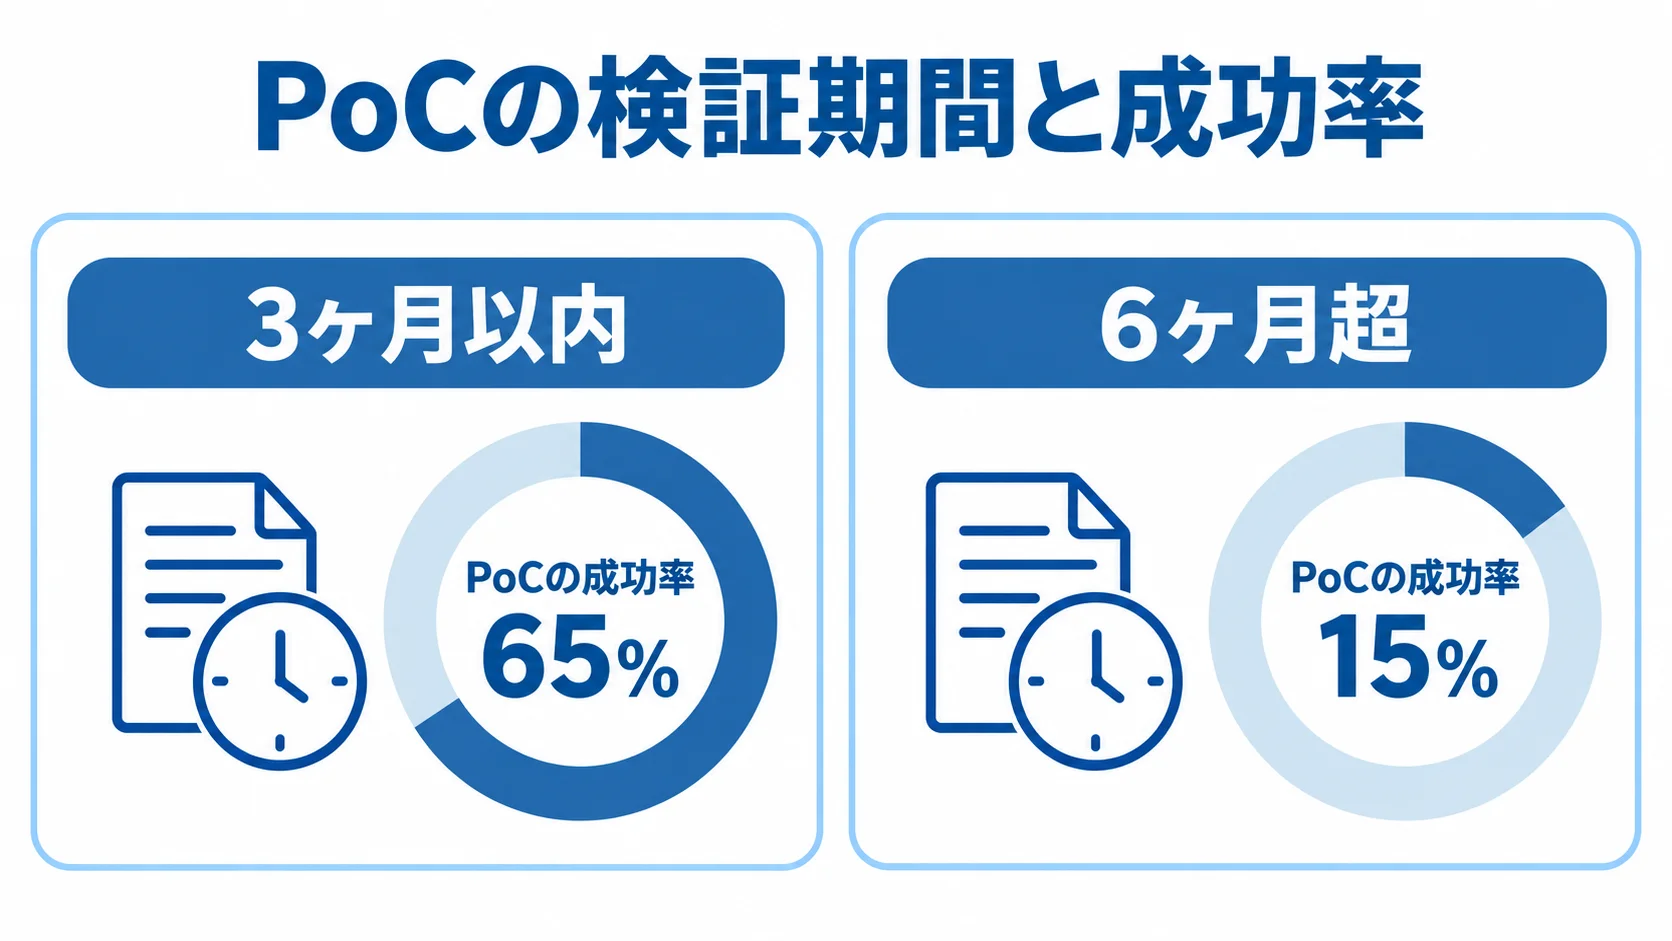
検証が長引くと結論が出ず、関係者の関心が薄れてPoCが立ち消えになることがあります。期間は成功率にも関わります。一次データでは、期間の長さによって成功率に大きな差が出ています。
- 3ヶ月以内に結論:PoCの成功率は65%と報告されています。
- 6ヶ月超で検証:成功率は15%まで下がるとされています。
「データを増やす」「モデルを調整する」と検証を延ばすほど、費用がかさみます。
そこで、開始前に期限と成功・撤退の判定基準を決めておきます。たとえば、3ヶ月を期限とし、目標精度に達すれば本開発へ進みます。
目標に届かなければ、撤退するか仕切り直します。基準を曖昧にせず短期間で白黒をつけておけば、PoC死を防げます。
特に、3ヶ月で結論を出すことは、最大のコスト削減につながります。
検証環境と本番環境のギャップという失敗
PoC死には、検証環境では精度が出ても本番環境では出ないという形があります。研究用のデータは整っていて好成績が出やすい一方で、実業務では雑多で不完全なデータが日々流れ込みます。
データの違いにモデルが対応できず、精度が安定しないことがあります。「実験では当たったのに現場では当たらない」という落差は、現場の信頼を失わせます。
- 本番に近い実データ:実運用と同じ品質・形式のデータでの精度確認
- 業務で使えるか:現場が使い続けられるかの評価
- 引き継ぎ体制:検証結果を本番の運用チームへ渡す仕組み
PoCでは、精度だけでなく本番運用に耐えられるかも確かめておくことが大切です。運用の現実を見据えた設計があれば、検証と本番のギャップを防げます。
PoCを始めた時点から、成果を本番チームへ引き継ぐ仕組みも考えておきます。たとえば、どのデータが有効か、どう前処理するかといった情報を、運用チームへ渡しておきます。
データ品質軽視による精度不足と再構築リスク
予測分析で根深く厄介な失敗は、データ品質の軽視です。予測精度は入力データの品質に左右されるため、ここを軽く見ると、あとで大きな手戻りを招きます。
データが不十分なままモデル開発を進めると、最後になって精度不足が判明し、データから作り直す事態になりかねません。
データ準備を軽視して開発費が膨らむ失敗
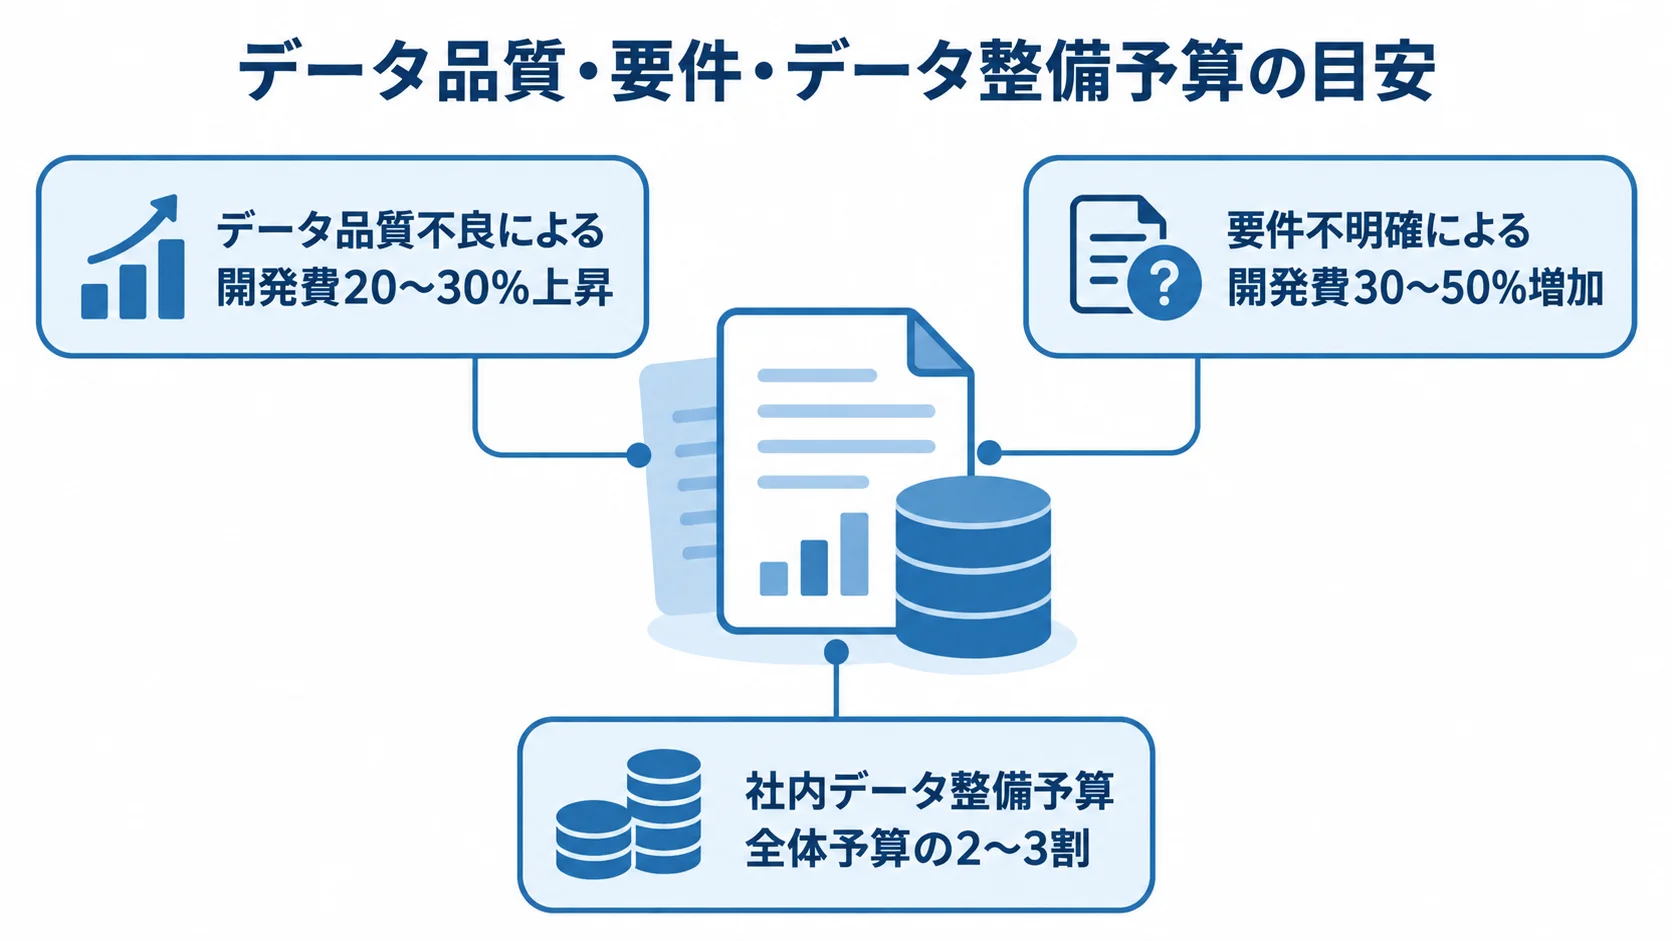
データ品質の問題や要件の不明確さは、手戻りを生んで開発費を押し上げます。費用の増え方と、整備に充てる予算の目安を、あらかじめ見積もっておく必要があります。
- データ品質が不良:開発費が20〜30%上昇
- 要件が不明確:開発費が30〜50%増加
- 整備予算:全体予算の2〜3割を、社内データの収集・クレンジングに充てる
これらは、後工程でデータの問題が発覚して修正が必要になったときのコストです。
「データはあるから大丈夫」という楽観は禁物です。そこで、プロジェクトの初期にデータの現状を評価し、整備にかかる工数と費用を予算に含めておきます。
特に非IT企業では、部署ごとに形式が異なり、紙やExcelにデータが散在して、欠損も多くなりがちです。
こうした状態を確かめたうえで、モデル開発を急がず、地道な整備に時間と費用をかけます。予測モデルの華やかさより、データ整備の地道さを優先するほうが、最も安く確実に精度を出す道です。
日々増えるデータにも同じ品質基準を保つ運用が必要です。基準を維持できなければ、整えたデータ基盤も時間とともに再び品質が落ちます。
データ整備は一度きりではなく、継続して守る活動です。運用では、入力ルールを統一し、異常なデータを早い段階で検知します。
精度が出ず再構築に追い込まれる失敗
データ品質を軽視して招く最悪の事態は、システムの再構築です。開発後に精度不足が判明すると、データ基盤から作り直すこともあります。
そうなると、初期投資が無駄になり、費用も二重にかかります。
MITの調査では、AIプロジェクトの95%が期待した成果に届いていません。その背景には、データに起因する失敗もあります。再構築を避けるには、進め方を次のとおりにすると有効です。
- MVPで小さく検証:費用200万〜300万円で、データの精度を確かめる
- 一部の業務で試行:十分な精度を確認してから本格展開
MVP(Minimum Viable Product)で問題を小さな損失で把握できるため、全社規模で作り込む前に検証することが、再構築の回避につながります。
運用・チューニングコスト暴騰と予算超過リスク
予測分析で見落とされがちな失敗は、運用コストの暴騰です。
モデルは市場や顧客行動の変化に応じて再学習・調整が必要です。そのため、初期費用だけを見て運用費を軽視すると、稼働後の継続費用が予算を圧迫します。
TCOを見誤り予算が30〜40%超過する失敗
運用コストの見落としは、予算超過として表れます。一次データでは、企業の85%がコストを10%以上見誤り、初年度の予算が30〜40%超過すると報告されています。
特に、運用費を見積もりに含めないことは、予算超過の主因の一つです。
- 初期費用:TCO(総保有コスト)の約20%
- 運用・教育・データ整備:TCOの残り約80%を占める
- 予算計画:見積もりに30〜40%のバッファを持たせる
この構造を知らずに予算を立てると、後から資金が足りなくなるおそれがあります。
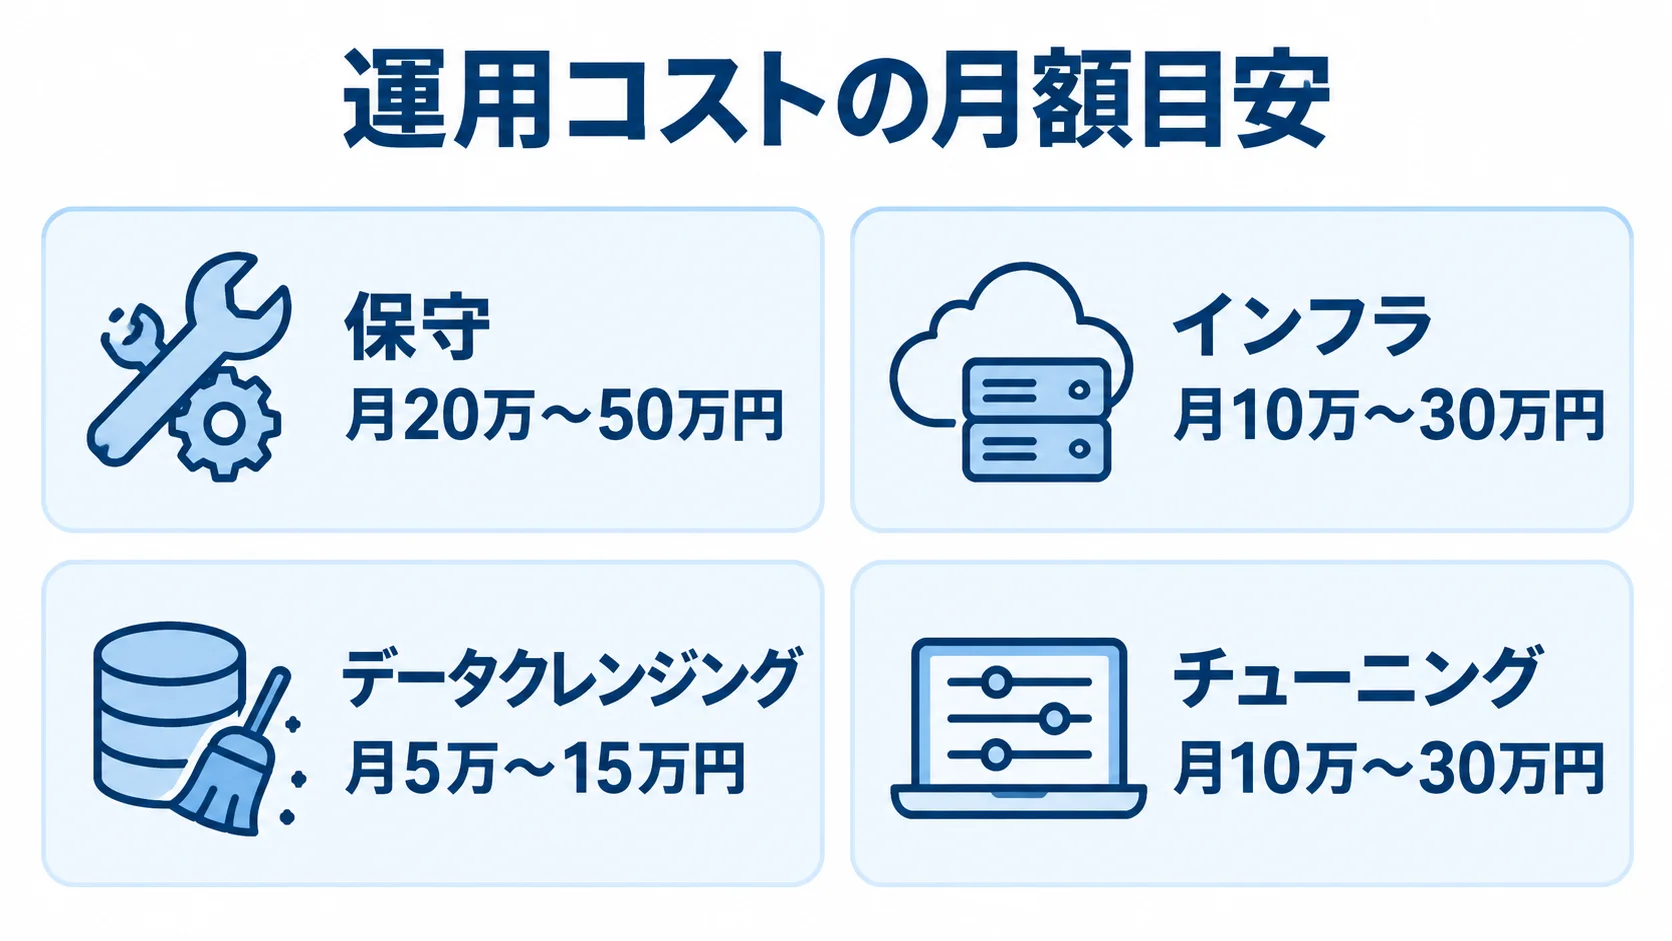
自社開発の運用費では、保守が月20万〜50万円、インフラが月10万〜30万円かかります。さらに、データクレンジングが月5万〜15万円、チューニングが月10万〜30万円かかります。
これらを合算すると月数十万円規模になり、年間では数百万円の継続費用になります。初期費用の安さに惑わされず、TCO全体で判断すれば、予算超過を防げます。
運用放置でモデルが劣化する失敗
運用コストを惜しむと、モデルの劣化を放置する失敗につながります。市場環境が変わると、学習時の傾向に基づくモデルの精度が下がります。
放置すると、予測が当たらなくなり、現場が使わなくなるおそれがあります。
- 精度を監視:劣化の兆候を継続的に把握
- 再学習を実施:担当者と実施時期を運用ルールに定める
継続して再学習や調整をする体制がなければ、予測分析は陳腐化します。こうした仕組みを整える考え方が、MLOpsです。
発注側と開発会社は、MLOpsを運用設計に組み込み、運用をコストではなく精度維持の必須投資として扱います。
riplaは、フルスクラッチ受託と国内開発の立場から、初期構築だけでなく運用時の精度維持も見据えた設計を重視しています。
内製化失敗とベンダーロックインのリスク
予測分析の長期リスクは、内製化の失敗とベンダーロックインです。ベンダー依存は運用費や改善の外注費を生み、一方で内製化を急ぐと運用が回らなくなります。
外注と内製のバランスを誤ると、長期的な失敗につながります。
ベンダー依存で身動きが取れなくなる失敗
ベンダーロックインは、特定企業の技術や仕組みに依存し、他社への移行や自社での運用が難しくなる状態です。モデルの中身がブラックボックス化することもあります。
- 契約・権利を明確化:ソースコードの権利とデータの所有権を定める
- 知識を社内に蓄積:自社が中身を理解し、引き継げる状態を作る
依存が強いと、改善やトラブル対応のたびに同じベンダーへ頼ることになります。費用や納期を相手に委ねる形になり、運用コストが膨らむおそれもあります。
競争原理が働かないまま運用費がじわじわ膨らむ、静かですが深刻な失敗です。
そこで、ドキュメントを整えて、特定のベンダーしか分からない状態を避けます。開発の過程で担当者が知識を得て、扱える領域を徐々に広げていきます。
内製化を焦って運用が回らなくなる失敗
ロックインを恐れて内製化を急ぎすぎる失敗もあります。運用には統計や機械学習の知識が必要で、人材がいないまま全てを担うと、運用が止まり精度が崩れるおそれがあります。
- 段階的に内製化:ベンダーの支援を受けながら、社内の対応範囲を広げる
- 役割を分担:専門性の高い業務はベンダーが、日々の運用判断は自社が担う
また、現場の担当者を、予測結果を読み解ける「AIパワーユーザー」に育てます。非IT企業が、データサイエンティスト級の人材を急に確保するのは、現実的ではありません。
riplaは、フルスクラッチ受託と国内開発の立場から、透明性のある開発と現場の内製化を見据えた伴走を重視しています。
ロックインと内製化失敗の両極端を避け、外注と内製の範囲を段階的に調整することが、予測分析を長く活かす鍵です。
撤退基準がなく惰性で投資を続ける失敗
導入の判断には熱が入りやすい一方で、失敗時の対応を決めないまま始めるケースがあります。
撤退基準がなければ、効果が出なくても「もう少し」と投資を続け、損失が膨らみます。これは、導入時に撤退基準を決めなかったことから生じる、構造的な失敗です。
- 撤退ラインを決める:導入判断と同時に、見直しの条件を定める
- 利用率を確認する:稼働6ヶ月後に現場の利用率が70%未満なら、撤退・見直しを検討する
具体的な基準があれば、感情に流されず損失を抑える判断ができます。そのため、「始める判断」と「やめる判断」をセットで設計しておきます。
まとめ
予測分析システムでは、PoC後の放棄とデータ品質不足が起こり得ます。加えて、運用費の見落としや内製化・ベンダー依存の失敗にも注意が必要です。
PoCは3ヶ月で区切り、データ整備に投資して、運用費を含むTCOで予算を立てます。そのうえで、MVPで小さく検証し、段階的に内製化していく進め方が、リスクを抑えます。
riplaはフルスクラッチ受託と国内開発を組み合わせ、データ整備から運用・内製化まで支援します。全体像は予測分析システムの完全ガイドをご覧ください。
▼全体ガイドの記事
・予測分析システムの完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。