
在庫管理のAIエージェント開発は、業務とKPIを整理し、連携を設計して開発し、テストを経て段階的に公開する順に進めるのが基本です。この順で進めると、大きな投資をする前に効果とリスクを確かめられるため、投資リスクを抑えやすくなります。
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
在庫管理のAIエージェント開発・構築の全体像
在庫管理AIは、複数のツールで需要と在庫を把握し、発注の提案から承認依頼、登録、監視までを行います。従来の集計・可視化・予測を中心とするシステムとは異なり、目的に沿って処理の順番を組み立て、外部システムを操作する点が特徴です。
属人化・過剰在庫・欠品を同時に解決する考え方
発注では、経験をもとに季節性や得意先の動きを判断し、Excelやメールで仕入先へ連絡する場合があります。柔軟な方法ですが、担当者が不在のときは判断が止まり、その基準も説明しにくくなります。さらに、拠点ごとに在庫の持ち方が異なり、発注の判断をそろえにくい点もあります。
- 発注理由を提示:販売実績、入荷予定、リードタイム、最低発注量、倉庫容量、販促予定を踏まえ、発注理由を示します。
- 欠品需要を補正:欠品期間の売上が0件でも需要なしとはみなさず、前後の販売や代替品、注文キャンセルから損失を推定します。
- データを整える:欠品データを補正して、学習に使える需要情報をそろえます。
データ品質の改善をAI開発の前工程として扱うことが、在庫削減と欠品抑制を両立させる近道です。
従来システムとAIエージェントの違い
従来の需要予測システムでは、予測値や発注点を画面に表示し、担当者がその結果を見て発注します。
- AIエージェント:発注ロットや倉庫の空き、納期遅延、社内ルールを確かめたうえで発注案を作り、承認依頼までを担います。
- 自動化の範囲:提案から承認付き発注、限定商品の自動発注へと、自動化の範囲を広げていきます。
MonotaROの公式テックブログでは、機械学習への切り替えで発注量が増えた事例を紹介しています。50万点近い在庫品を扱う物流現場では、入荷能力への影響を考えて、予測の更新頻度を下げる検討をしました(出典: MonotaRO Tech Blog、2022年)。
精度を上げることと、現場が処理できる量に抑えることは別のKPIです。そのため、AIエージェントには、発注額と入荷量を制約条件として持たせる必要があります。
在庫管理のAIエージェント開発・構築の進め方
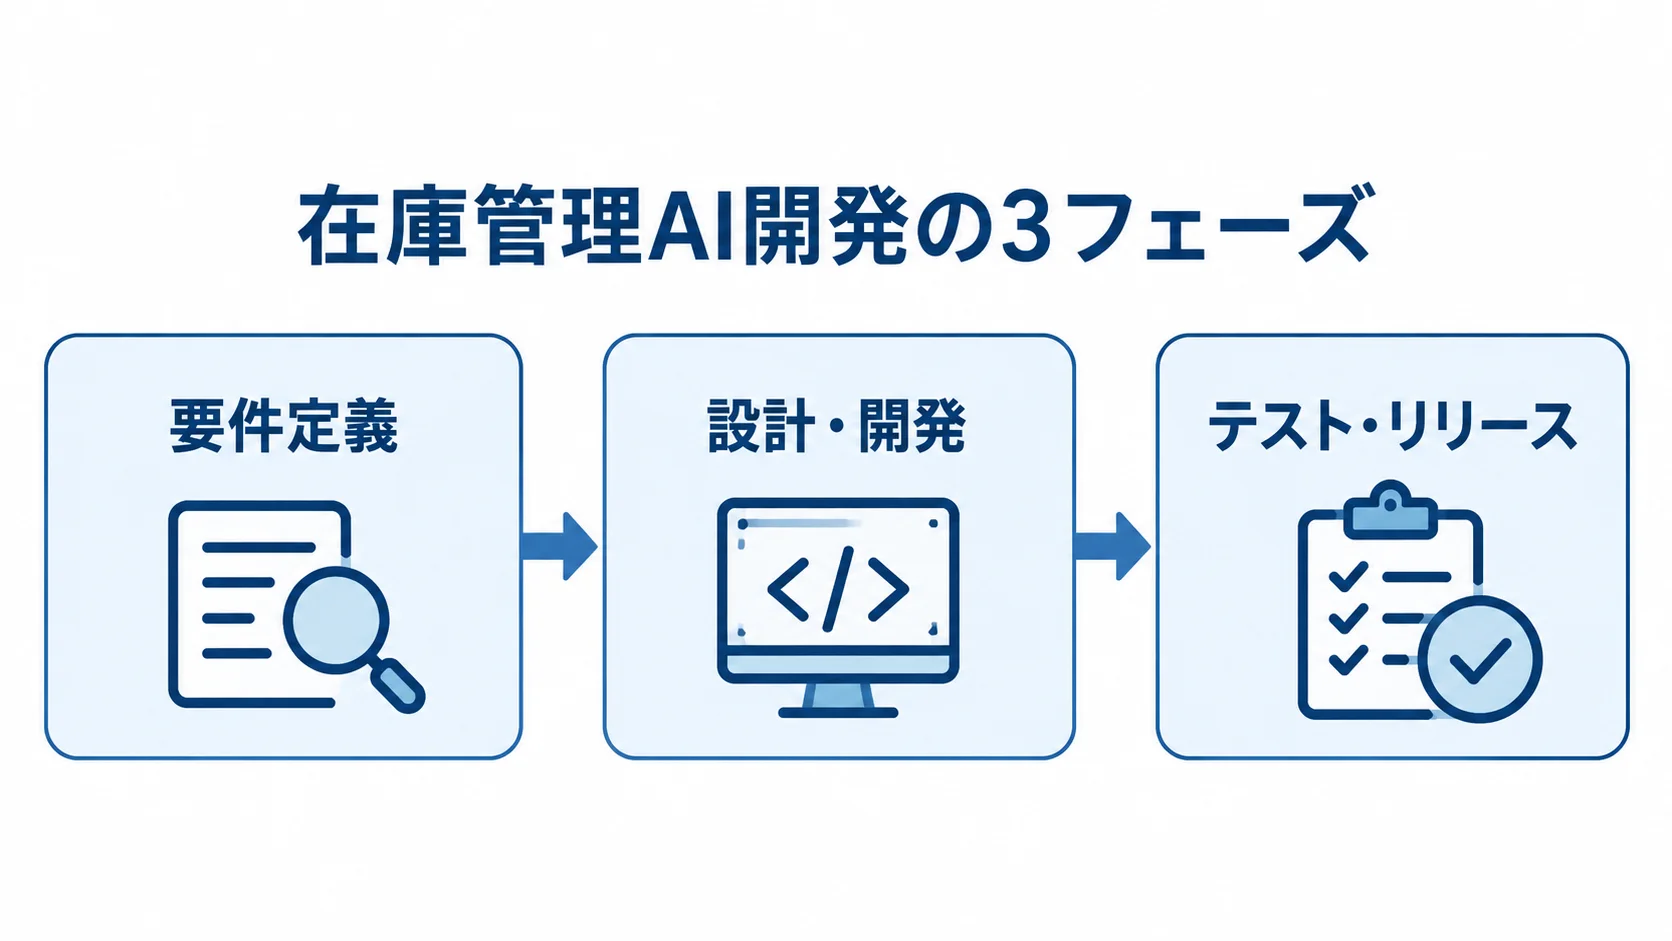
開発は、要件定義、設計・開発、テスト・リリースの3フェーズで進めます。各フェーズで必要な事項は、文書に残しておきます。
- 要件定義:AIに任せる業務と参照データ、人の確認条件を定めます。
- 設計・開発:失敗時に戻す手順を含めて、業務に沿った仕組みを作ります。
- テスト・リリース:定めたKPIと安全条件を確かめてから、公開します。
モデル選定から始めると、業務に合わない仕組みになりがちです。そのため、最初に業務フローとKPIを決めておくことが大切です。
要件定義とPoCの対象業務
まず、在庫金額や欠品率、廃棄率などの現状値を測ります。在庫回転率、発注作業時間、予測誤差も押さえておきます。
- 対象を絞る:全商品・全拠点には広げず、季節変動を比較的読みやすい1カテゴリ、1倉庫、数十〜数百SKU程度で始めます。
- 業務を選ぶ:毎朝の発注候補、欠品リスク通知、入荷予定と販売計画の照合など、失敗時の影響を限定できる業務から着手します。
- PoCを検証する:精度、発注上限、根拠の理解、システム登録を確かめます。
撤退基準は、商品群の特性と業務KPIに合わせて個別に設定します。例えば、ベースラインモデルより欠品率が改善しない場合は、対象範囲を縮小します。
発注候補のレビュー時間が短縮されない場合も、対象範囲を縮小します。さらに、在庫金額の増加やデータ欠損が続く場合は、予測モデルを見直します。
データ基盤・エージェント・連携の設計
設計では、販売実績や在庫残高、入出荷、発注残などのデータを、どこから取得し、どの頻度で更新するかを決めます。商品マスタや仕入先マスタ、リードタイム、販促カレンダーも、取得元と更新頻度を決める対象です。
- データ仕様:実在庫と理論在庫の差異、単位、商品コード統廃合、返品、欠品の扱いを定めます。
- ツール権限:入力項目、照会、予測、発注候補、仕入先確認、承認申請、登録の権限とログを設定します。
- 更新の安全性:自由なSQLで本番DBを更新させず、許可APIやストアドプロシージャで読み書きを分けます。
データクレンジングに3〜6か月かかるケースもあるため、開発工程とは別に見積もります。
テスト・段階リリース・効果測定
テストでは、通常ケースに加えて、例外的な状況も再現します。急な販促や災害による納期遅延、仕入先の休業、欠品、重複発注、価格の異常、通信断などが対象です。
- 誤候補を検証:担当者が誤りに気付き、発注を取り消せるか、二重登録を防げるか確かめます。
- 段階的に公開:担当者の承認から始め、KPI確認後に低額・定型商品へ広げます。
検証用データと本番データは分けておき、ログには入力や根拠、AIの判断、承認者、実行結果を残します。こうした段階的なGo/No-Goで進めると、投資リスクを抑えやすくなります。
API非対応のレガシーシステムとの連携方法
在庫管理の現場では、すべてのシステムにAPIが用意されているとは限りません。古いERPや倉庫管理システム、専用端末、CSV連携だけの仕組みが残っている場合は、連携方式を現実に合わせて選ぶ必要があります。
特に、この接続部分を見積もりから外すと、AI部分よりも接続のほうで納期と費用が膨らみます。
CSV連携・RPA・中継サーバーの使い分け
CSV出力ができるなら、決まった時刻に在庫、発注、入荷のデータを出力し、中継サーバーで検証したうえでデータ基盤へ取り込みます。
- CSV連携:発注候補をCSVで出力し、人が確認してから取り込みます。低コストで始めやすいのが利点です。
- 画面操作:RPAは、画面の変更やポップアップ、通信遅延、セッション切れに備えて、再試行とエラー通知を設けます。
- SQL接続:参照は読み取り専用にし、DBの仕様変更を監視します。
直接更新は業務ルールを迂回し、在庫残高や発注履歴を壊す危険があるため、原則として避けます。必要な場合は、更新対象、トランザクション、ロールバック、実行者、承認者を記録し、責任範囲を契約に明記します。
連携仕様と障害時の責任分界
連携仕様書には、データ項目、文字コード、単位、タイムゾーンを記載します。加えて、更新頻度や欠損時の扱い、重複排除、エラー時の再送、手動復旧の手順も書いておきます。
- 二重発注を防ぐ:同じ発注番号を二度送っても重複しない冪等性と、送信済み・受付済み・確定済みの状態を管理します。
- 取得時刻を記録:遅延データを新しい在庫と誤認しないようにします。
- 原因を切り分ける:データ、モデル、連携、承認、仕入先の処理を整理します。
経済産業省は2026年に、AI利用時の民事責任に関するガイダンスを公表しました。
AIの自律性やブラックボックス性を踏まえると、責任分担を整理することが重要です(出典: 経済産業省「Guidance on the Interpretation and Application of Civil Liability in the Utilization and Application of AI」、2026年)。
ガバナンスと安全制御の設計
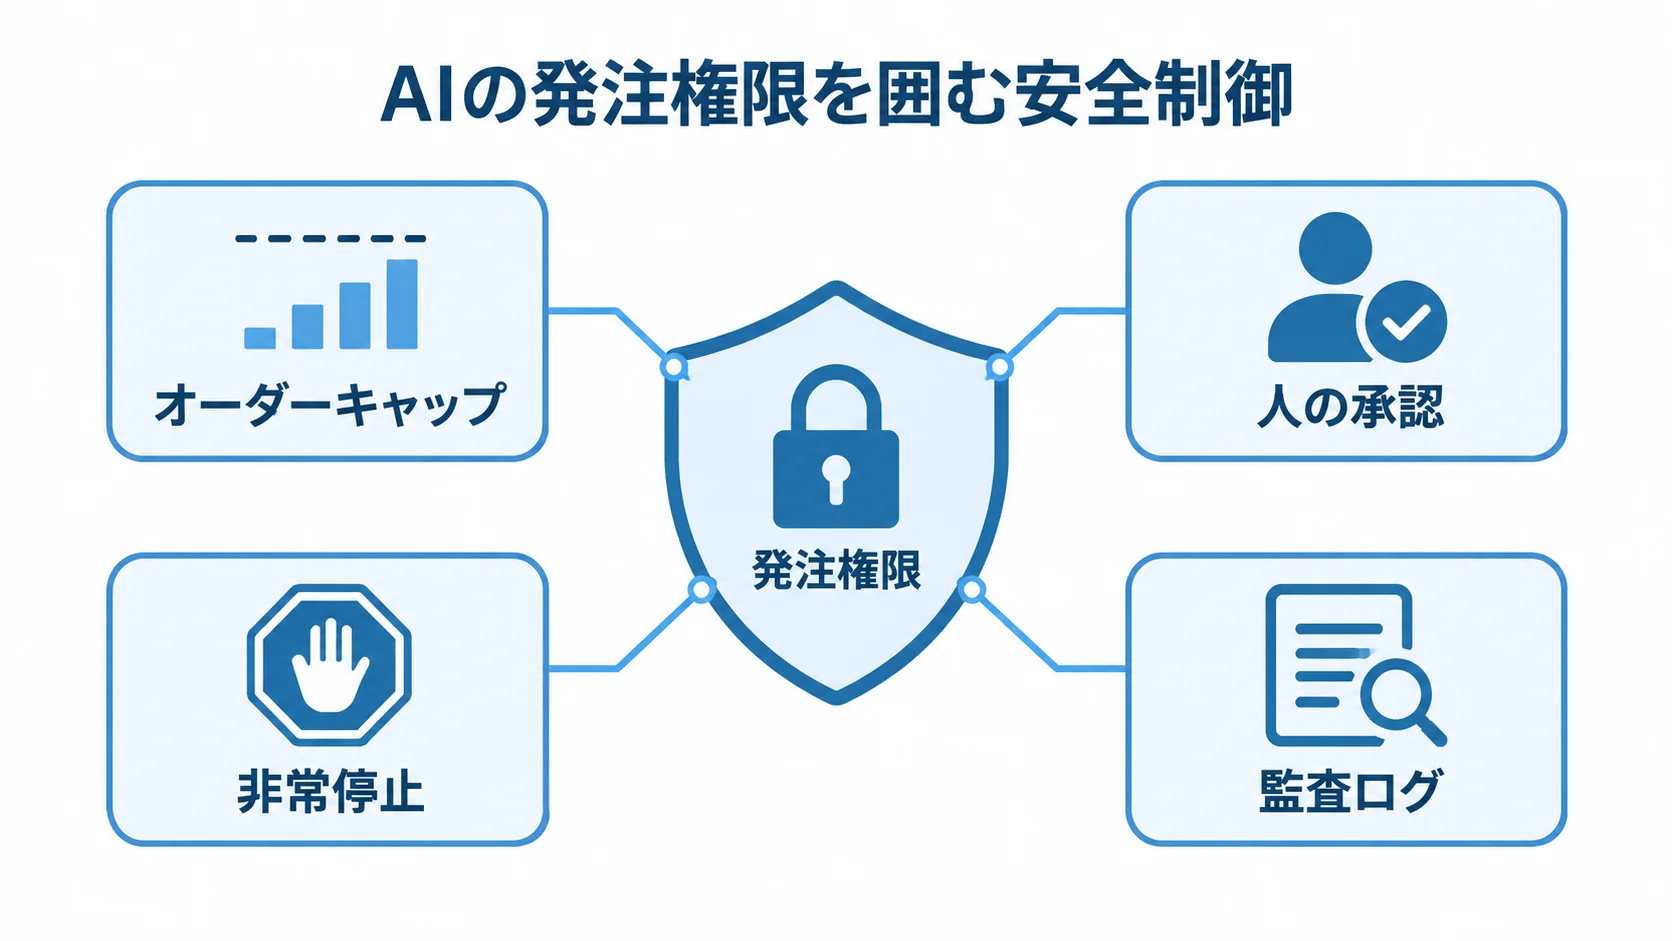
在庫管理でAIに発注権限を与える場合、誤りの影響はチャットの回答ミスより大きくなります。そのため、オーダーキャップや承認フロー、非常停止、ロールバック、監査ログを最初から実装します。
NISTのAI Risk Management Frameworkは、AIの信頼性を全ライフサイクルで扱う枠組みです。設計・開発から導入、利用、評価までを対象とし、ガバナンスを続けていく考え方です(出典: NIST AI RMF、2023年・2024年更新)。
オーダーキャップとHuman-in-the-Loop
オーダーキャップは、1回あたりの発注金額やSKU単位の数量、仕入先単位の金額、1日あたりの総発注額に上限を設ける仕組みです。
- 人の承認へ戻す:上限超過時、過去平均との差が大きい場合、通常と異なる仕入先への発注時は自動実行せず、人の承認へ戻します。
- 非常停止:連携キューを止め、未実行の発注を保留にします。
- 承認対象を限定:高額な発注や初回、急増、欠品期間の補正が大きい商品、仕入先変更を伴う発注だけを承認にかけます。
- 根拠を表示:現在庫や予測需要、納期、安全在庫、発注理由、代替案を画面に示します。
Human-in-the-Loopでは、すべてを人に確認させると負担が増え、確認が形骸化してしまいます。そのため、低額で定型的な補充は自動化し、確認が要る発注を見分けます。
説明可能性と管理画面のUX
「AIが発注を勧めています」と表示されるだけなら、担当者は根拠を判断できず、承認に進めません。現場の担当者が承認するには、画面で根拠を確かめられることが必要です。具体的には、予測の根拠になった直近の販売推移や季節性、販促予定、欠品日数、入荷予定、納期の不確実性を表示します。
- 根拠を見せる:重み付けを図や短文で示し、データ更新時刻も明記します。
- 現場の判断を記録:却下や数量修正の理由をモデル評価に活用します。
- 検証可能性を重視:業務で確かめられる根拠を提示します。
判断を記録する理由には、販促中止や仕入先の納期遅延、代替商品への切り替えなどがあります。説明の目的は、業務で検証できる根拠を示すことです。
AIエージェント特有のセキュリティリスク
AIエージェントは、データを読むだけでなく、APIを呼び出したり、外部へ情報を送ったり、業務システムを更新したりします。
- 想定する脅威:プロンプトインジェクション、機密情報の外部送信、ツールの誤操作、第三者製スキルやMCPの供給網リスクを想定します。
- 実行環境を分ける:本番DBから切り離し、必要なAPIだけを許可します。
- 外部ツールを検査:コードや設定を確認し、依存関係を固定します。
環境変数と認証情報も、用途別に分けます。Snykの2026年調査では、3,984件のAgent Skillsを分析しました。
その36.82%に何らかの問題があり、13.4%に重大な問題がありました。76件に悪意あるペイロードを確認したと報告されています(出典: Snyk「ToxicSkills」、2026年)。
この調査は、外部ツールのコードや設定、自然言語指示を検査する際の参考になります。ただし、在庫管理システム自体の統計ではない点に注意が必要です。そのうえで、導入前にはスキャンとネットワーク隔離を行い、操作ログを残しながら、権限を定期的に見直します。
SaaS・フルスクラッチ・OSS内製化の選び方
開発アプローチは、業務の独自性や既存システムの複雑さ、社内のデータ・セキュリティ人材、将来の拡張範囲をもとに決めます。SaaSは短期間で始めやすい一方、独自の発注ルールやレガシー連携には制約があります。
フルスクラッチは自由度が高い反面、初期費用と保守負担が大きくなります。OSS内製化はライセンス費を抑えられますが、アップデートや脆弱性対応、評価基盤、運用人材の費用まで含めて、TCOを比べることが必要です。
SaaSとフルスクラッチの業務適合性
標準的な在庫可視化や発注提案なら、既存SaaSの設定とAPI連携で十分な場合があります。
複数拠点の特殊な補充ルールや製造工程との連動、重量センサー、店舗ごとの発注制約まで扱う場合は、SaaSを基盤にした追加開発か、個別システムの構築を検討します。
比較するときは、デモ画面を見るだけでなく、実データでの精度や連携方式、ログの取得、データ移行、解約時のデータ返却を確かめます。
LangChain・CrewAI・AutoGenなどのOSSの内製利用
OSSフレームワークを使うと、エージェントの役割分担、ツール呼び出し、ワークフロー、評価処理を柔軟に組み立てられます。
- 内製の体制:PythonやTypeScript、クラウド、データエンジニアリング、セキュリティ、在庫業務の知識を持ち、継続保守できるチームが必要です。
- 総保有コスト:初期費用に加え、3年間の維持費と人員リスクを比べます。
- 外注の引き継ぎ:設計書、データ辞書、評価手順、運用Runbookを納品対象にします。
ただし、OSS自体の利用料が無料でも、モデルAPI、推論基盤、監視、脆弱性対応、テストデータ、当番運用の費用は発生します。
内製は仕様変更に素早く対応できる一方、退職や異動で保守が止まるリスクがあります。外注では、業務知識が手元に残らないと依存が強まります。そのため、共同運用から内製へ段階的に移せる契約にしておきます。
マルチエージェントの役割分担
業務が複雑な場合は、在庫エージェントや需要予測エージェント、補充エージェント、調達エージェント、物流エージェントのように役割を分ける構成も考えられます。
ただし、エージェントを増やすほど、データの受け渡しや権限、失敗時の責任、検証が複雑になります。まずは1つのオーケストレーターと限定したツールで始め、役割分担が効果を生むと確かめてから拡張します。
在庫管理AIの導入事例から読み取れる要点
導入事例を見ると、成果はAIを入れたこと自体より、対象業務を絞り、現場の承認やデータ整備を含めて運用を設計した結果として生まれています。ここで取り上げる事例は、リサーチノートで整理したものです。
企業ごとに対象商品や期間、評価方法が異なるため、自社のKPIへそのまま置き換えず、検証設計の参考として活用します。
MARUWA SHOMEIのセンサー連携と人の承認
照明資材を扱うMARUWA SHOMEIの導入例では、IoT重量センサーと在庫最適化AIを連携しました。欠品や過剰在庫の予兆を検知し、人が承認または却下する運用が紹介されています。
約4か月で184品目を対象に、在庫総額を約13%、金額にして約300万円圧縮しながら、欠品ゼロを達成したとされています。
特に重要なのは、AIにいきなり発注させず、センサーの実測値と人の判断を組み合わせた点です。
ヤオコー・ワークマンに見る発注業務の短縮
リサーチノートでは、ヤオコーがAI自動発注率98%を実現した事例を整理しています。あわせて、店舗の手動発注時間は1日3時間から25分へ短縮しました。
ワークマンは約10万SKUの発注業務を、1店舗あたり30分から2分へ削減した事例として紹介されています。
成果には、予測モデルの精度だけでなく、店舗ごとの例外ルールも関わります。さらに、発注画面の使いやすさや、担当者が確認する対象の絞り込みも、成果に直結します。
MonotaROの事例が示す精度と物流負荷の両立
MonotaROの事例は、機械学習への切り替えで予測値が上がった商品に発注が集中し、入荷キャパシティを圧迫する可能性を明らかにしています。
AIエージェントのKPIを予測誤差だけにすると、精度は高いのに倉庫が処理しきれず、仕入れ資金が膨らむという失敗につながります。そのため、発注量や入荷量、倉庫の作業量、在庫金額を一体で評価することが必要です。
在庫管理のAIエージェント開発費用・費用相場
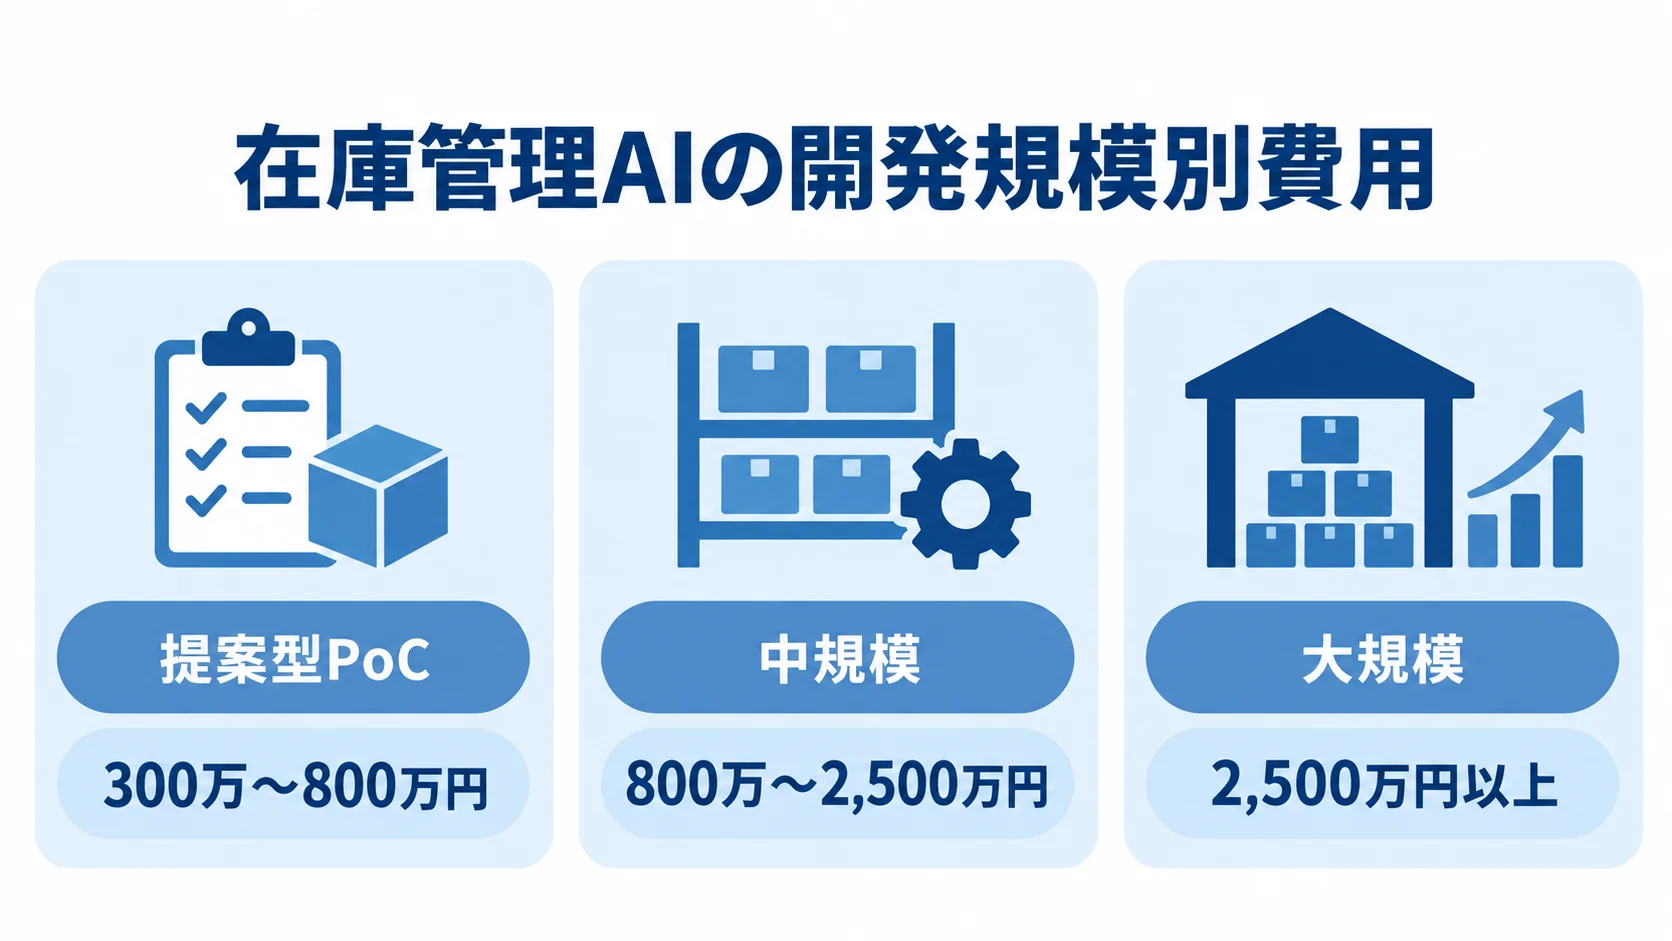
在庫管理のAIエージェント開発費用は、対象SKU数や拠点数、データ品質、既存システム連携、自動実行の範囲で大きく変わります。限定カテゴリの提案型PoCは300万〜800万円、中規模で複数システムと承認フローを連携する場合は800万〜2,500万円が目安です。
全社展開やマルチエージェント、レガシー改修を含む大規模開発は、2,500万円以上になる可能性があります。ただし、これは相場の目安なので、実データを確認した見積もりが必要です。
費用の内訳と工数の考え方
一般的な内訳は、要件定義、データ調査・クレンジング、アーキテクチャ設計、AIモデル・エージェント開発に加えて、APIやRPA連携、画面開発、テスト、教育、保守運用です。
- 費用配分:リサーチノートの実務知見では開発40〜60%、設計・テスト各10〜20%、要件定義約10%です。
- 追加費用に注意:データ整備とレガシー連携は、後から費用が増えやすい領域です。
- 見積もりの前提:含む作業、除外作業、前提条件、追加単価、検収条件を記載します。
請負契約の人月見積もりでは、仕様変更やデータ欠損、連携先の制約に備えて、1.3〜1.5倍程度のリスクバッファが上乗せされる場合があります。バッファは一式にまとめず、どの事態に備える費用かを確認します。
ランニングコストと再学習費用
運用開始後は、クラウドやモデルAPI、データベースの費用がかかります。ログ保管や監視、バックアップも継続して発生します。さらに、RPA実行環境、セキュリティスキャン、問い合わせ対応の費用も見込みます。
- 再学習の予算:季節や商品構成の変化に備えて、月次・四半期の評価と、それに続く再学習や特徴量の見直しにかかる費用を見込みます。
- 追跡する指標:モデル精度、発注候補の採用率、却下理由、欠品率、在庫金額、作業時間を追います。
- 月額費用:データ量、推論回数、保守時間、障害対応時間、SLA、更新影響を比べます。
安いモデルへ変える場合も、予測精度や応答時間、監査ログの形式が変わらないかを確かめます。
見積もりを取る際のポイント
AI開発の見積もりを同じ条件で比べるには、要件を具体的にそろえておく必要があります。「AIで在庫を最適化したい」という段階では、各社の金額を比べる土台が足りません。
依頼する前に、対象業務と対象拠点、SKU数、データ期間、既存システムを整理します。AIが実行する操作や承認者、KPI、セキュリティ要件も書き出したうえで、複数社へ依頼します。
要件が曖昧な段階では、本開発の金額を求めるより先に、データ調査とPoCの見積もりを取る方法が適しています。
仕様書に盛り込むべき項目
仕様書には、入力データの項目とサンプル、更新時期、予測対象、発注ルール、制約条件を記載します。加えて、出力画面や外部操作、権限も含めます。承認や停止の方法も書き添えます。ログや評価方法も記載します。
さらに、欠品や返品、棚卸差異、商品廃番、急な販促、仕入先変更などの例外ケースを、あらかじめ書き出しておきます。AIが答えられない場合の「保留」や、担当者へエスカレーションする条件も、機能要件に含まれます。
開発会社の実績と体制
ベンダー選定では、生成AIのデモを見るだけでなく、在庫・調達・物流の知識を確認します。あわせて、ERPやWMSとの連携実績、データ基盤、セキュリティ、運用の引き継ぎも見ておきます。
- 事例を確認:対象期間、SKU数、比較基準、欠品率の定義を尋ねます。
- 実務担当者と話す:設計、データ、運用の責任者に質問します。
- 契約責任を整理:誤発注、復旧、漏えい、モデル変更、第三者停止、SLA、再委託を確認します。
損害賠償の上限や免責、検収、瑕疵対応、承認ログの扱いも決めておきます。必要に応じて、サイバー保険の対象範囲も確かめます。
段階契約によるPoC死と予算超過の防止
最初から全社分の請負契約を結ぶと、データの欠損や業務ルールの未整理が見つかったときに、開発を止めにくくなります。
- PoCを実施:準委任契約で調査し、成果指標を確かめたうえで開発に進みます。
- Goの条件:精度、データ更新、承認時間、上限遵守、現場受容性で判断します。
- No-Go後も活用:No-Goとなっても、データ辞書と業務分析は別の改善に生かします。
- 契約を分ける:要件定義・PoCは準委任、KPI達成を確認した後の本開発は請負とします。
機能ごとに本開発へ進む形にし、Goの判断には投資回収の見込みも含めるのが安全です。
導入後の運用改善とモデルドリフトへの対応
在庫管理AIは、リリースしたあとも継続して見直す必要があります。商品構成や販売チャネル、季節性、仕入先、倉庫能力が変わると、学習時と本番でデータの分布がずれるモデルドリフトが起こります。
月次でKPIを確認し、四半期ごとにモデルとルールを評価して、現場の却下理由や例外処理を改善に反映します。
精度・業務・財務のKPIの監視
精度のKPIには、予測誤差や欠品予兆の再現率、異常検知の適合率を置きます。業務のKPIでは、発注候補の採用率や担当者のレビュー時間、手動修正率、連携エラー率を見ます。
財務のKPIには、在庫金額や在庫回転率、廃棄額、欠品による機会損失を含めます。ただし、1つの数字だけを追うと、精度を上げるために在庫が増えるなど、部分最適が起きます。
再学習と業務ルール変更の担当者
モデルの再学習には、データサイエンティストだけでなく、業務側の確認も関わります。変更には、部門をまたぐ確認が必要です。
- 担当者を連携:商品マスタ、購買、物流、ITの担当者が変更影響を確かめます。
- 更新前に比較:バックテストと本番モデルを比べ、悪化した場合は旧モデルに戻します。
- ルール変更を承認:安全在庫、発注上限、承認者、仕入先の優先順位の変更は、責任者の確認を経て、履歴を残します。
経済産業省のAI事業者ガイドライン第1.2版は、2026年4月に公開されました。AIの開発・提供・利用のリスク管理に関する国内の参照資料です(出典: 経済産業省「AI事業者ガイドライン 第1.2版」、2026年)。
よくある質問(FAQ)
完全自動化の可否や必要なデータ、費用、誤発注への対策は、導入前に質問が集まりやすい論点です。
在庫管理のAIエージェントは完全自動発注できますか?
技術的には可能です。ただ、最初から全商品を完全自動化することはおすすめしません。まずは提案のみ、次に人の承認付きの発注、最後に低リスク商品だけの自動発注という段階を踏みます。
金額上限や数量上限、異常値検知、非常停止、監査ログを設けることで、誤発注の影響を限定できます。
開発前にどのようなデータを用意すればよいですか?
販売実績や在庫残高、入出荷の情報を用意します。発注残や商品マスタ、仕入先マスタも必要です。さらに、リードタイムや最低発注量、販促や季節イベントの情報も揃えます。
特に重要なのは、欠品中の販売数を需要ゼロとして扱わないことと、実在庫と理論在庫の差異を把握することです。データが不完全でもPoCは可能ですが、欠損や重複、コード不一致を一覧にして、クレンジングを見積もりに含めます。
在庫管理AIエージェントの開発期間はどれくらいですか?
限定したカテゴリのデータ調査と提案型PoCであれば、要件整理から検証まで数か月を目安にします。
複数拠点に広げ、ERP・WMS・POS連携まで扱うと、期間は延びます。承認画面やレガシーシステム、全自動発注まで含めると、半年から1年以上になる可能性があります。
データクレンジングだけで3〜6か月かかるケースもあるため、開発会社にはデータサンプルを渡し、連携難易度を確認してから正式な期間を決めます。
AIの誤発注が起きた場合の責任は誰が負いますか?
一律にベンダーだけ、または利用企業だけが負うとは限りません。
データの誤りやモデルの不具合、連携処理の障害、承認者の判断、仕入先の処理を原因ごとに分けて考えます。そのうえで、契約で責任分界や損害賠償の上限、SLA、ログの保存、停止手順を定めます。
高額な発注や例外ケースには、Human-in-the-Loopを置きます。誰が何を確認して実行したかを記録することが、実務上の重要な対策です。
まとめ
在庫管理AIエージェント開発で押さえる要点
在庫管理のAIエージェント開発では、AIに発注を任せること自体より、データや業務ルール、既存システム、人の承認を一つの運用として設計することが大切です。
- 小さく検証:対象を絞り、現状KPIを測って提案型PoCで効果とリスクを確かめます。
- 既存環境と連携:CSV、RPA、中継処理でレガシーシステムにも接続します。
- 安全策を備える:承認、停止、ロールバック、ログで誤発注と漏えいを抑えます。
- 費用を確認:開発費の幅を踏まえ、保守から3年間の運用費まで見積もります。
費用の目安は、PoCで300万〜800万円、中規模開発で800万〜2,500万円、大規模展開で2,500万円以上です。
データ品質や連携方式で変わるため、保守、再学習、監視、セキュリティを含めて、3年間の運用費を確認します。
次に行うべき準備
準備として、次の公式情報で自社の前提を確かめます。確認に使う資料は、MonotaRO Tech Blogの機械学習導入事例、SnykのToxicSkills調査、NIST AI Risk Management Frameworkです。
経済産業省のAI事業者ガイドライン第1.2版とAI利用時の民事責任ガイダンスもあわせて参照し、前提を確かめます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。