
検索システム導入の失敗は、データ品質、費用と要件、運用体制と権限設計の面に表れます。これらを押さえ、PoCの基準や出口まで設計しておけば、失敗は避けやすくなります。
▼全体ガイドの記事
・検索システムの完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
データ品質軽視で精度が出ない失敗
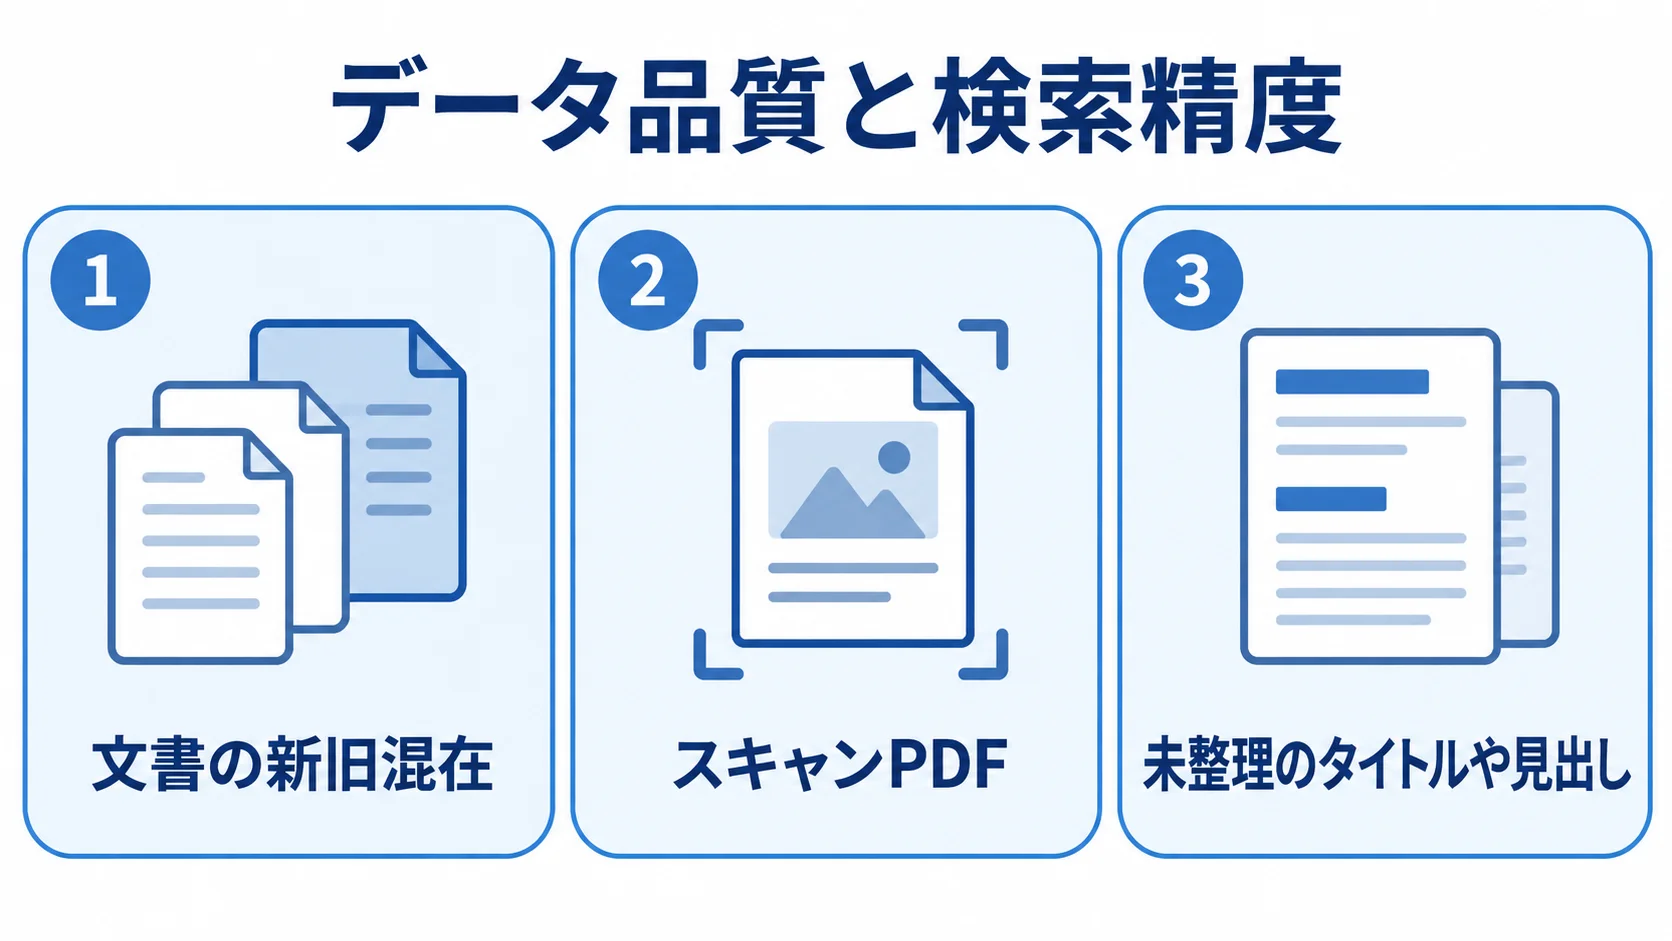
検索システムは、データ品質を軽視すると精度が出ず、利用されなくなることがあります。生成AIの性能が高くても、文書が古かったり、重複していたり、テキスト化されていなかったりすると、回答は的外れになります。
整備不足のデータが生む的外れな回答
RAG型AI検索は、検索で見つけた文書を根拠に回答を作ります。そのため、根拠文書の品質がそのまま回答の品質に直結します。
- 文書の新旧混在:古い版の情報をもとに回答することがあります。
- スキャンPDF:テキスト化されていないと、検索に出てきません。
- 未整理のタイトルや見出し:文脈をつかめず、別の文書を根拠にすることがあります。
こうした状態は「ゴミを入れればゴミが返る」の典型です。また、一次データでは、データ品質の不良が開発費を20〜30%押し上げる要因とされています。
データ整備を軽視すると、精度不足の失敗につながります。失敗したプロジェクトでは、整備より先にAI機能の構築を急ぎ、最後になってデータの汚さが問題になります。
発注側は、予算にAI構築費だけでなく、データ収集・クレンジング費も相応に含めておく必要があります。データ整備は一度で終わりません。文書は増減や更新が続き、組織やルールも変わるため、導入時に整えたデータも放置すれば古くなります。
失敗するプロジェクトは、初期整備で満足して、その後の更新運用を設計していません。そこで、誰がどの頻度で検索対象データを更新するかを決めておくことが、精度を保つ前提になります。鮮度が落ちると、検索システムは使われなくなります。
PoC死を招く長期化と検証基準の欠如
精度が出ない検索システムは、PoCが長引くうちに頓挫することがあります。合格基準に届かないまま検証を続け、利用されずに放置される状態を「PoC死」と呼びます。
- 3ヶ月以内のPoC成功率:65%です。
- 6ヶ月超のPoC成功率:15%まで下がります。
- 検証基準:合格基準に達しなければ撤退します。
一次データでは、PoCの長期化自体が失敗の予兆になるとされています。そのため、3ヶ月で結論を出す規律が必要です。
PoC死を避けるには、検証の合格基準を事前に数字で定めておくことが欠かせません。合格基準は、「上位50件の問い合わせに対し80%以上で適切に回答できること」のように、誰でも判定できる数値にします。基準がないと、主観で検証を延ばすことになり、コストがかさみます。
riplaは、フルスクラッチ受託の立場から、データ整備を土台に置き、3ヶ月という明確な基準でPoCを区切る進め方を重視しています。
多くの失敗は、技術そのものより、進行上の規律が足りないことから生まれます。
トークン課金が暴騰するコストの失敗
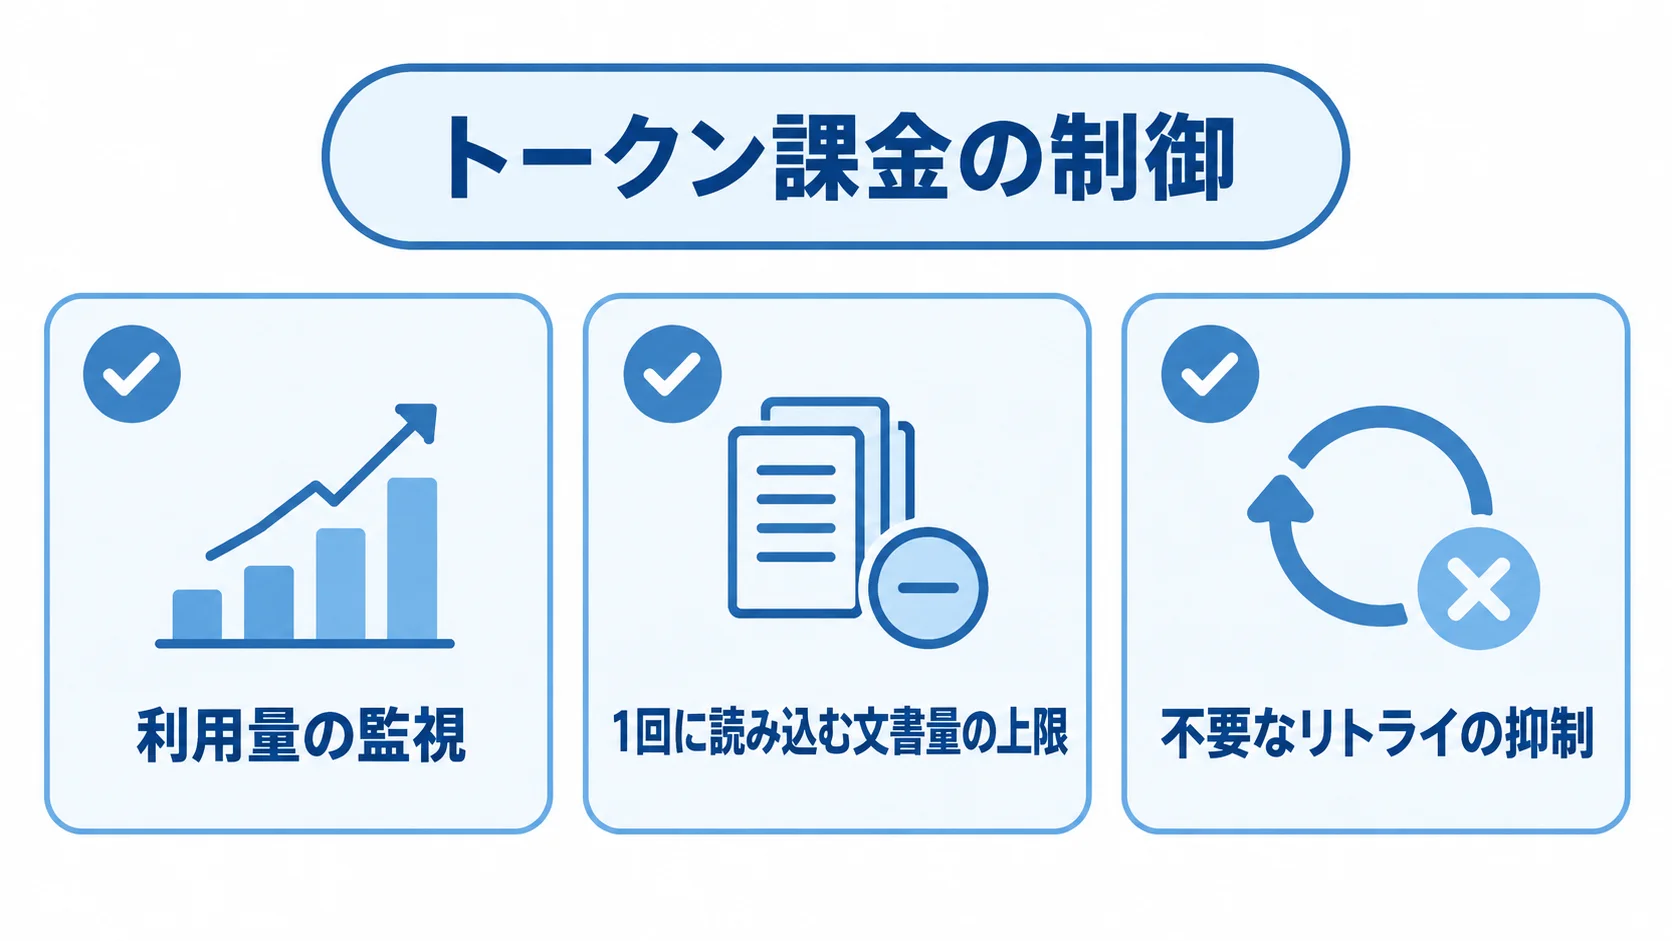
RAG型AI検索では、生成AIのトークン従量課金が想定を超えるリスクがあります。たとえば、月数万円の想定だったAPI利用料が、運用後に数十万円、数百万円へ膨らむと、費用対効果が崩れます。さらに、使うほど課金が増える仕組みを理解しないまま導入すると、予算管理が破綻します。
消費量が想定の5〜30倍に膨らむリスク
トークン課金が膨らむのは、1回の検索でどれだけ使うかを読みづらいためです。社内ナレッジへの1リクエストで、数千〜数万トークンを使う場合もあります。
- 複数回の処理:AIエージェントの処理で消費量が増えます。
- リトライ:想定の5〜30倍に膨らむケースがあります。
- 利用量の監視:ユーザー・部門別に把握し、上限超過時は制限します。
一見簡単な質問でも、AIが文書を何度も読み、回答を練り直すと、トークンは増えていきます。
設計段階で、1回に読み込む文書量に上限を設け、不要なリトライを抑えておきます。トークン制御を要件に含めるかどうかが、コストの失敗を避ける分かれ目です。また、無制限に使える状態では、月末に高額な請求が届くことがあります。
導入前に消費量を正確に予測するのは困難です。そのため、PoCで実測し、1リクエストあたりの平均量を把握しておきます。平均量に想定利用者数を掛ければ、月間コストの概算が見えます。
実測に基づいて運用費を見積もると、楽観的な試算による予算破綻を避けられます。
運用費を見落とすTCO見積の失敗
トークン課金以外も含めて、運用費全体を見落とす失敗があります。TCO(総保有コスト)のうち初期構築費は約20%で、残りの80%は運用・保守・教育にかかるとされ、「TCOの80%ルール」と呼ばれます。
- RAG型の運用費:API利用料・ベクトルデータベース・監視を含めて月30万〜130万円が目安です。
- オープンソースモデル:API利用料が月30万円を超える規模では、自社GPU運用が安くなる分岐点です。
- 切り替え計画:利用が拡大したときの運用方式の切り替え方法を、導入前に決めておきます。
初期費だけで判断すると、運用費を見落としてTCO見積が崩れます。
分岐点を越える規模では、Llama 3やMistralを自社GPU環境(月10万〜50万円)で運用するほうが安くなる場合があります。この分岐点を見落として従量課金を続けると、総コストが膨らみます。
予算を30〜40%超過する見積の失敗
検索システムに限らず、AIプロジェクト全般で、初期見積の甘さが予算超過を招きます。追加費用が重なって、当初予算に収まらない事態も頻発しています。
一次データでは、企業の85%がコストを10%以上見誤り、初年度に予算を30〜40%超過するとされています。
要件不明確による開発費の30〜50%増加
予算超過の大きな原因は、要件が曖昧なまま開発を始めることです。一次データでは、要件が不明確だと、開発費が30〜50%増加するとされています。
- 要件定義:開発前に時間をかけ、対象データ・利用者・成果指標・権限を固めることです。
- 予算バッファ:追加要望を想定し、見積に30〜40%を織り込みます。
- 発注先の選定:要件を一緒に詰める相手を選ぶことが大切です。
「とりあえずAI検索を作りたい」という曖昧な状態で発注すると、開発中に機能や対象文書が増え、見積額を超えることがあります。また、データ品質が悪い場合は、開発費にさらに20〜30%が上乗せされます。
安い見積に飛びついても、要件が曖昧なままなら、追加費用で結局高くつきます。そのため、安さだけで選ばず、要件をともに詰められる発注先を選ぶことが、予算超過の回避につながります。
過大なROI見積で期待が裏切られる失敗
効果を過大に見積もると、期待が裏切られることがあります。業務効率化を楽観的に予測した結果、実際の削減効果が一部にとどまり、投資回収の見込みが崩れる場合があります。
- 削減時間の充当率:50%だけを効果に計上します。
- 実質人件費:給与の1.5〜2倍で計算した額です。
- 投資判断:楽観だけで稟議を通さず、保守的な試算で採算を示します。
MITの調査では、AIプロジェクトの95%が期待した成果に届かないとされています。効果の算定では、一次データが示す「充当率50%ルール」を参考にできます。
内製化の失敗とベンダーロックインのリスク
検索システムでは、導入後に運用体制の失敗が表面化します。運用しながら育てていくものなので、体制が整わないと活用されません。
内製化を急ぎすぎる場合と、外注に依存してベンダーロックインに陥る場合の両方に注意が必要です。
運用体制が整わず放置される失敗
検索システムは、データを更新し、辞書を調整し、精度を監視し続けることで価値を保ちます。ただし、導入時に担当者を決めないまま構築を進めると、そのあと手が回らなくなるプロジェクトもあります。
- 運用の放置:データが古び、調整されず、精度が落ちて利用されなくなります。
- 利用率の確認:導入後6ヶ月で70%を切る場合、体制見直しのサインです。
- 段階的な内製化:外部の支援を受け、担当者を育てながら移行します。
一方で、運用をすべて内製化しようと急ぐことも、失敗のもとになります。専門人材がいないまま全てを内製化すると、トラブルに対応できず、システムが不安定になることがあります。導入計画に運用体制を含めておくことが、放置を防ぐ前提になります。
最初は外注先の支援を受けて運用し、現場の担当者を少しずつ「パワーユーザー」に育てます。そのうえで、内製化の比率を段階的に高めていく進め方が堅実です。
ベンダーロックインを避ける設計の注意点
外注に依存しすぎると、ベンダーロックインのリスクが生じます。独自仕様でシステムを作ると、乗り換え時にデータやロジックの移行が難しくなり、保守費を払い続けることがあります。
- データの所有権:自社に確保しておく必要があります。
- モデルの切り替え:別モデルへ差し替えられる構造にします。
- 出口の自由:ベンダー固有の仕組みに依存せず、データやロジックを移行できる設計であることが大切です。
生成AIは技術の進化が速いため、モデルやサービスを固定しすぎると、より良い選択肢が出ても切り替えられず、機会を失います。そこで、API利用時も別モデルに差し替えられる構造にしておけば、価格や性能の変化に柔軟に対応できます。
riplaは、フルスクラッチ受託と国内開発の立場から、データとロジックの所有権を発注企業に残し、モデルやインフラを段階的に切り替えられる設計を重視しています。導入時の選択が将来の自由度を狭めないよう、出口まで考えておきます。
権限設計の甘さとハルシネーションのリスク
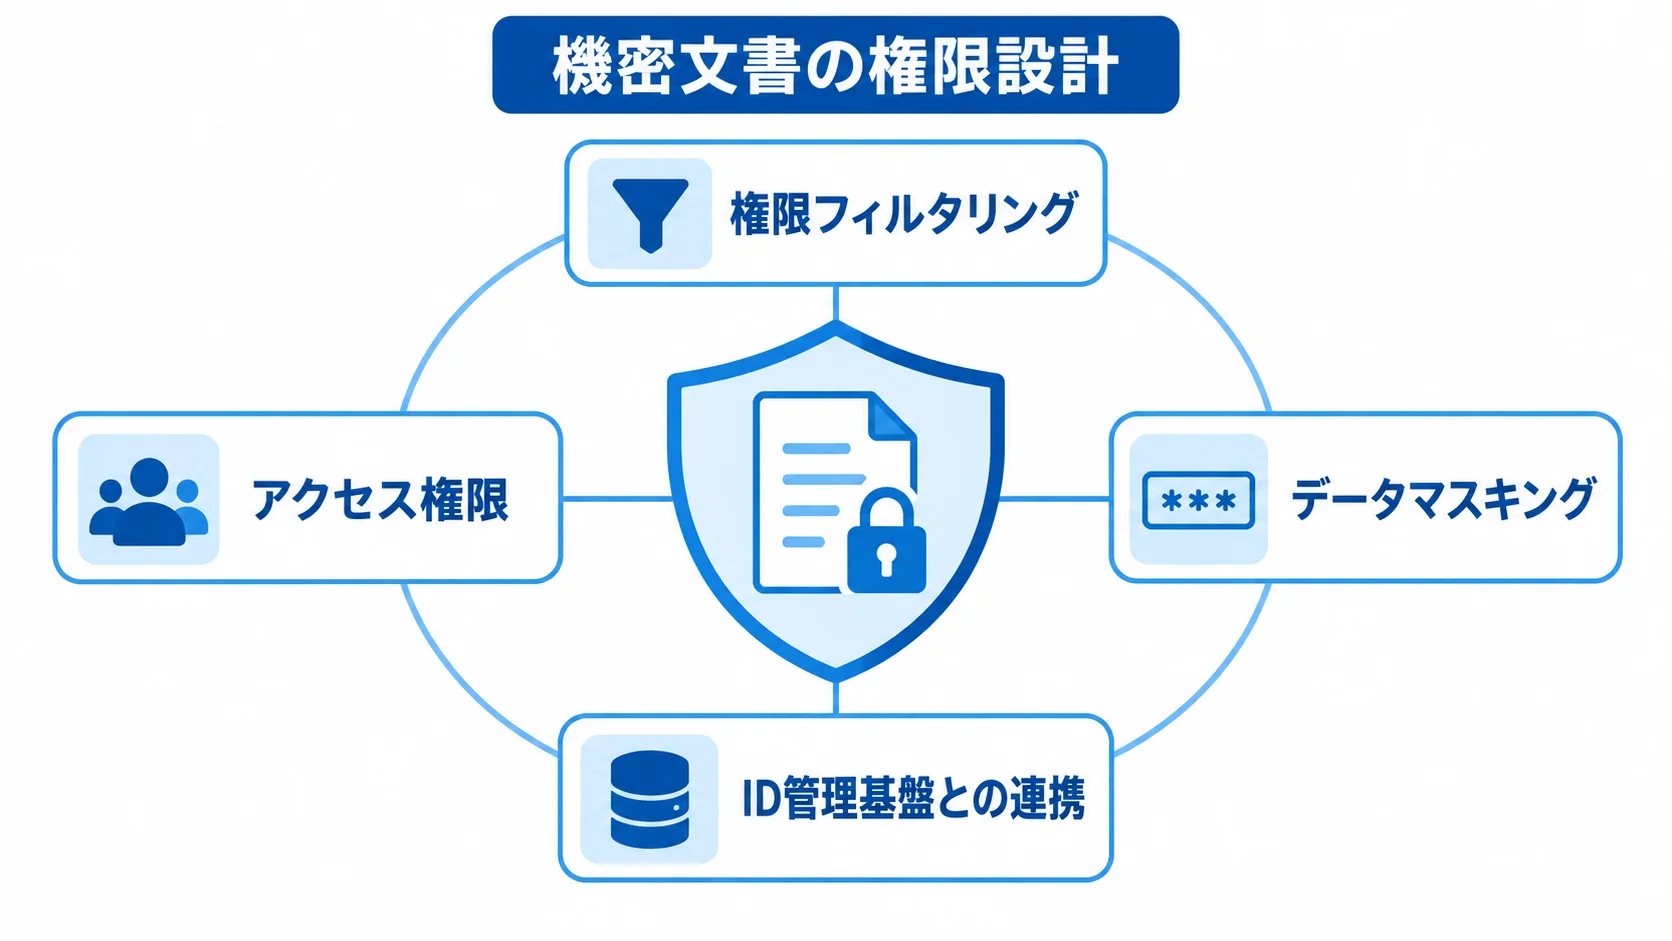
コストや精度と並んで、セキュリティと回答の信頼性も軽視できません。社内AI検索は機密文書を扱うため、権限設計が甘いと情報漏えいにつながります。
また、生成AIの誤回答を信じると業務に支障が出ます。便利さの裏にあるリスクは、導入前に把握しておく必要があります。
権限設計の甘さが情報漏えいを招く失敗
社内AI検索でもっとも怖い失敗は、権限設計の甘さによる情報漏えいです。権限を考慮せず全文書を対象にすると、人事情報や経営機密が誰でも検索できる状態になります。
本来は特定の役職・部門だけが閲覧できる情報も、そのままでは検索対象に含まれてしまいます。
- 権限フィルタリング:権限外の文書を検索・回答から除外します。
- アクセス権限:役職・部門ごとに設定します。
- データマスキング:個人情報を伏せます。
- ID管理基盤との連携:既存の基盤と接続します。
RAG型では、権限外の文書を根拠に回答を生成すると、検索結果に表示されなくても回答内容から機密が漏れることがあります。そのため、検索入口でのフィルタリングが欠かせません。
これらは後から付け足しにくい根幹の仕組みです。導入後に権限を考慮していなかったと判明すると手遅れになりやすいため、要件定義の段階で詰めておく必要があります。便利さを優先して権限を後回しにする判断は、最も危険です。
誤った回答を鵜呑みにするリスク
RAG型検索では、生成AIがもっともらしい誤回答を返すことがあります。根拠文書がなくても文章を作ってしまう場合もあり、業務判断に使うと重大なミスにつながります。
- 根拠文書の提示:利用者が回答内容を確認できるようにします。
- 利用者教育:回答を鵜呑みにせず、根拠を確認するルールを浸透させます。
- 権限と出典:ガバナンスと回答の信頼性を支える設計にします。
法務・経理・安全に関わる領域では、誤回答の影響は計り知れません。根拠となった文書を出典として示せば、利用者は内容を検証でき、誤りを信じるリスクを抑えられます。
riplaは、フルスクラッチ受託と国内開発の立場から、権限フィルタリングと出典提示を組み込む設計を重視しています。
検索システムでは、コストや精度に加え、セキュリティと回答の信頼性にも注意が必要です。
まとめ
検索システム導入の失敗は、データ品質とトークン課金の問題、要件の不明確さによる予算超過、運用体制とロックインの問題に集約されます。いずれも、技術だけでなく、進め方と設計に関わる問題です。
データ整備を土台に、トークン消費を制御し、要件・運用体制・出口を設計しておけば、失敗を避けやすくなります。AIプロジェクトの95%が成果に届かないという現実もあるため、導入前の備えが欠かせません。
PoCは3ヶ月で区切って撤退基準を設け、見積には30〜40%のバッファを持たせておきます。効果は充当率50%、実質人件費は給与の1.5〜2倍という前提で、保守的に試算します。
これらは特別な技術ではなく、実践できる備えです。riplaは、フルスクラッチ受託と国内開発を組み合わせ、データ整備とトークン制御に加え、要件整理や運用体制の設計まで支援しています。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼全体ガイドの記事
・検索システムの完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。