
生成AIシステムの必要機能は、インデックス化、検索・回答生成、精度評価、業務自動化の4つに大別できます。これらを組み合わせると、社内データに基づく回答や業務処理を実現できます。
各機能の役割を押さえないと、デモは動いても本番では使えないことがあります。各テーマの詳細は関連記事もご覧ください。
▼全体ガイドの記事
・生成AIシステム開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
生成AIシステムを支えるRAGパイプラインの全体機能
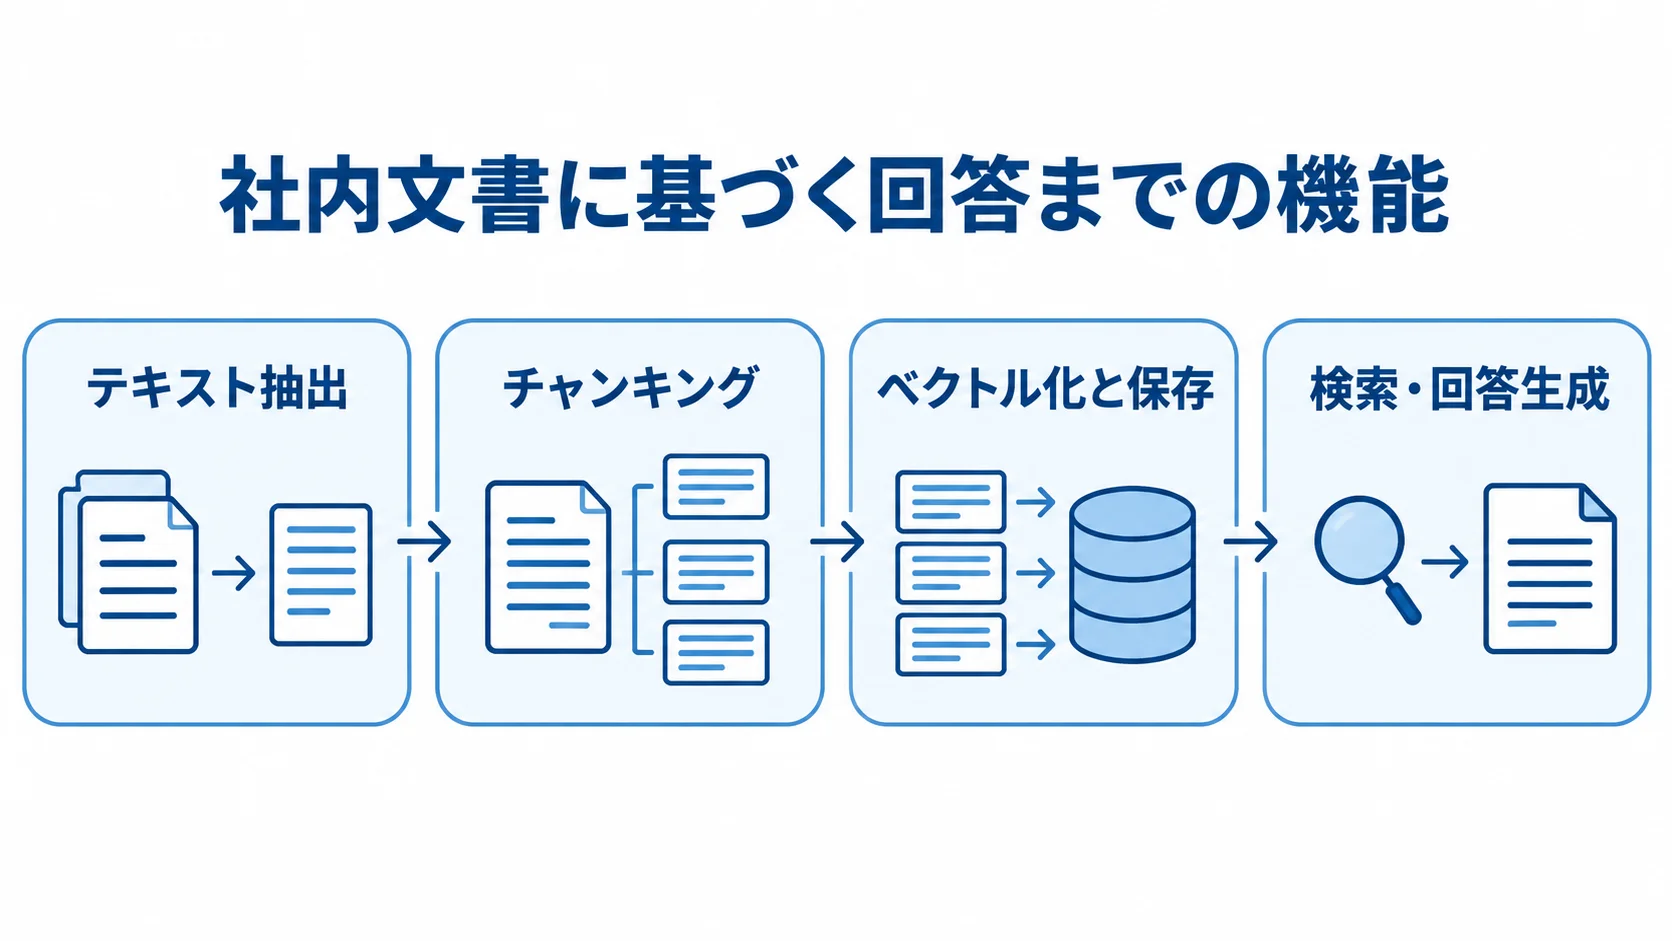
社内データを使うRAG型システムの機能は、データを検索できる形にするインデックス化と、質問に答える検索・回答生成に大きく分かれます。両者は一連のパイプラインとして連動し、社内文書に基づく正確な回答につなげます。構成要素の役割を理解しておくと、必要な機能を過不足なく見極められます。
インデックス化(データ取り込み・ベクトル化)機能
インデックス化は、社内文書を生成AIが検索できる形に変換する機能群です。開発会社は、ファイル形式や保存先に応じて、次の処理を組み合わせます。
- テキスト抽出:PDF、Word、Excelなどから文字情報を取り出す工程。
- チャンキング:抽出した文章を、検索しやすい単位に分ける処理。
- ベクトル化と保存:文章を数値の列に変換し、ベクトルデータベースに格納する。
ベクトルデータベースには、Pinecone、pgvector、Weaviateなどが使われています。検索の品質はインデックス化の丁寧さに左右されるため、システムの中でも欠かせない機能の一つです。
ベクトルデータベースを選ぶときは、扱うデータ量、検索速度、既存システムとの相性を確認します。たとえば、PostgreSQLを運用している組織では、拡張機能のpgvectorで運用の負担を抑えられます。
大規模なデータと高速な検索を求める場合は、専用設計のPineconeやWeaviateが候補になります。さらに、データ量の増加に伴うスケーリング費用も踏まえ、将来の規模を見据えて選びます。
検索・回答生成機能
検索・回答生成は、質問への回答を社内情報に基づいて作る機能です。回答の品質は、検索の精度に直接左右されます。
- 関連情報を検索:質問に近い情報を探し、回答の根拠として使う。
- 検索精度を高める:誤った文書は高性能なモデルでも誤回答につながるため、検索アルゴリズムやリランキングが必要です。
- 企業向けモデルを利用:Azure OpenAI ServiceやAWS Bedrock経由で、大規模言語モデルを使えます。
- 出典を明示:回答の忠実性を保つため、参照文書を示す仕組みは業務利用の標準的な要件です。
Azure OpenAI ServiceやAWS Bedrock経由のモデル利用は、企業向けのセキュリティやデータ取り扱いの要件を満たしやすいため、機密情報を扱う基盤に採用されるケースが増えています。
精度を最大化するチャンキングと検索アルゴリズム
チャンキングは文書を分ける単位を決め、検索アルゴリズムは関連情報の探し方を決めます。同じデータとモデルを使っても、この2つの設計しだいで回答の精度は変わります。実証データもあわせて、それぞれの選び方を見ていきます。
チャンキング(文書分割)の最適化機能
チャンキングは、長い文書を検索しやすい大きさの塊(チャンク)に分割する処理です。分割の単位は、文書の構造に合わせて決めます。
- 規程文書:条文ごとに分けます。
- マニュアル:手順のまとまりごとに区切ります。
チャンクが大きすぎると無関係な情報が混ざり、小さすぎると文脈が断片化します。実際に、東京ガスの事例でも、精度改善の主要な施策としてチャンキングを見直しました。
分け方には、固定文字数で区切る方式のほか、見出しや段落など意味上の区切りに沿う方式があります。加えて、隣接するチャンクの一部を重複させ、文脈のつながりを保つ方法もあります。
開発では、データの性質に応じて方式を選びます。目立たない設計ですが、回答精度を大きく左右するため、生成AIシステム開発で特に多くの工数を投じるべき領域の一つです。
ハイブリッド検索機能(精度+52%の実証)
ハイブリッド検索は、キーワード検索とベクトル検索を組み合わせ、業務データの検索精度を高める方式です。
- 検索の特徴:キーワード検索は固有名詞や型番の完全一致、ベクトル検索は言い換えや概念の近さに強みがあります。
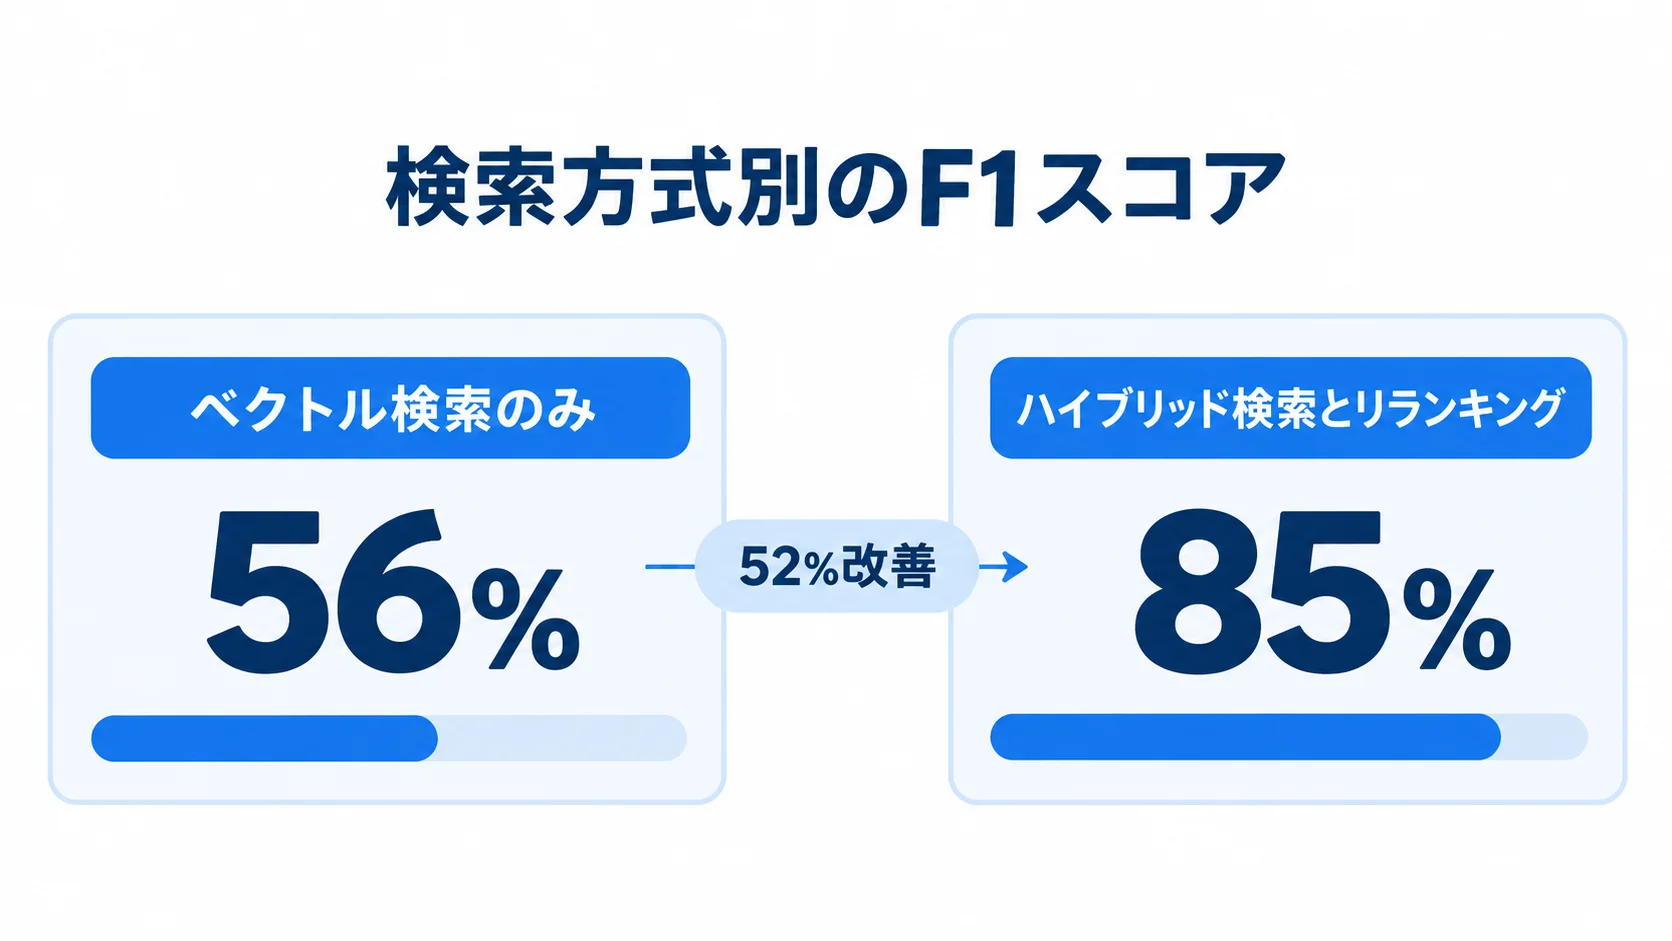
- 実証結果:F1スコア(検索の正確さを示す指標)は、ベクトル検索のみで56%、ハイブリッド検索とリランキングで85%。52%改善しました。
- 業務での活用:製品名、社内用語、略語の取りこぼしを防ぎ、実用に耐える精度を確保しやすくします。
- 導入事例:東京ガスの事例では、ハイブリッド検索が実用化の決め手となりました。
実証結果を踏まえ、生成AIシステム開発では、ハイブリッド検索を必須機能として位置づけるべきです。
回答品質を高めるリランキングと評価機能
リランキングは検索候補から関連性の高い情報を選び直し、評価機能は精度を数値で測ります。どちらも運用しながら精度を高める段階で役立ち、システムを実用レベルに引き上げるうえで欠かせません。
リランカー(再評価)機能の役割
リランキングは、検索候補を質問との関連性に応じて並べ替え、回答に使う情報を整える機能です。
- Top-Kの調整:取得件数を増やすと関連性の低い情報も混ざり、ノイズが増えることがあります。
- 関連性による順位付け:Cohere RerankやCross-Encoderで候補を評価し直し、関連性の高い順に並べます。
- 品質の向上:情報の取りこぼしとノイズを抑え、回答の質が下がるのを防ぎます。先述のハイブリッド検索と併用した実証では、F1スコアが85%に達しました。
検索の段階では幅広く候補を集め、モデルに渡す段階で関連性の高い情報に絞る、という二段構えが可能です。特に、回答の正確さを業務で使える水準まで高めるには、リランキングを標準機能として組み込むことが推奨されます。
評価フレームワークで精度を測る機能
精度を継続して高めるには、回答の品質を数値で測る評価機能が欠かせません。RagasやDeepEvalといった評価フレームワークを使うと、次の指標を算出できます。
- Context Precision(検索精度):検索で適切な情報を取得できているかを測ります。
- Faithfulness(忠実性):回答が参照文書に忠実であるかを示す指標です。
指標を使えば、精度が足りない原因が検索側にあるのか生成側にあるのかを切り分けられます。逆に、評価をせずに改善を進めると、高性能なモデルに変えれば解決すると誤認しがちです。
実際には検索の精度が原因であることも多く、その場合はモデルを変えても解決しません。評価で原因を数値で特定できれば、チャンキングの見直しやハイブリッド検索の導入に工数を集中できます。
評価機能は、精度を改善し続けるための基礎になります。このため、生成AIシステムの標準機能に含めるべき要素です。
ワークフロー制御とAIエージェント機能
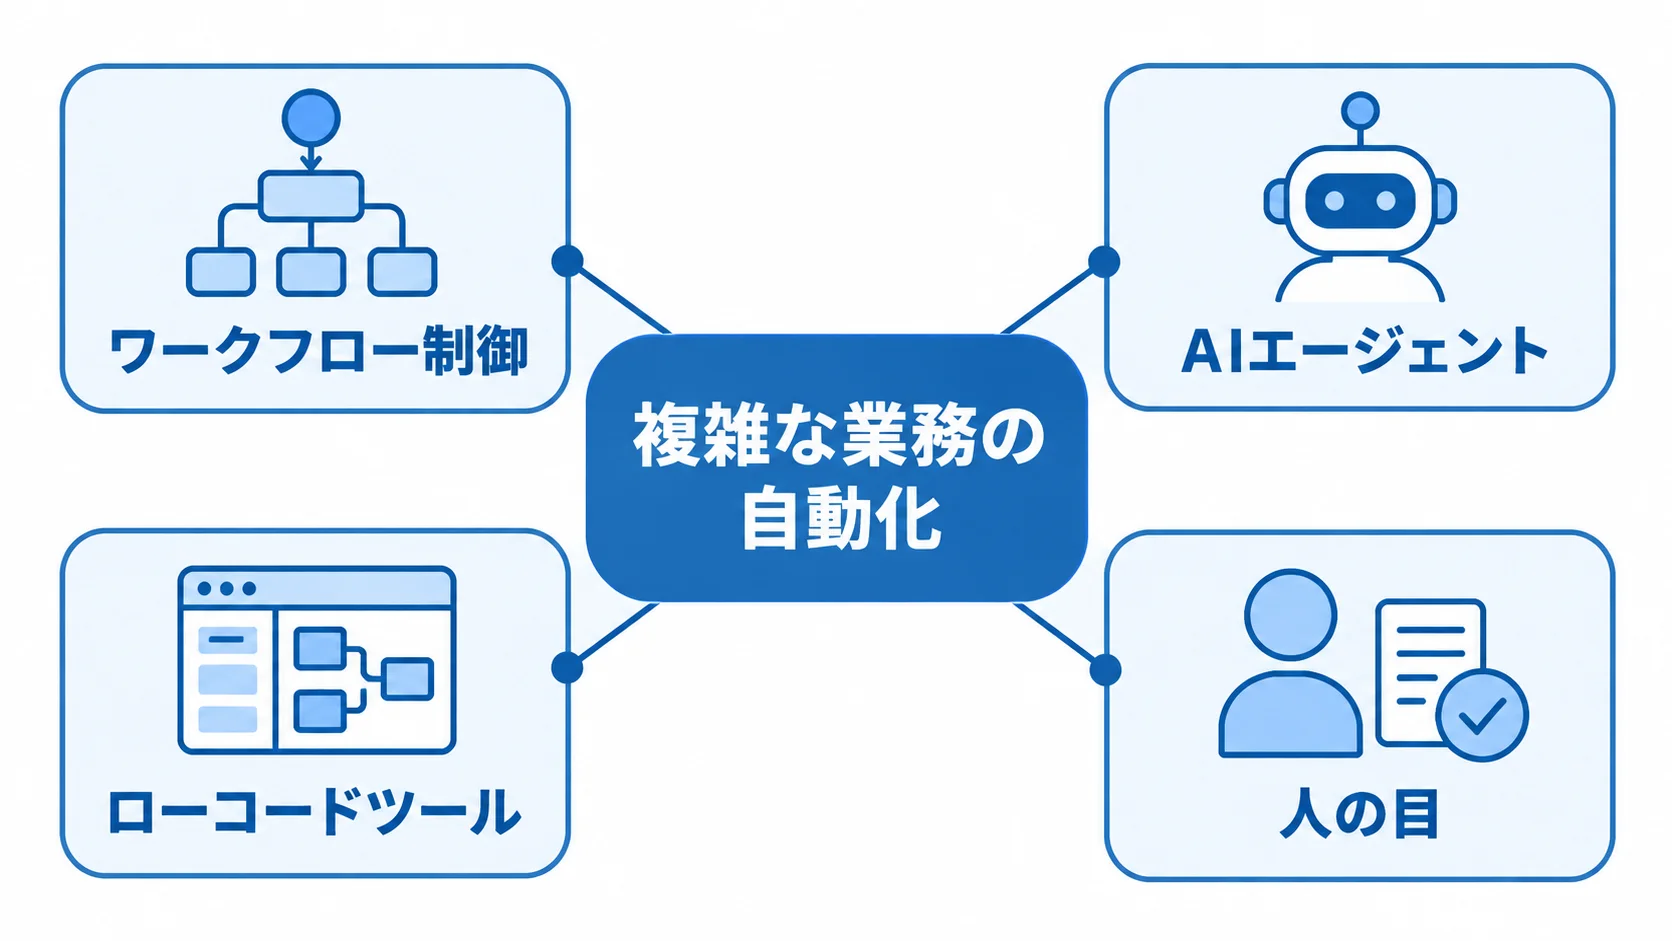
近年の生成AIシステムには、複数の処理を順に実行するワークフロー制御や、自律的にタスクを進めるAIエージェントがあります。どちらも複雑な業務の自動化に関わる機能です。また、ローコードツールの普及により、実装のハードルも下がっています。
ローコードによるワークフロー設計機能
ワークフロー制御は、入力に応じて処理を分けたり、複数の処理をつなげたりする機能です。Difyでは、次の5つの主要ノードを組み合わせます。
- 開始ノード
- LLMノード
- IF/ELSEノード
- コードノード
- 終了ノード
ノードを組み合わせると、質問の種類によって回答方法を切り替えたり、外部システムから取得したデータを回答に反映したりできます。プログラミングの専門知識が多くなくても、画面上で視覚的に設計できます。
ローコードツールは開発期間を短くでき、現場の要望に合わせた調整も行えます。ただし、検索精度の設計やデータ整備は引き続き必要です。
ローコードのツールがあっても、業務に合った処理の組み立ては人が決める必要があります。ワークフロー設計機能は、設計した処理を効率よく実装する手段として捉えておきます。
AIエージェントによる自律タスク実行機能
AIエージェントは、目標に応じて手順を判断し、外部システムと連携してタスクを進める機能です。
- 自律的な処理:APIで情報を取得し、その内容から判断して次の処理へ進みます。
- 導入事例:札幌市の旅費事務AIエージェントは規程を参照し、確認作業の処理時間を27.2%短縮しました。
- 権限と確認の設計:自律性を高めると効率と誤判断のリスクがともに増えるため、重要な処理には人の目を入れる段階を設けます。
業務自動化の効果と安全性を両立させる設計が、エージェント機能を活用するための条件です。
まとめ
生成AIシステム開発に必要な機能は、RAGパイプラインの構成に沿って整理しました。まず取り上げたのは、データを検索できる形にするインデックス化と、質問に答える検索・回答生成です。精度を高める機能としては、チャンキングと検索アルゴリズムに加えて、リランキングと評価を扱いました。さらに、ワークフロー制御とAIエージェントも取り上げました。
実証では、ハイブリッド検索とリランキングを組み合わせることで、F1スコアが56%から85%に上がり、52%改善しました。この結果は、両機能の重要性を示しています。
機能を選ぶ際は、流行のモデルよりも、社内データの性質に合ったチャンキングと検索の設計が重要です。さらに、評価機能で精度を数値で把握し、改善できる構成に整えます。
必要な機能を過不足なく組み込み、運用しながら改善する前提で設計することが、業務で使えるシステムへの近道です。
自社に合う構成は、データの特性と業務の要件を踏まえて検討するとよいでしょう。そのうえで、信頼できる開発パートナーに相談することをお勧めします。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。