
生成AIシステムの失敗は、参照データの品質不足、セキュリティ上の脅威、精度評価の不足から起きやすくなります。データ整備、セキュリティ管理、精度評価を進め、運用後も改善を続けることで、失敗は避けられます。
全体像は生成AIシステム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・生成AIシステム開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
最も多い失敗原因「データ品質」の構造的理解
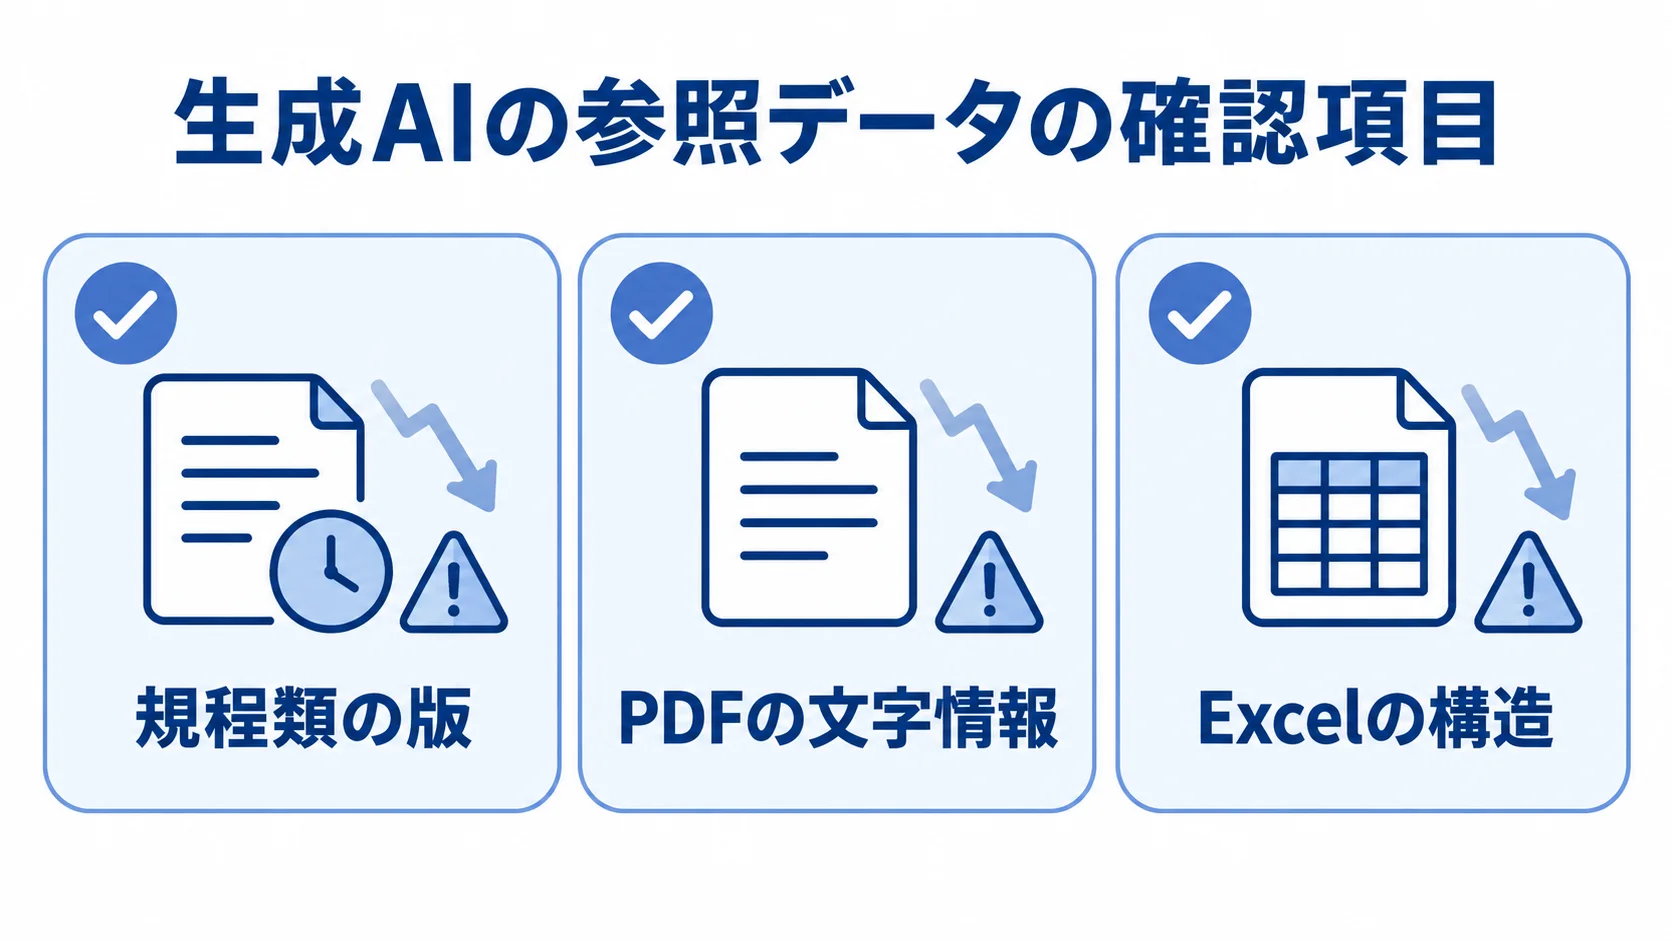
生成AI、特にRAG型のシステムでは、参照データの品質低下が主な失敗原因になります。データが古い、不正確、未整理のままだと、モデルの性能が高くても正確な回答はできません。この構造を理解することが、失敗を避ける出発点です。
調査データが示す失敗の実態
生成AIプロジェクトの失敗率の高さは、複数の調査で裏付けられています。
- AIプロジェクトの失敗予測:Gartnerは、2026年までに60%がデータ不足で失敗すると予測しています。
- RAG事例の成功率:Canon ITソリューションズが分析した228件のうち、成功と評価されたのは33%でした。
- 失敗原因の内訳:回答品質が46%、データ連携の課題が42%でした。
これらの数字は、失敗の大半がモデル自体ではなく、データに関わる部分で起きていることを示しています。
この実態を踏まえずに精度不足を理由として高性能なモデルへ替えても、費用が増えるだけで、問題は解決しないままです。まず、データの品質と連携の設計を確認することが先決です。
データ品質起因の失敗を防ぐ対策
開発前に、データを洗い出して一覧にし、誤りを直す作業(クレンジング)を徹底します。AIが正しく解釈できるよう、ファイルの種類ごとに状態を点検します。
- 規程類の版:古い規程と現行版が混在していないか。
- PDFの文字情報:スキャン画像だけで、文字を読み取れないPDFの有無。
- Excelの構造:表とテキストが入り組み、AIが中身の関係を把握しにくい状態になっていないか。
東京ガスの事例では、初期の精度がほぼゼロでも、データの扱いと検索手法を改善することで実用化に至りました。また、工数の40〜60%をデータ準備に充てるべきとする原則もあります。
地道なデータ整備は、失敗と成功を分ける最大の分岐点です。整備を軽視すると、時間や費用をかけても精度の壁を越えられず、失敗を避けるうえで最も重要な対策を欠くことになります。
現場で起こりがちな具体的な失敗シナリオ
データ品質に起因する失敗は、現場では具体的な形で表れます。たとえば、古い規程を誤って参照することや、PDFの読み込み漏れが挙げられます。
- 古い規程を参照:旧版と新版が残ったままで、廃止済みのルールを根拠に回答してしまいます。
- PDFを読み取れない:画像として保存されていて本文を抽出できず、AIが内容を読めない事態も頻繁に起こります。
こうした失敗は、整ったデモデータでは表に出にくく、多様な実データを使う本番で初めて明らかになることがあります。これがPoCの壁の正体ともいえます。
これらの原因はモデルの性能ではなく、データの状態にあります。そのため、整えたサンプルだけでなく、PoCの段階から本番に近い実データで検証し、想定外のデータを把握することが防御策になります。
セキュリティリスクとデータポイズニングの脅威
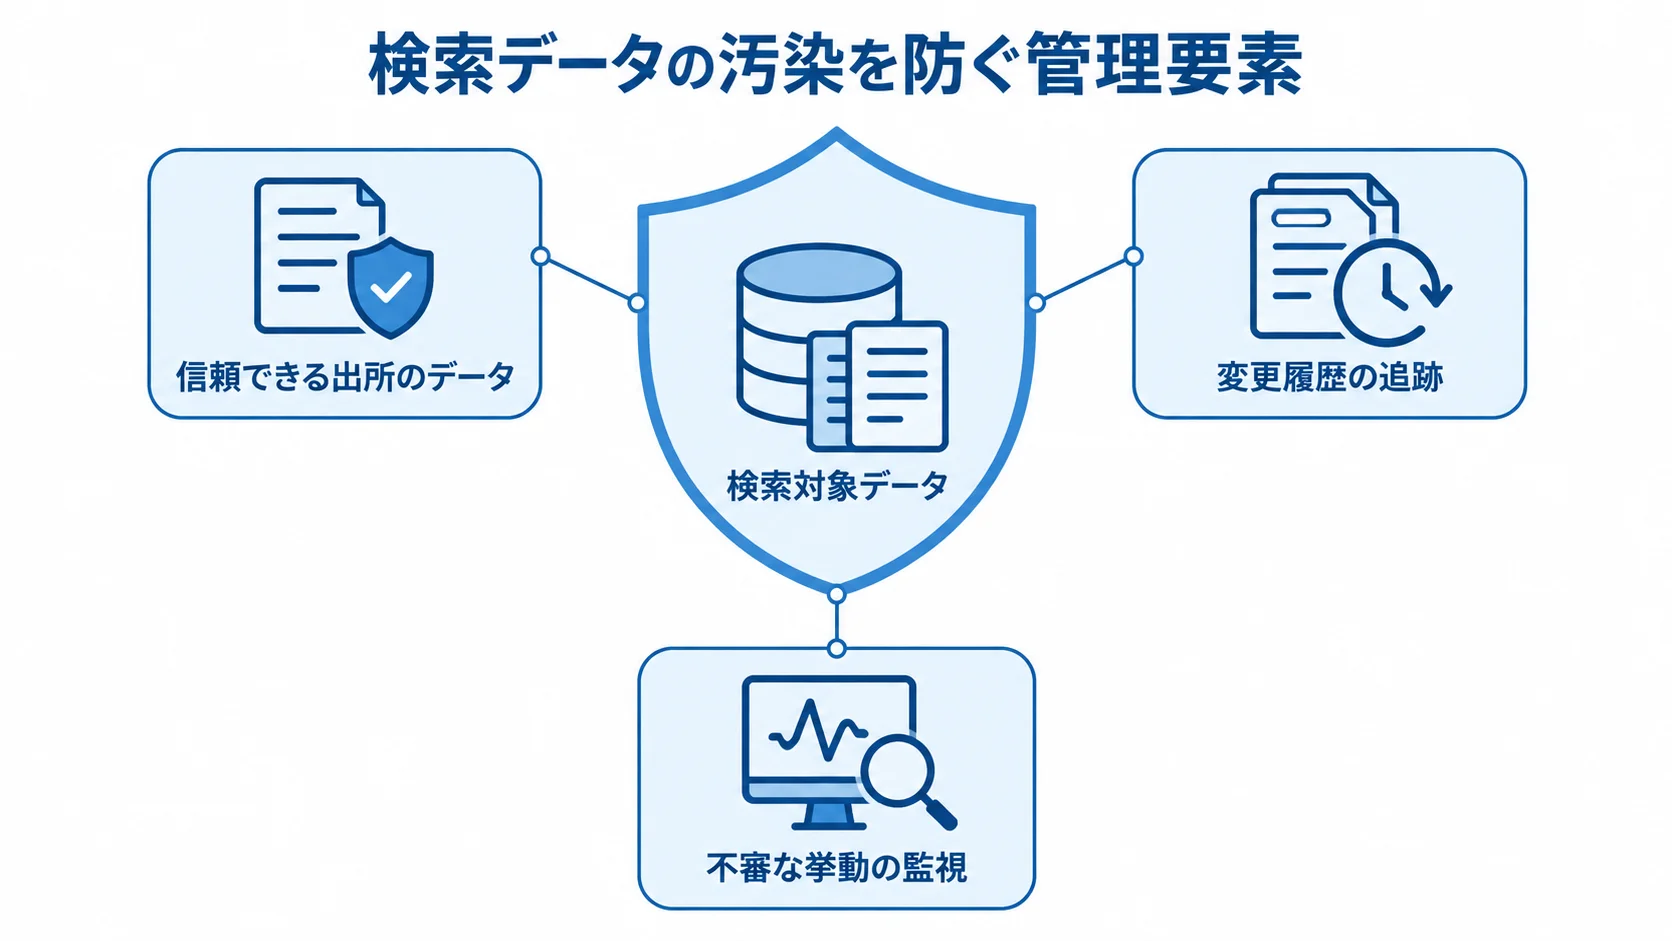
生成AIシステムには特有のセキュリティ脅威があり、見過ごせません。機密情報を扱うため、情報漏洩やデータ汚染が深刻な影響を及ぼすおそれがあります。主なリスクは、参照データの汚染、情報漏洩、ハルシネーション、著作権で、それぞれに対策が必要です。
BadRAG攻撃が示すデータ汚染の危険性
BadRAG研究の数値は、検索対象データのわずかな汚染でも攻撃が成立する深刻さを示しています。
- 汚染データの割合:検索対象データの0.04%にあたります。
- 攻撃成功率:プロンプトインジェクションを用いた場合に98.2%に達しました。
ごく一部の悪意あるデータでも、システムが誤った回答や有害な回答を生成するよう仕向けられるおそれがあります。特に、社外のデータや多くの人が編集できる文書を参照元にする場合は、警戒が必要です。
対策としては、データの取り込み経路を管理して信頼できる出所のデータを使い、変更履歴を追跡します。あわせて、不審な挙動を検知する監視体制も整えます。データは量だけでなく、一つひとつの信頼性を確かめることが欠かせません。
社外サイトや自由投稿の文書を参照すると、汚染データが入る経路が増えます。そのため、さらに慎重な管理が求められます。具体的には、誰がいつ追加・編集したかを記録し、想定外の内容がないか定期的に点検します。
セキュリティを軽視すると、利便性と引き換えに重大なリスクを抱えることになります。対策は構築時だけでなく、運用を通じて継続して維持する必要があります。
情報漏洩・ハルシネーション・著作権リスク
生成AIには、データ汚染以外にも仕組みに伴う主なリスクがあります。
- 情報漏洩:入力した機密情報が外部に流出したり、モデルの学習に再利用されたりすることが懸念されます。
- ハルシネーション:事実に基づかない情報を、もっともらしく生成してしまう問題です。
- 著作権:生成物が既存の著作物を侵害するおそれがあります。
これらのリスクは、ゼロにすることはできません。そのため、情報漏洩には学習利用に関する契約や設定を確かめ、アクセス権限を制御して対応します。
ハルシネーションには、出典を明示する仕組みと人による最終確認を設けます。著作権については、生成物の利用範囲を定める社内ガイドラインが有効です。
リスクを認識して仕組みで管理すれば、導入を妨げる致命的な障害にはなりません。適切な対策こそが、安全に活用するための条件です。
失敗を定量的に切り分ける精度評価の手法
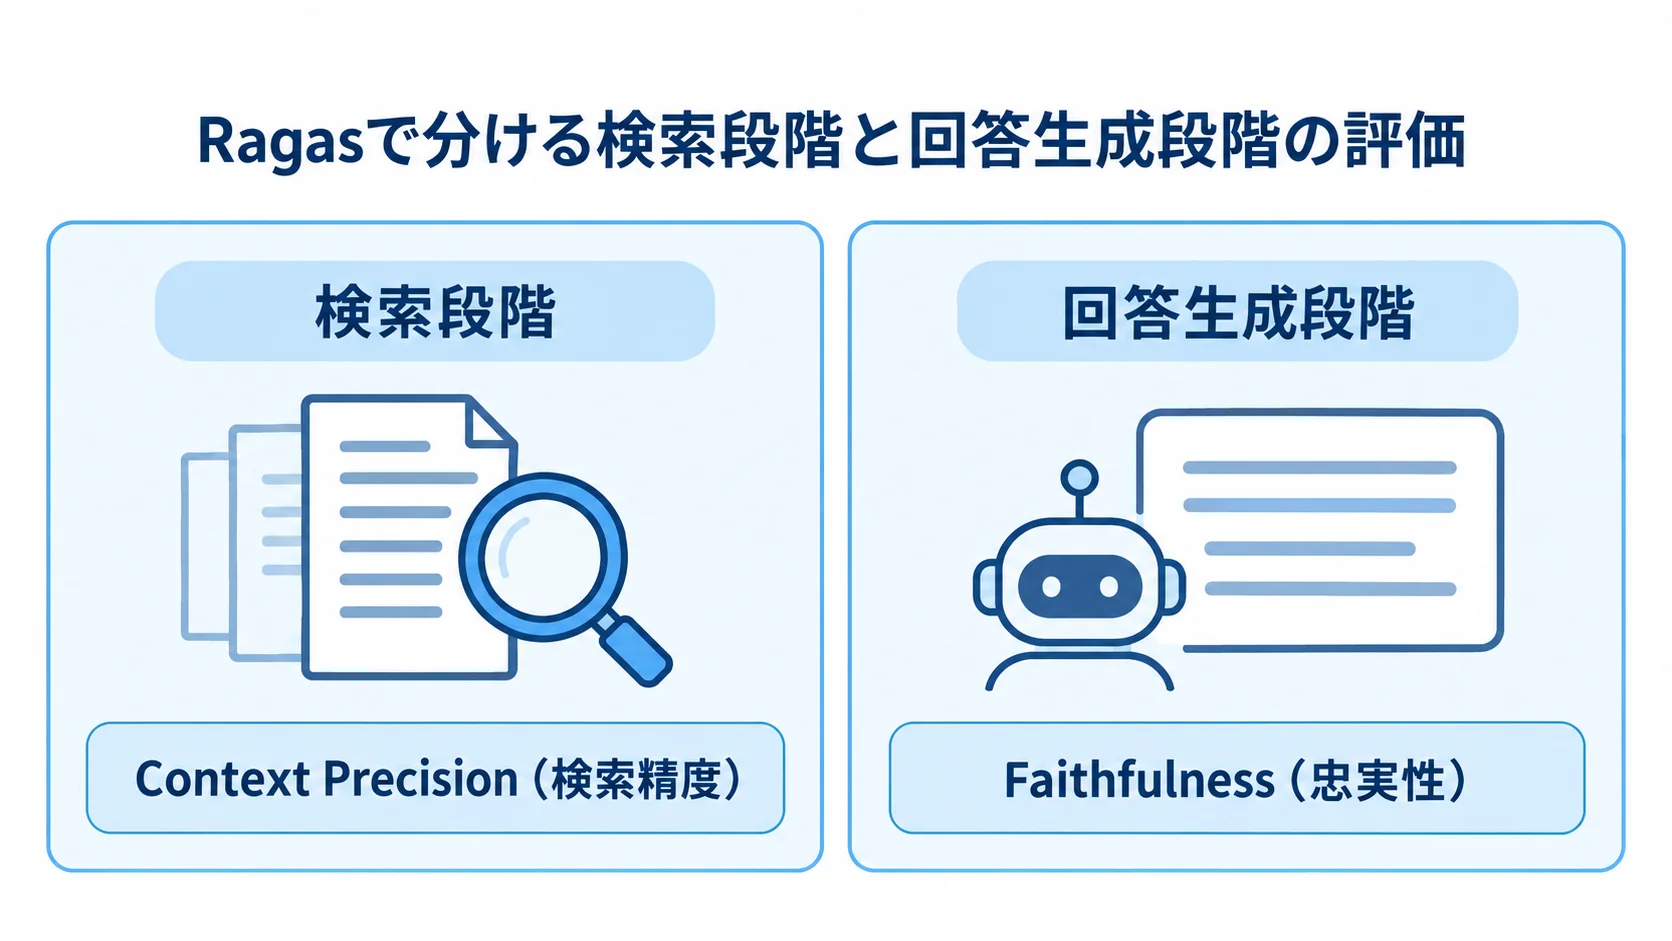
精度が出ない原因を勘や印象だけで探しても、解決しないことがあります。失敗を克服するには、問題の箇所を定量的に切り分ける評価手法が欠かせません。
Ragasによる原因の定量的な切り分け
Ragasの評価フレームワークは、精度低下の原因を切り分けるのに有効です。検索段階と回答生成段階を見分けるために、2つの指標を使います。
- Context Precision(検索精度):検索段階で、適切な情報を取得できているかを測る指標。
- Faithfulness(忠実性):回答が参照文書に忠実かどうかを測る指標です。
多くの失敗プロジェクトは、原因を特定しないまま大規模言語モデルを高性能なものに替えようとします。一方で、評価によって改善箇所を絞れば、闇雲な変更を避けられます。
調査では、失敗原因の46%が回答品質、42%がデータ連携に起因していて、多くは検索側の問題です。原因を測れば、チャンキングの見直しやハイブリッド検索の導入など、必要な改善に絞って取り組めます。
原因を定量的に診断する習慣が、PoCを越えて本番化できるかを左右します。
PoC死を避ける継続的な改善体制
PoCで止まり本番に至らない「PoC死」は、生成AIプロジェクトの最大の失敗パターンです。一度作って終わりにせず、運用中も精度を改善し続ける体制が欠かせません。
継続的な改善では、運用の中で3つの取り組みを行います。
- モニタリング:評価指標の定期的な計測。
- 原因特定と改善:精度が下がった際に、原因を探して調整します。
- 担当と判断基準の明確化:誰が改善を判断し、ベンダーがどこまで支援するかを決めておきます。
現場の質問やデータは時間とともに変わるため、リリース時の精度を保ち、高めるには継続的な調整が欠かせません。改善サイクルを回せるかが、長期的な成否を決めます。
改善の体制は、開発の初期から計画に組み込んでおきます。具体的には、要件定義や契約の段階で、担当者、判断基準、ベンダーの支援範囲を明確にしておきます。
東京ガスの事例のように、反復改善によって実用化に至った例もあります。システムを育てていく前提で改善の仕組みを持つことが、PoC死を避けることにつながります。
失敗を恐れて立ち止まるよりも、改善を続ける仕組みを持つことが、成功への道筋になります。
まとめ
生成AIシステムの失敗は、データ品質、セキュリティ、精度評価の3つの観点から捉えられます。Gartnerは、AIプロジェクトの60%がデータ不足で失敗すると予測しています。
Canon ITソリューションズの調査では、回答品質が46%、データ連携が42%を占めました。失敗を避けるうえで最も大切なのは、原因を構造的に理解し、データ整備、セキュリティ管理、精度評価の3つを疎かにしないことです。
BadRAGでは、0.04%のデータ汚染で攻撃成功率が98.2%に達する脅威も示されています。情報漏洩、ハルシネーション、著作権のリスクは、契約や権限管理、出典確認、社内指針によって管理します。
具体的には、データを整え、リスクを管理し、Ragasなどで原因を測って改善します。さらに、運用を続けながら精度を高める体制も、PoC死を避けて実用化するための鍵です。
失敗パターンを事前に知っておくことで、多くのリスクは避けられます。導入の際は、リスク対策まで見据えて設計できる開発パートナーに相談するところから始めてください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。