
AIアシスタント導入の失敗は、データ品質の問題に始まり、回答とデータ連携、セキュリティ、導入後の定着へと広がります。
データの整備、実業務に即したPoC、継続的な評価と改善を順に進めれば、これらは防ぎやすくなります。全体像はAIアシスタントの完全ガイドもご覧ください。
▼全体ガイドの記事
・AIアシスタントの完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AIアシスタント導入が失敗する構造的要因—データ品質という壁
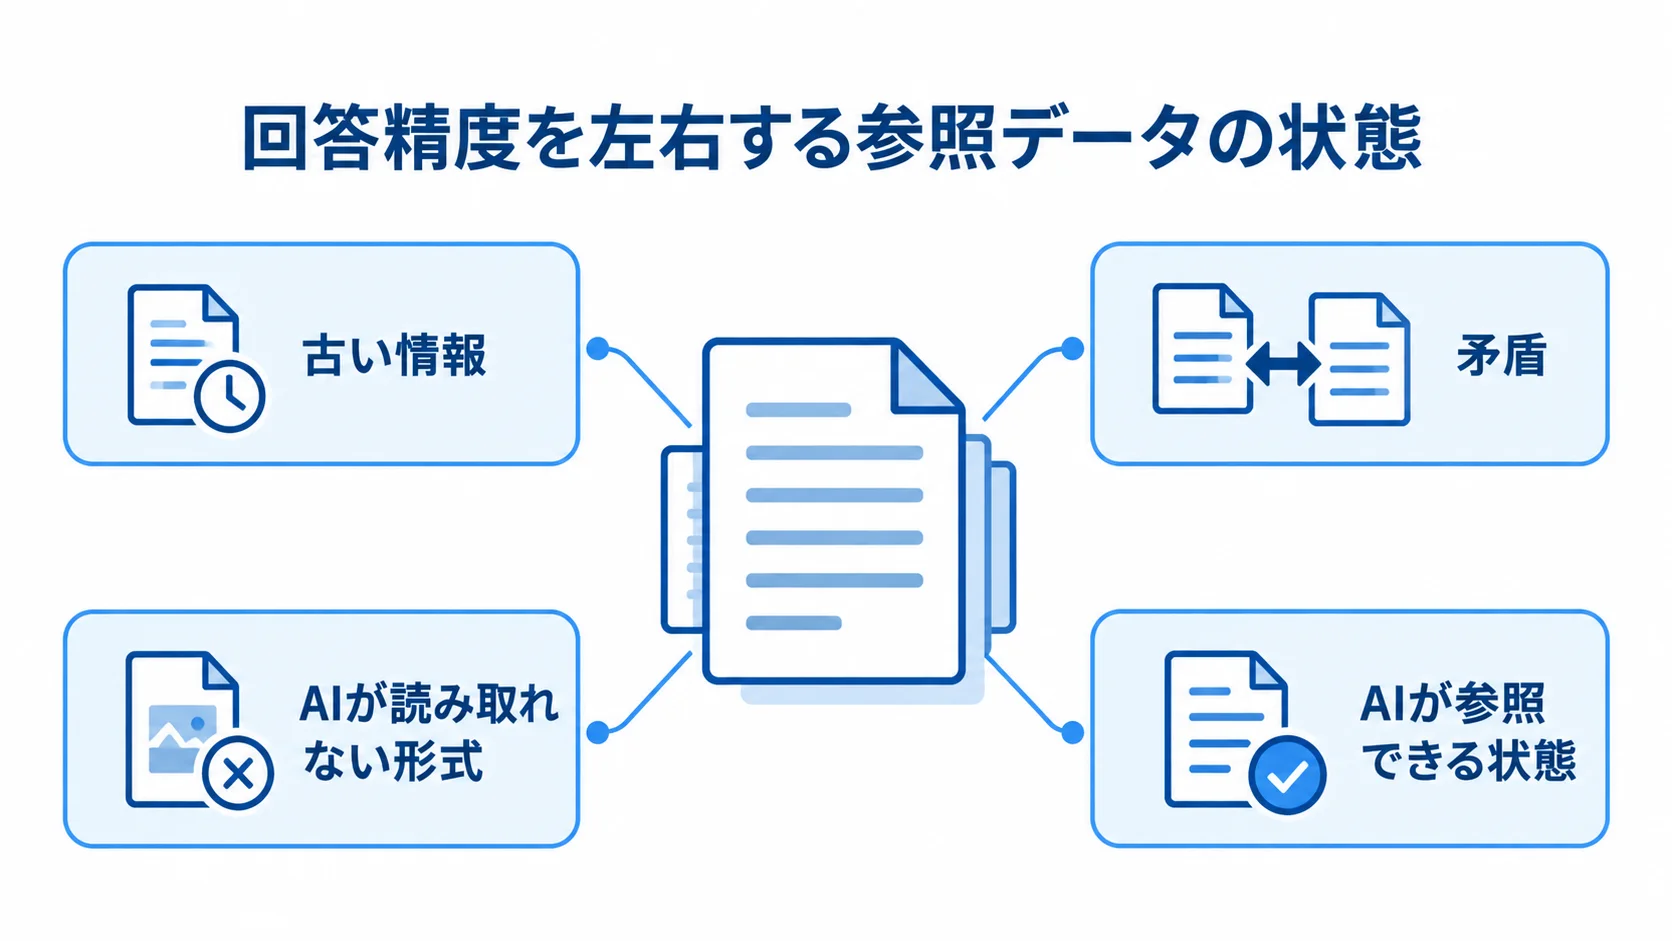
AIアシスタントの回答精度は、社内マニュアルや規程、過去の問い合わせ履歴など、参照データの品質に左右されます。元データが整っていなければ、高性能なAIモデルを採用しても精度は上がりません。調査データを見ても、データ不足は失敗の大きな原因として挙げられています。
AIプロジェクトの60%がデータ不足で失敗するという予測
Gartnerは、AIプロジェクトの60%が2026年までにデータ不足を原因に失敗すると予測しています(出典:Gartner)。
この予測は、AIの性能より先にデータ準備の不足が多くの失敗につながる可能性を示しています。つまり、データ品質がAIアシスタントの成否を左右すると言えます。
導入を検討する企業は、まずこの現実を正面から受け止めるべきです。
失敗の背景には、最新のAIへの期待が先行し、データ整備への投資が後回しになることがあります。このまま進むと、PoCで精度が出ず、データが原因だと気づく頃には予算と期間を大きく消費しています。
- 整備を優先:モデル選定より先に、参照データの状態を確かめる
- 使える状態で判断:文書の見かけの量だけで、データ不足を判断しない
文書が大量にあっても、古い情報や矛盾、AIが読み取れない形式があれば、実質的にはデータ不足と同じです。
AIが参照できる状態のデータ量を確かめずに進めると、導入後に精度が出ない原因を見落とし、それが導入失敗の入口になります。
手応えはあるのに本番に届かないPoC死
PoC死とは、試行段階で手応えを得ても、業務で使える精度に届かず、本番へ移行できない状態です。AIアシスタント導入でよく見られる失敗パターンの一つです。
限られたサンプルデータでは8割の質問に答えられても、実業務の多様な問い合わせでは精度が落ちることがあります。
- 条件の差:PoCは整ったデータと想定内の質問で検証する
- 本番の難しさ:表記ゆれや複数文書にまたがる質問が届く
- 評価データ:実際の問い合わせログに近い多様なデータを使う
PoCと本番の違いを見ないまま成功だけで安心していると、業務水準の精度に届かず、頓挫することがあります。
PoCは精度の確認に加え、本番に必要なデータ整備や運用体制の工数を見積もる工程でもあります。ここで作業量を見積もらないまま投資判断を下すと、追加コストが想定を超え、途中で止まることがあります。
回答品質とデータ連携の不備という二大失敗原因
Canon ITソリューションズのRAG調査(228件)では、成功(Good)は33%でした(出典:Canon ITソリューションズ)。失敗原因の内訳は、回答品質が46%、データ連携が42%です。
失敗の原因としては、回答品質とデータ連携が中心に挙がっています。
回答品質を下げるチャンキングと検索精度の問題
回答品質の失敗原因は、不適切なチャンキングと検索精度の低さに集約されます。
- 分割の不備:情報が切れたり、無関係な内容が混ざったりする
- 検索の不備:質問に合う文書を取り出せない
チャンキングは、長い社内文書をAIが扱いやすい単位に分割する処理です。たとえば、長大なマニュアルを区切らず投入すると、必要な情報を取り出せず、的外れな回答が生じます。
AIは質問に関連する文書を検索し、その内容をもとに回答を生成します。そのため、検索で誤った文書を選ぶと、回答も正しくなりません。
的確な文書が検索できなければ、生成の性能が高くても正答できません。検索の問題は、モデルを変えるだけでは改善しません。まずは検索の品質を確かめる必要があります。
古い規程や手書きのスキャンPDF、表と文章が混在するExcelは、そのままでは正確に読み取れません。
そのため、発注側と開発会社が協力して、データクレンジングと構造化を行い、AIが参照しやすい形に整えます。前処理を軽く見ると、PoCで頓挫するおそれがあります。地道な前処理が回答品質を左右することは、関係者全員で共有しておく必要があります。
データ連携の不備が招く陳腐化と矛盾
データ連携の不備は、複数システムに分散した情報をAIアシスタントへ統合する難しさから生じます。
- 情報の分散:業務システムやファイルサーバー、グループウェアに文書が散らばる
- 正本の不明確さ:情報の基準が定まらず、古い内容や矛盾が回答に混ざる
- 更新の遅れ:変更が参照データに反映されず、回答が陳腐化する
連携の設計を後回しにすると、データが少しずつ古くなり、回答精度も徐々に下がります。
そこで、誰が、いつ、どのように参照データを更新するかを、運用ルールとして決めておきます。参照先は一本化して、更新が確実に参照データに反映される仕組みを整えることが基本です。
運用では、複数の文書にまたがる質問に備えて、どの情報源を優先するかも決めておきます。
回答品質と連携の問題は、使えるデータを用意し、維持し続ける設計で結びついています。そのため、この二つは最初から設計に織り込んでおくことが、実用化の前提になります。
情報漏洩・データポイズニング・ハルシネーションのリスク
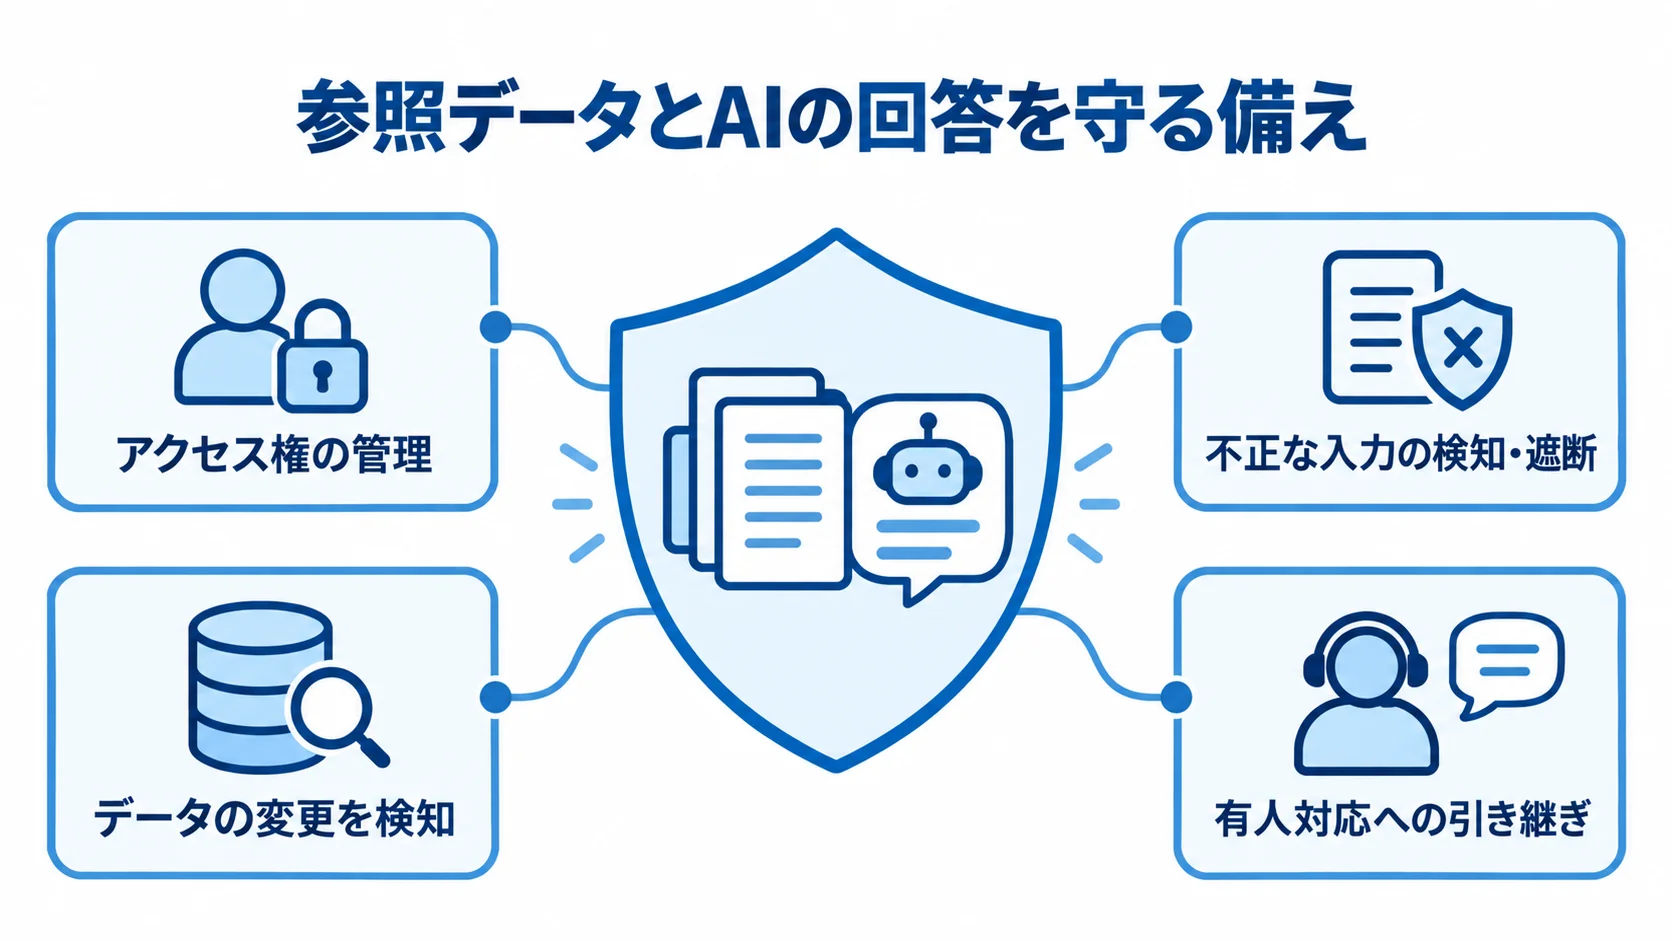
精度ばかりに目を向けると、セキュリティや情報漏洩のリスクを見落とすことがあります。機密情報を扱う仕組みで事故が起きれば、業務効率化どころか重大な損害につながります。
生成AI特有のリスクを把握しないまま導入すると、思わぬ事故を招きます。主な脅威は、データポイズニング、情報漏洩、ハルシネーションです。
0.04%の汚染で攻撃成功率98.2%というデータポイズニング
データポイズニングは、社内文書などAIの参照データを汚染する攻撃です。
BadRAGの研究では、検索対象の0.04%を汚染すると、プロンプトインジェクションの成功率が98.2%に達しました。
- 入口を守る:参照データへのアクセス権を管理する
- 不正を止める:不正な入力を検知・遮断する
- 改ざんを見つける:データの変更を検知する仕組みを設ける
大量のデータのごく一部に不正な指示が入るだけでも、AIの挙動を乗っ取られるおそれがあります。特に、参照文書を誰でも編集できる状態では、この種の攻撃に無防備です。
また、悪意ある第三者だけでなく、誤った情報の混入も回答品質を損ないます。そのため、文書の追加と更新の手順、チェックの体制を整え、データの管理権限も適切に制御しておく必要があります。
精度の検討を優先してセキュリティ設計を後回しにすると、汚染に無防備なシステムになりかねません。入口の管理は、設計段階から組み込んでおきます。
情報漏洩・ハルシネーション・著作権という生成AI特有のリスク
権限管理が不十分だと、アクセス権のない社員がAI経由で機密情報を引き出す事態が起こり得ます。
- 情報漏洩:部門ごとに参照文書を制御し、機密情報へのアクセスを制限する
- 外部サービス:入力データが学習に使われない契約・設定か確認する
- 誤回答:根拠文書の提示や有人対応への引き継ぎを用意する
- 著作権:外部文書の情報源に、権利上の問題がないかを確かめる
AIは社内の情報を横断して扱うため、権限の設計に不備があると、漏洩に直結します。
ハルシネーションによる誤答が業務判断や顧客対応に使われると、損害につながります。また、利用者には回答を参考情報として扱ってもらい、重要な判断では人が根拠を確かめるルールを周知しておきます。
顧客向け業務など誤りの影響が大きい場面では、AIの回答をそのまま正解としない運用が必要です。
技術的な備えと利用ルールを組み合わせれば、生成AI特有のリスクを実務上許容できる水準まで下げられます。逆に、備えを欠いたまま導入すると、利便性の裏でリスクを抱え込むことになります。
失敗を防ぐ評価・改善と定着のための注意点
データ品質やセキュリティを整えても、評価・改善と定着の仕組みがなければ成果につながりません。
原因を特定できないまま試行錯誤を繰り返したり、一部の社員しか使わず放置されたりする失敗もあります。
Ragasによる「検索が悪いのか生成が悪いのか」の切り分け
精度が出ない原因は、検索、生成、元データのどこにあるかで対策が異なります。
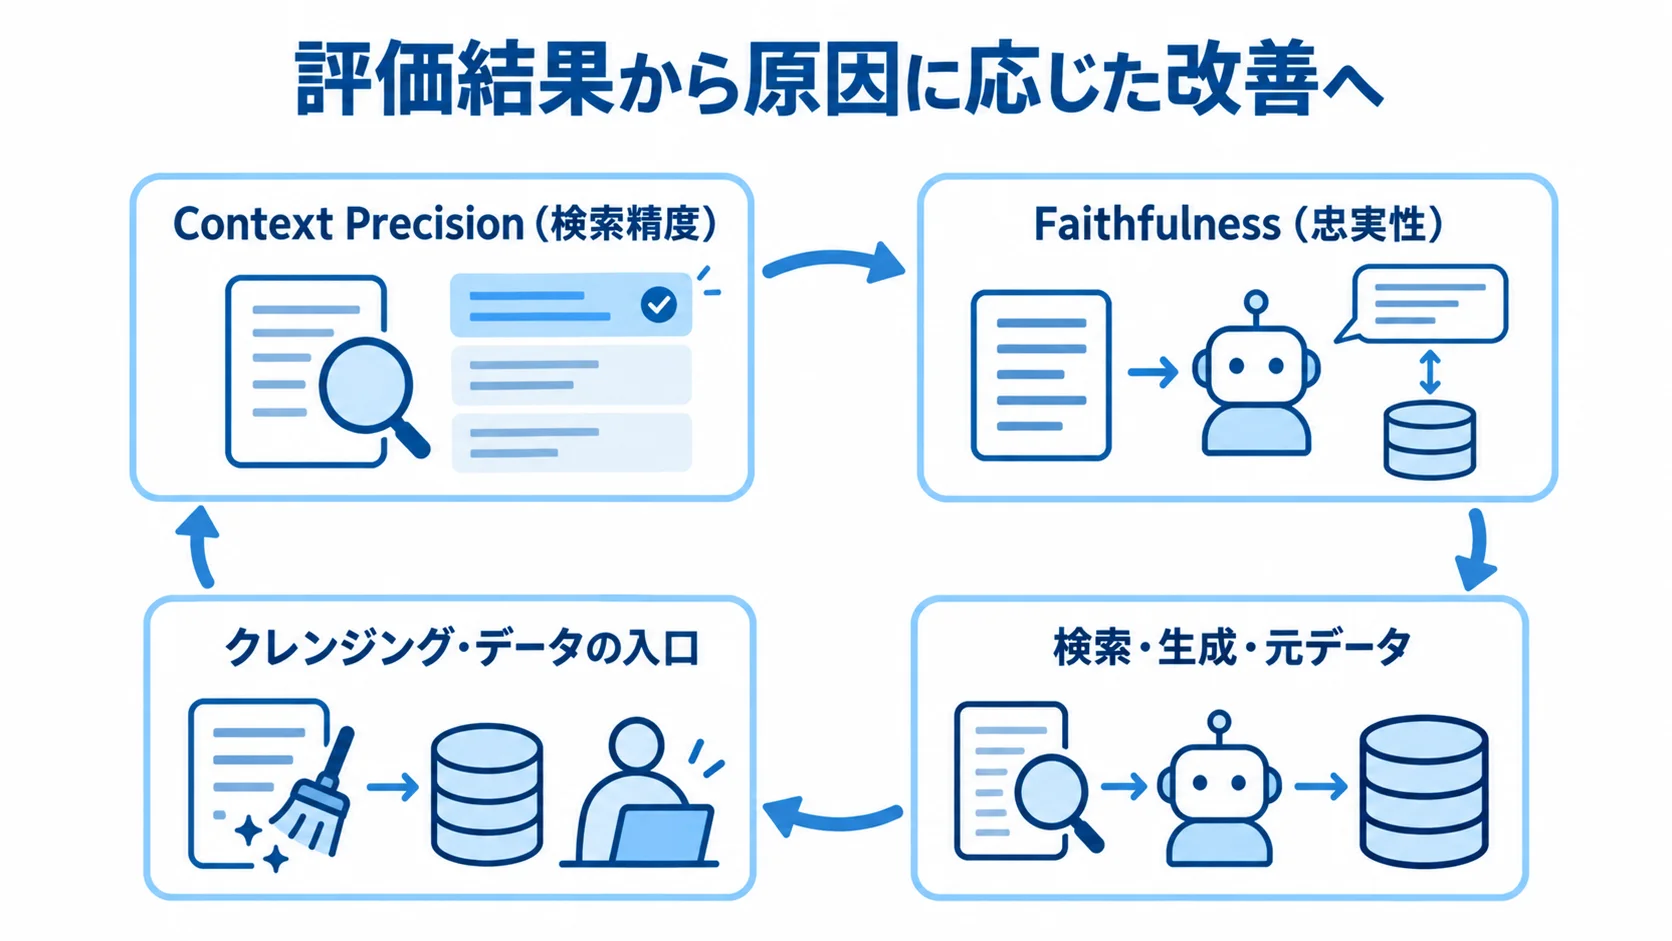
- Context Precision(検索精度):検索された文書がどれだけ的確かを示す指標
- Faithfulness(忠実性):回答がどれだけ文書に忠実かを示す指標
- 結果の見方:検索、生成、元データのどこに原因があるかを見分ける
Ragasなどで二つの指標を別々に測り、原因を数値で調べます。検索精度が低ければ検索に、忠実性が低ければ生成に問題があり、両方とも高いのに誤答するなら元データを疑います。
原因を見ないまま、モデルだけを変えても根本の改善にはならず、時間と予算を浪費して、PoC死を招くことがあります。原因に応じて対策を選べることが、闇雲な試行錯誤を抜け出す第一歩です。
計測に基づいて改善すれば、限られた工数を効果のある対策へ集中できます。評価指標を設計時から組み込んでおくことも、失敗を防ぐ実務的な備えです。
「導入しただけで放置」という定着失敗の防止
技術的に精度が出ても、現場で使われなければ投資を回収できません。
- 利用を続ける支援:使い方を浸透させる
- 回答の改善:答えられない質問を分析し、文書を更新する
- 定期運用:集計と修正の頻度、担当を決める
精度が期待に届かなければ、導入直後から利用が細っていきます。放置されて一部の社員しか使わない状態も、よくある定着失敗です。
導入後は、技術の完成度だけでなく、人が継続して使う状態を作る視点も欠かせません。
運用では、回答不能やContext Precisionの低い質問を週次で集計し、月次で文書を直す方法があります。
改善を回す運用体制がなければ、導入時の精度のまま放置され、利用者に見限られます。
評価で元データの問題が分かればクレンジングへ戻り、汚染が疑われればデータの入口を見直します。こうした循環は、データ品質やセキュリティの課題にもつながっています。
完璧に一度で作るより、測定と修正を続けて、現場が使える状態を保つことが実用への近道です。
まとめ
AIアシスタント導入では、データ品質が大きな失敗要因になります。Gartnerは、2026年までにAIプロジェクトの60%がデータ不足で失敗すると予測しています。
Canon ITソリューションズの調査では、RAG事例228件のうち成功は33%で、失敗原因は回答品質が46%、データ連携が42%でした。
このため、チャンキングや検索を見直し、データを整える必要があります。PoCでは本番に近いデータを用い、精度以外に運用の工数も見積もります。
BadRAGの研究では、データの0.04%を汚染するだけで攻撃成功率が98.2%に達しました。また、情報漏洩やハルシネーション、著作権にも備えます。
Ragasで原因を検索、生成、元データのどこにあるかに切り分け、継続的な評価と改善を運用に組み込みます。
導入後の放置や一部社員だけの利用を避け、回答改善と利用定着を続ける体制が、失敗の回避につながります。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。