
AIライティングシステムは、うまく使えば制作の工数を減らせます。一方で、導入しても使われない、コストが想定より膨らむ、誤情報で炎上するといった失敗が起きがちです。失敗の構造を知ることが、同じ轍を踏まないための最良の保険になります。
費用や全体像は、AIライティングシステムの完全ガイドから確認できます。
▼全体ガイドの記事
・AIライティングシステムの完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
トークン課金の暴騰と隠れコストの失敗
金銭的なダメージがもっとも大きいのは、ランニングコストが想定を超えることです。生成AIはトークン課金が基本のため、利用が増えるほどコストが際限なく膨らみます。
稟議では月額数万円と説明していたのに、実際の運用では何倍にもなり、追加の予算確保に追われることがあります。AIライティング特有の落とし穴といえます。
月5万円見込みが20万円超になった失敗
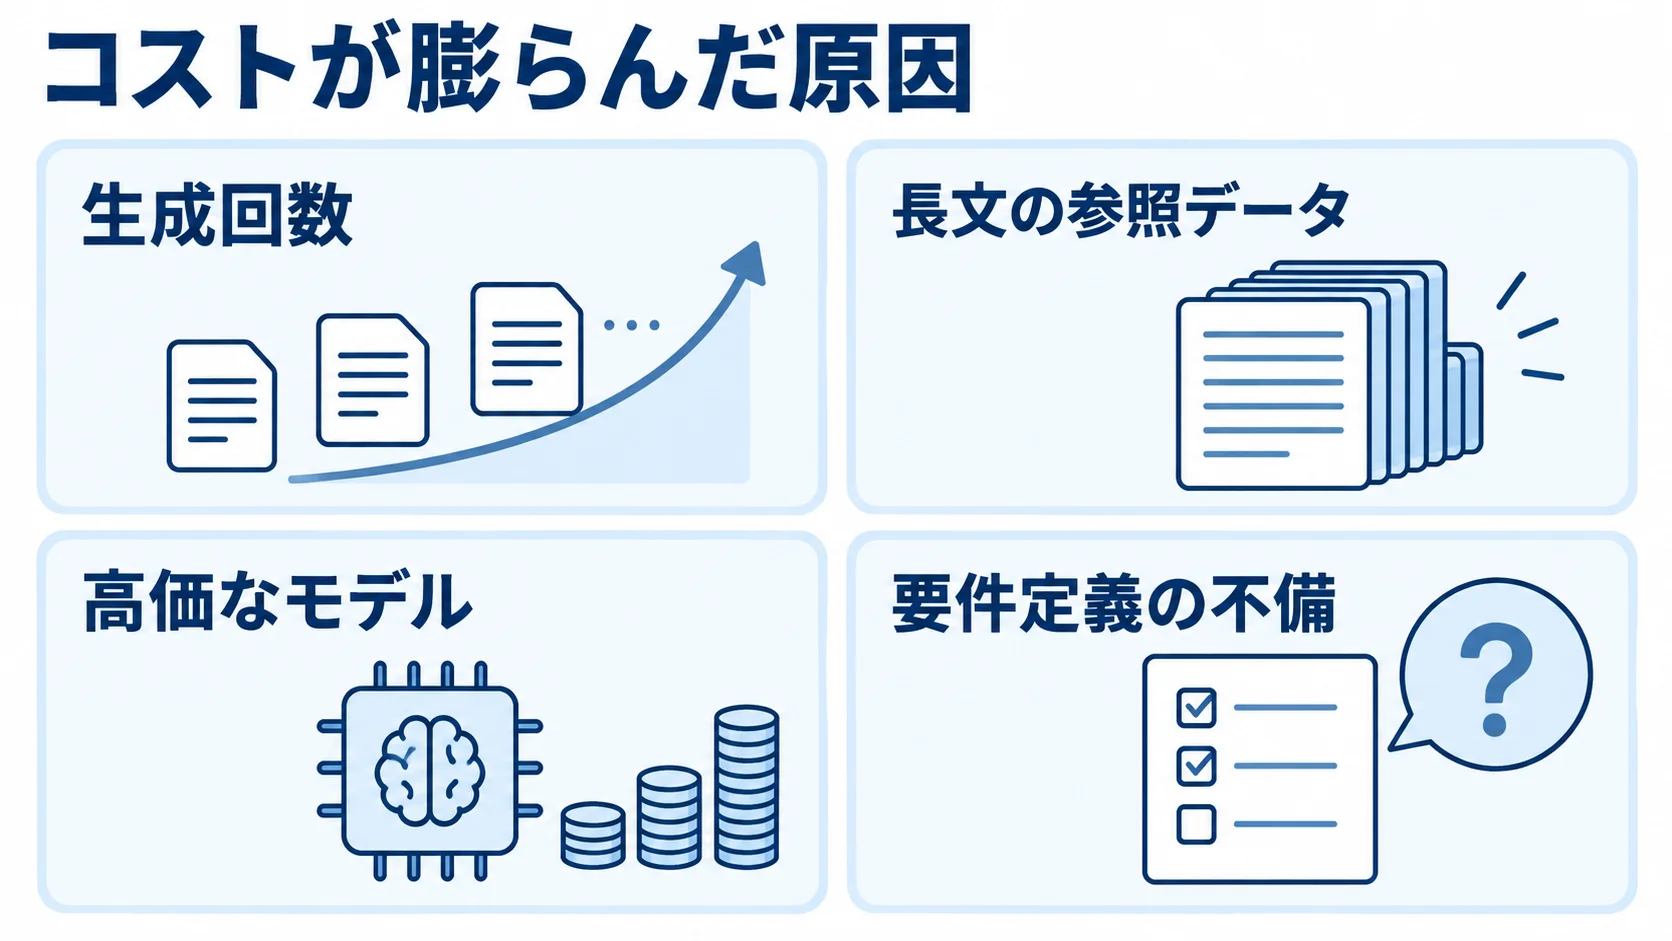
一次データには、月5万円を見込んでいたトークン課金が、実際には20万円超に達した事例があります。その原因は、想定より生成回数が多かったこと、長文の参照データを毎回読み込ませてトークン消費が膨らんだこと、高価なモデルを安易に使ったことなどが重なった結果です。
さらに、モデルの選び方によっても費用は大きく変わります。月10万リクエストの試算では、Gemini 2.0 Flashが約3,750円なのに対し、Claude Sonnet 4は約135,000円です。選定を誤るだけで、数十倍の差が生じます。
この失敗を避けるには、導入前に利用量を現実的に試算し、用途ごとにモデルを使い分けることが欠かせません。そのうえで、コストは運用する人の注意に頼らず、利用量に上限を設ける制御で縛ることが鉄則です。こうした制御を入れておけば、暴走を制度的に防げます。
金額の見方は、稟議の段階と運用の段階で分けて持っておく必要があります。
- 稟議の段階:月額の見込みに、利用量が増えた場合の上限額を添えて示す
- 運用の段階:予算の80%に達したら通知し、上限を超えたら一時停止する設定を入れる
要件定義不備による追加開発という失敗
もう一つの典型は、初期見積もりに含まれていなかった隠れコストが後から発生することです。一次データでは、要件定義の不備による再開発で100万〜500万円が追加で発生した事例や、連携API開発費が1件あたり30万〜100万円かかる実態が報告されています。
「とりあえず導入してから考える」と要件を曖昧にしたまま進めると、後から「この連携は別料金」「このチューニングは追加見積もり」と言われ、当初の予算が崩れます。隠れコストには、プロンプトや参照データのチューニング費、運用に必要な人的リソースなども含まれます。
失敗を避けるには、見積もりの段階で費用を分けて提示させ、隠れコストを洗い出すことが重要です。安く見える提案ほど、後から費用が積み上がる構造になっていないかを疑う姿勢が、コスト面の失敗を防ぎます。
見積もりは、費用の種類ごとに中身を確かめるのが基本です。
- 初期費用と月額費用:それぞれ別の金額として示されているかを確認する
- 従量と追加開発:利用量に応じた費用と、後から発生しうる開発費の扱い
補助金の事前着手で全額不支給になる失敗
AIライティングシステムの導入には、デジタル化やAI導入に関する補助金を活用できる場合があります。一次データでは、通常枠で最大450万円規模の支援を受けたケースも報告されています。
ただし、見落とされやすい致命的な落とし穴があります。補助金は原則として、交付決定の前に契約・発注してしまうと「事前着手」とみなされ、全額が不支給になることがあります。
早く始めたい一心で交付決定を待たずに発注すると、当てにしていた補助金が一切下りず、自己資金で全額を負担する事態になります。この失敗を避けるには、補助金の申請スケジュールと交付決定のタイミングを正確に把握し、交付決定が下りてから契約・発注する手順を守ることが欠かせません。
あわせて、対象経費の範囲や採択の要件も、事前に確認しておく必要があります。補助金は魅力的な制度ですが、手続きの順序を一つ間違えるだけで効果がゼロになりかねません。
だからこそ、導入を急ぐあまり順序を飛ばさないことが、補助金活用における最大の注意点です。
申請では、スケジュールと採択後の報告という二つの面を押さえておく必要があります。
- 申請スケジュール:交付決定の時期を、発注の予定と並べて確認する
- 採択後の報告:報告が求められる内容と時期を、契約の前に把握する
ハルシネーションによる誤情報・炎上リスク
金銭以上に深刻になりうるのが、誤情報の公開によるブランドの毀損です。AIはもっともらしい嘘(ハルシネーション)を堂々と書くため、人の確認を怠ると、事実と異なる内容や不適切な表現がそのまま世に出てしまいます。一度公開した誤情報は、たとえ削除しても拡散やキャッシュが残るため、信頼を取り戻すまでに長い時間がかかります。
事実誤認・法規制違反の表現が出る失敗
典型的な失敗は、AIが生成した記事に事実誤認や古い情報が混じり、それを確認しないまま公開してしまうケースです。特に専門的な内容や数値を含む記事では、AIが実在しない出典をでっち上げたり、誤った数値を自信たっぷりに書いたりします。
さらに、健康・美容・金融の分野では、薬機法や景品表示法に触れる「絶対に治る」「No.1」といった表現が生成され、法的なリスクに直結することもあります。
この失敗を防ぐ最大の対策は、RAG(検索拡張生成)で社内の正確な一次情報を参照させ、生成の根拠を限定することです。たとえば、AIチャットボット分野のKARAKURIが正答率95%保証プランを提供できるのも、参照データの整備と検索精度の作り込みがあってこそです。
あわせて、薬機法などの禁止表現を検出するチェック機能を組み込み、最終的には人が確認する工程を残します。「AIに任せきりにしない」という運用設計が、炎上リスクを構造的に下げます。
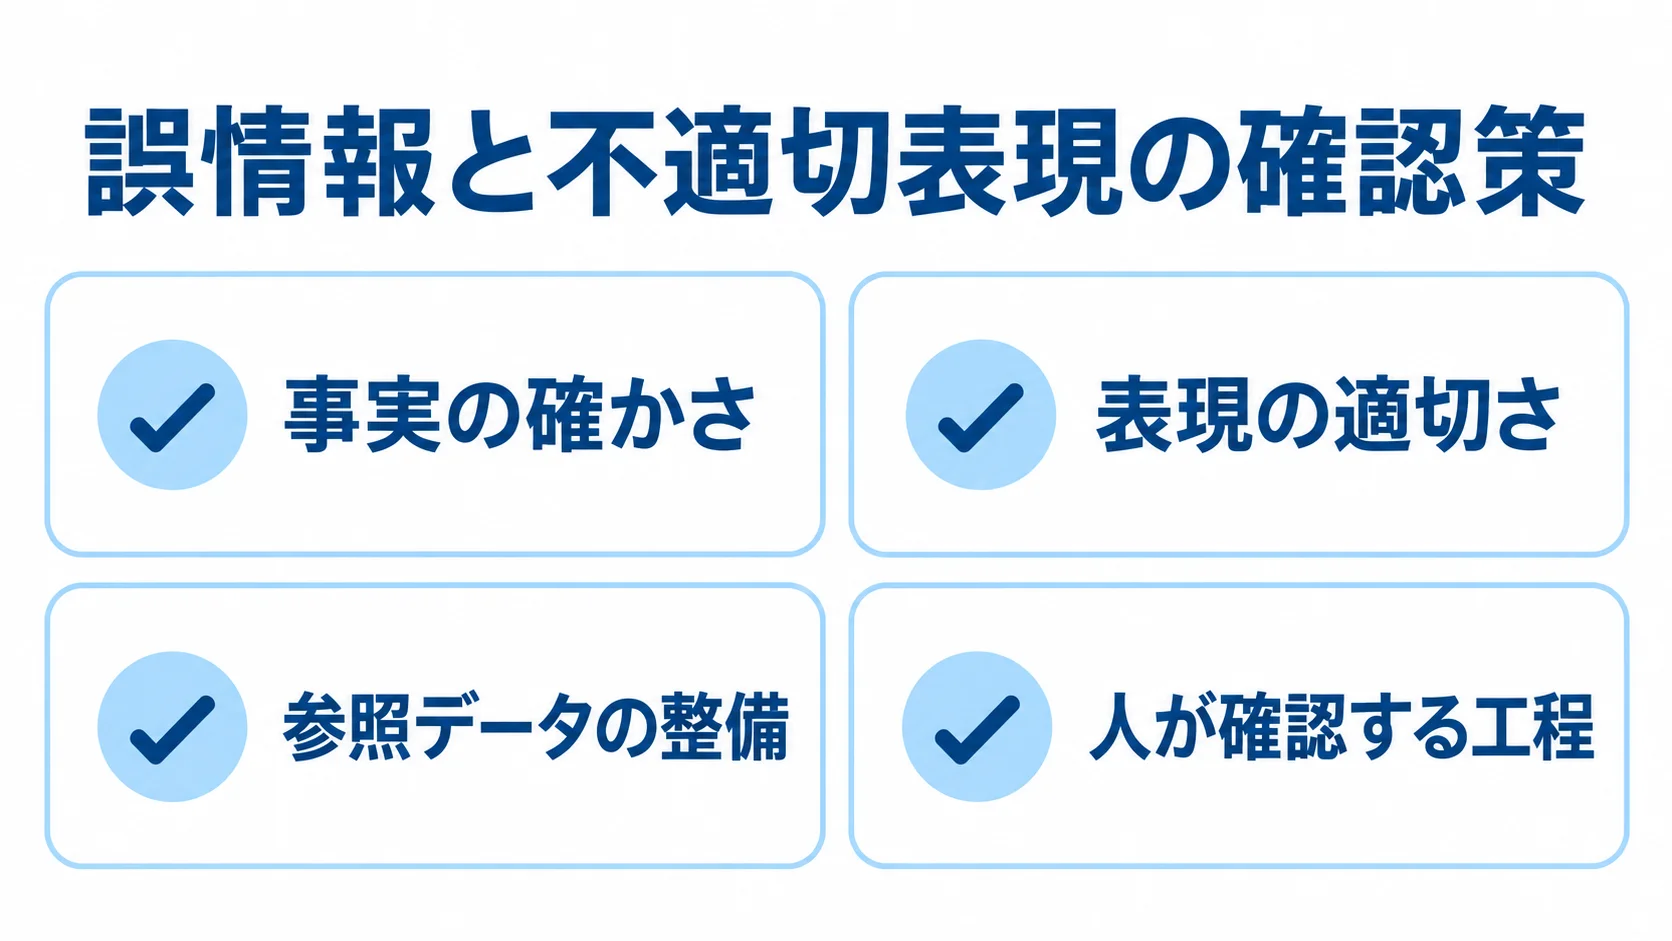
生成された文章は、事実の確かさと表現の適切さの2つの面で確認します。
- 事実の確かさ:数値や出典が一次情報と合っているかを、人が照らし合わせる
- 表現の適切さ:禁止表現が含まれていないかを、チェックの結果と人の目で見る
RAGの精度不足という見えにくい失敗
RAGを導入すれば精度が上がると考えがちですが、参照データが整理されていないと、検索のヒット率が低いままになり、結局ハルシネーションが残ります。マニュアルやFAQをそのまま放り込むと、AIは必要な情報を正確に引けず、的外れな根拠をもとに文章を生成してしまいます。
RAGの質は、参照データを構造化し、チューニングするかどうかで決まります。この失敗を避けるには、RAG用のデータを検索しやすい粒度と形式に整理し、想定する質問に正しい情報を引けるかを継続的に検証することが欠かせません。
誤回答を防ぐには、プロンプトの工夫も役立ちます。「参照データに根拠がない場合は推測で書かない」といった制約を設けると、嘘の生成を抑えられます。RAGの精度は、作って終わりではなく、運用しながら磨き続けるものだと捉えておくことが大切です。
RAGの確認では、データの整い方と回答の根拠の2つを見ておきます。
- 参照データの整い方:検索しやすい粒度で分かれているか、想定する質問に対応しているか
- 回答の根拠:参照データに基づかない内容が混ざっていないこと
ベンダーロックインと形骸化のリスク
導入時には見えにくいものの、後から効いてくるのが、ベンダーロックインと運用面の形骸化です。
乗り換えたくても移れない、せっかく導入したのに使われなくなるという事態は、投資そのものを無駄にしてしまいます。これらは技術の問題ではなく、契約と運用の設計で防ぐべきリスクです。
データが移せずロックインされる失敗
特定ベンダーのシステムにプロンプトや参照データ、生成履歴を蓄積していくと、乗り換えようとしたときにデータを取り出せず、身動きが取れなくなります。これがベンダーロックインです。
長年かけて作り込んだプロンプトやナレッジが、そのベンダーの環境でしか使えない形式に閉じ込められていると、値上げや品質低下があっても乗り換えられません。そのため、不利な条件を受け入れざるを得なくなります。
この失敗を避けるには、契約の段階で条件を決めておくことが欠かせません。データの所有権が自社に残る設計を選べば、ベンダーに縛られず、状況に応じて別のツールへ移行できます。
riplaは、フルスクラッチ受託の立場から、データやロジックの所有権を発注側に残し、特定ベンダーに依存しない構成を重視しています。ロックインのリスクを避けたい企業には、この観点を強くおすすめします。
押さえたいのは、データの取り出し方と、契約が終わったときの扱いの二点です。
- エクスポート:蓄積したデータを、標準的な形式で取り出せること
- 契約終了時:契約が終わったときに、データを返還することを要件として明記する
運用リソース枯渇で形骸化する失敗
もっとも多い失敗が、導入後に運用リソースを確保できず、システムが徐々に使われなくなる形骸化です。AIライティングは、プロンプトの改善や参照データの更新といったメンテナンスに、最低でも月5〜10時間のリソースが必要です。
この工数を担う担当者を決めないまま導入すると、初稿の質が改善されないまま放置され、現場は「使えない」と判断して従来の手作業に戻ってしまいます。この失敗を避けるには、導入前に運用体制と担当者を明確にし、AIの使い方を継続的に磨く前提で計画を立てることが欠かせません。
考え方は「育てながら使う」に切り替え、定型記事のように効果の大きい用途から段階的に広げていきます。現場が小さな成功を実感できれば、定着につながります。
実際、立て直しに成功した企業は、例外なくこの運用設計に丁寧に向き合っています。
運用の体制づくりは、担当者の確保と使い方の見直しの二つに分けて考えます。
- 担当者の確保:プロンプトの改善や参照データの更新を担う人を、導入前に決めておく
- 使い方の見直し:現場の声や結果をもとに、プロンプトと参照データを継続的に手直しする
現場の抵抗と情報漏えいのリスク
最後は、技術や予算とは別に、「人」と「情報」に関わるリスクです。
現場のライターや編集者の抵抗、そして機密情報の漏えいは、見落とされやすいものの、プロジェクトを頓挫させる要因になります。導入の初期段階から手を打っておく必要があります。
「仕事を奪われる」不安による現場抵抗
AIライティング導入でしばしば見落とされるのが、現場のライターや編集者の心理的な抵抗です。「AIに仕事を奪われる」という不安や、「機械が書いた文章は使いたくない」という抵抗感があると、導入してもツールが使われません。
経営層がトップダウンで導入を決めても、実際に手を動かす現場が前向きでなければ、定着は望めません。これは、業務システム導入に共通するチェンジマネジメントの課題です。
この失敗を避けるには、AIを「人の仕事を奪う存在」ではなく、面倒な初稿作成やリサーチを肩代わりし、人をより創造的な仕事へ解放する道具として位置づけ直すことが大切です。
そのうえで、現場の不安や誤解を早い段階で解消しておくことが欠かせません。現場が「これは自分を楽にしてくれる」と実感できるよう導入を設計すれば、抵抗は協力へと変わります。
現場の抵抗を和らげるには、この二つを導入の計画に組み込むことが必要です。
- 役割分担:初稿とリサーチはAI、ファクトチェックと最終仕上げは人が受け持つ
- オンボーディング:編集者向けの説明の場で、不安や誤解を一つずつ解消する
機密情報の漏えいという致命的リスク
もっとも致命的になりうるのが、情報漏えいです。無料版のAIツールでは、入力した情報がAIの学習に利用される場合があり、機密情報や個人情報を入れると、外部に流出するリスクがあります。
現場が利便性を優先して、契約外の無料ツールに社内情報を貼り付ける「シャドーAI」も、見えにくい漏えいの経路になります。一次データでは、情報漏えいへの対応に500万円以上を要した事例が報告されており、金銭面にも信用面にも大きな被害をもたらします。
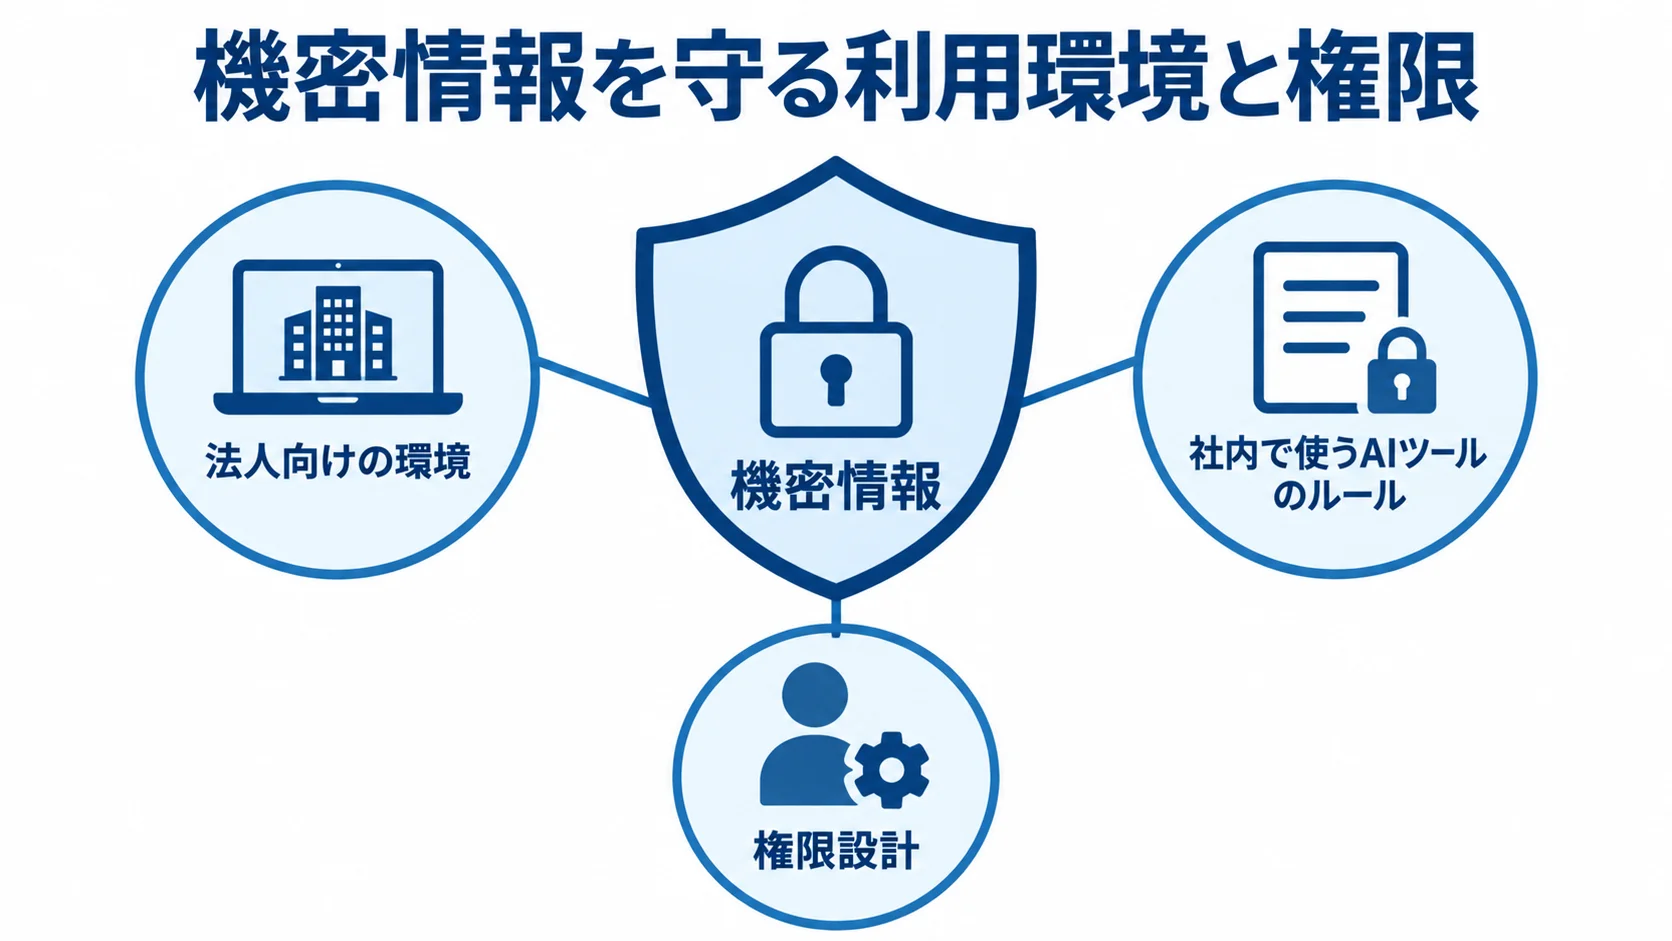
この失敗を避けるには、導入前の段階で情報の扱いを決めておくことが欠かせません。あわせて、社内で使うAIツールのルールを明確にし、現場が安全なツールを使える状態を整えることで、シャドーAIを防ぎます。情報管理は、利便性と引き換えにするものではなく、事業を続けるための前提条件です。
riplaは、フルスクラッチ受託の立場から、データの取り扱いと権限設計を要件の段階から作り込み、情報漏えいのリスクを抑えた構築を支援しています。失敗事例を自社の問題として読み、対策を確かめるチェックリストに使うのがおすすめです。
押さえたいのは、利用するツールと、参照できるデータの範囲の二つです。
- 利用するツール:入力データを学習に使わない法人向けの環境かどうかを確かめる
- 参照できるデータ:社員ごとに閲覧や利用の範囲を権限で分けておく
まとめ
AIライティングシステムの失敗を振り返ると、トークン課金の暴騰(月5万円の見込みが20万円超)と隠れコスト、誤情報や法規制違反による炎上、ベンダーロックインでデータが移せない問題があります。
さらに、運用リソースの枯渇による形骸化、現場の抵抗、情報漏えい(対応に500万円以上)が加わり、計6つのリスクに集約されます。IDC Japan 2024では、AI導入プロジェクトの32%が期待した効果を達成できていないとされています。こうしたリスクを軽く見た導入が多いことをうかがわせます。
失敗を避けるには、これらのリスクを導入前に確認すべきチェックリストとして扱うことが大切です。
コストは上限を設けて管理し、誤情報はRAGと人による確認で防ぎます。ロックインはデータの所有権を自社に残して避け、形骸化は運用体制で食い止めます。現場の抵抗は、役割分担によって和らげられます。
情報漏えいは、法人向けの環境と権限管理で抑えます。riplaは、フルスクラッチ受託と運用の伴走という立場から、これらのリスクを要件の段階から設計に織り込み、失敗しないAIライティング導入を支援しています。
全体像は、あらためて完全ガイドでご確認ください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。