
AI FAQシステムの失敗は、参照データの品質の低さと、PoCから本番に進めない「PoC死」が主な原因です。
回答品質やデータ連携、セキュリティ、評価と改善の体制も課題になります。共通の原因と回避策を、AI FAQシステムの完全ガイドも踏まえてデータで整理します。
▼全体ガイドの記事
・AI FAQシステムの完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI FAQシステムが失敗する最大要因—データ品質とPoC死
AI FAQシステムの失敗原因の筆頭は、参照データの品質の低さです。FAQやマニュアル、規程類が整っていなければ、高性能なAIを使っても回答精度は上がりません。
データ品質の低さが招く失敗と、PoCから本番へ移れない「PoC死」の二つが、代表的な失敗の構造です。
調査データが示すデータ不足という壁
調査の数字からは、データ不足による失敗の深刻さがわかります。AI FAQシステムの失敗に、データ品質が深く関わることも示されています。
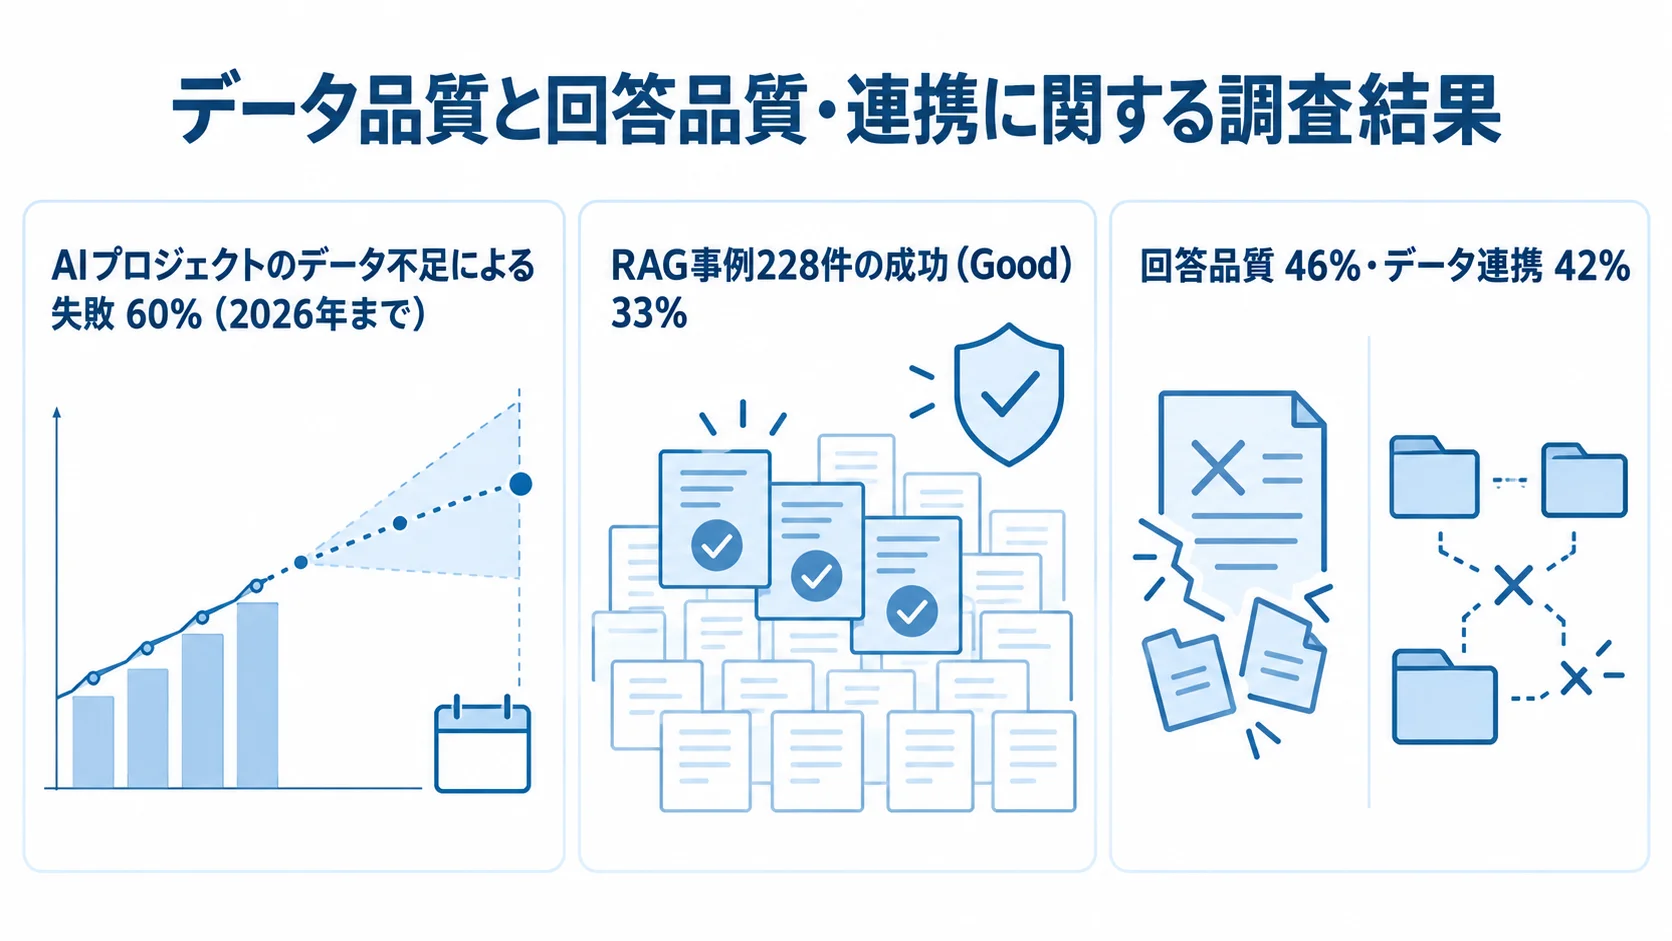
Gartnerは、AIプロジェクトの60%が2026年までにデータ不足で失敗すると予測しています(出典:Gartner)。
Canon ITソリューションズが228件のRAG事例を分析した調査では、成功(Good)は全体の33%でした。失敗原因の46%は回答品質、42%はデータ連携の課題に起因していました(出典:Canon ITソリューションズ)。
AIモデルを選ぶより先にデータを整えることが、失敗を避ける第一歩です。回答品質には、次の2点が特に関わります。
- データ整備の優先:モデル選定より先に参照情報を整える
- 参照情報の品質:古い、矛盾した、未構造化のFAQは、回答が外れる原因になります
最新AIへの期待から整備を後回しにすると、PoCで原因に気づくまで予算と期間を使ってしまいます。さらに、初期に品質を軽視すれば、その後の工夫も無駄になりかねません。
手応えはあるのに本番に届かないPoC死
PoCで精度が出ても、それだけで本番化を判断すると失敗につながります。本番化に必要な条件と工数も、あわせて確認します。
- よくある失敗「PoC死」:手応えがあっても業務精度に届かず、本番に移れない状態
- 条件差の検証:問い合わせログに近い多様なデータで、表記ゆれや複数の文書にまたがる質問も評価する
- 本番工数の見積もり:データ整備と運用体制に必要な作業量
限られたサンプルで8割の質問に答えられても、実際の幅広い問い合わせでは精度が落ちることがあります。PoCでは整ったデータと想定内の質問で好成績が出やすい一方、本番では複雑な質問も届きます。
こうした条件差を埋めないまま成功と判断すると、本番の精度が業務水準に届かず頓挫します。また、作業量を見積もらないまま投資を判断すると、想定外の追加コストで中断することがあります。
回答品質とデータ連携の課題への対策
失敗原因の大半を占める回答品質とデータ連携の課題は、地道なデータ整備で対策できます。
社内文書は、そのままではAIが正確に読めない形式が多く、そのためクレンジングや構造化が実務上の柱になります。
データクレンジングという泥臭い実務
回答品質の課題に対する最も確実な対策は、地道なデータクレンジングです。古い規程類、手書きをスキャンしたPDF、表とテキストが混在するExcelは、そのままではAIが正確に読み取れません。
こうした社内文書を参照しやすく整える作業が、精度を左右します。プロジェクト全体の工数のうち、40〜60%をデータ準備に割くべきだという指摘もあります。華やかなAI開発以上に前処理が成否を分けるため、この点は発注側と開発会社で共有しておきます。
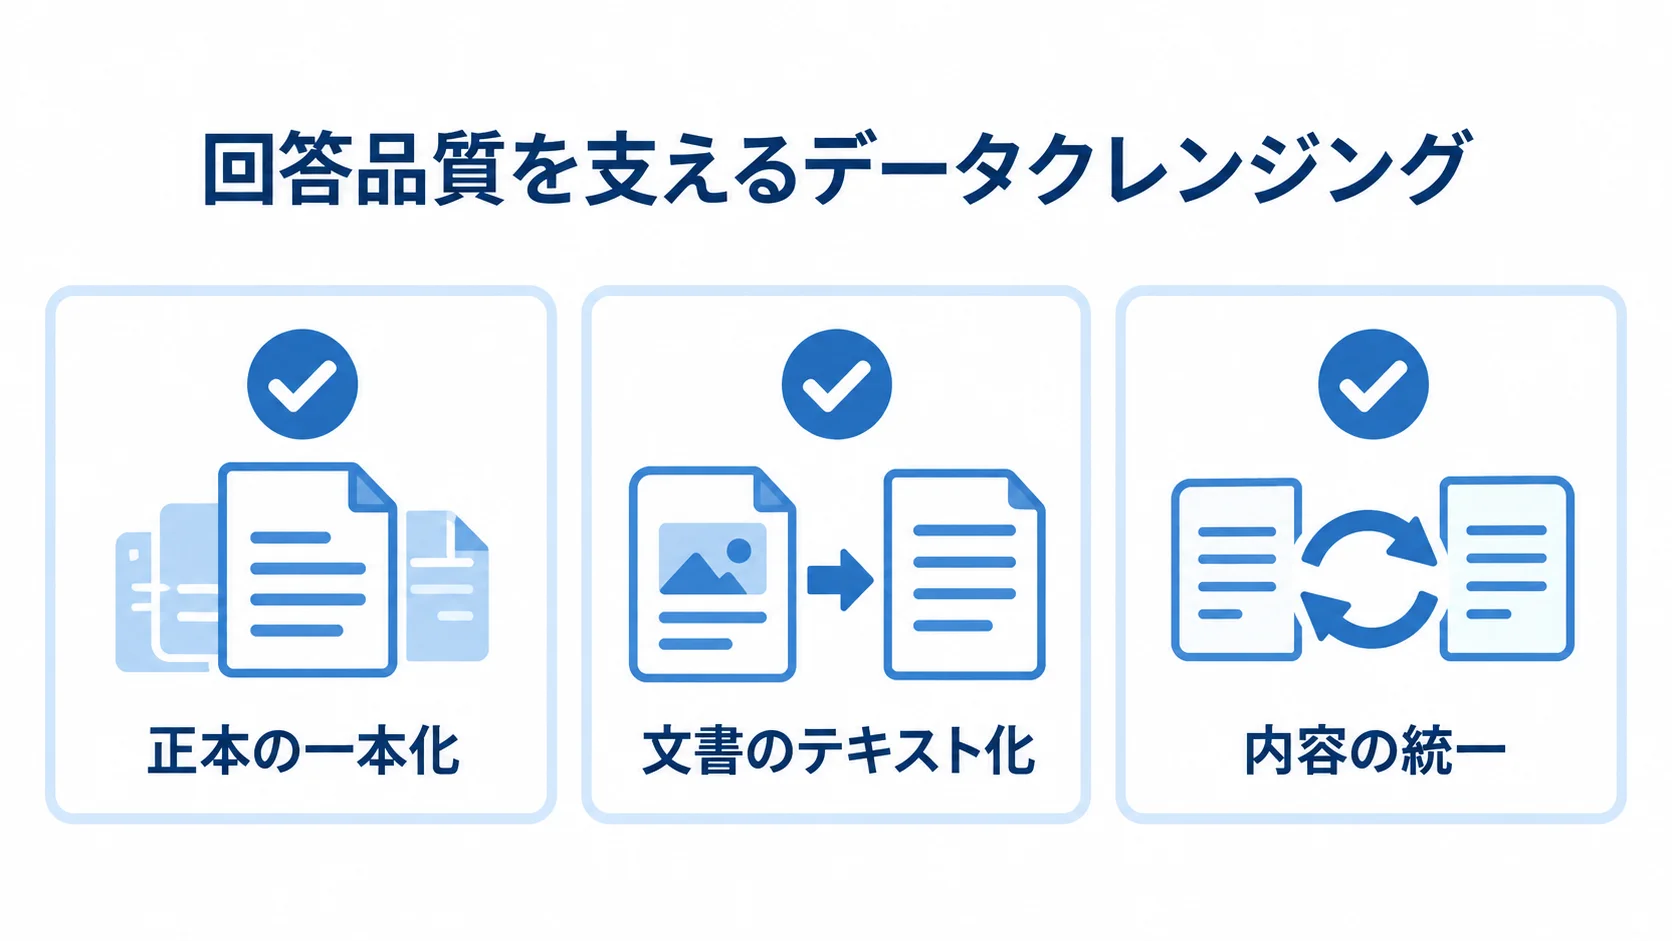
AIが正確に情報を検索できる状態にするには、文書を次の作業で整えます。
- 正本の一本化:最新版と旧版が混ざった文書の整理
- 文書のテキスト化:手書きPDFや画像の文書を、検索できる形にする
- 内容の統一:矛盾する記載や重複したFAQを洗い出す
データ準備を軽視してPoCに進むと、精度が出ずに頓挫するおそれがあります。だからこそ、十分な工数と期間を確保しておくことが、失敗を避ける対策になります。
構造化とデータ連携でつまずかない設計
クレンジングと並んで、データの構造化も欠かせません。分割の仕方や更新情報の扱いを、設計の段階で決めておきます。
- 文書の構造化:適切に分割し、見出しや項目の関係を保つ
- 参照元の特定:複数のシステムにある情報から、正本を選ぶ
- 更新フローの設定:反映の経路と、更新の担当者・時期
文書を区切る単位の設計は回答品質に直結します。長大な文書をそのまま入れると、AIが無関係な箇所を参照して、回答が外れることがあります。
データ連携の課題は、複数システムに散らばる情報を、AI FAQシステムにまとめて取り込む難しさから生じます。FAQは業務システムやファイルサーバー、グループウェアに分散しており、そのため、古い情報や矛盾した情報を参照しかねません。
連携設計を後回しにすると、せっかく整えたデータも古くなり、回答精度が下がります。こうした点から、構造化と連携の両面を設計することが、回答品質を長く保つ前提になります。
見落とされがちなセキュリティ・情報漏洩リスク
精度向上に集中するあまり、セキュリティや情報漏洩の検討を後回しにする例もあります。特に機密情報を扱うシステムでは、リスクが表に出た際に重大な損害につながります。
データ汚染とプロンプトインジェクションの脅威
社内文書を参照するAI FAQには、参照データが汚染されるという特有のリスクがあります。そのため、データの入口を管理することが欠かせません。
- 参照データのアクセス制御:編集できる人を必要な範囲に絞る
- 不正入力の検知・遮断:不正な指示が混ざるリスクへの備え
- 改ざん検知と確認:更新する人と手順を決め、チェックの体制を整える
BadRAG研究では、検索対象のわずか0.04%が汚染されただけで、プロンプトインジェクションの成功率が98.2%に達しました。さらに、一部の不正な指示によって、AIが攻撃者の意図どおりに動かされます。
精度の議論に偏ると安全設計が後回しになり、攻撃に無防備なシステムになりかねません。だからこそ、データの入口を管理することが、セキュリティと精度の両方を守る土台になります。
情報漏洩・ハルシネーション・著作権への備え
情報漏洩、誤回答、著作権の各リスクには、次のような備えを組み合わせます。
- 情報漏洩:部門や機密度に応じて、参照できる文書を制限する
- 外部AIの利用:入力データが学習に使われない契約や設定かを確認
- ハルシネーション:根拠を示し、対応が難しい質問は人の担当者へ引き継ぐ
- 著作権:参照する外部文書の情報源の確かめ
権限管理が不十分だと、アクセス権のない社員が機密情報を引き出すおそれがあります。また、生成AI特有のリスクは、構造的に捉えて一つずつ対策する必要があります。
誤答が業務判断や顧客対応に使われると、損害につながります。利用者には、AIの回答が参考情報であることを伝え、重要な判断では人が根拠を確認するルールを設けます。顧客向けや誤りの影響が大きい業務では、AIの回答をそのまま正解として扱わない仕組みが必要です。
備えないまま導入すると、利便性の裏でリスクを抱えたままになります。技術対策と利用ルールを組み合わせて、リスクを実務上許容できる水準まで下げます。
失敗を防ぐ評価と改善のサイクル
データ品質やセキュリティを整えても、評価と改善がなければ精度は上がりません。原因を定量的に切り分けて、改善を回す仕組みをつくる必要があります。評価で失敗原因を特定しないまま試行錯誤すると、プロジェクトは頓挫します。
Ragasによる失敗原因の定量的な切り分け
精度が出ないとき、AIモデルを新しくすれば改善すると考えるのは、典型的な落とし穴です。原因が検索、生成、元データのどこにあるかで、対策は異なります。
原因を切り分けずにモデルだけを変えても根本改善にはならず、PoC死を招きます。一方で、Ragasなどの評価フレームワークを使うと、原因を定量的に調べられます。
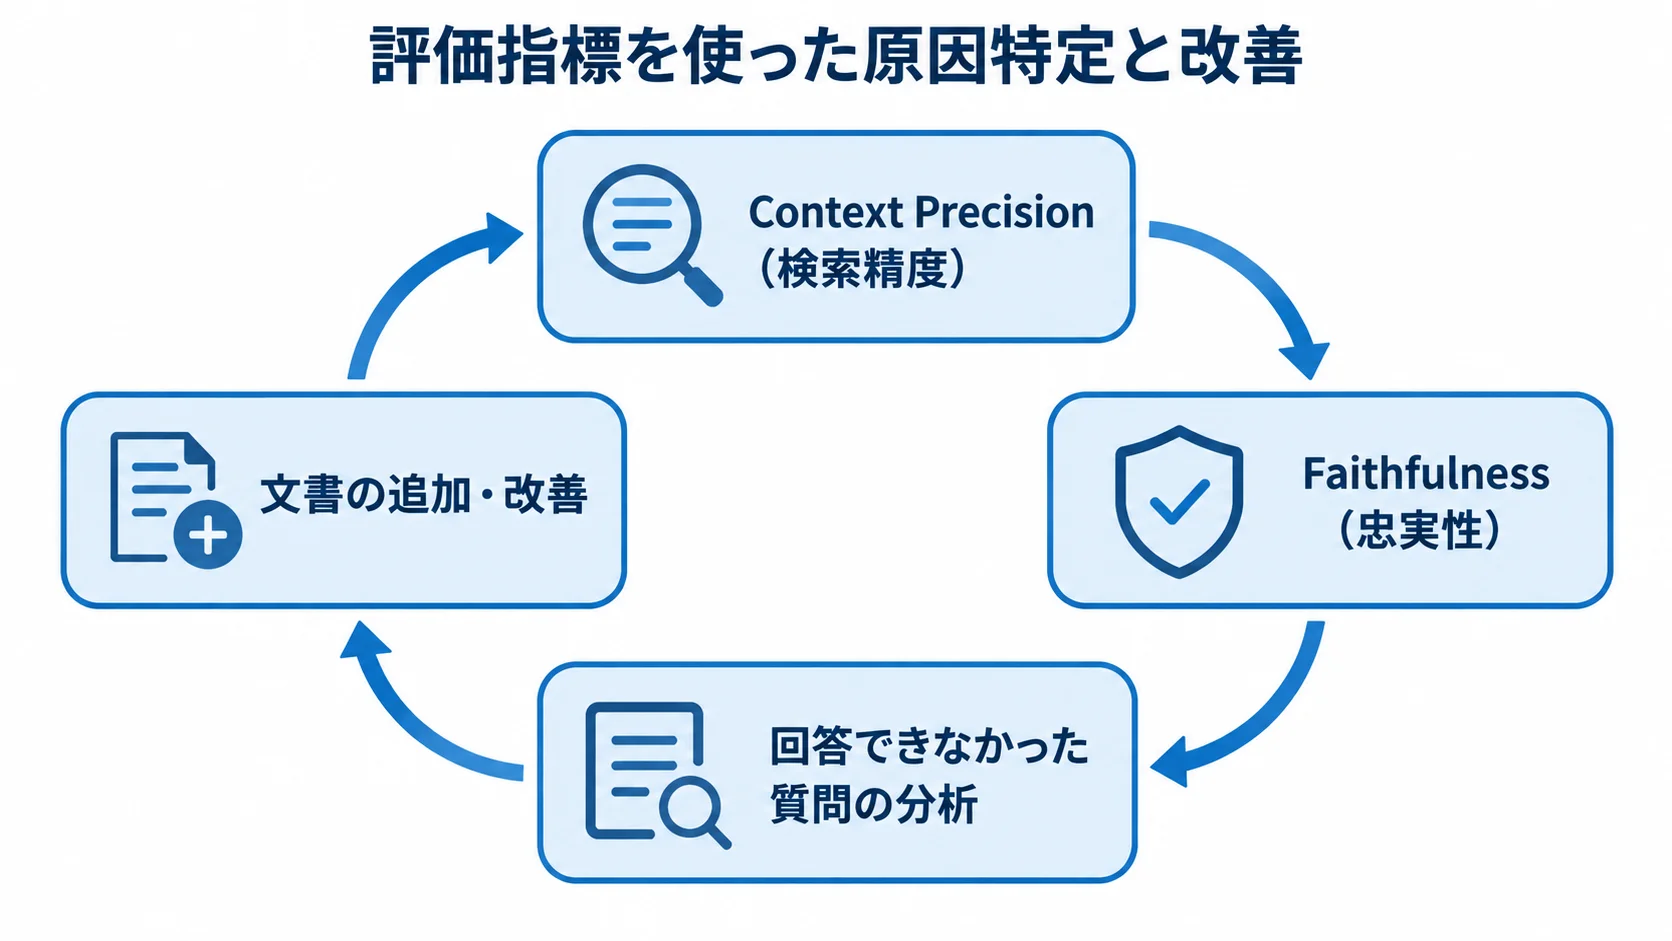
Ragasでは、検索文書の的確さを示すContext Precision(検索精度)を測定できます。また、回答が文書に忠実かを示すFaithfulness(忠実性)も、別々に測れます。
原因を見分けるには、指標と回答の状態を照らし合わせます。検索と生成のどちらを直すか、元データを見直すべきかを判断できます。
- 検索の問題:検索精度が低い
- 生成の問題:忠実性が低い
- 元データの問題:両指標が高くても回答が誤る
指標に応じて対策を選べば、闇雲な試行錯誤から抜け出せます。
計測せずに検索設定やプロンプト、モデルを変えると、時間や予算を浪費します。限られた工数を効果のある対策に集中させるには、計測に基づく改善が欠かせません。
低い指標に応じて打ち手を選べば、改善が空回りせず、本番に必要な精度へ近づきます。評価指標を最初から設計に組み込むことも、失敗を防ぐ備えになります。
改善を回す運用体制
運用体制では、改善サイクルを誰がいつ回すかを具体的に決めておきます。
- 回答できなかった質問を分析し、文書を追加・改善する担当者
- 回答できなかった質問や、Context Precisionが低い質問の週次の集計
- 月次の文書追加・修正で、改善を習慣にする
担当者や仕組みがないと、導入時の精度のまま改善が止まり、利用者に見限られることがあります。運用体制を用意しないことは、PoC死と並ぶ代表的な失敗パターンです。
評価で元データの問題がわかればクレンジングや構造化に戻り、汚染が疑われればデータの入口を見直します。一度で完成させるより、測定と改善を続けることが実用化への近道です。
まとめ
AI FAQシステムの失敗の最大要因はデータ品質です。Gartnerは、AIプロジェクトの60%が2026年までにデータ不足で失敗すると予測しています。
Canon ITソリューションズの調査では、RAG事例228件の成功は33%でした。失敗原因の46%は回答品質、42%はデータ連携に起因し、データ準備には工数の40〜60%を割くべきとの指摘もあります。
PoC死に加え、BadRAGのデータ汚染や情報漏洩、ハルシネーションも見落とせません。汚染が0.04%でも攻撃成功率が98.2%に達した研究結果があります。
RagasのContext PrecisionとFaithfulnessで原因を検索・生成・元データに分け、改善を続ける体制を整えます。
失敗の構造と対策を把握し、同じ失敗を避けるプロジェクト設計につなげることが大切です。
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。