
AI翻訳ツール開発の期間は、PoCで1〜3か月、中規模で3〜6か月、大規模で6〜12か月以上が目安です。
期間は言語ペアや専門用語、求める精度で変わり、要件と品質基準の合意からデータ準備、実装、評価へと進みます。開発方式、納期の短縮策、遅延対策も期間を読むうえで欠かせません。全体像はAI翻訳/自動翻訳ツール開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・AI翻訳/自動翻訳ツール開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
AI翻訳ツール開発の開発期間の全体像
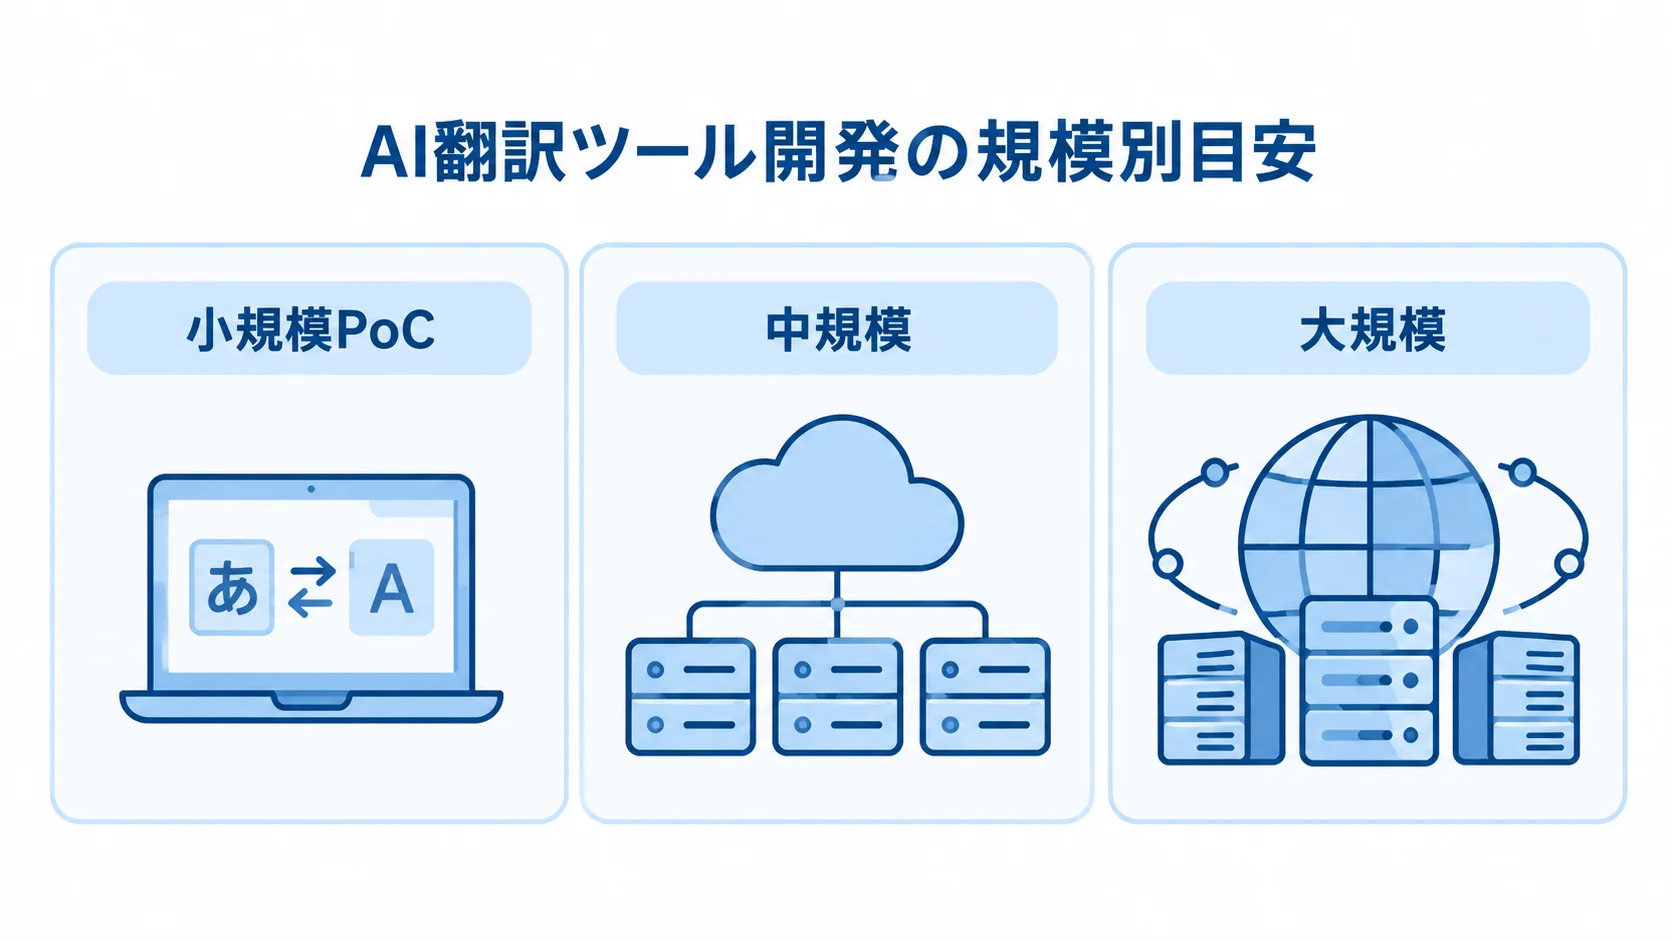
AI翻訳ツールの期間は、対応言語数、専門分野、連携範囲、求める精度によって変わります。だからこそ、規模別の目安をつかんでおくことが、計画の出発点になります。
PoC(概念実証)は1〜3か月・100万〜500万円、中規模は3〜6か月・500万〜1,500万円が目安です。一方、多言語や複数システムを扱う大規模開発は、6〜12か月以上・1,500万〜4,000万円程度です。
翻訳ツール開発では、期間の大部分は、実装よりも翻訳精度を業務水準に引き上げる調整に費やされます。この調整の工数は、汎用エンジンを使うか、自社向けに作り込むかで大きく変わります。
たとえば、DeepL API、Google Cloud Translation、OpenAIのLLMなどを呼び出す実装であれば、数週間で動くものを作れます。ただし、自社の専門用語や言い回し、トーンを訳文に反映させるには、用語集を整えたうえで対訳データによるファインチューニングが必要になります。品質評価と改善を含むこの調整が、期間とコストの大半を占めます。
期間を見積もる前に、求める精度、対象の言語ペア、利用する業務を発注側が明確にしておきます。これらが決まってはじめて、現実的なスケジュールを立てやすくなります。
規模別の開発期間と費用の目安
規模ごとの期間、体制、費用は次のとおりです。いずれも初期段階の概算です。
- 小規模PoC:1言語ペアで精度を検証。期間は1〜3か月、体制は1〜2名、費用は100万〜500万円です。
- 中規模:用語集や翻訳メモリを整備し、特定業務に導入。期間は3〜6か月、体制は3〜5名、費用は500万〜1,500万円です。
- 大規模:5言語以上と複数の業務システムに対応。期間は6〜12か月以上、費用は1,500万〜4,000万円です。
PoCでは、既存APIやオープンソースのNMTモデルを使って、自社文書の翻訳精度を測ります。中規模では、EC商品説明やマニュアルへの組み込みが対象になります。
中規模のチームには、プロジェクトマネージャー、機械学習とバックエンドのエンジニア、翻訳品質の担当者を含めます。大規模になると、リアルタイム翻訳APIやポストエディットの仕組みも対象に入ります。
大規模開発は、EC、マニュアル、チャット、社内文書への横断的な組み込みを含みます。正確な期間は、要件定義と小規模PoCを経てから確定します。
翻訳ツール固有の期間変動要因
同じ中規模でも、3か月で終わる場合と6か月かかる場合があります。その差を左右する条件は次の4つで、見積もりではこれらを確認します。
- 言語ペア:数と難易度によって、評価と調整の工数が変わります。
- 専門用語:用語集や翻訳メモリの整備範囲が、データ準備の工数を左右します。
- 処理方式:リアルタイム翻訳は、バッチ処理より工数が20〜30%増える傾向です。
- 求める精度:必要な精度と、人手でポストエディットする範囲によって運用設計が変わります。
日英は対訳データが豊富なため、高精度を出しやすい傾向があります。一方、日本語と東南アジア言語のようにデータが少ない組み合わせでは、品質を保つためのデータ収集や調整に時間がかかります。さらに、言語ペアが増えるたび、評価と調整の工数も積み上がります。
医療、法務、製造、ITなどでは、汎用エンジンが専門用語を誤訳することがあります。
チャットやコールセンターのリアルタイム翻訳では、応答速度への対応とインフラ設計が必要になります。そのうえで、精度とポストエディットの範囲も見積もりの段階で洗い出し、楽観的すぎない期間を設定します。
工程別スケジュールと期間配分
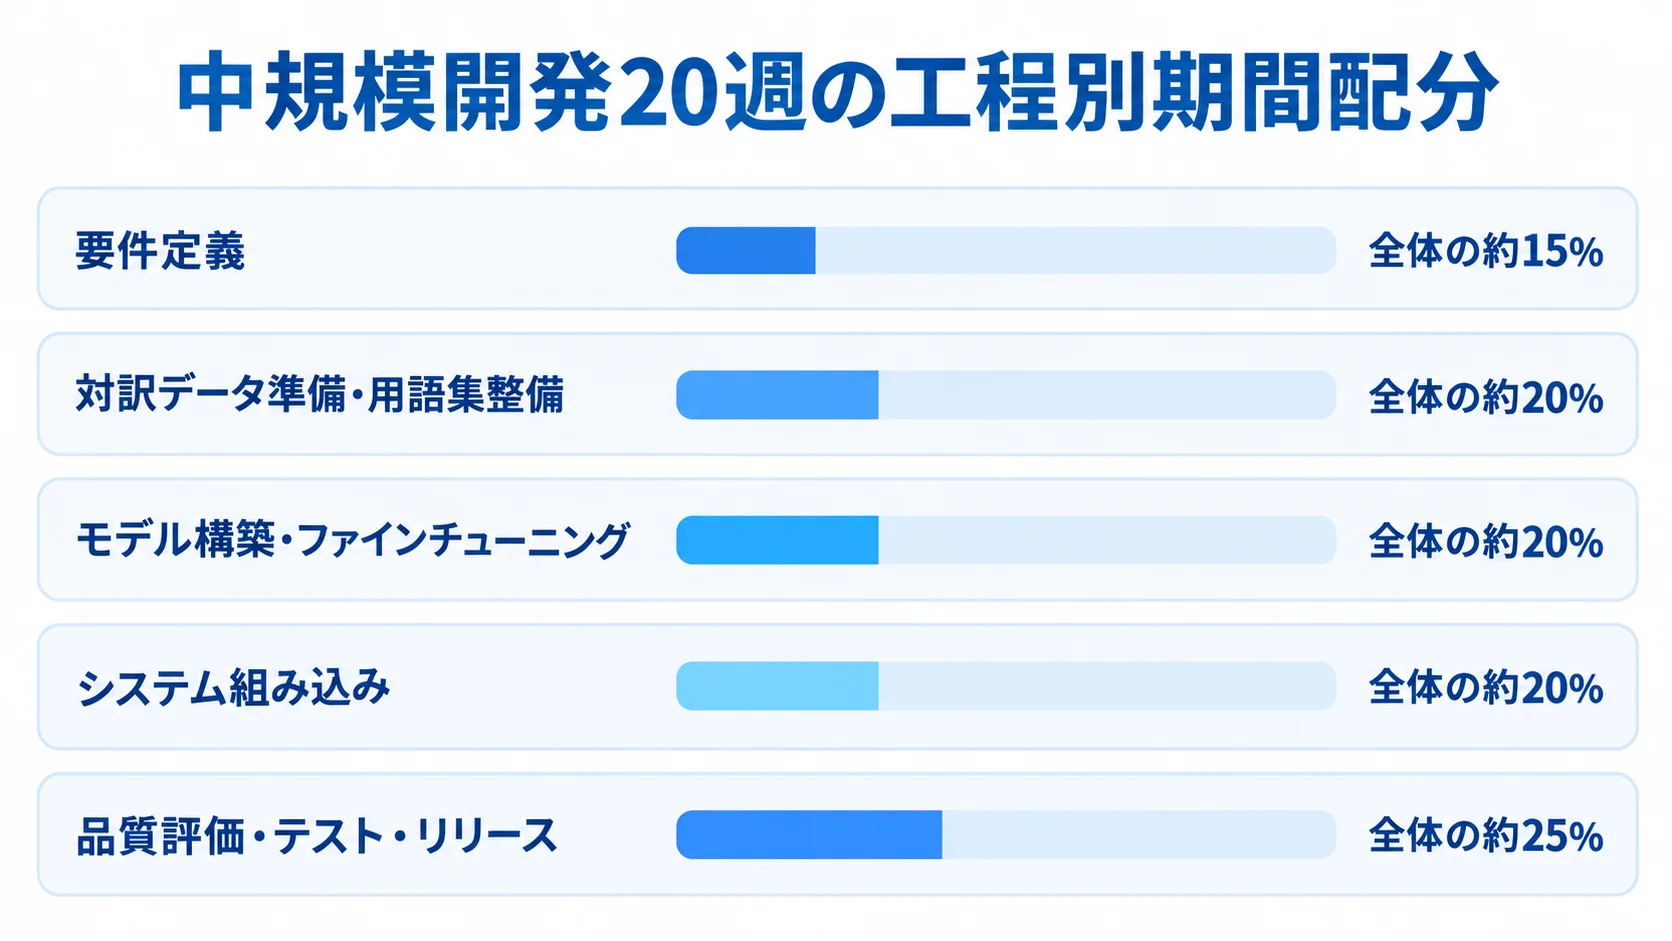
中規模の約5か月、20週の開発では、要件定義からリリースまでの5工程に、次の割合で期間を割り振ります。
- 要件定義:全体の約15%。
- 対訳データ準備・用語集整備:約20%。
- モデル構築・ファインチューニング:約20%。
- システム組み込み:約20%。
- 品質評価・テスト・リリース:約25%。
通常のシステム開発と比べて、データ準備と品質評価の比重が大きくなります。品質評価の期間がほとんどない見積もりでは、リリース後に翻訳精度の問題が起きるおそれがあります。期間を正しく見積もるには、全体を工程に分けて各工程に必要な週数を把握し、この配分と照らし合わせることで、各社のスケジュールの妥当性を判断しやすくなります。
要件定義・対訳データ準備フェーズ(約7週・35%)
20週の計画では、要件定義に約3週、対訳データ準備と用語集整備に約4週を割り当てます。前半で対象と評価方法を定めたあと、学習と参照に使うデータを整えます。
- 要件定義:対象の言語とコンテンツ、精度指標、処理と連携の方式を決めます。
- データ準備:過去の翻訳資産、用語集、翻訳メモリを整えます。
対象コンテンツには、商品説明、マニュアル、チャット、契約書などがあります。加えて、リアルタイムかバッチか、既存システムとどう連携するかも決めます。
発注側と「どの用語をどう訳すか」を、早い段階で合意しておきます。そのうえで、過去の訳済みマニュアルや翻訳会社への発注履歴を集め、原文と訳文の対訳コーパスを整備します。
用語集には、業界用語、製品名、禁止表現をまとめます。あわせて、過去の翻訳を再利用する翻訳メモリ(TM)も構築します。
データ不足が分かると全体が遅れるため、キックオフ直後から棚卸しを始めます。データ準備は、品質を左右する重要な工程です。
モデル構築・システム組み込みフェーズ(約8週・40%)
モデル構築とファインチューニングに約4週、既存システムへの組み込みに約4週を割り当てます。この期間に、エンジンの調整と業務フローへの接続を進めます。
- モデル構築:エンジンを選び、用語集を適用し、必要に応じて追加学習します。
- システム組み込み:翻訳エンジンを既存業務システムにつなぎます。
ベースのエンジンには、既存API、オープンソースNMT、LLMがあります。また、用語集オーバーライドや、翻訳メモリの一致率に応じた既訳の再利用も、この工程で実装します。
ECサイトでは、商品マスタの多言語フィールドに翻訳結果を自動で反映します。マニュアル管理では一括翻訳バッチを、チャットではリアルタイム翻訳APIを組み込みます。
翻訳結果を人が確認・修正するポストエディット画面の有無で、工数は変わります。さらに、APIを疎結合に設計しておくと、業務システムとエンジンを並行して開発できます。
翻訳品質評価・テスト・リリースフェーズ(約5週・25%)
翻訳品質評価は、翻訳ツールに特有の工程です。評価とテストに約3週、リリース準備と受入テスト(UAT)に約2週を割り当てます。
- 自動評価:BLEUやCOMETで参照訳との一致度や意味の近さを測ります。
- 人手評価:対象言語のネイティブや翻訳担当者が訳文を確認します。
- 受入テスト:実業務データで修正時間が許容範囲か確かめます。
人手評価では、重要用語の誤訳、意味の反転、業務に合うトーンかを確認します。自動指標だけでは実務品質を保証できないため、人手で見ることで担保します。
品質評価を削ると、リリース後に誤訳による業務トラブルやブランド毀損が起こり、結果として総コストと期間が膨らむおそれがあります。そのため、全体の約25%を確保するのが現実的です。
開発アプローチによる期間の違い
開発アプローチによって、初回リリースまでの期間は変わります。精度、機密性、予算に合う方式を選ぶことが、納期計画の出発点になります。
- 既存翻訳API活用型:既存エンジンを業務システムにつなぐ方式です。
- ドメイン特化型:自社の対訳データで追加学習する方式です。
- 独自NMTフルスクラッチ型:独自の翻訳エンジンをゼロから構築する方式です。
既存翻訳API活用型の短納期パターン
短納期で実現しやすいのは、既存翻訳API活用型です。DeepL API、Google Cloud Translation、Amazon Translateを利用できるほか、OpenAIやAnthropicのLLMなどもAPIで呼び出せます。
- 期間:1〜2言語ペアの中規模ツールで2〜4か月が目安です。
- 主な作業:用語集の整備と業務システムへの連携に集中できます。
既存エンジンの精度を土台にするため、モデル用のデータ収集や学習が不要になります。近年のLLMは、用語集と文体をプロンプトで指定することで、ファインチューニングなしでも一定のドメイン適応を実現できます。
金融業では、NTTドコモビジネスの「COTOHA Translator」を導入し、運用レポートの翻訳を従来の10倍に高速化した事例があります。このように、既存エンジンでも短期間で業務効果を得られる場合があります。
一方で、機密データを外部APIに送れない場合や、既存エンジンの精度が要件に届かない場合は、追加学習型や独自NMT型を検討します。
ドメイン特化ファインチューニング型の期間
この方式は、オープンソースNMTモデルやLLMに自社の対訳データを追加学習させるものです。専門用語が多く、汎用エンジンで誤訳が頻発する医療、法務、特許、製造などで採用されます。
- 期間の目安:中規模で4〜7か月です。API活用型と比べると、2〜3か月ほど長くなります。
- 追加工程:データ整備、学習、評価、精度改善を繰り返します。
まず対訳データの収集とクレンジング、学習データセットの構築を行います。そのうえで、ファインチューニングを実行し、評価を進めます。評価のあとにデータを追加して再学習する精度改善ループを、数回回すのが一般的です。
改善ループの回数が、スケジュールと精度のバランスを左右します。また、LLMに用語集や参考訳を文脈として与えるRAG(検索拡張生成)型翻訳なら、フルの追加学習をせずに専門分野へ適応できる方法もあります。
RAG型翻訳は、学習コストと期間を抑えながら専門精度を高める選択肢になります。必要な精度と、投じられる期間・予算に応じて、追加学習の深さを決めます。
納期を短縮する具体的な方法
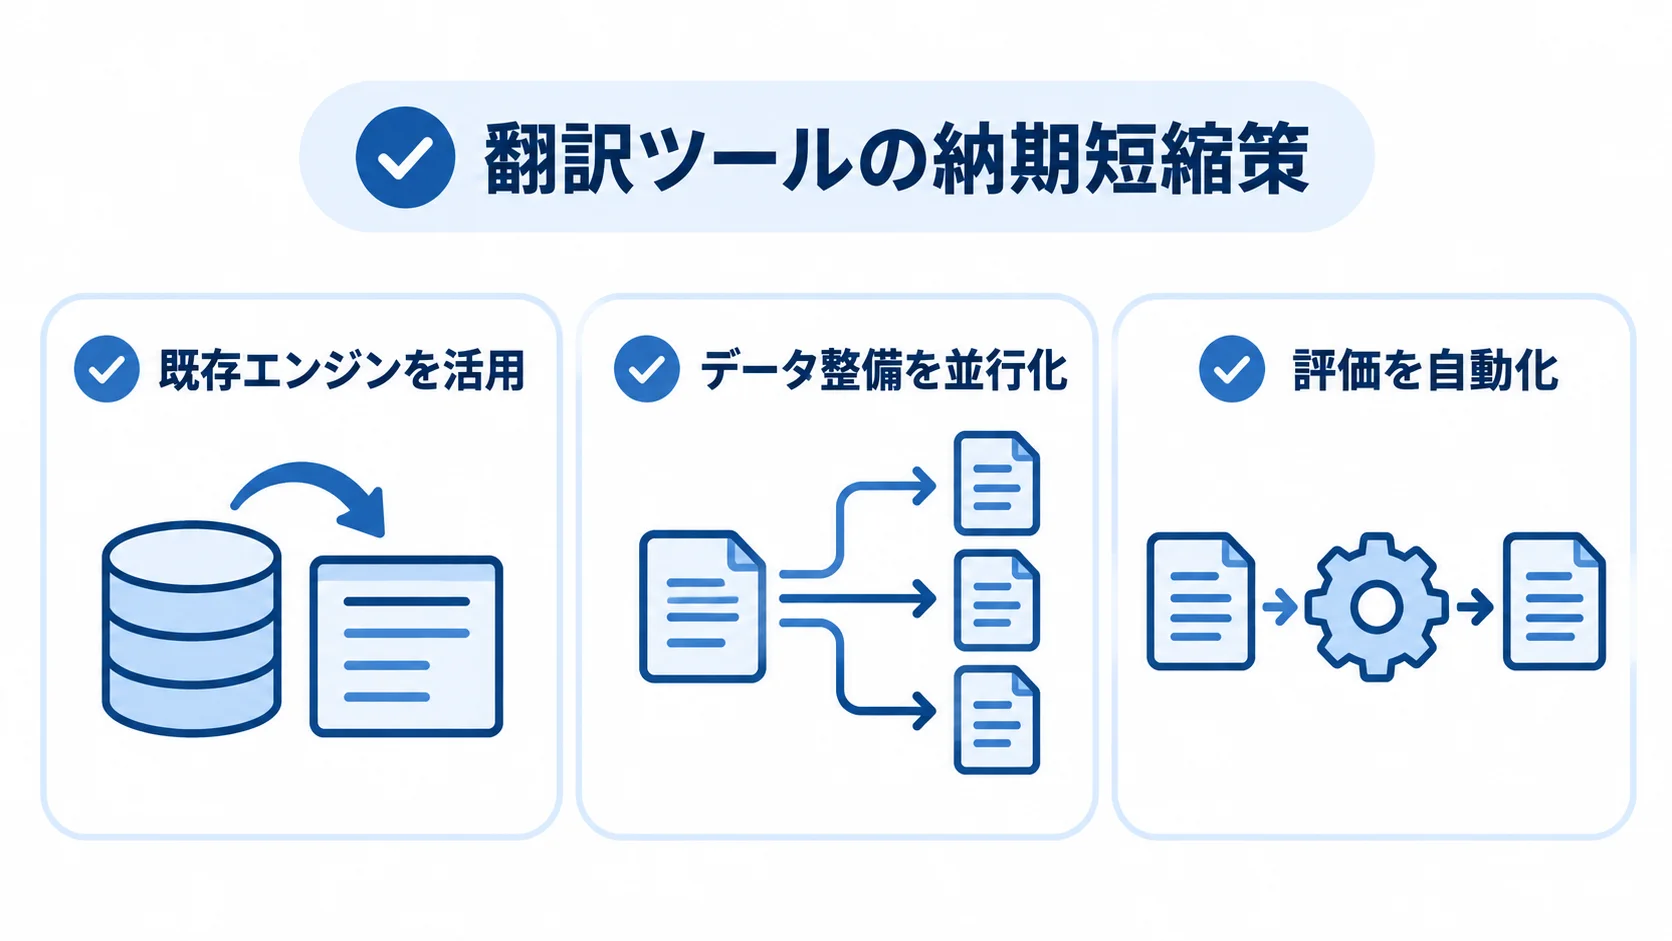
人を増やすだけでは、翻訳ツールの納期は短縮できません。精度を保って期間を縮めるには、対訳データの質と評価サイクルに着目した工夫が必要です。
- 既存エンジンを活用:用語集を加え、足りない部分だけ追加学習やRAGで補います。
- データ整備を並行化:システム開発と同時に翻訳資産や用語集を準備します。
- 評価を自動化:自動スコアと評価画面で改善サイクルを速めます。
既存エンジンと用語集機能の活用
既存エンジンの品質を確かめ、自社向けに追加調整する範囲を決めます。
- 既存エンジン:DeepLやGoogle、LLMは大量データで訓練され、汎用翻訳の精度が高水準です。
- 自社向けの調整:既存の精度に、自社ドメインの用語や文体を加える作業に集中します。
- 用語集機能:APIのglossaryで訳語を固定し、重要用語の誤訳を防ぎます。データ準備と学習も短縮できます。
- 段階的な精度向上:実運用の品質を検証し、不足部分だけをファインチューニングやRAGで補い、不要な学習工数を抑えます。
対訳データ整備の並行化と評価の自動化
対訳データと用語集の整備は、システム開発と並行して進めます。データ待ちによる停滞を避けるため、発注側の担当者もキックオフ直後から作業に加わります。
- データ準備:翻訳資産の棚卸し、用語集作成、確認ルールの合意を行います。
- 品質評価:自動スコアの算出と人手評価の作業を効率化します。
データ整備には、業務部門の協力が欠かせません。そのため、専任の担当者を置き、エンジニアがエンジンやシステムを実装している間に準備を進めます。
開発初期にBLEUやCOMETの算出の仕組みを整えておくと、更新のたびにワンクリックで精度を測れます。さらに、改善サイクルも速く回せます。
人手評価では、対象文を効率よく抽出して提示する画面を用意します。これにより、レビュアーの負担が減り、評価を短期間で終えられます。
データ準備と評価を並行化・自動化することで、翻訳ツール特有のデータ待ちや評価待ちによる停滞を防ぎます。
納期遅延の典型要因と対策
綿密に計画していても、翻訳ツール開発には固有の遅延リスクがあります。そこで、契約や進捗管理に対策を組み込めるよう、代表的な要因と対策を確認します。
翻訳品質基準の曖昧さと合意
合格基準が曖昧なまま開発を進めると、主観的な修正要求が続いて、リリースが遅れます。そのため、開発初期に、測定できる基準を具体的に決めておきます。
- 用語の基準:用語集に載せた重要用語の誤訳がないこと。
- 自動評価の基準:BLEUスコアなどの目標値を設定します。
- 修正時間の基準:原文1,000文字あたりの許容時間を定めます。
機械翻訳は完璧ではないことを発注側と共有し、人手のポストエディットで最終品質を担保する運用に合意します。機械翻訳だけで100点を求めると、精度改善が終わらず、納期が延びてしまいます。そこで、機械翻訳で8割を訳し、人が2割を仕上げるといった役割分担を明確にすると、現実的な納期に収まりやすくなります。
対訳データ・用語集準備の遅延とバッファ確保
データ準備の遅れや言語ごとの品質差は、全体の納期を押し延ばす要因になります。そこで、早期に棚卸しを行い、まず主要言語をリリースして影響を抑えます。
- データ不足:要件定義と同時に棚卸しし、全体工数の10〜15%を予備期間にします。
- 言語ごとの品質差:言語ペアに優先順位をつけ、難しい言語は後続段階に回します。
過去の翻訳資産が別々のファイルに散らばっていたり、部署ごとに用語が異なっていたりすると、データの整備に時間がかかります。そのため、使えるデータの量を早い段階で確定させます。
日英では高品質でも、マイナー言語では精度が出ず、追加調整が必要になる場合があります。そのため、言語ごとの差を最初から計画に織り込んでおくことが欠かせません。
言語ごとのクリティカルパス(遅れが全体の納期に響く作業の流れ)をガントチャートで一覧にし、週次で進捗を確認します。遅れの兆候があれば、スコープや優先順位を調整して、遅延を管理します。
まとめ
AI翻訳ツールの目安は、PoCが1〜3か月、中規模が3〜6か月、大規模が6〜12か月以上です。
20週の中規模開発では、要件定義15%、データ準備20%、モデル構築20%、組み込み20%、評価などに25%を配分します。
実装よりも、対訳データや用語集の準備と、翻訳品質の評価・改善に多くの期間を要します。既存エンジンを使い、用語集で自社向けに調整しながら段階的に進める方法は、納期の短縮につながります。
品質基準は数値で合意し、ポストエディットを前提に運用を設計します。あわせて、データ準備を並行して進め、全体工数の10〜15%を予備期間として確保します。
翻訳精度と納期のバランスを取った計画が、プロジェクトを成功に導く鍵です。
具体的なスケジュールを検討する際は、小規模PoCで自社データの翻訳精度を確かめることから始めます。
▼全体ガイドの記事
・AI翻訳/自動翻訳ツール開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。