
AI翻訳ツール開発は、実データでPoCを行って精度を確かめ、画面と業務フローを試作したうえで、基準に沿って本開発への移行を判断するのが基本の流れです。
ニューラル機械翻訳(NMT)や大規模言語モデル(LLM)は汎用文なら高精度ですが、専門用語や独自表現では期待した品質が出ないことがあるため、この順で進めると技術と業務のリスクを抑えられます。
▼全体ガイドの記事
・AI翻訳/自動翻訳ツール開発の完全ガイド
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
翻訳ツールにおけるPoCの位置づけと目的
PoC(Proof of Concept=概念実証)は、本格開発の前に実現性や効果を小規模に検証する取り組みです。翻訳ツールでは、自社が求める精度で訳せるかを実データで確かめます。
汎用ベンチマークで高スコアのエンジンでも、自社の専門文書では用語の誤訳が頻発することがあります。一方で、既存APIに用語集を組み合わせるだけで、予想以上の品質が出る場合もあります。
PoCを使うと、試すまで分からない翻訳品質の不確実性を、少ないコストで早い段階に解消できます。PoCを省くと、数千万円を投じたあとに業務で使える精度が出ないと判明しかねません。
PoCでは、まず小さく試して精度の見通しを立て、本開発の可否を決める段階的な進め方が有効です。
翻訳ツールにPoCが必要な理由
翻訳品質は、対応言語や専門分野、対訳データの量と質によって左右されます。汎用エンジンの性能が、自社の業務にもそのまま当てはまるとは限りません。
PoCで確かめる観点は、実データでの精度と、運用に必要な人手です。
- ドメイン適合性:少量の実データで自社分野の精度を測る
- 修正の必要量:機械翻訳のみで使える範囲と、人の修正が要る範囲
- 運用モデル:人がポストエディットする範囲
一般的な日英翻訳が高精度でも、自社製品の技術用語や業界特有の略語・表現では誤訳が増えることがあります。一方で、既存APIに用語集を組み合わせるだけで品質が上がる場合もあるため、構成によって結果は変わります。
運用設計は品質とコストを左右するため、PoCで機械翻訳のみの実力や人手修正の量を体感し、現実的な運用を見通します。
PoCは数十万円〜数百万円の投資で、数千万円規模の本開発の可否と方向性を見極められます。PoCを挟まずに本開発へ先に進むと、開発後に業務で使える精度が出ないと判明するおそれがあります。
PoC・プロトタイプ・モックアップの違い
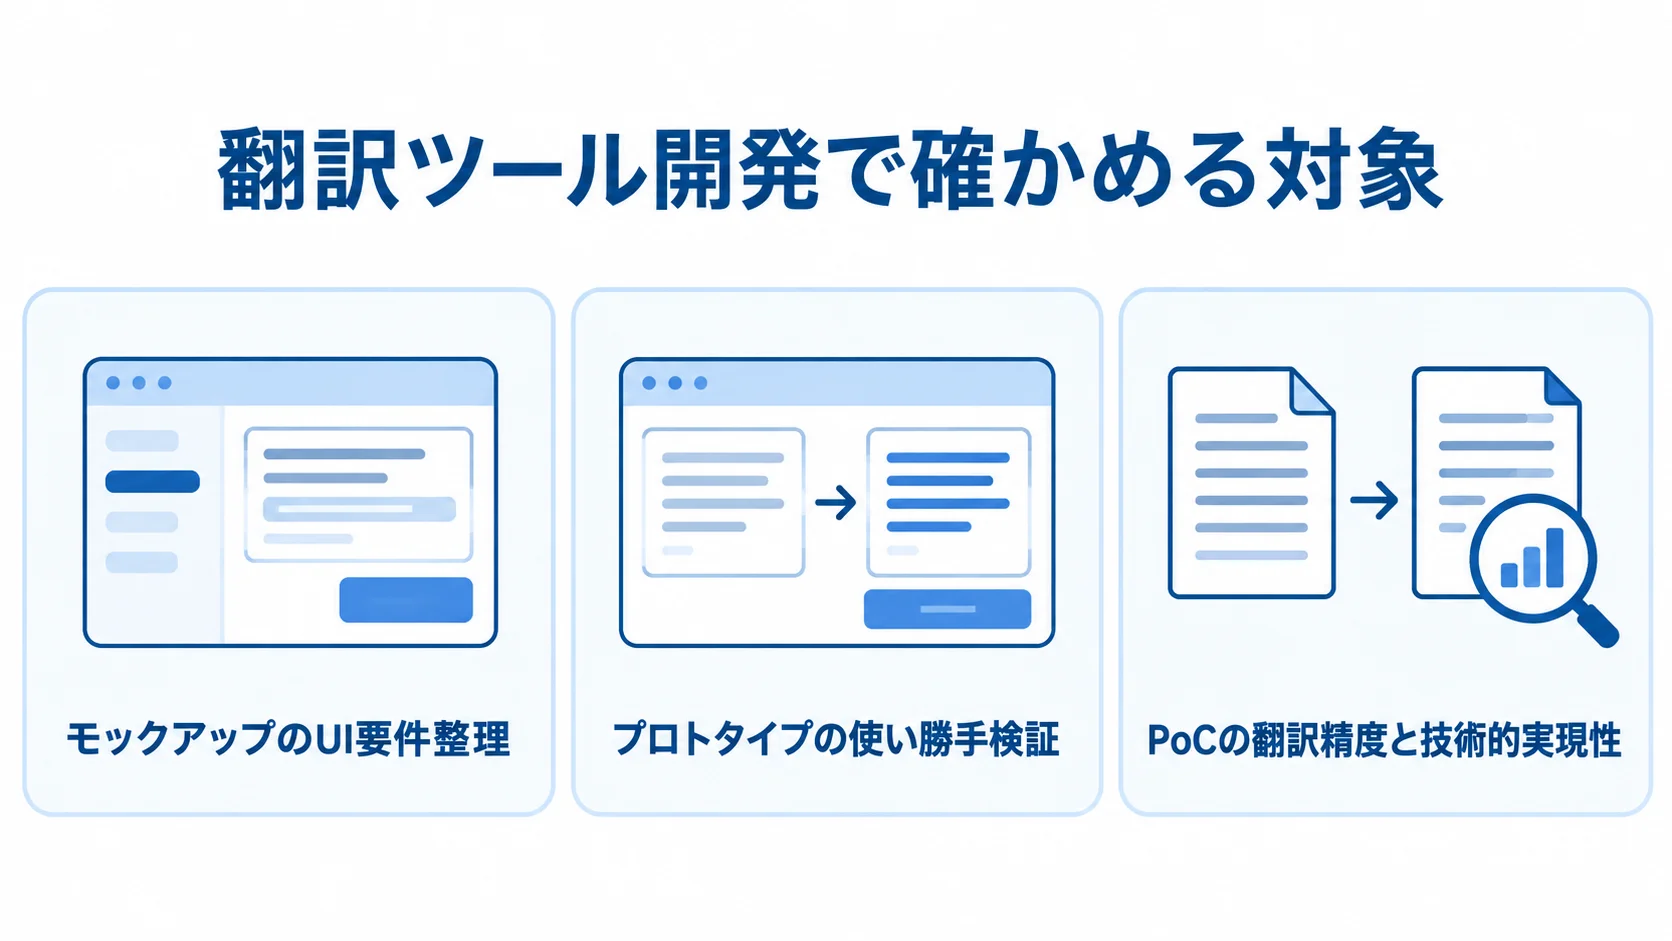
3つの手法は、翻訳ツール開発で確かめる対象がそれぞれ異なります。目的に応じて使い分けると、技術面と業務面の適合性を本開発の前に確認できます。
- モックアップ:画面や操作の流れを共有し、UI要件を固める
- プロトタイプ:限定的に動く試作品で、使い勝手を確かめる
- PoC:翻訳精度が業務水準に届くかを、技術面から検証する
モックアップでは翻訳機能は動きません。一方、プロトタイプでは、文章入力に翻訳結果を返すなど一部の機能を実際に動かします。
PoCは、翻訳精度が業務水準に届くかという技術的な実現性と有効性を確かめることが主目的です。画面の美しさよりも、翻訳結果を評価指標で測ります。
まず精度の見通しを確かめ、その後に画面や業務フローを詰める順序が効果的です。
翻訳PoCで検証すべき項目
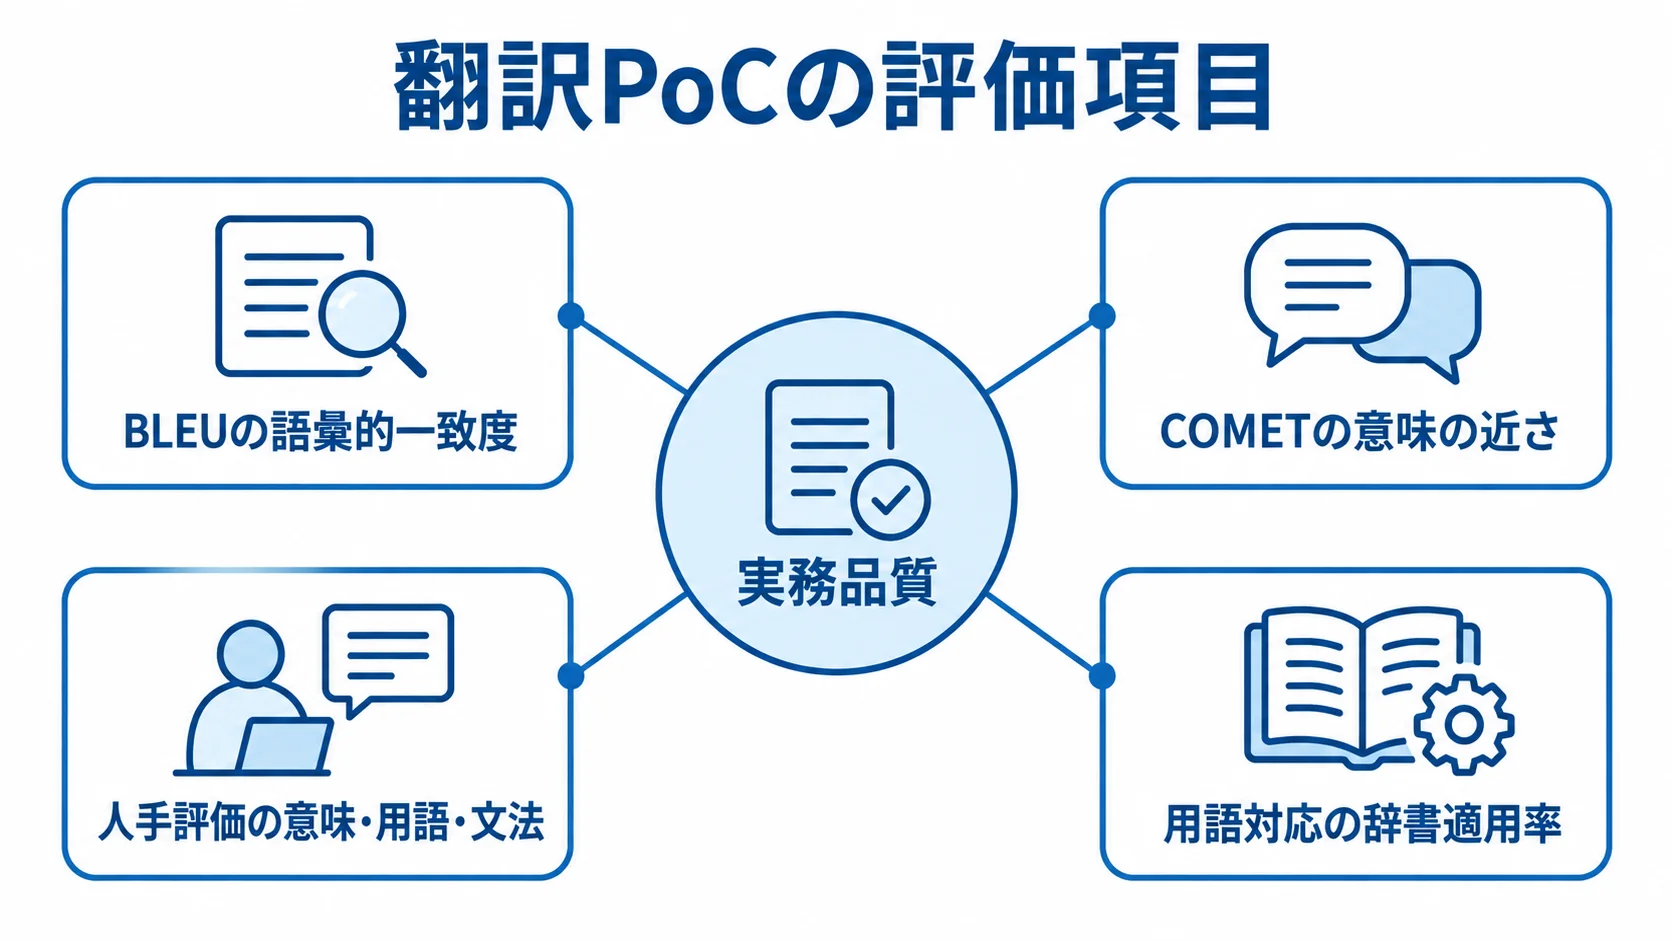
PoCを成功させるには、何をどう測るか、合格ラインはどこかを先に決めておく必要があります。評価項目が明確であれば、結果を客観的に判断できます。
翻訳精度の評価指標と専門用語対応
翻訳精度は、自動評価指標と人手評価を組み合わせて確かめます。比較する構成と評価の観点をそろえておくと、結果を同じ条件で比べられます。
- BLEU:機械翻訳と参照訳の語彙的な一致度を測る
- COMET:翻訳文と参照訳の意味の近さを捉える
- 人手評価:意味、用語、文法、敬体、業務トーンを採点する
- 用語対応:辞書適用率と、製品名・業界用語の誤訳を確かめる
BLEUやCOMETのスコアを算出すれば、複数のエンジンや用語集の有無、調整前後の構成を客観的に比べられます。
自動指標の数値が高くても、実務で使えない場合があります。そのため、対象言語のネイティブや翻訳担当者による評価も必要です。
特に専門用語の対応度を重視します。誤訳は信用問題につながるため、重要語の誤訳ゼロを必須とするのが一般的です。
汎用エンジン単体、用語集あり、ファインチューニング前後などの構成を比べ、必要な精度に届く構成を見極めます。
言語ペア別の品質と実業務データでの実用性
言語ペアごとに翻訳品質が大きく異なるため、多言語対応では組み合わせごとにPoCで確かめる必要があります。その結果は、運用設計とコスト試算に直結します。
- 言語ペア:対応予定の全組み合わせで品質を測る
- 現場データ:商品説明、マニュアル、チャットログで試す
- 修正工数:人によるポストエディット時間を記録する
対訳データが豊富な日英や英中は高精度を出しやすい一方、データの少ない言語との組み合わせは品質が低くなりがちです。そこで、機械翻訳のみで運用できる言語と、修正が必須の言語を切り分けます。
実データには特有の難しさがあります。表記ゆれや専門用語、口語のほか、箇条書きや表組みも含まれます。
ポストエディット工数は、業務効率化を判断するうえで欠かせない指標です。機械翻訳なしの場合と比べ、時間短縮をPoCで実測します。
翻訳PoCの進め方と期間・費用
翻訳PoCの目的は、限られた期間と予算で判断材料を得ることです。そのため、少量データでの検証方法と体制を先に決め、期間と費用も事前に見積もっておきます。
少量の対訳データでの精度検証手法
大量のデータをそろえる必要はありません。そこで、実業務を代表する少量の対訳データを使い、自社ドメインの傾向を調べます。
- 実業務から、数百〜数千件程度の原文を抽出する
- 翻訳担当者に、正解訳を用意してもらう
- 出力と正解訳を比べ、指標と人手で評価する
- 学習効果を見る場合は、データを学習用と評価用に分ける
評価用データセットで、BLEUやCOMET、用語適用率、人手評価を測ります。学習前後を比べると、ファインチューニングによる精度向上も確認できます。
PoCの評価では、数百〜数千件の規模でも、用語集で誤訳が減るか、特定分野でファインチューニングが頭打ちになるかといった示唆を得られます。
なお、評価データは実業務の文章の難易度分布に合わせます。簡単な文ばかりでは精度が高く見え、難しい文ばかりでは低く出すぎて、結果の信頼性が下がります。
PoCの期間・費用・体制の目安
期間と費用は、PoCの範囲や比較する翻訳構成によって変わります。
- 期間:全体で1〜2か月程度
- 軽量なPoC:既存APIや用語集を使い、100万〜300万円程度
- 体制:エンジニア1〜2名と翻訳品質の評価担当者
対訳データの準備に2〜3週間、構成の実装と測定に2〜3週間、分析と報告に1週間程度を見込みます。なお、ファインチューニングを含む複数構成の比較は、軽量なPoCより費用が高くなります。
評価担当者は、社内の翻訳担当や対象言語のネイティブです。翻訳の良し悪しは技術者だけでは判断しにくいため、業務側の参加がPoCの質を左右します。
報告では、構成別の精度比較や専門用語の対応状況、言語ペア別の品質を示し、ポストエディットの実測値も残します。そのうえで、本開発の推奨方法と概算の費用・期間も添え、Go/No-Go判断の材料にします。
PoCの最大の価値は、少額の投資で、本開発への巨額の投資を確度高く判断できる点です。
プロトタイプ・モックアップの作り方
PoCで精度の見通しが立ったら、試作を通じて、翻訳ツールを業務にどう組み込むかを具体化します。画面と業務フローの使いやすさも、あわせて確かめます。
翻訳エンジンの品質が高くても、画面が使いにくかったり業務フローに合わなかったりすると、現場に定着しません。
翻訳画面・用語集管理画面のモックアップ
モックアップでは、翻訳作業画面と用語集管理画面の要件を、実際の担当者と確認しながら固めます。
- 翻訳作業画面:原文・訳文、修正欄、履歴、確定操作を配置する
- 翻訳メモリ:一致候補の見せ方を翻訳担当者と決める
- 用語集管理画面:用語と訳語の登録・編集・検索を設計する
- 運用管理:分野、ステータス、承認フローの設計
原文・機械翻訳・修正欄の配置は、翻訳者の作業効率を左右します。さらに、用語集は、業務部門が自分で用語を追加・修正できる使いやすさが、運用定着の鍵になります。
モックアップはFigmaなどで作成します。機能は動かなくても、要望や面倒な操作を早期に把握でき、開発前に画面の認識を合わせることで、実装後の大きな作り直しを防げます。
プロトタイプによる業務フローの検証
画面イメージを固めたら、翻訳が動く試作品を業務フローに沿って使ってみます。たとえば、PoCで有望だった既存APIと用語集の組み合わせを取り入れ、原文を入力すると翻訳結果が返る状態を作ります。
ECサイトなら、商品情報の登録から多言語説明文の生成、担当者による確認・修正、公開までを関係者に試してもらいます。
- 確認・修正:翻訳結果を直す時間と手間を調べる
- システム連携:既存システムとのデータ連携を確かめる
- 現場運用:用語集の更新が業務に乗るかを試す
この検証で、机上では気づけなかった実務上の課題を見つけられます。ECやマニュアル、チャットなど既存の業務システムに組み込む想定なら、連携部分の実現性も簡易に確かめておきます。
試作品には、本番品質のコードや網羅的なエラー処理は求めず、動かして業務に組み込める手応えを確かめます。こうした気づきを要件に反映すると、本開発の精度と成功確率が高まります。
PoCから本開発への移行判断(Go/No-Go)
PoCとプロトタイプの目的は、本開発へ進むかどうかを判断することです。事前に決めた基準を使い、結果を冷静に評価します。
Go/No-Goの判断基準
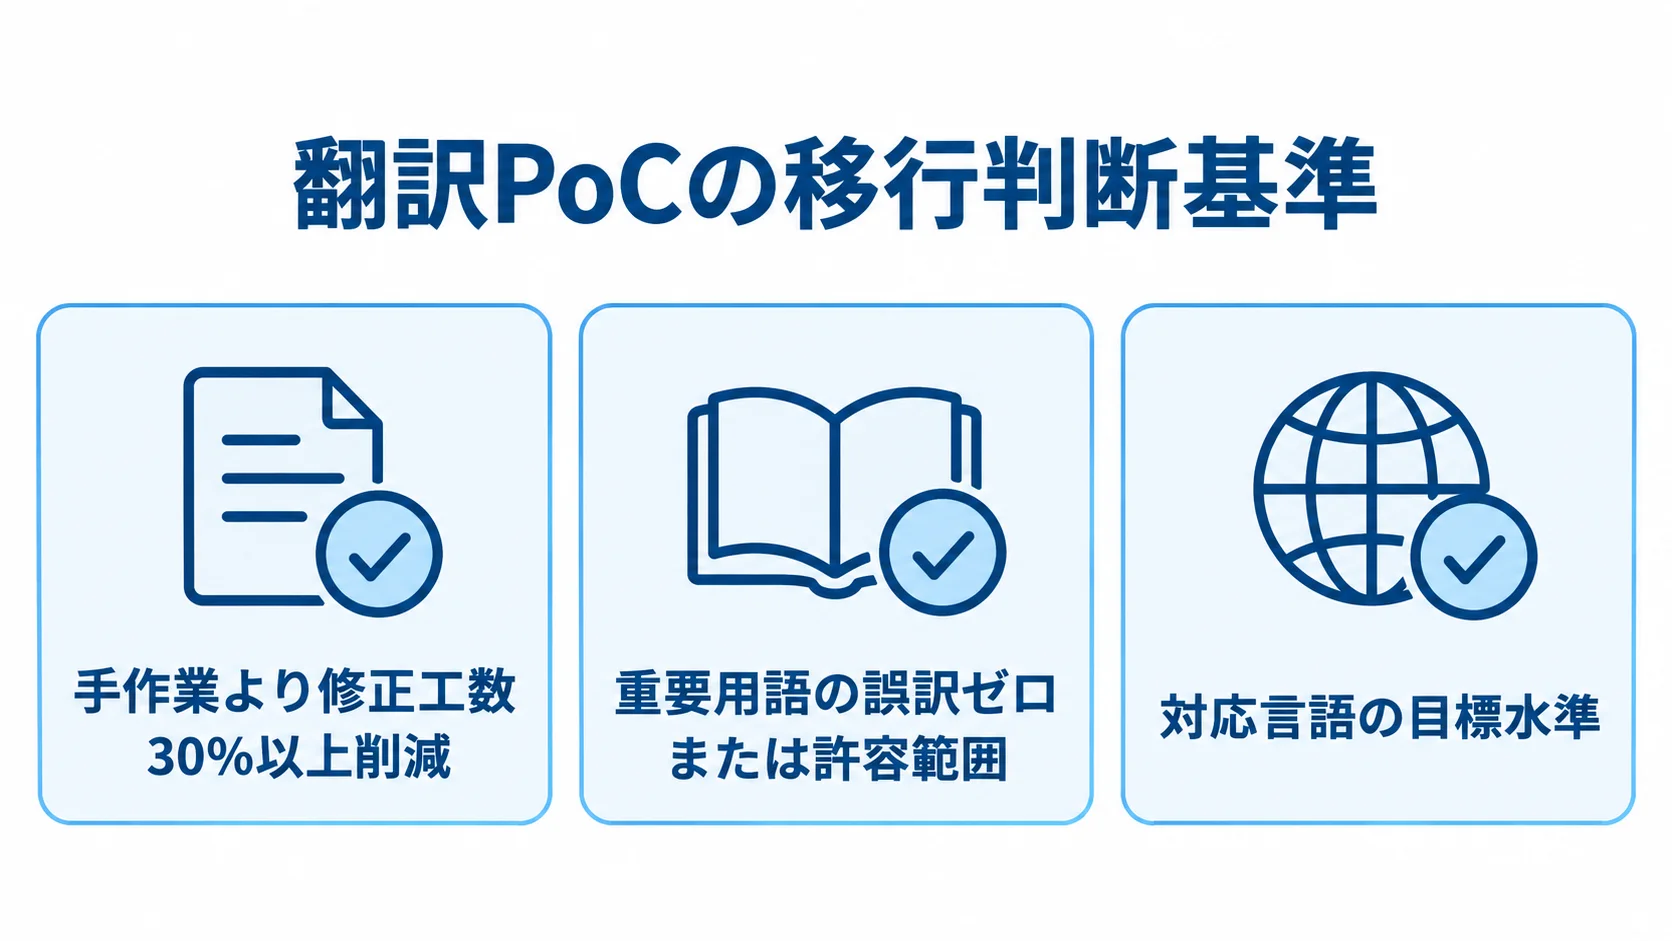
判断基準は、PoCを始める前に設定して、発注側と開発側で合意しておきます。評価する観点は、業務効果、用語品質、言語ペアの品質です。
- 業務効果:手作業より修正工数が30%以上減るか
- 用語品質:重要用語の誤訳がゼロか許容範囲か
- 言語品質:対応言語で目標の水準に届くか、届く道筋が見えるか
さらに、翻訳時間やコストが目標水準まで下がるかも、業務改善効果として数値で確認します。
用語集で対応できる範囲なら、本開発で品質を保てる見込みが立ちます。
全基準を満たせばGo、満たせなければNo-Goです。ただし、一部の言語や分野に課題が残る場合は、範囲を絞って進む判断もできます。
翻訳精度が目標に届かなくても、本開発の前に巨額の損失を避けられた成功と捉えます。そのうえで、推奨方法、概算費用と期間、運用体制もあわせて判断します。
翻訳PoCで陥りやすい落とし穴
PoCの結果を正しく判断するには、評価条件と機械翻訳の役割を事前に決めておく必要があります。特に避けたい落とし穴があります。
- 基準を決めずに始める:結果を都合よく解釈しやすい
- 都合のよいデータだけ使う:実データでの品質を見誤る
- 機械翻訳だけで完璧を求める:人の修正を含む運用で評価する
- PoCを品質保証とみなす:本番全体で再度品質を評価する
評価指標と合格ラインは、PoCの前に合意しておきます。簡単な文章だけでは精度が高く見えるため、実業務の難易度分布を反映したデータを選びます。
機械翻訳とポストエディットの役割を前提に評価します。少量データでの検証結果が本番全体で再現するとは限りません。そのため、本開発では全体の品質評価が必要です。
まとめ
AI翻訳ツールは、自社のデータと専門分野によって、業務で使える精度が変わります。そこで、本開発の前にPoCで実データを試し、精度と実用性を確かめます。
PoCでは、BLEUやCOMET、人手評価を使い、専門用語、言語ペア別の品質、修正時間を測ります。期間は1〜2か月、費用は100万〜300万円程度の検証で、数千万円規模の本開発の可否を判断できます。
評価基準を事前に決め、実業務のデータで検証し、人の修正も含めて移行の可否を考えます。そのうえで、まずは小規模なPoCで自社データの翻訳精度を確かめることをお勧めします。
▼全体ガイドの記事
・AI翻訳/自動翻訳ツール開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。