
自己符号化器は、入力を潜在表現へ変換して復元するニューラルネットワークです。教師ラベルなしで特徴を抽出でき、次元削減や異常検知などに使われます。
評価では、復元誤差だけでなく下流タスクの性能も見ます。仕組みと種類、異常検知、導入手順、失敗対策まで押さえると、導入の論点がそろいます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
自己符号化器による入力の圧縮と復元の仕組み
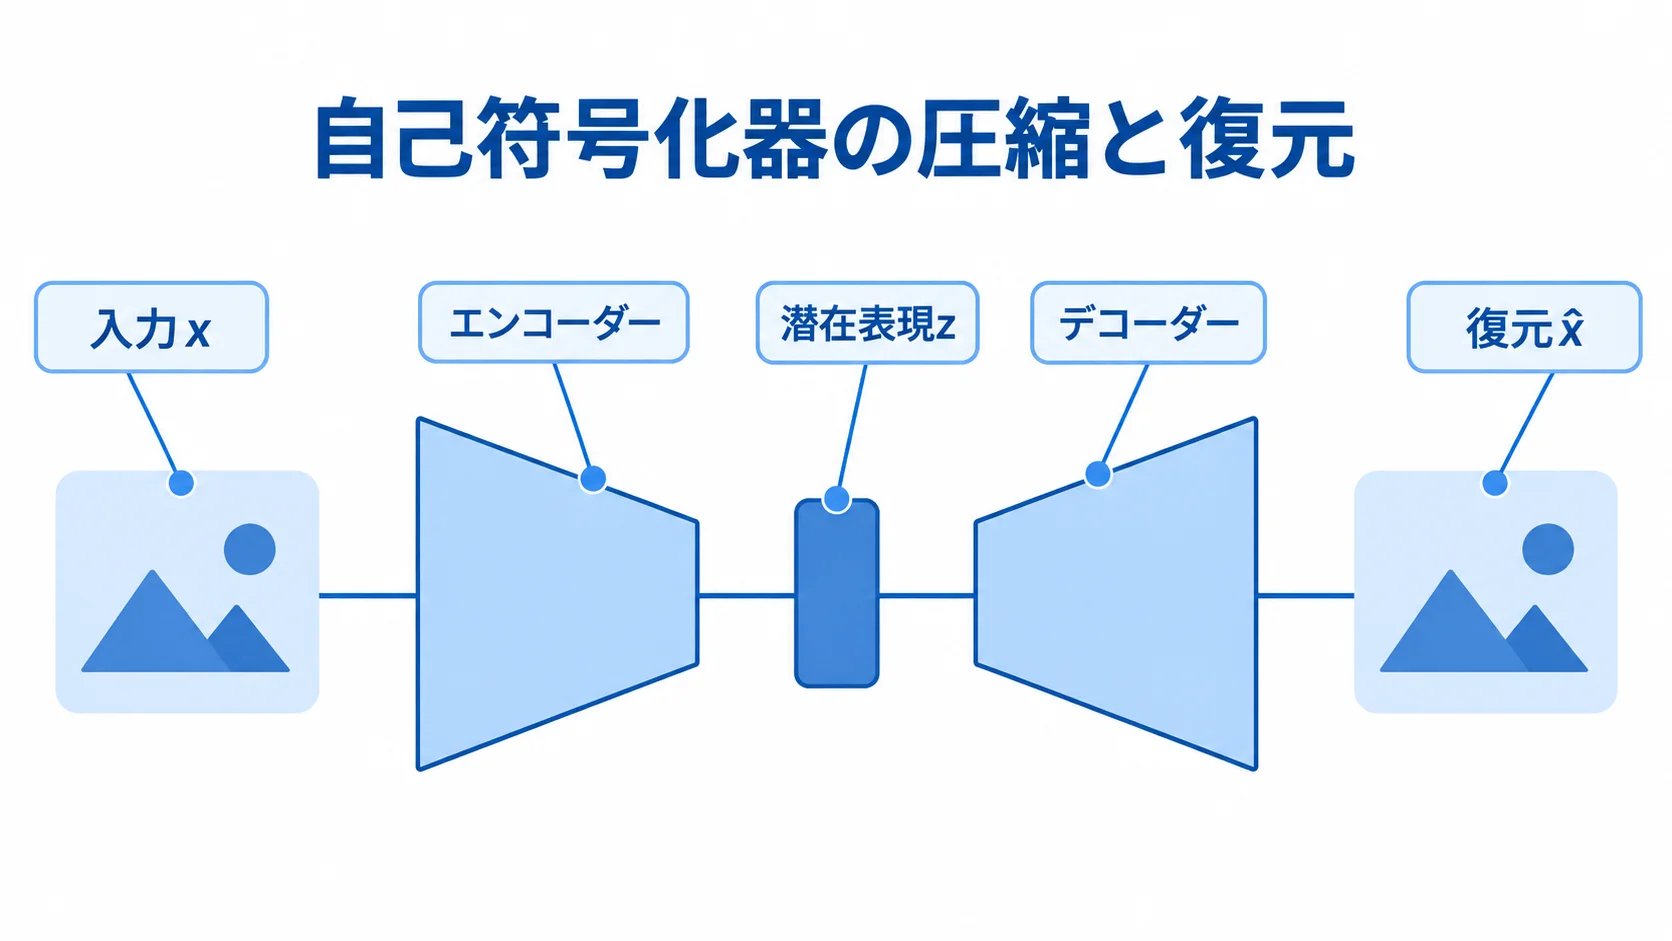
入力xはエンコーダーによって潜在表現zへ写され、デコーダーがzから復元x̂を生成します。
学習では、入力と復元の差である再構成損失を最小化します。
損失には、平均二乗誤差、絶対誤差、二値交差エントロピーなどがあり、入力の型に合うものを選びます。
学習時に潜在次元を小さくしたり、ノイズを加えたりすると、モデルは入力の重要な構造を学びやすくなります。
ボトルネックによる表現容量の制限
潜在表現の次元が入力と同じでも、正則化やノイズを加えると、意味のある特徴を学べる場合があります。ただし、次元を小さくしすぎると重要な情報を失い、大きすぎると単純なコピーを学んでしまいます。そのため、潜在次元は複数試し、下流タスクと復元品質の両方で評価します。
自己符号化器の種類と使い分け
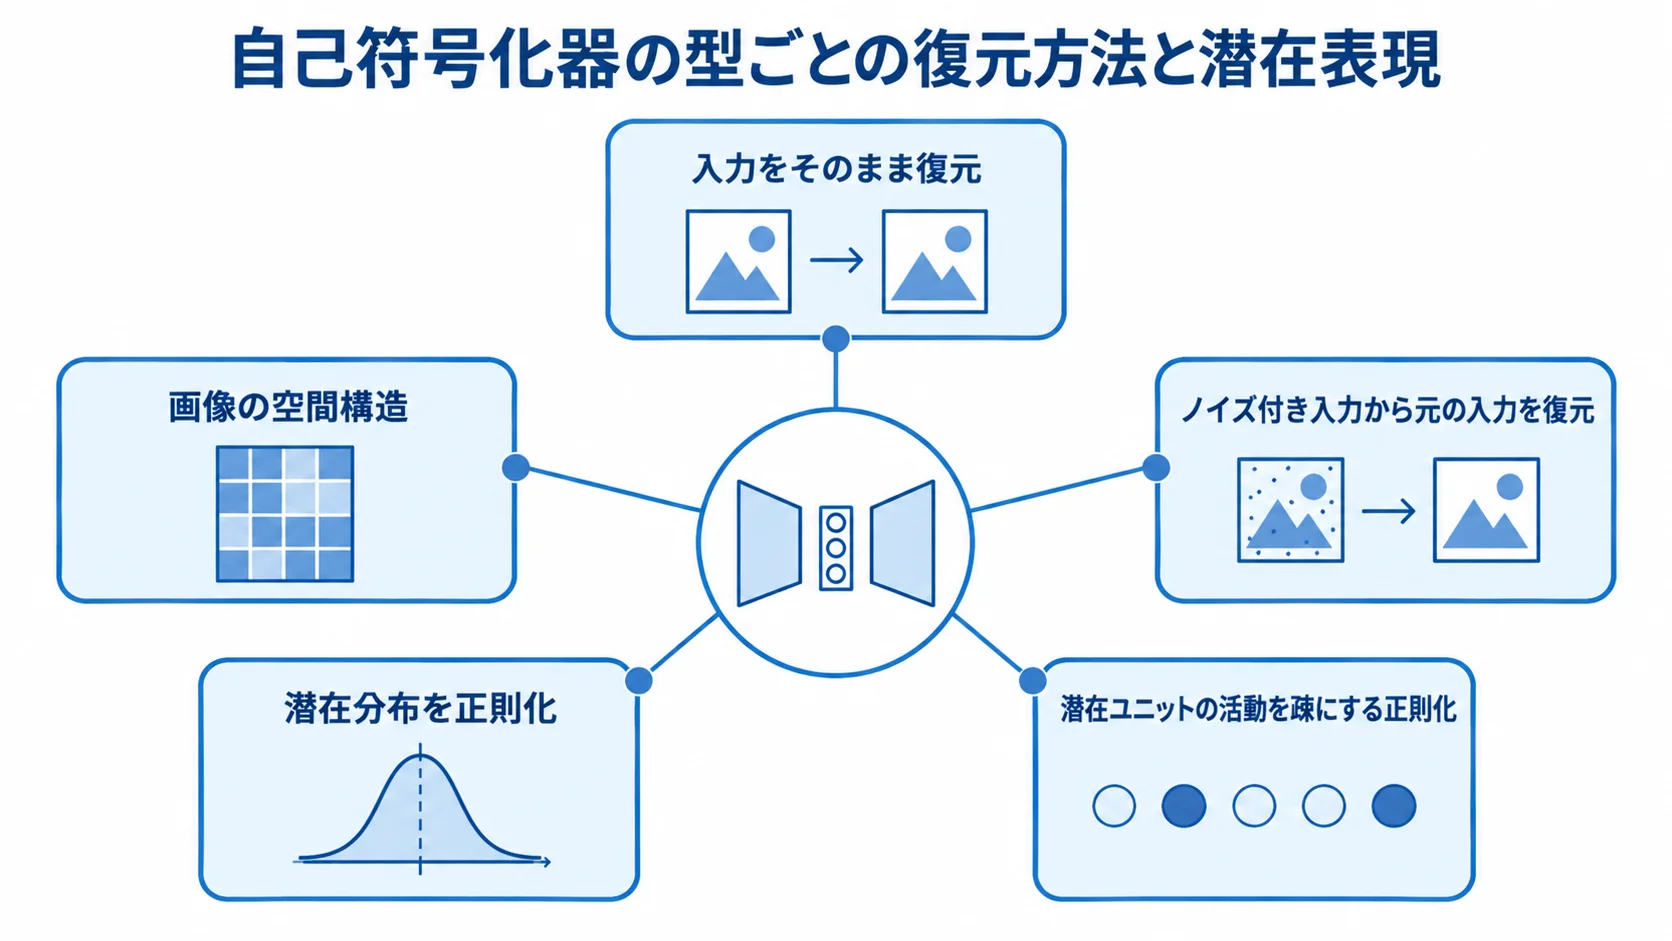
自己符号化器は、入力の復元方法と潜在表現の作り方によって型が分かれ、用途も変わります。目的が生成か、ノイズ除去か、画像の扱いかで、選ぶ型が変わります。
- 基本型:入力をそのまま復元し、圧縮表現を学ぶ型
- デノイジング型:ノイズ付きの入力から、元の入力を復元する型
- 疎表現型:潜在ユニットの活動を疎にする正則化を加えた型
- 変分型(VAE):潜在分布を正則化し、生成や補間に利用する型
- 畳み込み型:畳み込みを使い、画像の空間構造を扱う型
復元誤差としきい値による異常検知
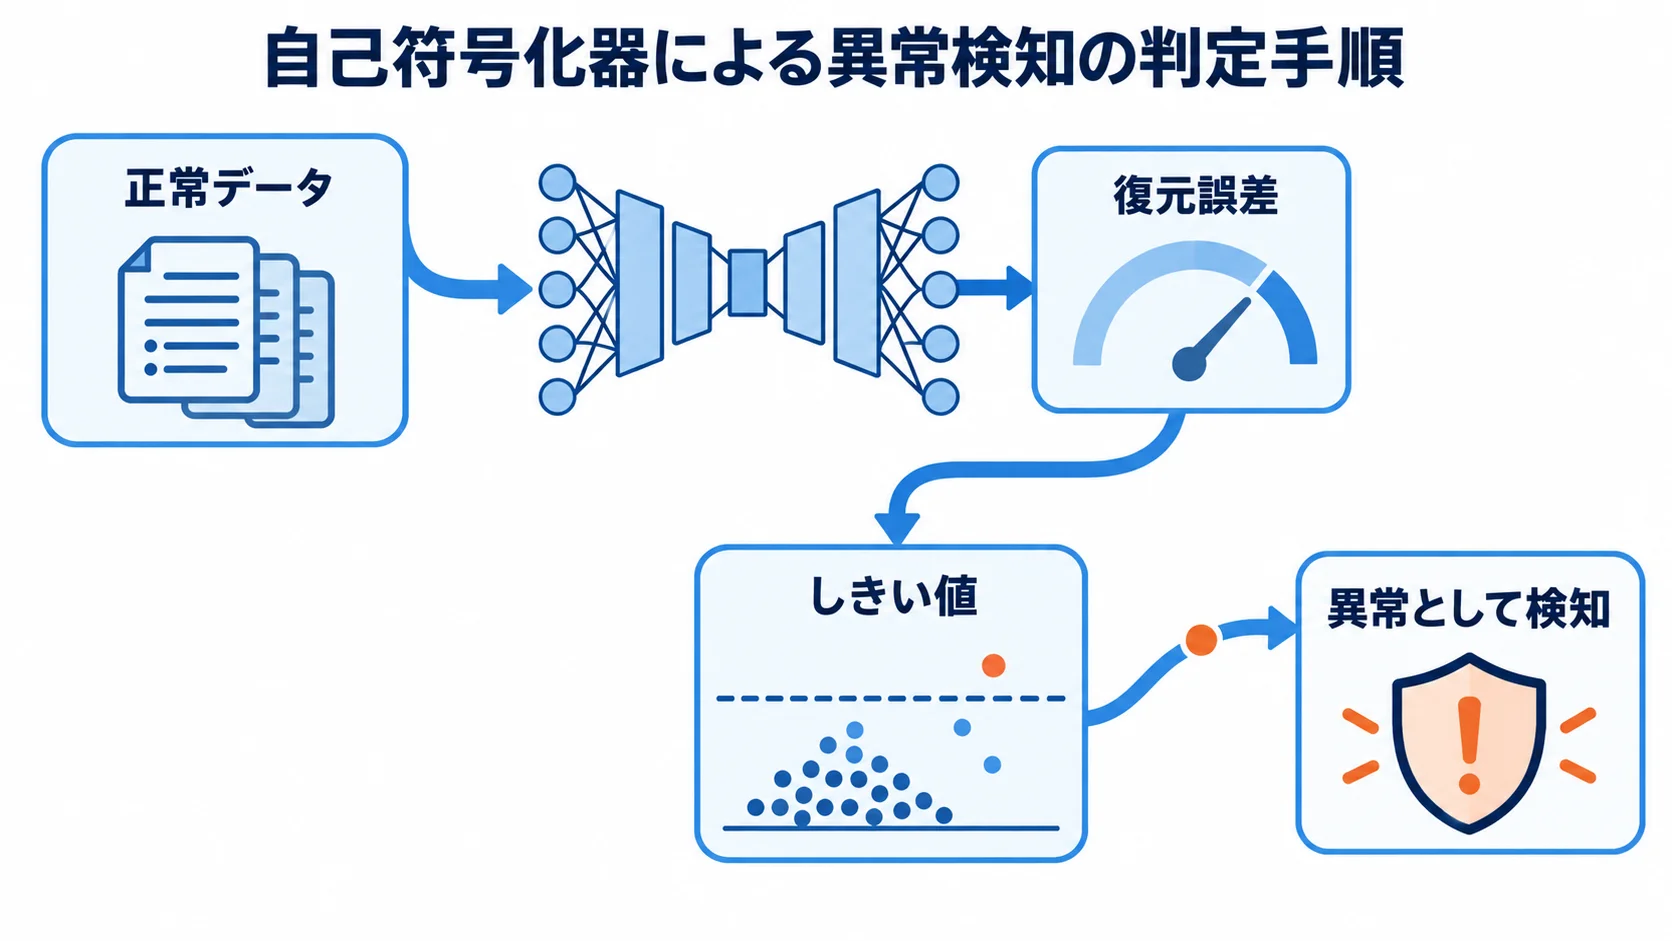
正常データで学習した自己符号化器は、正常なパターンをうまく復元できると想定されます。
異常なデータは復元しきれず誤差が大きくなるため、その誤差をスコアとして使います。
スコアがしきい値を超えたデータを、異常として検知します。ただし、異常なデータが学習データに混ざっていると、見逃しが起きる場合があります。また、モデルの容量が大きすぎる場合や、異常が正常に近い形をしている場合にも、見逃しが起こります。
しきい値は検証データを使って決めます。見るのは、適合率と再現率、誤警報の多さです。検知遅延や対応コストも考えたうえで、設備・顧客・期間をまたいだテストや、異常の種類別の評価も行います。
導入での復元目的と利用目的の分け方
導入では、入力データの定義から運用の手順まで、この順に決めていきます。
- 対象を定義する:画像、表、音声、ログなどの入力形式と、正常とみなす範囲
- 前処理を固定する:スケール、欠損、順序、データ分割の条件を保存しておく
- 構造を比較する:潜在次元、層数、活性化、ノイズ、正則化の組み合わせ
- 復元と下流を評価する:誤差に加えて、分類・検知・検索への効果の確認
- しきい値を運用する:警報、再確認、停止、再学習の手順
復元品質と検知性能の評価
評価では、復元誤差や画像品質、潜在表現の分離性を測ります。異常検知の場合は、適合率と再現率も確認します。異常検知の評価には、誤警報と検知遅延も含めます。
学習、検証、テストに使うデータへ、同じ対象の近いコピーが混ざらないようにします。そのため、顧客や設備の単位でデータを分割します。
自己符号化器で起きやすい失敗と対策
入力のコピー学習
コピー学習を防ぐには、潜在次元とノイズを見直し、疎性と重み減衰も確認します。そのうえで、下流性能を評価します。
復元誤差のしきい値の固定化
しきい値は、設備・期間・顧客ごとの分布を見たうえで、検証データを使って更新します。
テストデータの学習への混入
データ漏えいを防ぐには、分割前に重複を除去しておきます。そのうえで、前処理としきい値の学習には、学習データだけを使います。
入力の特徴を潜在表現へ圧縮する自己符号化器
自己符号化器は、エンコーダーで入力を圧縮し、デコーダーで復元する、教師なしの表現学習モデルです。
次元削減、ノイズ除去、異常検知に応用できます。さらに、画像圧縮や生成にも使えます。
目的の達成は、復元誤差と下流指標の両方で判断します。そのため、潜在次元や学習データ、しきい値も合わせて確認します。また、顧客や期間をまたいでも、同じ結果を再現できるかを確認します。
よくある質問(FAQ)
自己符号化器について、寄せられることの多い疑問に順に答えます。
Q. 自己符号化器とは何ですか?
自己符号化器は、入力を潜在表現へ変換するエンコーダーと、そこから入力を復元するデコーダーで構成されるモデルです。
Q. 何に使えますか?
次元削減やノイズ除去、異常検知に使えるほか、画像圧縮、特徴抽出、生成にも使えます。
Q. 異常検知の仕組みは何ですか?
正常データで学習し、復元誤差が大きいデータを異常候補として検知します。
Q. 潜在次元はどう決めますか?
複数の次元を試し、復元品質と下流性能に加えて、圧縮率や過学習も合わせて見て決めます。
Q. 異常のしきい値はどう決めますか?
検証データを使って、適合率と再現率を比べ、誤警報、検知遅延、対応コストも見て設定します。
参考資料
自己符号化器の構築方法や機能、関連研究を確認するときに、役立つ資料を挙げます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。