
AWS導入・構築で起きやすい失敗は、移行の見積もりの甘さや過剰スペック、隠れコスト、PoCを省いた本番化、運用体制の欠如、ベンダーロックインとコンプライアンス違反などです。先人がどこでつまずいたかを知っておくことは、自社の投資を守る何よりの保険になります。
なお、AWS導入・構築の全体像をまだ把握していない方は、まずAWS導入・構築の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・AWS導入・構築の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
移行の見積もりの甘さと過剰スペックの失敗
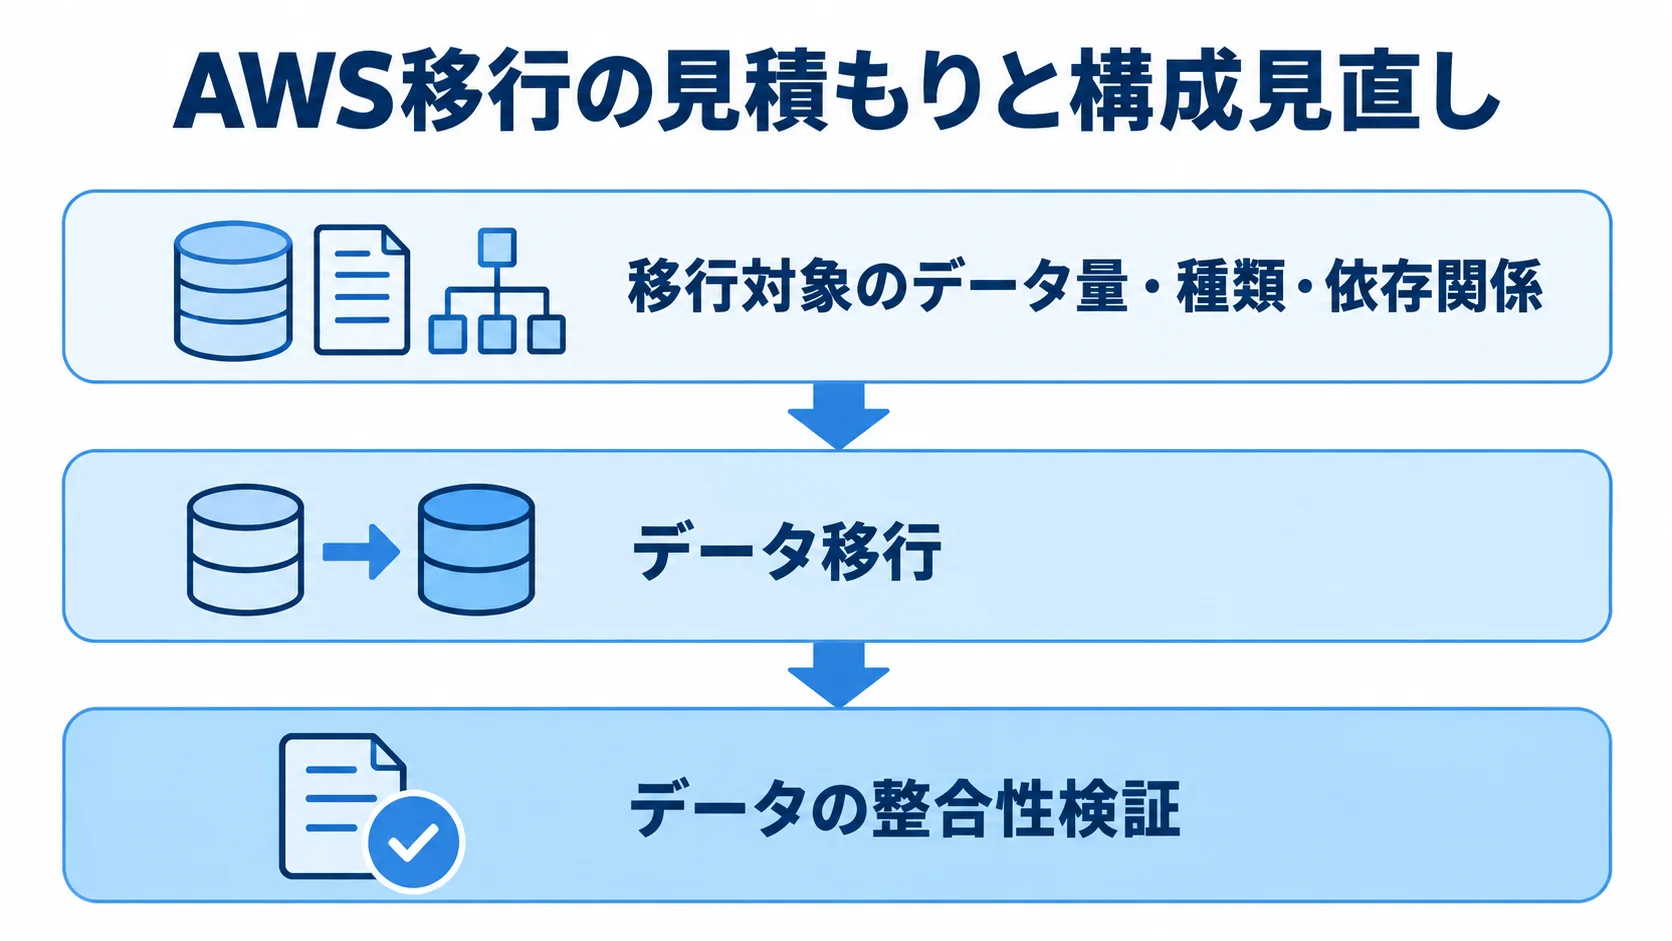
AWS移行でまず起きやすい失敗が、見積もりの甘さです。データ移行の工数や、オンプレミスとクラウドの構成の違いを軽く見積もると、計画が崩れます。
クラウド移行は「サーバーを置き換えるだけ」と思われがちです。しかし実際には、アプリケーションの改修、データの整合性確保、検証作業など、想定外の作業が積み重なります。この甘さが、予算超過とスケジュール遅延の主因になります。
データ移行の見積もりが甘く予算超過する失敗
移行で見落とされがちなのが、データ移行のコストと工数です。一次データでは、従業員50〜100名規模のオンプレからクラウドへの移行で、設計・構築の100万〜400万円とは別に、データ移行だけで20万〜80万円がかかるとされています。
大量のデータを正確に移し、移行後に整合性を検証する作業は、想像以上に手間がかかります。この部分を「ついでにできる」と甘く見積もると、後から大きな追加費用が発生します。
回避策は、移行対象のデータ量・種類・依存関係を事前に洗い出し、データ移行を独立した工程として見積もりに計上することです。全体では150万〜500万円前後が相場感になります。自社のデータ規模がこの幅のどこに当たるかを、ベンダーと具体的に詰めておきます。
移行は、影響の小さいシステムから段階的に移し、検証を重ねながら進めることで、想定外を最小化できます。
見積もりに移行の工数が正しく入っているかは、検証の範囲と移行の順番を見ると分かります。
- 検証の範囲:移行後のデータの整合性を、どこまで、どの方法で確かめるかが決まっているか
- 移行の順番:どのシステムから先に移すかの理由と、その順番による費用の違い
過剰スペックで無駄なコストを払い続ける失敗
もう一つの典型的な失敗が、過剰スペックです。オンプレミス時代の「念のため大きめに確保する」発想をそのままクラウドに持ち込むと、使われていないリソースにも課金され続けます。
クラウドは後から規模を変えられることが利点なのに、最初から余裕を持たせすぎると、その柔軟性を自ら捨てることになります。従量課金ゆえに無駄が見えにくく、放置されがちな失敗です。
回避策は、まず標準的なスペックで構築し、実際の負荷を監視しながらサイズを見直していく「ライトサイジング」を運用に組み込むことです。一次データでも、小規模シングル構成は20万〜30万円、中規模の高可用性構成は50万〜60万円と、必要なレベルに応じた段階的な構成が示されています。
最初から大規模構成を組むより、需要に合わせて育てる発想が大切です。CloudWatchなどの監視でリソースの使用状況を把握し、過剰な部分を定期的に削っていけば、無駄なコストを構造的に防げます。
過剰な構成になっていないかは、使用率の偏りと見直しの周期で確かめられます。
- 使用率の偏り:CPUやメモリの使用率が、長く低い水準のまま続いていないか
- 見直しの周期:負荷の変化に合わせてサイズを戻す時期を、運用の予定に入れているか
データ転送量・仕様変更による隠れコストのリスク
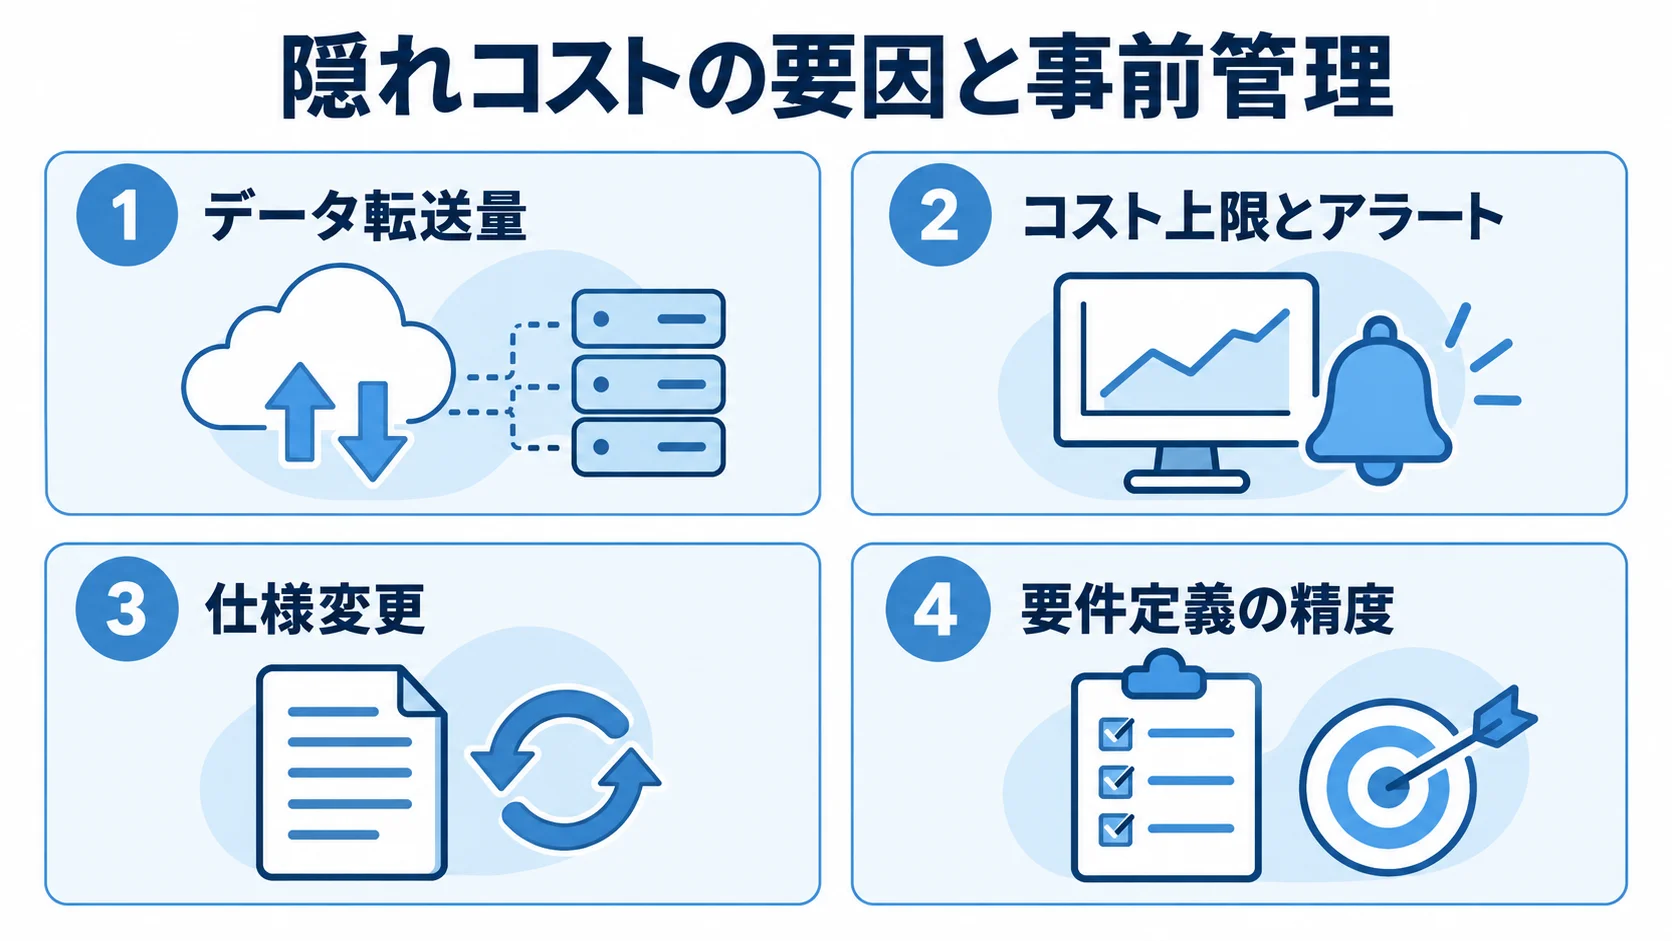
AWS導入後に多くの企業を悩ませるのが、当初の見積もりに含まれていなかった「隠れコスト」です。クラウドは従量課金のため、使い方次第で月額が変動します。
特にデータ転送量と仕様変更は、想定外の費用を生む二大要因として知られています。これらを事前に手当てしておかないと、運用が始まってから請求額に驚くことになります。
データ転送量の急増で費用が膨らむリスク
データ転送量は、クラウドの隠れコストの代表格です。AWSでは、インターネットへのデータ送信(アウトバウンド転送)に課金されるためです。
また、画像や動画を大量に配信するサービスや、利用が急増したシステムでは、転送量が跳ね上がり費用が膨らみます。サーバーやデータベースの料金ばかりに目が向き、転送量を見落としていると、運用開始後に「なぜこんなに高いのか」と困惑することになります。
回避策は、設計段階で転送量を試算し、コスト上限とアラートを設定しておくことです。CDN(コンテンツ配信網)を使って転送を効率化したり、配信方法を工夫したりすることで、転送コストを抑えられます。
一次データでは、インフラ月額は中規模で3万〜10万円が目安とされています。ただし、転送量次第ではこれを超えることがあります。月額の上限を要件として定め、超過しそうになったら検知できる仕組みを最初から組み込むことが、隠れコストへの最大の防御です。
転送量の見積もりが実際の利用に合っているかは、試算の前提と超過時の動きを見ると分かります。
- 試算の前提:利用者数や配信するコンテンツの量を、転送量の試算の条件として書き出しているか
- 超過時の動き:上限を超えたときに誰が通知を受け、どこまで止めるかの取り決め
仕様変更の積み重ねで追加費用が膨らむリスク
もう一つの隠れコストが、仕様変更による追加費用です。要件定義が曖昧なまま開発を進めると、途中で「やはりこうしたい」という変更が頻発します。そのたびに、追加の工数と費用が発生します。
クラウド開発は費用の約80%が人件費であるため、仕様変更による工数増は、そのまま費用増に直結します。小さな変更の積み重ねが、気づけば当初予算を超える原因になります。
回避策は、要件定義の精度を高め、仕様変更を最小化することです。一次データでも、要件定義の精度を上げることが仕様変更コストの抑制につながると指摘されています。
上流工程で業務要件と非機能要件をしっかり固め、関係者の合意を取っておけば、後からの手戻りを減らせます。
変更が避けられない場合も、影響範囲とコストをその都度示し、優先順位をつけて進めれば、費用の暴走を防げます。隠れコストは「見えないから怖い」のです。見えるようにし、上限を設定しておけば、多くは防げます。
仕様変更が積み重なっていないかは、要件の固め方と変更の記録で確かめられます。
- 要件の固め方:業務要件と非機能要件を文書にし、変更を受け付ける窓口を一つに決めた状態
- 変更の記録:変更ごとに、工数と費用の増減、影響範囲を残す仕組み
PoC不在のまま本番化する危うさ
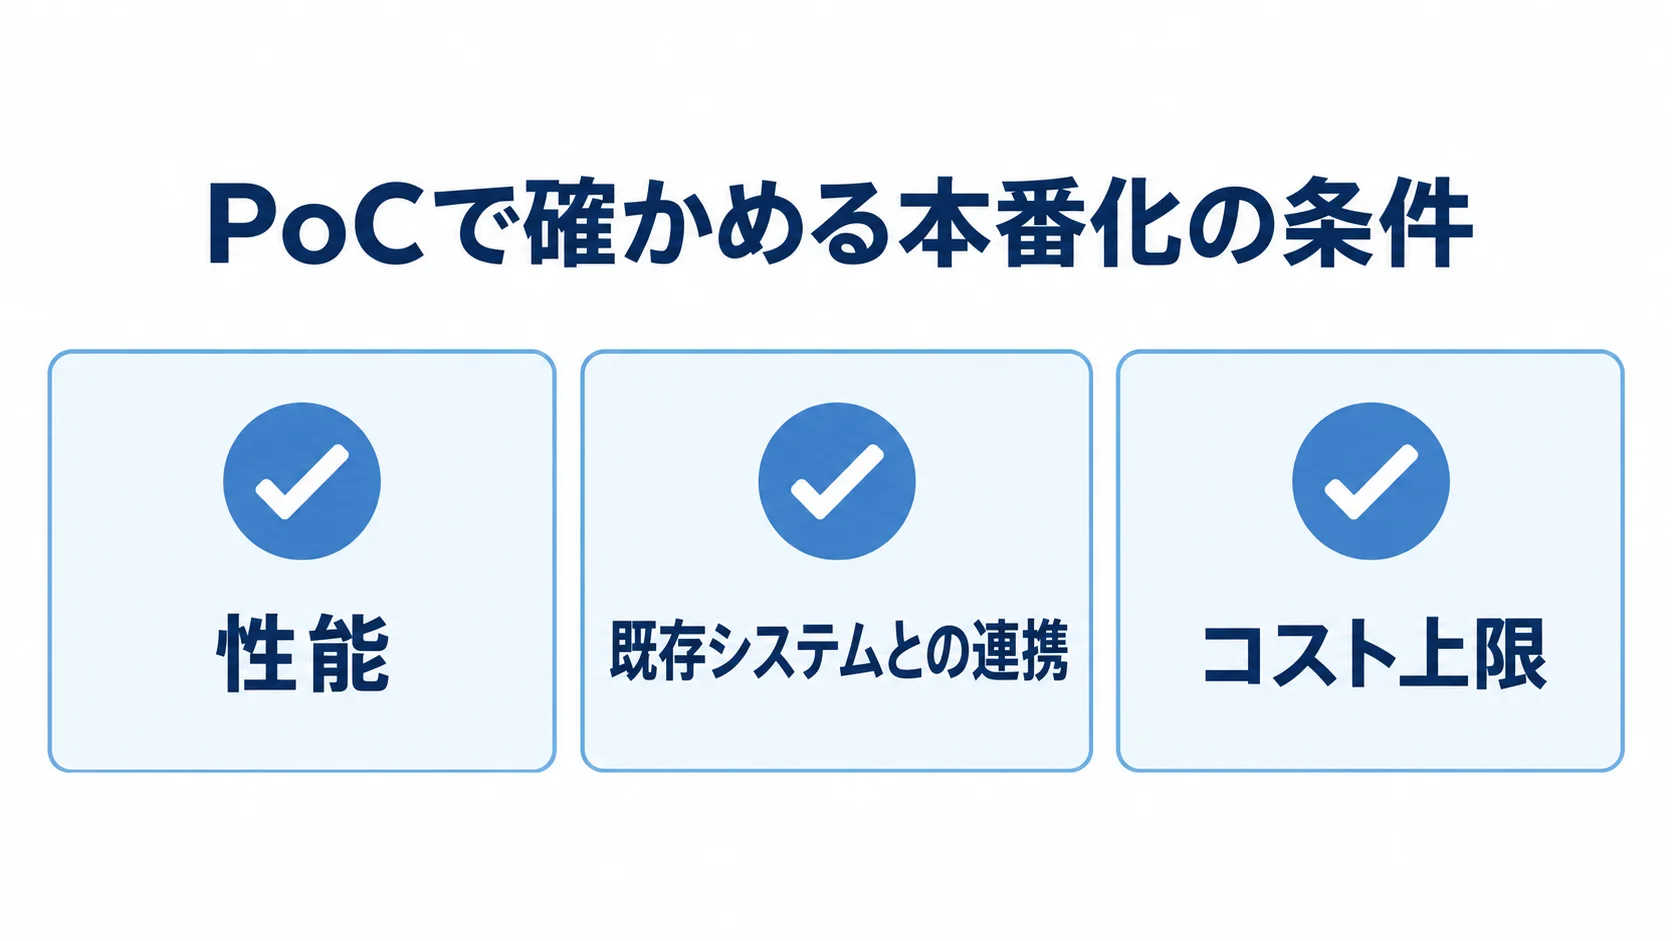
大規模なAWS構築や移行で見落とされがちなのが、PoC(概念実証)の不在です。検証を十分に行わないまま、いきなり本番システムを作り込んでしまうと、本番運用で初めて性能不足や連携の不具合が発覚し、大きな手戻りを招きます。
特にサーバーレスやマネージドサービスを多用する場合、実際に動かしてみないと分からない制約があります。机上の設計だけで本番化するのは危険です。
検証不足で本番後に手戻りが発生する失敗
PoCを省いて本番化すると、性能が想定に届かない、既存システムとうまく連携できない、想定したコストに収まらない、といった問題が運用開始後に噴出します。
本番稼働後の修正は、設計段階の修正に比べてはるかに高くつき、最悪の場合は構成の作り直しに至ります。たとえば、サーバーレスが特定の処理に不向きだった、転送量が想定を超えた、といった事実は、実際に動かして初めて見えてくることが多いのです。
回避策は、本番化の前にPoCで重要な前提を検証することです。性能が出るか、既存システムと連携できるか、コストが上限内に収まるかを、小さく作って確かめます。
ここで陥りがちなのが、PoCを「やったつもり」で終わらせることです。これを防ぐには、検証項目と合格基準を事前に定め、CPU使用率やネットワークI/Oといった指標で客観的に判断することが欠かせません。この評価軸の明確化は、解説されることの少ない実務上の勘所ですが、PoCを意味のある意思決定につなげる鍵です。
PoCが意味のある検証になっているかは、負荷の条件と連携の確認を見ると分かります。
- 負荷の条件:本番想定の負荷をどの量で試すかを、事前に数字で決めているか
- 連携の確認:既存システムとのデータのやり取りを、実際の経路でつないで確かめる計画
運用体制を整えずに導入する失敗
構築だけに気を取られ、運用体制を整えずに本番化するのも、よくある失敗です。AWSは、監視、障害対応、コスト管理、セキュリティ運用を、構築のあとも続けていく必要があります。
運用の担い手や手順を決めないまま稼働させると、障害時に誰も対応できず、コストも管理されないまま膨らみます。
一次データでは、保守運用費は年間で開発費の10〜20%(開発500万円なら年50万〜100万円)が相場とされています。運用には継続的なコストと体制が必要です。
回避策は、導入時点で運用体制を設計しておくことです。自社に運用人材がいない場合は、AWS運用代行(監視・障害一次対応、初期・月額とも数万円程度)を活用しつつ、徐々に内製化を進めます。
従来の「絶対止めない」型の運用から、目標値を定めて自動化を進めるSRE型の運用へ、運用文化を移す視点も欠かせません。構築と運用を一続きで設計することが、導入を成功させる前提条件です。
riplaはフルスクラッチ受託とクラウド構築・運用の伴走の立場から、PoCの評価軸設計と運用体制づくりまでを支援しています。
運用体制が整っているかは、担い手の分担と手順の書き方で確かめられます。
- 担い手:監視や障害の一次対応を、社内と外部のどちらが受けるかの分担
- 手順:障害時とコスト超過時の対応を、誰が読んでも動ける文書にした状態
ベンダーロックインとコンプライアンス違反のリスク
長期的な視点で警戒すべきリスクが、ベンダーロックインとコンプライアンス違反です。
前者は「特定のクラウドや特定のサービスから抜け出せなくなる」リスク、後者は「業界の規制やガイドラインに違反してしまう」リスクです。
どちらも導入時には顕在化しにくく、後になって大きな問題として降りかかるため、最初から手当てしておく必要があります。
独自サービスの多用でロックインに陥るリスク
ベンダーロックインは、特定クラウドの独自サービスを使い込むほど深まります。AWS固有のマネージドサービスは便利な一方、それに依存しすぎると、後で別のクラウドへ移ろうとしても容易には移せず、料金交渉でも不利になります。
利便性とロックインリスクは表裏一体であり、どこまで独自サービスに依存するかは、戦略的に判断すべき論点です。
回避策として有効なのが、コンテナ技術によるポータビリティの確保です。アプリケーションをコンテナ化しておけば、特定クラウドへの依存を抑え、将来的に別の環境へ移す余地が残ります。
複数のクラウドを併用するマルチクラウドという選択肢もあります。ただし、統合監視やセキュリティ管理が複雑になるため、安易に選ぶと運用負荷というリスクを招きます。
判断の基準は、「移行可能性をどこまで確保したいか」と「運用をどこまでシンプルに保ちたいか」のバランスです。独自サービスの利便性を享受しつつ、要となる部分はポータビリティを残す、という設計が現実的です。
独自サービスの選び方は、依存の範囲と移行時の作り直しで比べられます。
- 依存の範囲:どの独自サービスを、どの業務の中核で使うかを一覧にしているか
- 移行時の作り直し:将来ほかの環境へ移すとき、作り直しが要る部分の把握
コンプライアンス違反で事業リスクを抱える失敗
規制業種で最も避けるべきが、コンプライアンス違反です。金融業のFISC安全対策基準、医療分野の3省2ガイドラインといった業界基準を満たさないままシステムを稼働させると、監査での指摘や行政指導につながります。
最悪の場合は、事業の継続そのものに関わるリスクを抱えます。さらに、これらの要件を後から満たそうとすると、構成の作り直しという大きな手戻りが発生します。
回避策は、要件定義の段階で自社が従うべき業界基準を明確にし、それを満たす構成を最初から設計することです。
データの保管場所や暗号化、アクセスログの保全を要件に織り込みます。ゼロトラストに基づくアクセス制御も含めて、対応実績のあるベンダーを選ぶことが大切です。
コンプライアンスは「後で対応」が最も高くつく領域であり、上流で手当てすることが唯一の正解です。AWS導入の失敗の多くは、技術力ではなく「上流の詰めの甘さ」に起因します。見積もりからコンプライアンスまで、最初に丁寧に手当てすれば防げるものばかりです。
コンプライアンスの要件が足りているかは、業界基準と対応の実績で確かめられます。
- 業界基準:金融や医療など、自社の業種に当たる基準を要件定義の段階で特定しているか
- 対応の実績:同じ基準を満たす開発の実績を、ベンダーが示せるかどうか
運用フェーズで顕在化する課題とSRE移行の壁
AWS導入の失敗は、構築時だけでなく、運用が始まってから顕在化するものも少なくありません。構築は無事に終わったのに、運用フェーズで体制や文化が追いつかず、システムが期待どおりに機能し続けない、というケースです。
クラウドの真価は継続運用で発揮されるため、ここでつまずくと、せっかくの投資が活きません。
運用が属人化し改善が止まる課題
運用フェーズでよくある課題が、運用の属人化です。構築を担当した一部の人だけが構成を理解しており、その人が離れると誰も手を出せなくなる、という状態です。
インフラ構成が手作業のクリックで作られ、IaC(Infrastructure as Code)で管理されていないと、変更の履歴も残らず、再現も難しくなります。この属人化が、改善のスピードを落とし、トラブル時の対応を遅らせます。
回避策は、構成をIaCでコード化し、組織の資産として管理することです。コードで管理すれば、構成の意図が明文化され、複数人でレビューでき、同じ構成を正確に再現できます。
前述のスキルトランスファーやCCoEの考え方とも連動し、運用ノウハウを個人ではなく組織に蓄積する仕組みを作ることが、属人化という課題への根本的な対処になります。構築時点からIaCを前提にしておくことが、後の運用品質を左右します。
属人化を防げているかは、構成の管理と知識の共有で確かめられます。
- 構成の管理:手作業の変更を減らし、変更履歴が残る形で構成を管理しているか
- 知識の共有:構築を担当した人以外も、構成の意図を読んで変更できる状態か
従来運用からSREへの移行でつまずくリスク
クラウドネイティブな運用に移行する際、従来の運用文化が壁になることがあります。
オンプレミス時代の「絶対に止めない」ことを至上命題とするITIL型の運用から、目標値(SLO)を定めてその範囲で許容しつつ、定型作業(トイル)の撲滅や障害対応の自動化を進めるSRE型の運用へと移ることになります。この文化とプロセスの移行は、ツールを入れるだけでは進まず、組織の考え方そのものを変える必要があります。
移行でつまずくと、せっかくクラウドに移っても、運用は旧来のまま手作業と人海戦術が続き、クラウドの自動化メリットを活かせません。また、運用文化の移行は競合の解説が手薄な領域であり、AWS導入を「移しただけ」で終わらせず、本当の意味で活かすための鍵になります。
回避策は、まず監視の自動化や定型作業の削減から段階的に始めることです。いきなり全面的なSRE化を目指すより、小さな成功を積み重ねて運用文化を少しずつ変えていくほうが現実的です。
SRE型への移行が進んでいるかは、手作業の量と判断の所在を見ると分かります。
- 手作業の量:監視や定型作業のうち、人の手で行っているものの割合を把握しているか
- 判断の所在:障害時に、どこまでを自動で処理し、どこから人が判断するかの線引き
運用文化の移行を進めるうえで現実的なのは、外部パートナーの伴走を受けながら、徐々に内製のSRE的な運用へ移していくやり方です。
最初は監視や障害一次対応を委託しつつ、その過程で自動化のノウハウやSLOの考え方を社内に取り込み、定型作業を一つずつ自動化していきます。
一次データでも、AWS運用代行は初期・月額とも数万円程度とされています。こうした委託を入口にしながら、運用の自走力を段階的に育てるのが、文化の壁を乗り越える堅実な道筋です。
文化の移行も含めて、riplaが伴走の立場から支援しています。
まとめ
AWS導入・構築の失敗を振り返ると、その多くは「上流工程の詰めの甘さ」に集約されます。移行では、データ移行を独立した工程として正確に見積もります。過剰スペックは、ライトサイジングで防ぎます。
隠れコストは、データ転送量の試算とコスト上限・アラートの設定、要件定義の精度向上による仕様変更の最小化で抑えます。PoCは検証項目と合格基準を定めて意味のある検証にし、運用体制は導入時から設計します。
ベンダーロックインはコンテナでポータビリティを残し、コンプライアンスは上流で業界基準を織り込むことで、いずれも回避できます。
失敗を避ける最大のコツは、「技術より上流」を意識することです。どのサービスを使うかという技術論よりも、プロジェクトの前提を丁寧に固めることが、投資を守ります。見積もりから運用、コンプライアンスまでが、その前提にあたります。
これらを最初に手当てすれば、AWS導入で外すことはありません。riplaは、フルスクラッチ受託とクラウド構築・運用の伴走を組み合わせ、見積もりの精度向上からPoCの評価軸、ロックイン回避まで支援します。
また、コンプライアンス対応まで、失敗の芽を上流で摘む支援を一貫して行います。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。