
Azure OpenAIのシステム開発は、要件整理とモデル選定から始めます。次に、設計・開発とテストを行います。そのうえで、限定公開を経て定着させると、本番利用につながります。
全体の構成、費用相場、見積もりで確認する点も、あわせて取り上げます。
▼全体ガイドの記事
・Azure OpenAIのシステム開発の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
Azure OpenAIのシステム開発の全体像
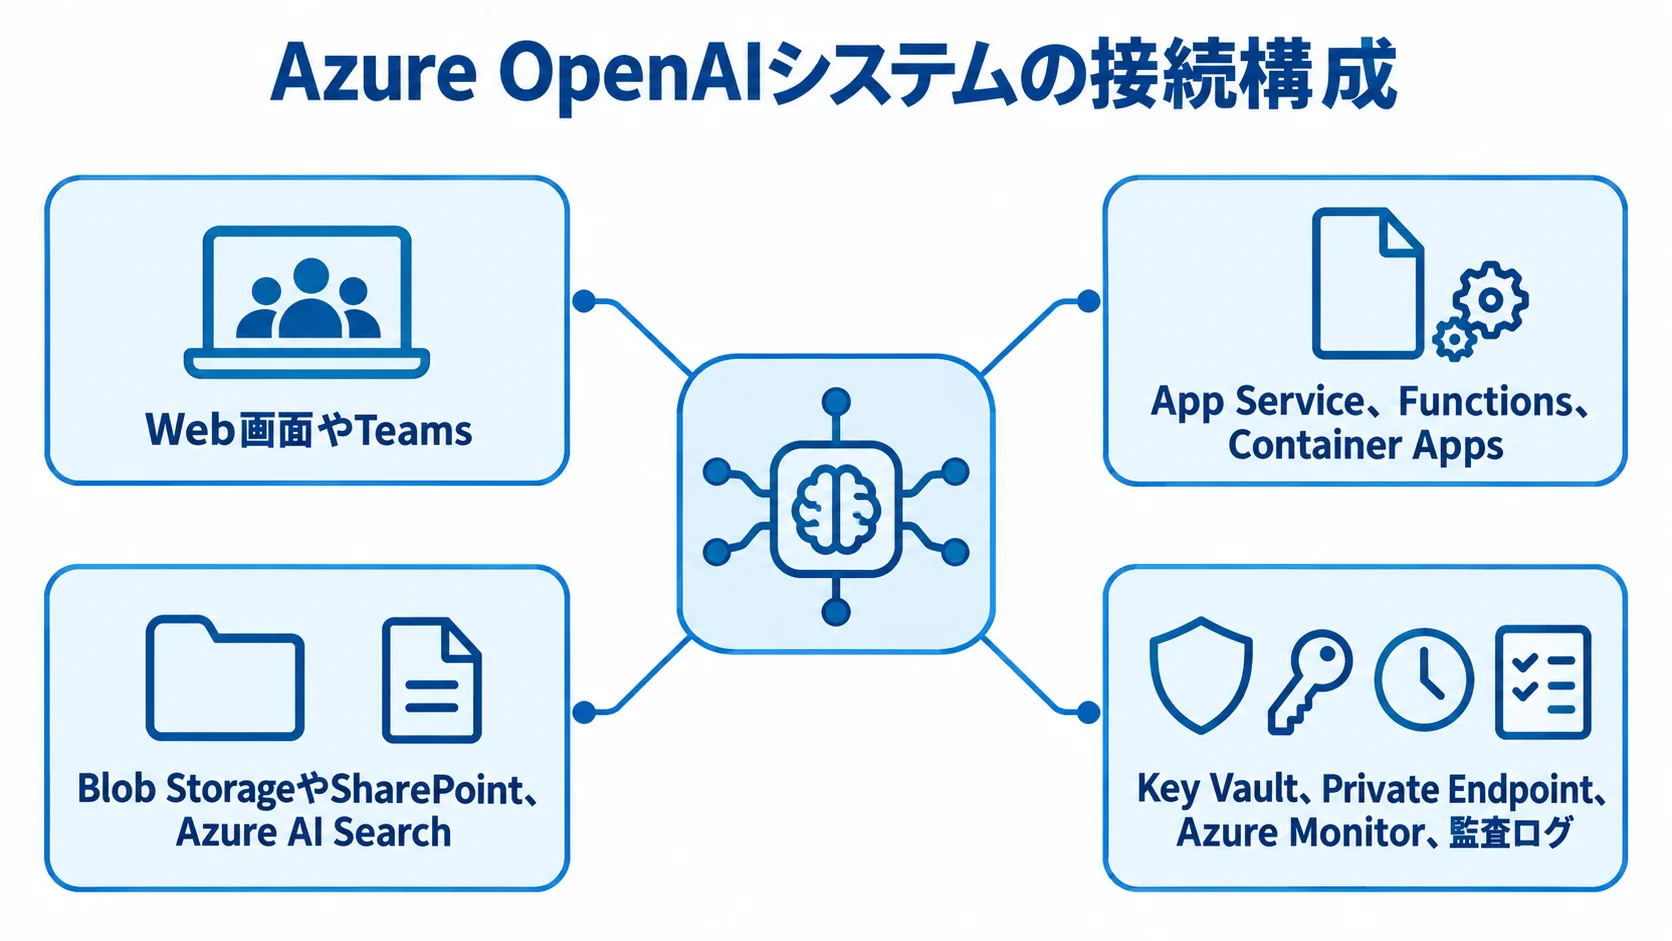
Azure OpenAIのシステムは、Azure上のOpenAI系モデルを、社内データや業務フロー、既存システムとつなぐアプリケーションです。
開発の範囲はチャット画面だけにとどまりません。利用者を認証し、閲覧が許されたデータだけを検索し、回答の根拠と操作履歴を残す設計も含まれます。
典型的な構成「UI・認証・アプリ・AI・データ・監視」
構成要素ごとの役割を整理すると、必要な機能と接続範囲を決めやすくなります。
- 画面と認証:Web画面やTeamsからの利用と、Microsoft Entra IDなどによる認証
- アプリとAI:App Service、Functions、Container Appsなどから行うAzure OpenAIの呼び出し
- データ:Blob StorageやSharePoint、Azure AI Search、SQLやCRMなどの組み合わせ
- 保護と監視:Key Vault、Private Endpoint、Azure Monitor、監査ログによる、秘密情報・通信・障害・利用状況の管理
全機能を最初から実装する必要はありません。一方で、将来の権限、ログ、データ更新、費用上限は、初期の段階から想定しておきます。
社内FAQは、回答生成だけで始められる場合があります。ただし、部署ごとに閲覧権限が違うときは、インデックス設計の段階で検索権限のフィルタを組み込みます。
最初に選ぶ用途:効果と安全性を測りやすい業務
初期の用途は、人が回答候補を確認でき、処理時間や採用率を測りやすい業務から選びます。候補には次のようなものがあります。
- 文書検索:社内規程や製品マニュアルの検索
- 要約:議事録や報告書の要約
- 項目抽出:申請書からの必要項目の抽出
- 回答下書き:問い合わせへの回答案の作成
融資可否や契約の最終判断、在庫・顧客情報の更新は、誤操作が直接損失につながります。そのため、こうした処理の完全自動化は初期段階では避けます。
Microsoftの顧客事例では、日本郵政がAzure OpenAI Serviceを使う生成AI活用ポータルを公開しました。その後、半年で70以上のミニアプリ、月間2万回超の実行へと広がり、利用者の8割が効果を実感しています(出典: Microsoft Customer Stories「日本郵政」、2025年)。
山梨中央銀行は2023年に全行で導入し、融資審査やIR想定問答へと用途を積み重ねています(出典: Microsoft Customer Stories「山梨中央銀行」、2025年掲載)。
Azure OpenAIのシステム開発の進め方
Azure OpenAIの開発は、6フェーズで進めると、PoCと本番開発の境界を管理しやすくなります。各段階で成果物と合格条件を決め、次へ進む判断を明確にします。
1. 要件整理:目的・KPI・対象データの決定
どの業務の何を改善するかは、測れる目標として定めます。導入そのものが目的になると、効果を測る基準が定まらないためです。問い合わせ対応の時間と回答の下書き時間は数字で、根拠の表示は条件として書き表します。
- 対応時間:問い合わせ対応を30分から10分へ短縮
- 下書き時間:回答の下書き作成を1件あたり15分削減
- 根拠表示:検索結果への根拠文書の必須表示
利用者数、1日あたりの質問数、許容応答時間、月額費用の上限も、この段階で決めておきます。さらに、誤回答が出たときに人が確認する条件も定めます。
SharePoint、ファイルサーバー、Blob Storage、SQL、CRMなどのデータ源を洗い出します。そのうえで、正本かどうか、更新頻度、公開期限、個人情報や機密情報の有無、閲覧者を一覧にまとめます。
代表質問を100〜300件程度集め、それぞれに正答、根拠、回答不可の条件を用意しておきます。こうして用意した質問と正答は、後のRAG評価と受け入れテストで使います。
要件整理では、目的と対象利用者、対象データを最初に確かめます。そのうえで、設計と評価の前提になる条件を、次の項目で決めておきます。
- 権限:利用者ごとに、閲覧できる範囲と操作できる範囲
- KPI:効果を測る指標
- 禁止事項:入力を認めない情報や、させない操作
- 費用上限:月額費用の上限
- 責任者:運用と判断を受け持つ人
2. 選定:モデル・リージョン・構成方式の比較
処理内容と運用要件を照らし合わせると、モデルやデプロイ方式の候補を絞り込めます。
- 要約・分類:小型モデルが候補
- 複雑な判断補助:高性能モデルが候補
- 夜間の大量文書処理:Batch APIが候補
- 対話のスループットと費用:一定のスループットと予測しやすい費用が必要な場合のProvisioned Throughput(PTU)が候補
実際の候補は、提供リージョン、利用可能なモデル、契約条件によって変わります。そのため、公開前と発注前に、Microsoftのモデル一覧と価格ページを確認します。
データの処理場所も、選定の条件になります。公式価格ページでは、StandardとProvisionedに、Global、Data Zone、Regionalのデプロイ区分があります。
Batch APIはGlobal Standard価格の50%割引で、24時間以内に結果を返す方式として案内されています(出典: Microsoft Azure「Azure OpenAI Serviceの価格」、2026年8月確認)。
機密性、レイテンシー、可用性のうち、優先する項目を決めます。費用も含めて考えます。特に、「Azureだから安全」と判断すると、リージョン制約を見落としかねません。
3. 設計・開発:RAG・権限・業務APIの一体実装
社内文書検索では、RAG(検索拡張生成)を採用するケースが多くあります。その場合、文書を意味のまとまりで分け、メタデータと埋め込みを付けて、検索基盤へ登録します。
- 文書を意味のまとまりでチャンク分割する
- タイトル、部署、適用日、機密区分などのメタデータを付ける
- 埋め込みを作成し、Azure AI Searchへ登録する
- 質問時にキーワード検索とベクトル検索を組み合わせ、関連文書を取得する
- 取得した根拠をAzure OpenAIへ渡す
Microsoft Learnも、この流れと同じ順序の設計を示しています(出典: Microsoft Learn「AzureでのRAGソリューションの設計と開発」、2026年確認)。
本番での品質は、モデルの選択よりも、データ更新と権限設計に左右されます。そこで、ユーザーのEntra IDや所属をもとに検索結果を絞り、権限外の文書がプロンプトに入らないようにします。
Azure AI Searchのagentic retrievalは、複雑な質問を複数の検索に分解し、複数ソースを並列に調べます。また、引用や実行情報を含む構造化結果を返します(出典: Microsoft Learn「RAG and Generative AI – Azure AI Search」、最終更新2026年8月4日)。
機能の成熟度や運用要件によっては、単純なClassic RAGのほうが制御しやすい場合もあります。
業務システムを更新するエージェントでは、関数を呼び出す前に、認可と入力検証を行います。加えて、二重送信防止、人の承認、監査ログも設けます。
たとえば、AIが在庫更新の候補を作り、業務APIが権限を検証したうえで、担当者が承認した場合だけ更新する形です。このように、どこまでをAIが受け持ち、どこから人が判断するかを決めます。
画面やAPIのほか、データ処理とログを分けて実装します。Infrastructure as Code(IaC)や秘密情報も、分けて実装します。そうしておくと、将来のモデル変更やベンダー変更にも、変更の範囲を絞って対応できます。
4. テスト:正答率に加え、権限・費用・遅延の測定
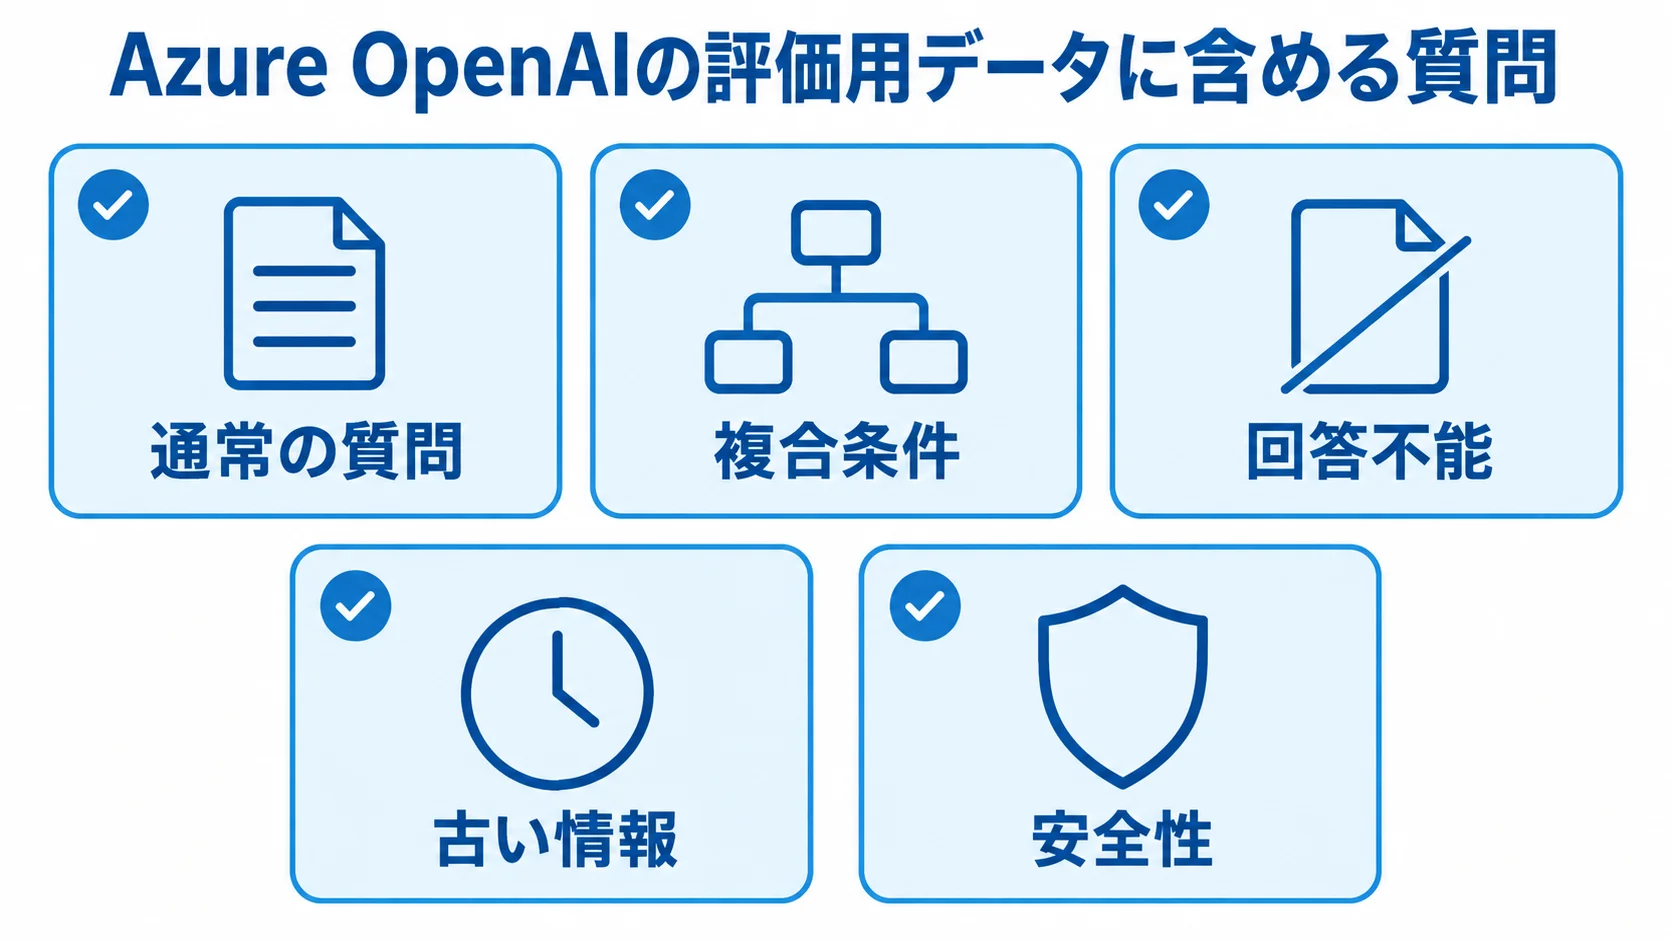
回答の正しさに加えて、根拠、権限外情報の有無、回答不能時の振る舞いを確認します。評価用データには、次の5種類の質問を含めます。
- 通常の質問:代表的な質問と言い換え質問
- 複合条件:複数条件を含む質問
- 回答不能:文書に答えがない質問
- 古い情報:古い文書を参照してはいけない質問
- 安全性:権限外データを狙う質問やプロンプトインジェクション
非機能テストでは、同時接続数とピーク時の応答時間を測定します。タイムアウトと再試行、モデル障害時の代替メッセージも確かめます。
ログのマスキング、月間トークン量、検索インデックスの更新遅延も測定対象です。
合格基準は案件ごとに合意しておきます。たとえば、根拠提示率90%以上、権限外文書の表示0件、P95応答時間5秒以内といった基準を設定できます。
月額上限を超えた場合に管理者へ通知する条件も、数値で決めます。ただし、ここに挙げた数値は基準の例です。
5. 稼働:限定公開から段階的な利用者の拡大
本番稼働は、対象部署と用途を絞った限定公開から始めます。その前に、次の案内と体制を整えます。
- 利用手順:回答をそのまま採用せず、根拠を確認して誤りを報告し、機密情報を入力しない方法
- 問い合わせ体制:窓口と障害時の連絡先
- 引き継ぎ基準:回答を人へ引き継ぐ条件と利用規約
- ログ管理:ログを確認する担当者
稼働初週の成果は、利用回数だけでなく、質問の種類と回答採用率で見ます。さらに、再質問率と有人エスカレーション率も確認します。
また、検索の失敗や拒否応答も見ます。トークン使用量と権限エラーも、あわせて確認します。回答を信用できず、別の検索へ戻る利用者がいる場合は、データ更新や引用表示を改善します。
段階ごとに、継続・修正・停止のどれにするかを判断します。安全を確かめながら、無理に展開を広げないことが大切です。
6. 定着:評価・教育・コスト管理の運用への組み込み
定着後は、納品して終わりにせず、評価と運用を続けます。教育や内製化も、あわせて進めます。また、文書の追加・削除の手順と、権限変更の反映を確認する方法も決めます。
- 定期評価:モデルや文書、質問傾向、プロンプトの変化に合わせた、評価データセットの再実行
- 変更記録:モデル、プロンプト、検索設定、インデックスの版の記録と、精度・根拠・拒否率・応答時間・トークン量の比較
- 役割分担:運用担当に割り当てる、月次の利用状況レビュー、コストアラート、インシデント対応、問い合わせの有人引き継ぎ
- 利用者教育:短い教材で伝える、得意・苦手な質問、個人情報を入力しないルール、回答根拠の確認方法
- 内製化:内製化を目指す場合は、ソースコード、IaC、設計書、評価データ、運用手順、モデル変更時の判断記録を納品物に含めることが有効
Azure OpenAIのシステム開発にかかる費用相場
システム費用には、モデルのAPI利用料のほかに、要件整理、データ整備、検索基盤が含まれます。また、アプリ開発や既存連携、セキュリティも費用の対象です。さらに、テスト、教育、保守も合算して考えます。
本番案件では、人件費とデータ・権限・運用の設計費が大きくなりやすい点に注意が必要です。トークン単価だけで安さを判断すると、予算不足につながります。
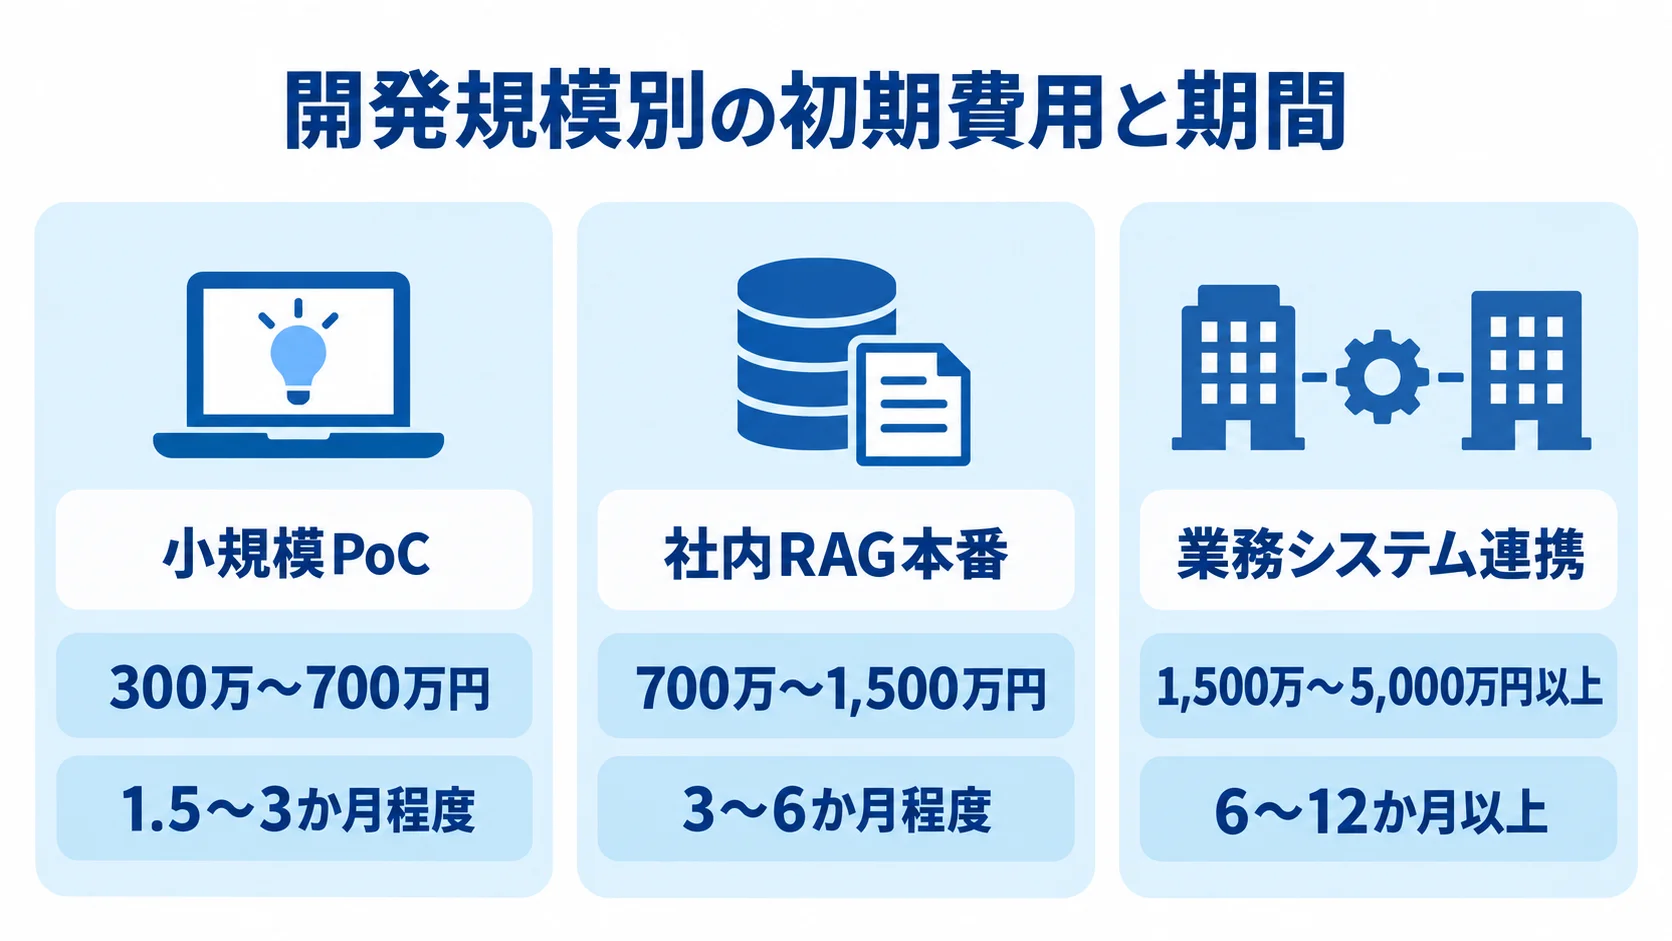
初期開発費の目安:PoCで300万〜700万円、本番RAGで700万〜1,500万円
規模別の推定額は、利用人数、文書数、連携や運用の範囲によって異なります。
小規模PoCは、1ユースケースで文書数が少ない場合の目安の一つです。
- 小規模PoC:10〜50人程度が使うチャット中心。初期費用300万〜700万円、期間1.5〜3か月程度。
- 社内RAG本番:複数部門、数百〜数千文書、権限連携、評価画面、監視を含む。700万〜1,500万円、3〜6か月程度。
- 業務システム連携:1,500万〜5,000万円以上、6〜12か月以上になる場合があります。
CRM、ERP、ワークフローなどの更新系APIを含む連携では、上記の費用や期間になる場合があります。権限や監査を含む連携も、同じ扱いになる場合があります。さらに、高可用性や既存ネットワーク接続まで含むと、費用と期間の見積もりが上がる傾向があります。
費用は、類似する業務システムの人月単価やAzure OpenAI案件の構成要素をもとにした推定です。具体的には、PM、SE、PGなどの工数を基に、データ量や連携数、非機能要件も踏まえています。
これは一律の公開価格ではありません(出典: NotebookLMリサーチノート「Azure・OpenAIのシステム」、2026年8月作成)。
要件と責任範囲によって費用は上下します。そのため、相場だけで発注額を決めつけないことが大切です。
月額費用の幅:利用量と構成で5万〜300万円程度
Azureなどの月額運用費の推定レンジは、規模や構成によって異なります。
- 小規模PoC:月額5万〜20万円
- 社内RAG本番:月額20万〜80万円
- 既存連携・高可用性あり:月額80万〜300万円程度
モデル利用料に加え、Azure AI SearchとApp ServiceやFunctionsも含めて考えます。StorageとSQLも、対象に入ります。
また、運用費にはネットワーク、Private Link、監視が含まれます。さらに、ログ保管、バックアップ、サポート契約も含めます。
保守・運用費は、初期開発費の年15〜25%程度を参考にできます。ただし、SLAや対応時間によって変わります。
モデル利用料は、入力と出力のトークン量で変わります。加えて、デプロイ方式やリージョンでも変わります。キャッシュや利用量も影響します。
OpenAI公式のGPT-4.1価格は、100万トークンあたり入力2ドル、出力8ドルです。GPT-4.1 miniは入力0.40ドル、出力1.60ドルです(出典: OpenAI「Introducing GPT-4.1 in the API」、2025年)。
これらはAzureの実価格とは別の、構成比較の参考値です。Microsoftは、契約、購入日、為替などでAzure価格が変わるため、料金計算ツールでの確認を案内しています。
試算例では、1日1万回、1回あたり入力4,000トークン・出力1,000トークンを30日使うと、入力1.2B、出力0.3Bトークンになります。
上記価格を単純適用すると、GPT-4.1は約4,800ドル、GPT-4.1 miniは約960ドル相当です。1ドル150円と仮定すれば約72万円、約14万円です。
この試算は、キャッシュやモデルの選び方で変わります。さらに、Azureのデプロイ方式や実際のプロンプト長でも変わる例です。
見積もりを取る際のポイント
「AI機能一式」のように一括で書かれた見積もりでは、中身を確かめにくいものです。そのため、成果物と前提条件を工程別に分けて比べます。
安い見積もりが、必ずしも優れているとは限りません。データ整備や権限、評価が抜けていると、本番移行の時点で追加費用が発生しやすくなります。監視や教育が抜けた場合も、追加費用が生じる場合があります。
見積項目の分け方:要件・データ・基盤・アプリ・評価・運用
見積書では、次の工程や成果物を分けて記載してもらいます。
- 要件・データ:要件定義、業務整理、データの洗い出しとクレンジング
- 基盤・アプリ:文書分割、インデックス、Azure基盤、ネットワーク、認証・権限、画面・API
- AI・連携:RAGまたはエージェント、既存システム連携
- 評価・運用:テスト、教育、移行、保守
各項目について、担当者、期間、前提を確認します。また、納品物や除外事項、追加費用の条件も見ます。
社内文書の整備を誰が担当するかも確認します。特に、PDFの文字崩れや重複文書、古い版は、モデルの性能とは別に手当てが必要です。画像内の文字やアクセス権限の不整合も、モデル性能とは切り離して考えます。
自社でデータ整備を行う場合は、見積もりに文書数、ページ数、更新頻度を明記してもらいます。担当工数と完了条件も、あわせて確認します。
AI Searchのインデックス作成後に、評価データを使った改善が何回含まれるかも確認します。
ベンダーに確認する本番運用と内製化の範囲
開発会社は、デモだけでなく、同じ業界・データ量・権限構成での本番実績を確認して選びます。提案の段階では、次の点を質問します。
- 品質・安全性:代表質問による評価、権限外データとプロンプトインジェクションへの対策
- 運用条件:処理地域、ログ保持期間、障害時の復旧方法、モデル変更への対応
- 体制:再委託先、実際の設計書、運用体制
AzureのSolutions Partnerなどの資格は参考にとどめ、設計と運用の実態を確認します。
内製化する場合は、ソースコードとIaCの引き渡し、評価データと改善手順の共有、アカウントやサブスクリプションの所有者を明確にします。
保守契約には、問い合わせ受付時間、障害の重要度、初動時間を含めます。さらに、復旧目標、モデル廃止時の移行、費用超過時の通知も盛り込みます。
相見積もりでは、同じ質問セット、文書量、利用者数を各社に渡します。同時接続数と目標KPIも、同じ前提で伝えます。そのうえで、価格だけでなく各社の対応範囲も比べます。
セキュリティの確認範囲:「学習利用なし」以外の項目
Microsoft Learnによると、Azureで販売されるモデルへのプロンプト、出力、埋め込みなどは他のお客様に提供されません。また、明示的な許可や指示なしに、基盤モデルのトレーニングにも使われないと説明されています(出典: Microsoft Learn「Microsoft Foundryにおけるデータ、プライバシー、セキュリティ」、2026年8月確認)。
ただし、アプリ側の権限設計やログ保管の責任は、自動で果たされるものではありません。そこで、ステートフル機能のデータ保持、不正使用監視、GlobalやData Zoneの処理場所を、構成ごとに確認します。
見積もりと設計では、次の項目をチェックリストに含めます。
- データと地域:個人情報・機密情報の分類、入力禁止データ、処理リージョン、Global/Data Zone/Regionalの選択
- アクセスと保護:Private Endpoint、Managed Identity、Key Vault、暗号化、RBAC、コンテンツフィルター
- 監査と継続:監査ログ、ログのマスキング、権限フィルタ、削除・更新反映、バックアップ、インシデント対応
要件を数値にし、承認者まで決めておくと、セキュリティ審査のやり直しを減らせます。
よくある質問
Azure OpenAIの導入では、ChatGPTとの違いや、PoCの期間がよく質問されます。社内データの安全性やRAGの精度も、質問の多い点です。発注や社内稟議の前に確認しておきたい点に、ここでお答えします。
Azure OpenAIのシステムはChatGPTと何が違いますか?
ChatGPTは、完成された対話サービスです。一方、Azure OpenAIのシステムは、Azure上のモデルを自社のアプリや業務データと組み合わせて作ります。
たとえば、Entra ID、Azure AI Search、業務APIを組み合わせ、業務に合わせた権限や操作フローを設計できます。ネットワークや監視も含めて組み立てられます。
その分、アプリ開発やデータ整備の費用と責任が発生します。さらに、セキュリティと運用の費用と責任も生じます。
Azure OpenAIのPoCはどのくらいの期間と費用が必要ですか?
小規模な1ユースケースでは、要件整理からデータ準備を経て、簡易RAGの作成、評価、報告まで行います。期間は1.5〜3か月、初期費用は300万〜700万円程度が推定の目安です。
文書数や権限連携、評価画面を含む範囲によって変動します。セキュリティ審査も含めるかどうかで、さらに変わります。PoCでは、代表質問と権限外質問への回答を確かめます。そのうえで、回答根拠、応答時間、費用を測り、本番化の条件を決めます。
RAGを使えばAzure OpenAIの回答は必ず正確になりますか?
必ず正確になるとは限りません。結果は、文書の正本性、チャンク分割、検索方式によって変わります。さらに、メタデータや権限フィルタの設計が影響します。プロンプトやモデル、評価データも、結果を左右します。
回答には根拠を表示し、答えがないときは「不明」と返します。また、重要な判断は人が承認する設計にすると、誤回答の影響を抑えられます。
社内データをAzure OpenAIに入力しても学習に使われませんか?
学習利用の条件と、アプリ側で定めるデータ管理を、分けて確認します。
- 他のお客様への提供:Azureで販売されるモデルのプロンプトや出力などは提供されないとMicrosoft Learnで説明されています。
- 基盤モデルの学習:明示的な許可や指示なしに、トレーニングへ使われないとされています(同Learn)。
- 構成ごとの扱い:アプリのログ、ステートフル機能、アップロードデータ、不正使用監視、処理リージョンで異なります。
- 自社での確認:契約と公式ドキュメントを確かめ、入力データの分類、保持期間、アクセス権限、削除手順を自社規程に反映
まとめ
Azure OpenAIのシステム開発は、モデルを画面に組み込んで終わりではありません。まず要件整理で目的とKPI、対象データを決め、権限と費用上限も、この段階で定めます。
選定ではモデル、リージョン、構成方式を比べ、設計・開発ではRAGと認証、業務API、ログを実装します。
6フェーズごとの成果物と合格条件
要件整理ではKPIと対象データ、選定ではモデルと処理地域を確認します。設計・開発ではRAG、権限、APIを扱い、テストでは品質と費用を測ります。
稼働では限定公開、定着では評価と教育を進めます。次へ進む条件と見直す条件を決めておくと、デモが動いたことだけで本番公開するリスクを抑えられます。
費用・責任・運用を含めた本番化の判断
本番化では、品質と費用、運用体制、継続改善の観点を合わせて判断します。
- テストと稼働:正答率、根拠、権限、応答時間、費用を測定し、限定公開からの稼働
- 定着後の運用:評価データ、コストアラート、教育、モデル変更への回帰テストを組み込んだ運用
- 外部委託の確認:初期費用に加え、データ整備、セキュリティ、保守、ソースコードとIaCの引き渡し範囲の比較
- 継続改善:AIの性能に加え、データと人の業務プロセスを改善する仕組みづくり
▼全体ガイドの記事
・Azure OpenAIのシステム開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。