
Azure Service Busのシステム開発は、要件整理から定着まで6つのフェーズを順に進めます。要件を整理する段階で失敗時の動きまで決めておくと、導入後の運用で起きる問題を減らせます。
▼全体ガイドの記事
・Azure Service Busのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Azure Service Busのシステムの概要
Azure Service Busは、注文受付と在庫管理、請求、通知などの間に入って連携を受け持つサービスです。販売管理や在庫管理そのものを提供する業務アプリケーションとは異なります。
業務イベントをメッセージとして一時的に保持し、受信側へ確実に渡す仕組みです。Microsoft Learnでは、アプリケーションやサービスを疎結合にし、負荷分散や信頼性の高い転送を実現するサービスとして位置付けられています。
QueueとTopic/Subscriptionの使い分け
どちらを選ぶかは、連携先の数と、イベントを届ける先の数で決まります。
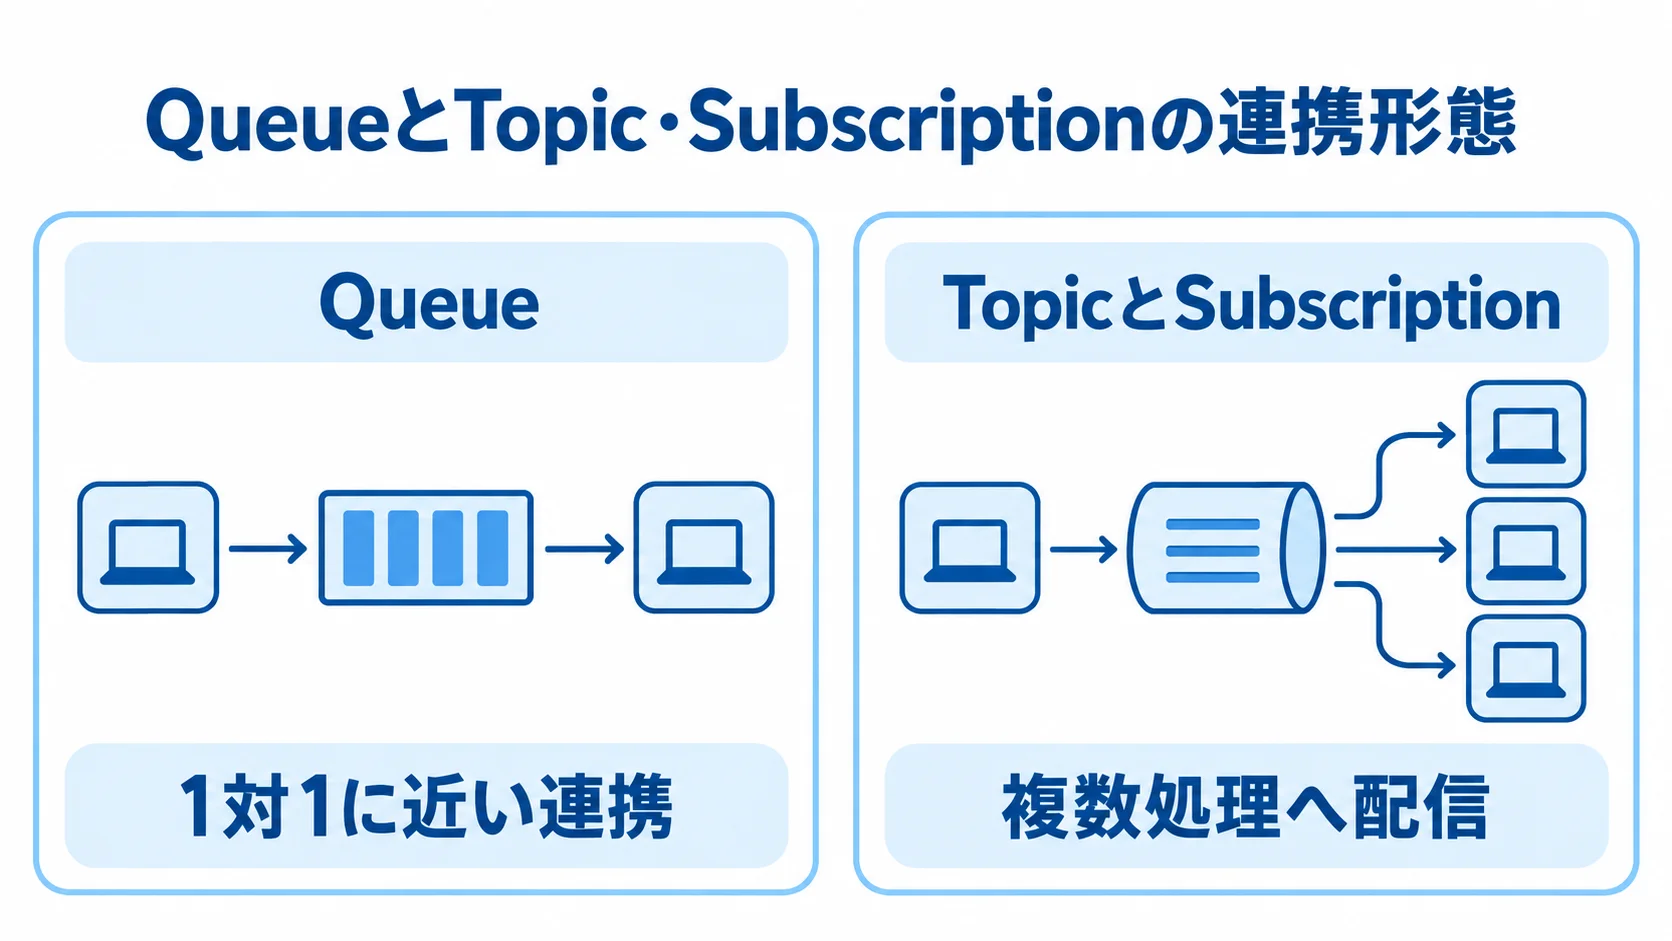
- Queue:送信側から受信側へ渡す1対1に近い連携
- TopicとSubscription:1つのイベントを複数処理へ配信するPub/Sub型連携
注文後の請求処理をQueueで非同期化する場合、請求完了を待たずに受付結果を返せます。ワーカーが停止している間もメッセージはQueueに残るため、復旧後に処理を再開できます。
注文イベントは、在庫や配送のほか、分析や顧客通知の処理にも届けられます。Subscriptionごとにフィルターを設定でき、たとえば国内注文を配送サービスへ、一定額以上の注文を審査サービスへ振り分けることも可能です。
購読先が増えると、フィルター評価や監視対象も増えます。そのため、購読先ごとの責任者と、停止時の扱いを先に決めておきます。
Service Busの採用判断
採用を判断するときは、システムがどこにあるかだけでなく、業務イベントの性質も確認します。
- 非同期化:同期APIで相手の完了を待たず、障害後に再処理したい業務イベントに向きます
- 即時応答:数百ミリ秒以内の応答が必要で、途中状態をすぐ返す場合は、全処理の非同期化が複雑になることがあります
- 選択先:単純通知はEvent Grid、大量ログや順序付きストリームはEvent Hubs、業務コマンドはService Busが候補です
業務コマンドのなかでも、再試行やDead-letter、Topicの購読管理を重視する場合は、Service Busの機能を生かせます。
RabbitMQなどを自社で運用すると、パッチや可用性、バックアップ、監視の責任が増えます。候補を選ぶときは、1秒あたりの件数と許容遅延を中心に比べます。保持期間や再送の要否、機密性も確認します。
Azure Service Busのシステム開発の進め方
Queueの作成より前に、業務イベントの意味と責任範囲を整理します。そのうえで、信頼性、セキュリティ、運用水準を決め、構成を選びます。
1. 要件整理:業務イベントと失敗時の動きの定義
まず、非同期化する候補を業務の流れに沿って洗い出します。
- 対象イベント:注文受付、在庫引当、出荷指示、請求確定、メール通知など
- 連携条件:送受信元、1日平均・秒間ピーク件数、許容遅延、保持期間、再送可否、個人情報の有無
- 失敗時の扱い:Dead-letter Queueへ移す回数、検知担当・時間、再送単位
- データと成果物:個人情報を含めずIDだけを渡せるか確認し、要件整理の成果物をまとめます
キャンペーン開始時や締め処理時の集中に備えるには、1日平均の件数だけでは足りません。
成果物は5点です。連携一覧とメッセージ項目定義、エラー分類を含み、残りはSLOと責任分界です。これらをそろえておくと、発注先との認識がずれにくくなります。
2. 選定:Service Busと周辺サービスの役割分担
要件をもとに、QueueとTopicのどちらを使うか、Sessionsを使うかを決め、階層も選びます。
- Queue・Topic:連携先に応じて選び、順序性が必要な場合はSessionsを検討します
- 重複検出:MessageIdを業務IDから再現できる設計にします
- Standard:開発・QAや低〜中スループットの本番向け。操作数は毎秒1,000が目安です
- Premium:専用MU、Geo-Replication、100MBまでのメッセージが必要な場合の候補です
注文番号などをSession IDにすると、FIFOを実現できます。ただし、セッション単位で詰まると後続も待つことになるため、順序性が必要な業務に限って使います。
Premiumは、Messaging Unit(MU)単位で専用リソースを確保する階層です。性能やレイテンシーを予測しやすくしたい本番にも向きます。
この目安は、Microsoft Learnの2026年2月更新情報を基にしています。一方で、PremiumのスループットはMU数やワークロードの特性で変わるため、検証環境でピークを再現し、想定値で判断します。
3. 設計・開発:イベント契約、冪等性、権限の先行整備
設計では、JSONの項目一覧にとどめず、イベント契約と障害時の動作、権限、監視まで定義します。
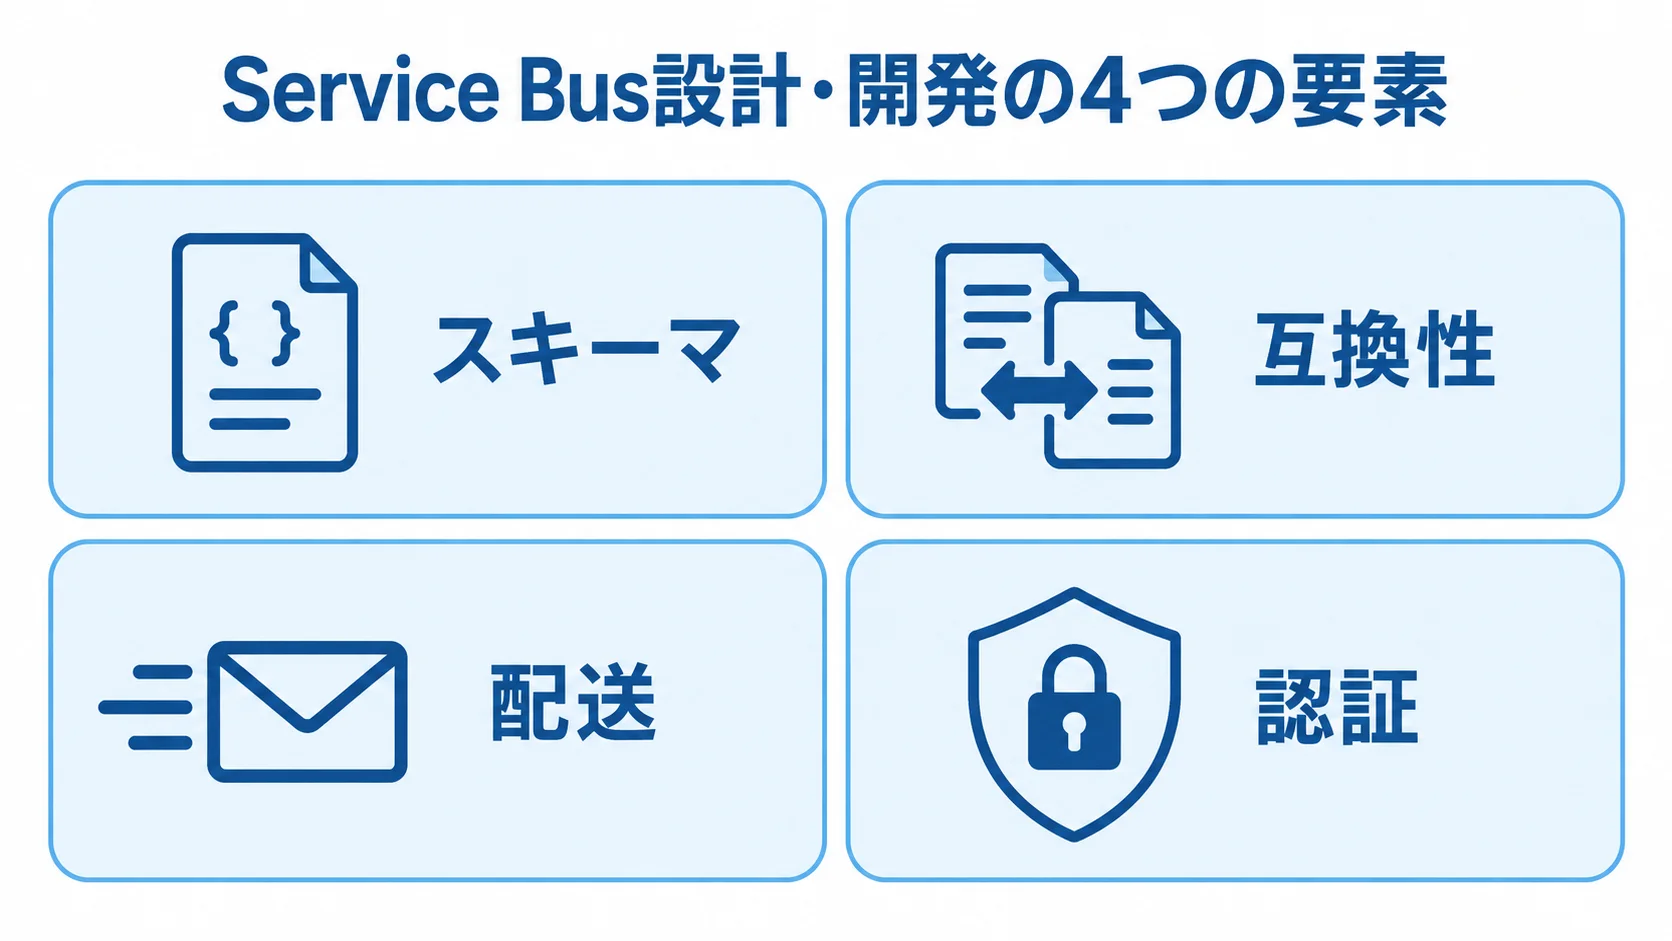
- スキーマ:イベント名、版、発生日時、一意キー、送信元、相関ID、再送回数、個人情報分類、保持期限
- 互換性:旧版を一定期間読めるようにし、一斉リリースは避けます
- 配送:少なくとも1回の配送とPeek-lock中の再配信を前提にします
- 認証:Entra ID、Managed Identity、RBACの最小権限を使います
- 接続・監視:オンプレミス接続と業務単位の監視項目
Peek-lock中に障害が起きると、同じメッセージが再配信される可能性があります。そのため、MessageIdや業務IDによる冪等性を受信側に持たせておきます。
送信側でタイムアウトが起きたときは、送信済みかどうかを判定できない場合があります。そこで、業務側の一意制約やInbox/Outboxも組み合わせます。
長期的に使う接続文字列やSASキーは、アプリケーションに埋め込まないようにします。オンプレミスと接続する場合は、VPNやExpressRouteなどの経路を確認します。あわせて、Private Endpoint、名前解決、送信元IP制御も確認します。
Azure MonitorとApplication Insightsでは、業務単位で成功率、滞留数、Dead-letter数を追います。また、処理時間、再試行回数、スロットリングも業務単位で監視します。
4. テスト:正常系より先の失敗系検証
送受信が成功しただけで合格とせず、失敗時の動作とピーク負荷も検証します。
- 障害試験:受信停止、DBタイムアウト、外部APIの5xx、権限不足、ネットワーク断
- メッセージ試験:二重送信、順序逆転、有効期限切れを意図的に起こします
- 負荷試験:ピーク送信数、購読先、フィルター、接続数、メッセージサイズを組み合わせます
各ケースでは、再試行の有無、Dead-letterへの移動、利用者への通知を確認します。
Standardは共有リソース上で、クレジット制のスロットリングが発生します。また、毎秒1,000クレジットを超える利用や、Topicの購読先・フィルター評価が増えた場合も測定します。
試験の結果は、MU数や受信ワーカー数、リトライ間隔を決める根拠になります。そのため、見積書と運用設計書にも残します。
5. 稼働:段階移行と復旧手順の実行
本番では、全件を一度に切り替えず、対象の業務や拠点を限って段階的に移行します。
- 切替準備:二重送信防止、未処理メッセージ、ロールバック判断者、切替時間帯の連絡先を明文化します
- データ移行:業務IDとメッセージIDを照合し、再送時の二重登録を防ぎます
- Geo-Replication:役割、昇格判断、接続切替、未処理メッセージを訓練します
Microsoft Learnの2026年更新情報では、Geo-Replicationがメタデータとメッセージデータを複製すると説明されています。なお、Premium専用で、現時点のセカンダリは1つです。
フェイルオーバーは、自動復旧を前提にせず、手順として検証しておきます。DRを導入する場合は、年1回以上の復旧訓練を契約範囲に含めます。
6. 定着:監視と再処理の運用への組み込み
稼働後に差が出るのは、Dead-letterや滞留メッセージを処理する担当者です。何件で通知するか、一次切り分けの項目もRunbookに書いておきます。
- 再処理:請求・在庫など影響が大きい業務は権限を限定し、承認者を置きます
- 月次確認:中央値に加え、95パーセンタイル遅延、再試行率、DLQ移行率、ピーク時滞留時間、業務完了時間
- 変更管理:SDK・ランタイム更新、脆弱性、契約、購読先の変更を定例会で管理します
再送前のデータ修正と、再送後の結果確認も、Runbookに含めます。
開発会社への依頼では、ソースコードに加えてIaCと監視設定を納品物に含めます。さらに、メッセージスキーマや障害訓練記録、運用手順書も納品物に加えます。こうした資料をそろえておくと、知識が特定の担当者に集中しにくくなります。
Azure Service Busのシステム開発費用相場とコストの内訳
費用には、名前空間の設定だけでなく、既存APIやDBの改修とメッセージ契約も含まれます。連携先や監視、試験も対象です。セキュリティや移行、保守も含めて見積もります。
この金額は、日本国内の受託開発を想定した企画用の目安で、正式な見積もりではありません。実額は、為替や契約形態、リージョン、要件の確定度によって変わります。
初期開発費を左右する連携規模と失敗系の深さ
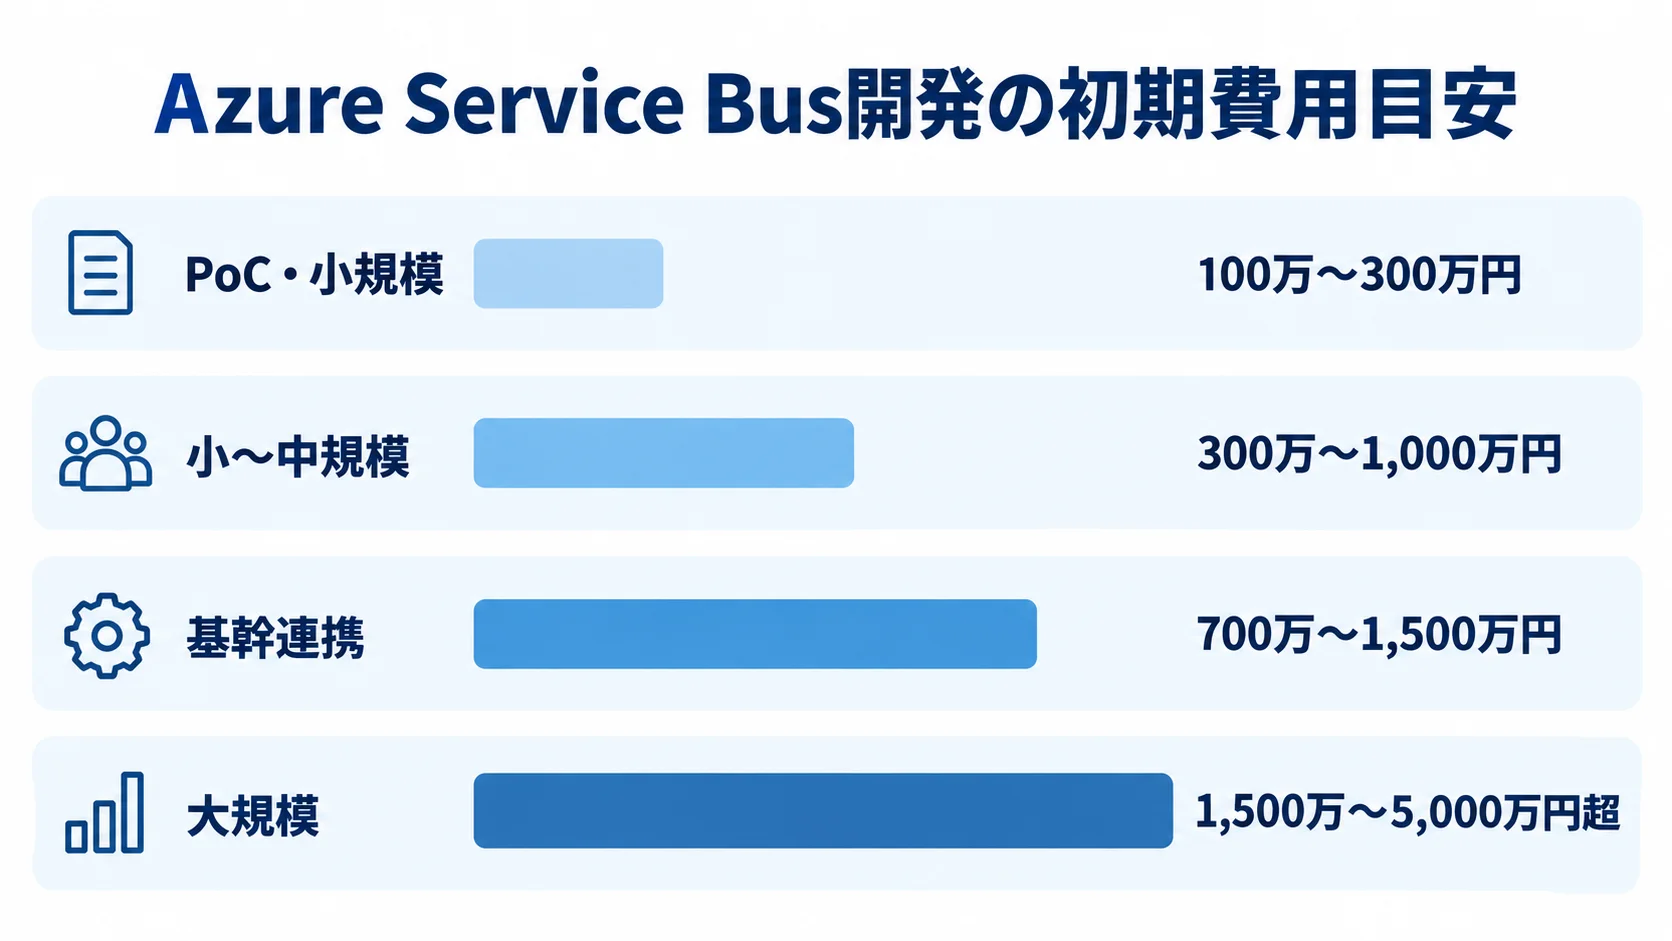
PoCから大規模な基幹連携まで、構成と求める運用水準に応じて初期費用に幅があります。
- PoC・小規模:100万〜300万円、1〜2か月
- 小〜中規模:300万〜1,000万円、3〜6か月
- 基幹連携:700万〜1,500万円、5〜8か月
- 大規模:1,500万〜5,000万円超、8〜12か月または1〜2年
PoCや小規模の案件は、1〜2システムの間にQueueを1本から数本置き、基本的な再試行と監視を整える想定です。一方で、3〜10連携先の基幹連携では、冪等性と監査ログを整えたうえで、Private Endpointや負荷試験、障害訓練まで行う想定です。
小〜中規模は、既存APIやDBと接続し、複数のQueueとTopic、権限、運用画面を整えます。
大規模案件では、複数の業務ドメインや二地域DRを含みます。あわせて、移行や24時間運用、厳格なSLAも見込みます。
これらは、業務システム一般の相場をAzure連携へ適用した推定で、Service Busだけの設定費ではありません。
Azure利用料と周辺インフラ費を分けた見積もり
月額予算では、Service Busの階層料金に加えて、ワーカーや監視基盤などの周辺費用も見込みます。
- 周辺サービス:Functions、Container Apps、DB、ログ、ネットワーク、バックアップを分けます
- Standard単体:月数千円〜数万円
- Premium:1 MUは月5万〜15万円、2 MUや二地域構成は月10万〜40万円程度
- 周辺インフラ込み:小規模本番は月5万〜20万円、中〜大規模は月20万〜100万円超の可能性
Microsoft Azureの公式料金ページは、表示価格を見積もりとして扱うよう案内しています。契約条件や購入日、通貨換算によって、実額が変わるとしています。
Premiumは専用MUを確保するため、メッセージ件数だけでなく、割り当てたMUと稼働時間も確認します。金額は、契約やリージョン、為替によって変わります。さらに、購入時点によっても違うため、料金計算ツールで再計算してください。
保守費に含める監視・再処理・更新の範囲
保守費の目安は、初期開発費の年15〜25%、または月額5万〜50万円以上です。メール対応だけか、24時間365日の一次監視まで含むかによって、体制は変わります。
- 監視・復旧:メール対応、24時間365日監視、ワーカー再起動を確認します
- 保守作業:Dead-letter調査・再処理、SDK更新、脆弱性対応、DR訓練
- 契約条件:対応時間、対象環境、月間作業時間、緊急対応料金を比べます
見積もりの精度が低いまま始めると、工数が増えます。メッセージ契約の変更や連携先の追加、審査、テスト環境の不足が重なるためです。また、リサーチノートで参照した業務システム一般論では、仕様が不明瞭な場合に工数や費用が1.3〜1.5倍へ膨らむ可能性が示されています。
未確定項目をすべて確定できなくても、リスクとして金額とともに分けて記載してもらいます。
Azure Service Busの見積もりを取る際のポイント
見積もりを比べるには、Queueの本数よりも先に、連携先の改修や認証、監視に加えて、テストや移行、運用の条件をそろえます。そのうえで、初期費用とAzure利用料、保守費に分けて比べ、前提と除外事項も確認します。
RFPに確認項目を含めておくと、提案の抜け漏れを見つけやすくなります。
同じ書式で渡す要件と前提条件
RFPには、送信元と受信先、QueueまたはTopicの候補を記載します。1日平均とピーク時のメッセージ数、最大メッセージサイズも併せて示します。
許容遅延、保持期間、購読先数も記載します。加えて、順序性の単位や重複不可の処理、最大再試行回数も明記します。
- 業務条件:DLQ保管期間、再処理承認者など、業務ごとに決める取り決め
- 不明項目:空欄にせず、提案者が確認すべき質問として一覧にします
- セキュリティ:個人情報・決済情報、保管地域、Entra ID、Managed Identity、RBAC、Private Endpoint
- 監査:ログのマスキング、脆弱性対応、監査ログの保存期間を確認します
個人情報を扱う場合は、個人情報保護委員会のガイドラインを踏まえます。委託先と再委託先の安全管理措置、契約、監査方法も、提案範囲に含めます。
複数社の比較と、成果物・責任分界の確認
各社の見積もりは、価格順ではなく同じ前提で比べ、作業範囲と費用配分を確認します。
- 作業範囲:Azure設計、SDK、IaC、API・DB連携、試験、監視、移行、引き継ぎ
- 費用配分:要件定義10〜12%、設計・環境構築22〜24%、実装48〜50%、テスト15〜17%
- 失敗系:二重受信、Dead-letter確認、二重請求防止、順序キー、PremiumのMU根拠
本番運用の事例に加えて、同じメッセージが2回届いた場合の扱いも質問します。あわせて、送信タイムアウト後の二重請求防止策や、Dead-letterの確認担当と時間も確かめます。
順序を守るキーやPremiumのMUの根拠も尋ね、その回答を各社の比較に使います。公開事例がない場合は、実績を断定せず、PoCと負荷試験で技術力を確かめる契約にします。
契約前に管理する費用増加のリスク
費用が増えやすい要因を契約前に確認し、担当範囲と納品条件も決めておきます。そのうえで、提案書では確定作業と未確定作業を分け、追加費用が発生する条件を記載してもらいます。
- 増額要因:連携先追加、仕様不足、項目変更、審査長期化、ネットワーク調整、テストデータ不足
- 追加費用:連携先1つの単価、購読先追加の影響、後日DR導入の差額を確認します
- 発注側の担当:業務説明、セキュリティ承認、障害判断、再処理承認を割り当てます
- 納品物:構成図、スキーマ、RBAC、アラート、Runbook、試験・訓練記録を受け取ります
担当者が不明だと、技術的に正しい仕組みでも運用が止まることがあります。このため、担当者以外でも復旧できる状態を納品の合格条件にします。
Azure Service Busのシステム開発でよくある質問
料金や構成は案件ごとに変わるため、判断の軸を持っておくと、社内説明や開発会社との打ち合わせを進めやすくなります。
Azure Service Busを使ったシステム開発はいくらかかりますか?
企画段階の目安は、PoCや小規模が100万〜300万円、小〜中規模が300万〜1,000万円です。中規模以上では700万〜1,500万円、大規模・基幹連携では1,500万〜5,000万円超が目安になります。
費用は、Service Busの設定に加えて、既存システムの改修や監視、テストの範囲で変わります。さらに、セキュリティや移行、保守の範囲でも変わるため、金額と見積範囲を比べてください。
StandardとPremiumはどちらを選べばよいですか?
開発・QAや低〜中スループットで、共有リソースの影響を許容できる場合はStandardが候補です。
一方で、高いスループットや予測しやすいレイテンシーが必要な場合は、Premiumを検討します。専用リソース、Geo-Replication、大きなメッセージが必要な場合も、Premiumが候補になります。
まずピーク負荷と障害時のSLOを検証し、Standardでは不足する根拠がある場合に、Premiumへ上げる考え方が安全です。
メッセージの重複や順序逆転は防げますか?
重複検出やSessionsで軽減できます。ただし、Service Busだけで業務処理のExactly-onceを保証することはできません。
Peek-lockによる再配信を前提に、MessageIdや業務IDで冪等性を持たせます。あわせて、DBの一意制約やInbox/Outbox、Dead-letterからの再処理手順も設計します。
順序性はSession ID単位で管理し、並列処理との兼ね合いを負荷試験で確かめてください。
オンプレミスの基幹システムとも接続できますか?
接続できますが、ネットワークと責任分界を先に確認します。そのうえで、VPNやExpressRouteなどの経路と、Private Endpointの構成を設計します。あわせて、名前解決やプロキシ、ファイアウォール、認証方式も設計します。
特に、基幹側の処理が一度しか実行できない場合は、再送時の重複登録を防ぐ業務キーと、障害時に手動で照合する運用を用意してください。
まとめ
QueueやTopicを作ることより、業務イベントの境界や失敗時の再処理、重複対策の設計が重要です。さらに、監視や権限、運用責任まで設計しておく必要があります。
要件整理から定着までの6フェーズを順に進めると、「メッセージは届いたが業務が完了していない」という問題を減らせます。
連携一覧と失敗時のチェックリストの作成
発注前に、連携先やピーク件数、最大遅延、順序性を1枚に整理します。重複不可の処理、Dead-letterの通知と再送、個人情報の扱いも、同じ紙に書き込みます。認証や監視、DR、納品物も、この1枚に含めます。
費用は、開発費やAzure利用料、周辺インフラ費、保守費に分けます。そのうえで、未確定条件を明記し、複数社から相見積もりを取ります。
技術実績に加えて、障害時に誰がどの手順で業務を復旧するかを説明できるパートナーを選ぶことが、長く使えるシステムにつながります。
小さな検証から始める本番範囲の拡大
まずは単一の業務イベントを検証し、本番へ広げる際の構成と運用条件を具体化します。
- 動作確認:1つの業務イベントで正常系・失敗系を試し、処理時間、再試行、重複、Dead-letter、運用通知を確かめます
- 本番構成:結果からStandardかPremiumか、FunctionsやContainer Appsなどのワーカー、監視・保守体制を決めます
▼全体ガイドの記事
・Azure Service Busのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。