
バギング(Bagging、Bootstrap Aggregating)は、元データから作った異なるサンプル集合で複数のモデルを学習し、その予測を投票や平均で集約するアンサンブル学習です。
ランダムフォレストは、この仕組みを広げた代表的な手法です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
バギングの仕組みとばらつきの平均化
まず、元データから復元抽出(抽出したデータを戻してから次を選ぶ方法)で、元データと同じ件数のブートストラップ標本を作ります。そのうえで、標本ごとに基底モデルを独立に学習します。
学習したモデルの予測は、分類では多数決や確率平均、回帰では予測値の平均でまとめます。この方法の主な狙いは、サンプルの違いによる予測の揺れを抑えることです。
バギングを拡張したランダムフォレスト
ランダムフォレストは、バギングと同じく標本ごとに決定木を学習して集める手法です。ただし、構成や集約の効果、柔軟性の面で違いがあります。
- 構成:サンプルと特徴量候補をランダム化した決定木の集合
- 集約効果:木同士の相関を下げ、集約の効果を高める仕組み
- バギングの柔軟性:基底推定器や特徴量抽出を目的に応じて選べる点
- 選び方:両者の違いを踏まえた使い分け
バギングの基底モデルとサンプリングの設定手順
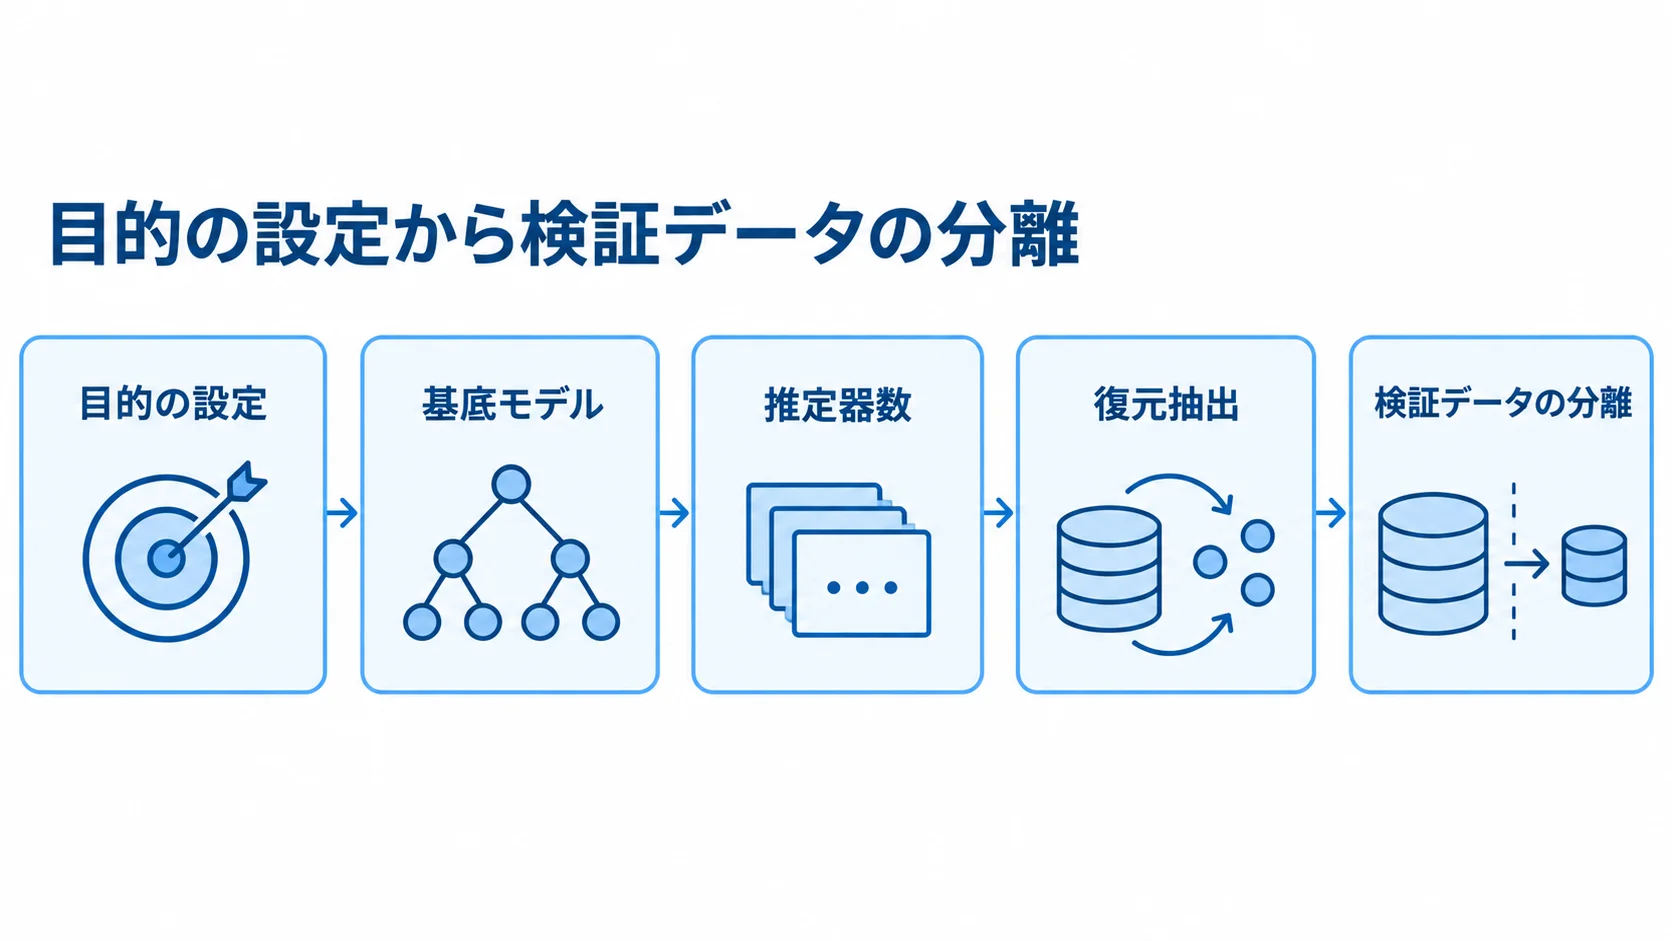
導入では、次の順に設定を決めていきます。
- 扱う問題(分類、回帰、異常検知)の決定と、評価指標の設定
- 決定木、線形モデル、近傍法などからの基底モデルの選定と、分散・計算量の確認
- 推定器数を変えたときの、精度の向上と推論コストの測定
- 復元抽出、サンプル比率、特徴量の範囲の設定
- 各標本とテストデータの重複や前処理の漏えいの防止と、検証の分離
未使用サンプルとOOB評価
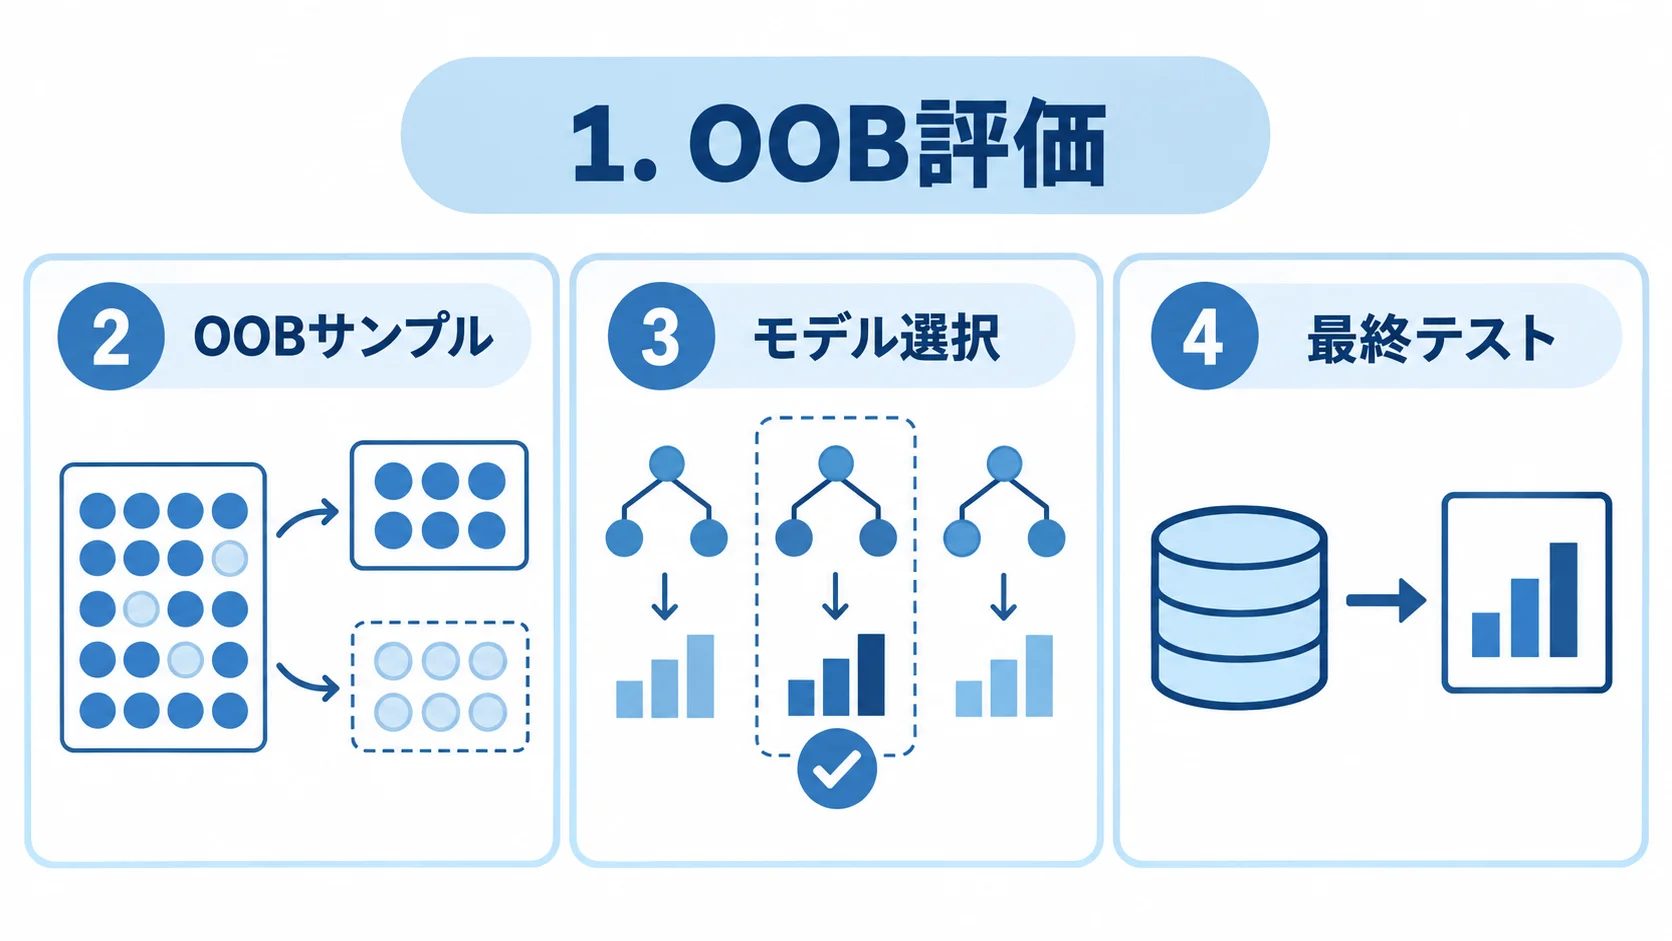
復元抽出では、各モデルの学習標本に含まれないサンプルが生じます。こうしたサンプルは、out-of-bag(OOB)サンプルと呼ばれます。
OOBサンプルは評価に使える場合があります。ただし、最終テストの代わりにしすぎず、モデル選択と最終評価を分けて扱います。
精度だけでなく安定性とコストの評価
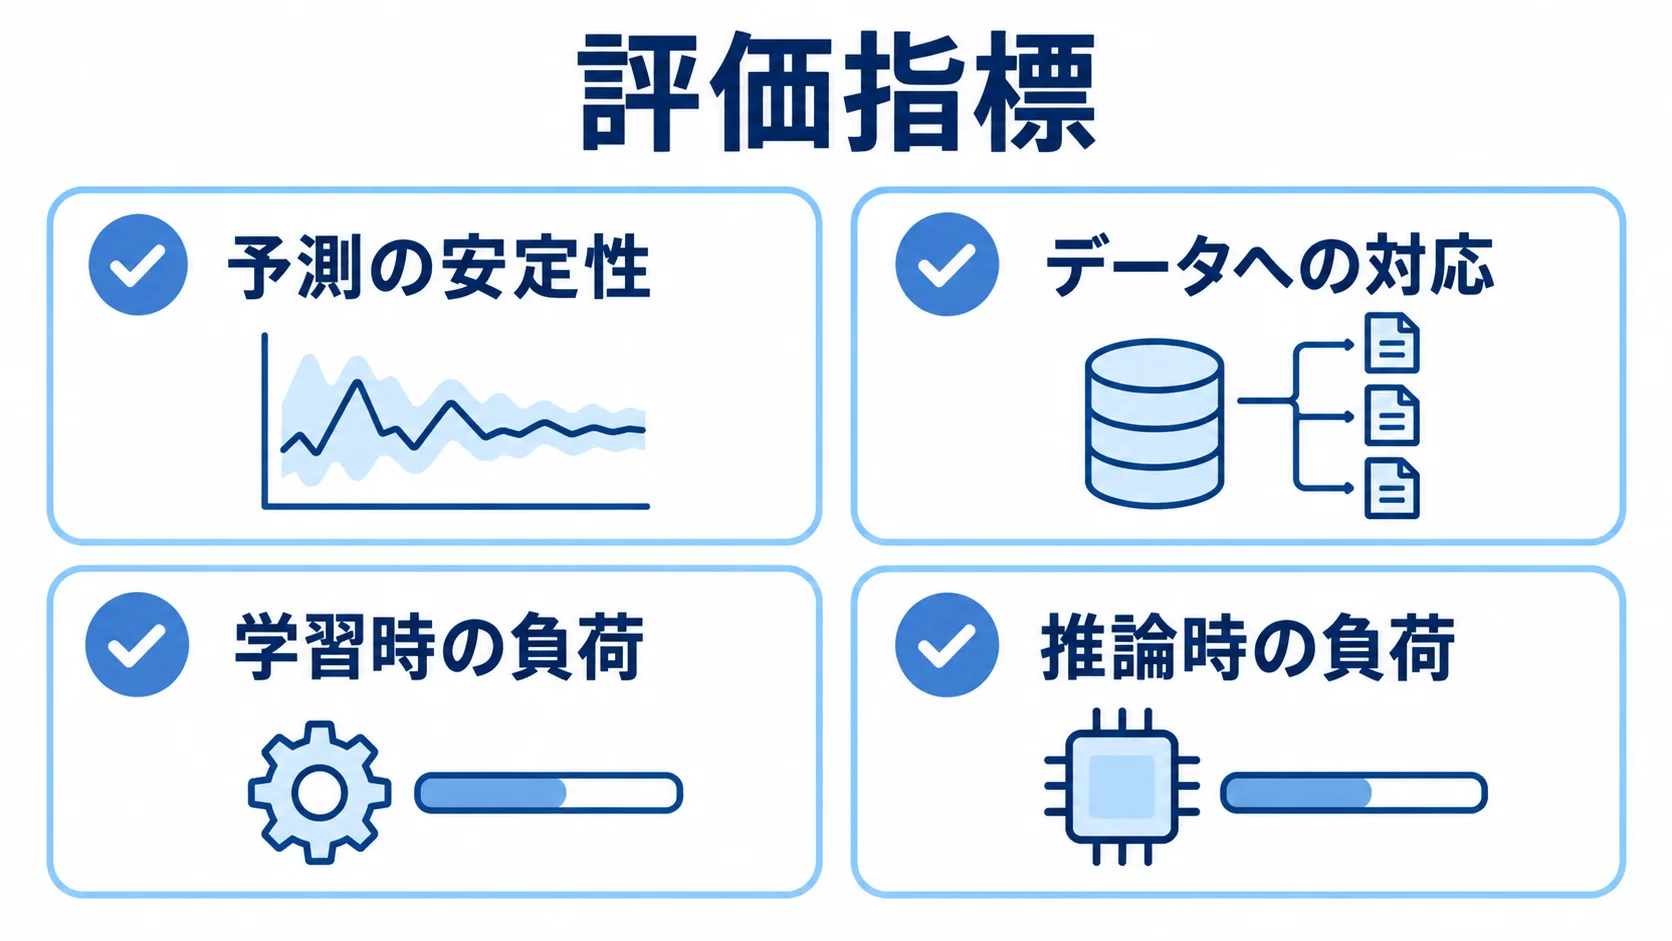
単一モデル、バギング、ランダムフォレストなどを同じ分割で比べる際は、平均性能に安定性と運用の負荷を合わせて見ます。
- 予測の安定性:平均性能とシード間のばらつき
- データへの対応:少数クラスと外れ値の扱い
- 学習時の負荷:学習時間とモデルサイズ
- 推論時の負荷:推論遅延
- 確率予測の品質:確率平均を使う場合の校正
バギングで起きやすい失敗と対策
モデル同士が似すぎている場合
モデル同士が似ていると、集約しても効果を得にくい場合があります。まず、サンプル、特徴量、初期値の多様性を確かめ、単一モデルと比べます。
前処理や分割による漏えい
前処理の漏えいを防ぐには、データを分割した後に、学習データだけで前処理を当てはめます。テストデータの情報が学習に入り込むと、評価が実際より良く見えてしまいます。
推論コストの増加
推論コストは、推定器数や深さを変えて比べながら調整します。そのうえで、並列化やモデル圧縮も候補にして、遅延上限を守れる構成を選びます。
バギングによる予測の安定化
バギングでは、ブートストラップ標本ごとに基底モデルを学習し、投票や平均で予測をまとめます。これにより分散が抑えられ、決定木などと組み合わせて使われます。
推定器の多様性やOOB評価を確かめ、漏えいや少数クラスへの対応も検討します。さらに、モデル数と推論コストを踏まえ、単一モデルや他のアンサンブルと比べます。
よくある質問(FAQ)
バギングについてよくある疑問に、質問ごとに答えます。
Q. バギングとは何ですか?
異なるサンプル集合で複数モデルを学習し、投票や平均で予測を集約するアンサンブル学習です。
Q. どのような効果がありますか?
単一モデルの予測のばらつきを抑え、過学習しやすいモデルを安定させる効果が期待できます。
Q. ランダムフォレストとの違いは何ですか?
ランダムフォレストは、決定木と特徴量のランダム化を組み合わせた代表的なバギング系手法です。
Q. OOB評価とは何ですか?
各モデルの学習標本に含まれなかったサンプルで性能を評価する方法です。最終テストとは分けて使います。
Q. モデル数は多いほど良いですか?
精度と安定性が改善する範囲で増やし、学習時間、メモリ、推論遅延とのバランスで決めます。
参考資料
バギングの分類器、アンサンブル手法、ランダムフォレストについては、次の資料で確認できます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。