
ブレンディングは、異なる得意分野を持つ複数のモデルの予測を、メタモデルと呼ばれる別のモデルで組み合わせ、単一のモデルより安定した予測を目指す手法です。
ただし、データの分け方を誤ると情報漏えい(データリーク)や過学習を招くため、検証の設計が重要になります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
ブレンディングの定義|複数モデルの予測を組み合わせる方法
ブレンディング(blending)は、複数のベースモデルの予測値を材料にして最終予測を作る方法です。分類ではクラス確率や予測ラベル、回帰では予測値を並べ、それをメタモデルに学習させます。
モデルどうしの得意な面を組み合わせる点が、この方法の狙いです。たとえば、決定木系モデルは非線形な関係を捉え、線形モデルは全体の傾向を安定して捉えやすい特徴があります。ブレンディングでは、こうした異なる特徴を組み合わせられます。
なお、文献やライブラリによっては、「ブレンディング」を複数モデルの予測を組み合わせる方法全般の意味で使います。この記事では、ベースモデルの予測を別に確保したホールドアウトデータから作る構成を指します。交差検証でアウトオブフォールド予測を作るスタッキングとの違いを説明するため、実務でよく使われる区別に従っています。
メタモデルは、ベースモデルの学習に使ったデータと同じデータで訓練しないことが重要です。ベースモデルが訓練データを記憶していると、そのデータへの予測は実運用時より楽観的になります。
その予測をメタモデルに渡すと、実運用では得られない情報を学習するおそれがあります。そのため、元データをベースモデルの学習用と、予測をメタモデルへ渡すブレンド用に分けます。
アンサンブル学習は、複数の予測器を組み合わせて単一予測器の偏りや分散を抑え、汎化性能を高める考え方です。ただし、モデルを増やせば必ず精度が上がるとは限りません。予測がほとんど同じモデルばかりでは、組み合わせても新しい情報は増えないためです。
ブレンディングの仕組み|ベースモデルとメタモデルの2段構成
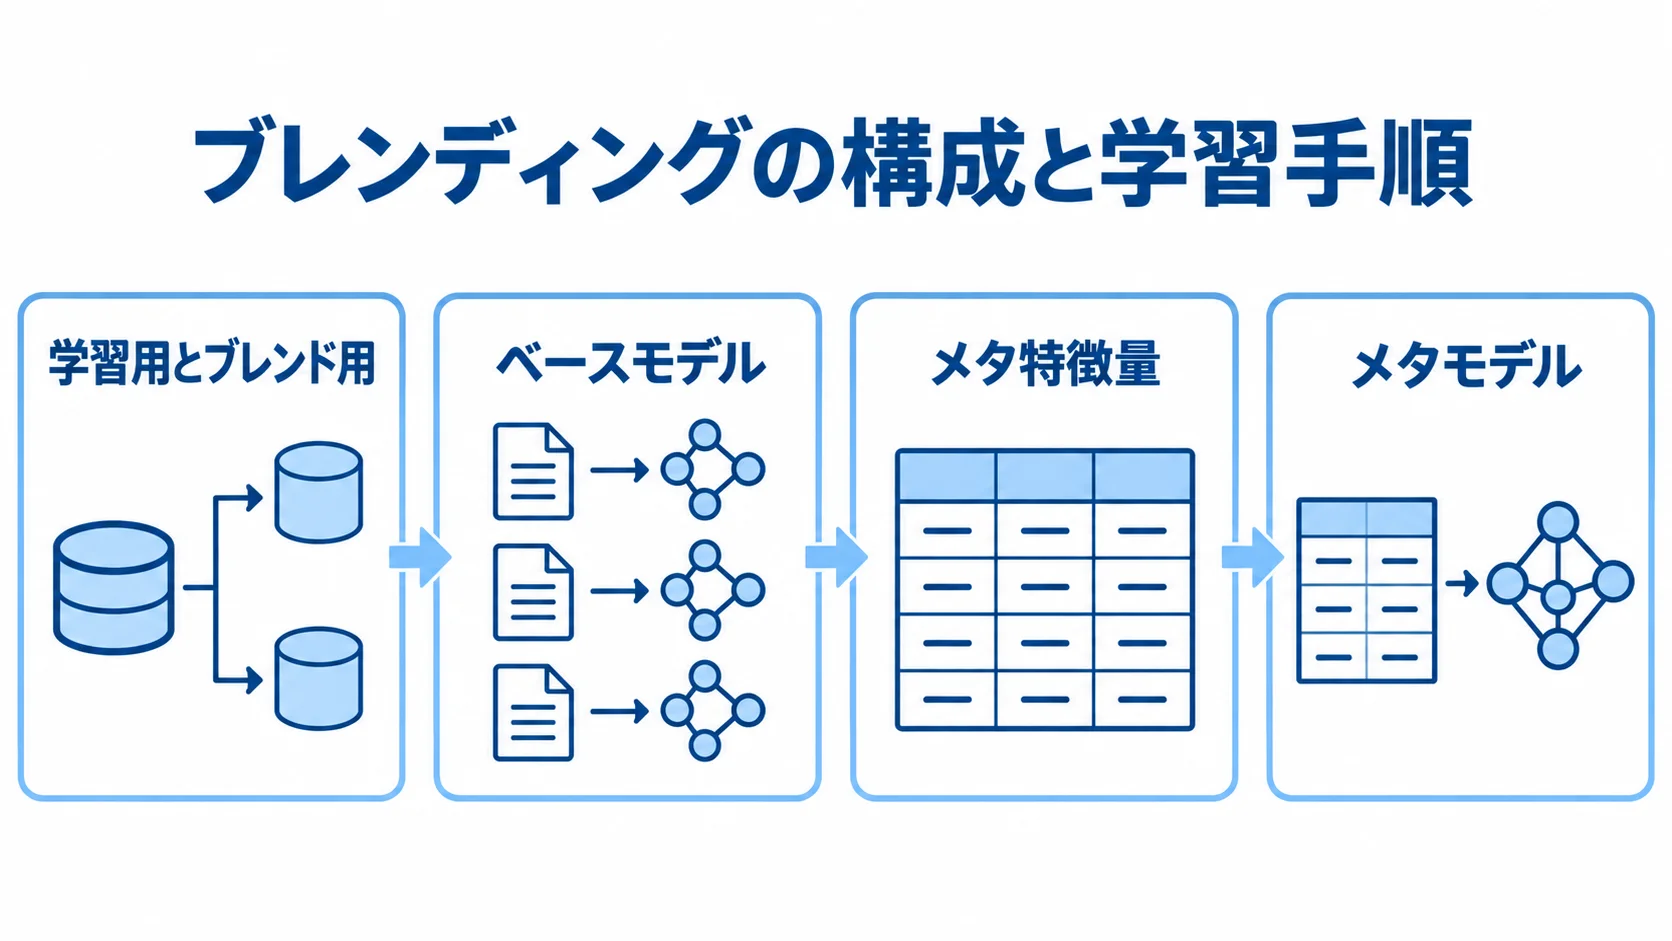
ブレンディングは一般に、ベースモデルとメタモデルの2段階で構成します。ベースモデルは元の特徴量から予測し、メタモデルはその予測を入力として最終予測を作ります。
また、元の特徴量をメタモデルへ追加で渡す設計もあります。その場合は、ベースモデルの予測だけを使う設計と区別して、検証条件を記録しておきます。
1. データの学習用とブレンド用への分割
まず、ベースモデルの学習用データと、予測をメタモデルへ渡すブレンド用データに分割します。たとえば、全体の80%を学習用、残りの20%をブレンド用にします。
分類では、クラス比率を保つために層化分割を使います。また、時系列データでは、未来の情報が過去側に混ざらないよう時系列順に分けます。
2. ベースモデルの個別学習
同じ学習用データを使い、複数のベースモデルを学習します。候補には、ロジスティック回帰、ランダムフォレスト、勾配ブースティングなどがあります。ニューラルネットワークも候補の一つです。
すべてを高性能なモデルにする必要はありません。大切なのは、検証データ上で異なる誤り方をし、互いに補完できる組み合わせを作ることです。
3. ブレンド用データへの予測によるメタ特徴量の作成
各ベースモデルでブレンド用データを予測し、予測値を横に並べます。たとえば、回帰で3モデルを使うと、1行はモデルA、B、Cの予測値からなる3列になります。
分類で確率を使う場合は、クラス数に応じて列数が増えます。こうして並べた各ベースモデルの予測値の列が、メタモデルへの入力となるメタ特徴量です。
4. メタモデルによる最終予測の作成
メタモデルは、学習と予測の2つの場面で使われます。
- 学習:メタ特徴量と正解ラベルを入力に、メタモデルを訓練する
- 予測:新しいデータを各ベースモデルで予測し、その結果をメタモデルへ渡す
回帰なら線形回帰やリッジ回帰、分類ならロジスティック回帰など、複雑すぎないモデルから始めると、各ベースモデルをどの程度信頼したかを確認しやすくなります。
# 概念的な流れ(実際のデータ分割・検証方法は用途に合わせて設計)
base_train, blend_data = split_data(data)

base_models = [model_a, model_b, model_c]
for model in base_models:
    model.fit(base_train.X, base_train.y)

meta_X = [model.predict(blend_data.X) for model in base_models]
meta_model.fit(transpose(meta_X), blend_data.y)

base_predictions = [model.predict(new_X) for model in base_models]
final_prediction = meta_model.predict(transpose(base_predictions))
上のコードは、考え方を示す擬似コードです。実装では、前処理を学習用データだけに適合させ、予測の列順も固定します。
分割方法と乱数も記録します。実験用の簡略実装をそのまま本番へ移さず、パイプラインとして再現できる形に整えます。
ブレンディングと他のアンサンブル手法の違い
投票・平均との違い|固定ルールと学習の差
予測の組み合わせ方は、固定ルールを使う手法と、メタモデルが学習する手法に分かれます。
- ハード投票:分類モデルの予測ラベルの多数決
- ソフト投票:クラス確率の平均から、最も高いクラスを選ぶ
- 回帰の平均:予測値の平均、または重み付き平均
- ブレンディング:メタモデルが予測の組み合わせ方そのものを学習する
スタッキングとの違い|メタモデル用予測の作り方
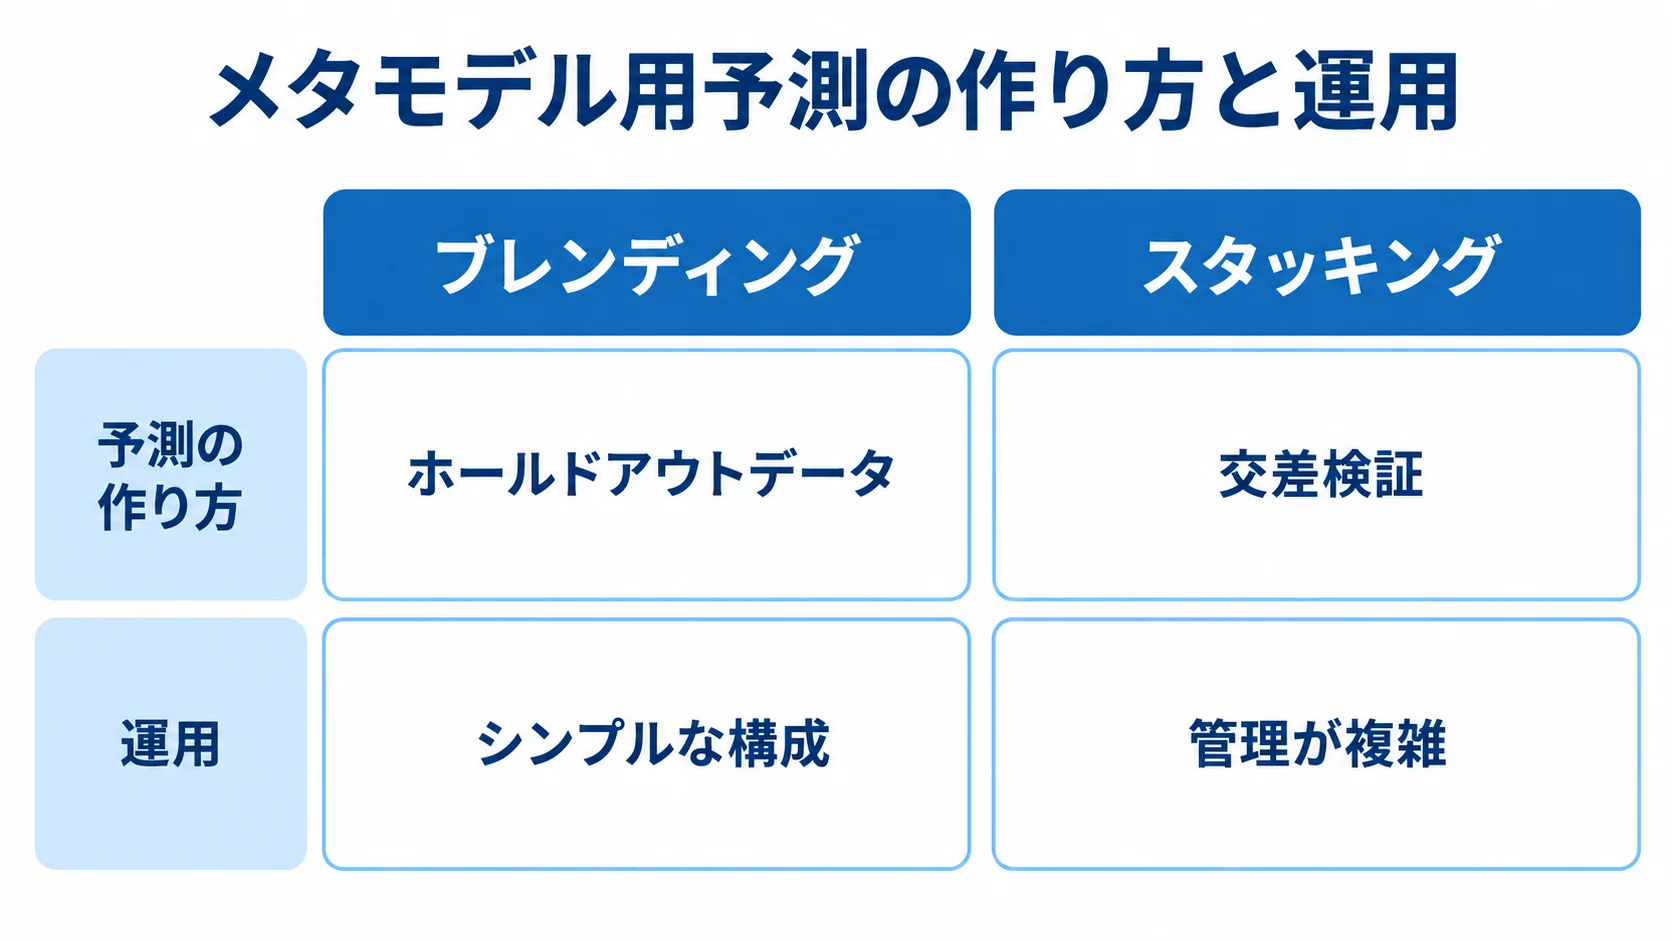
ブレンディングとスタッキングは、どちらもベースモデルの出力をメタモデルへ渡します。大きな違いは、メタモデル用の予測の作り方です。
- ブレンディング:1つのホールドアウトデータへの予測を使う、比較的シンプルな構成です。
- スタッキング:交差検証で各サンプルのアウトオブフォールド予測を作る構成が一般的です。
- ブレンディングを選ぶ場合:データが十分にあり、まず簡単な構造を検証したいときに扱いやすい方法です。
- スタッキングを検討する場合:データが少なく、ホールドアウトで学習データが減るときに候補になります。
- 運用体制:スタッキングは管理が複雑なので、検証手順を明確に決められるチームで採用します。
利用するライブラリに「ブレンディング」という機能があるかも確認します。たとえば scikit-learn には、StackingClassifier や StackingRegressor があります。
ただし、ホールドアウト方式のブレンディング専用のクラスが常にあるとは限りません。その場合は、データ分割、ベースモデルの予測、メタモデルの学習を一連のパイプラインとしてまとめます。
学習時と推論時で、列順や前処理も固定します。そうすることで、両段階で処理が食い違うのを防げます。
バギング・ブースティングとの違い|学習の関係の差
バギングは、データを復元抽出して複数モデルを並列に学習し、予測を平均または投票します。ランダムフォレストは代表例で、モデル同士のばらつきを抑えることを狙います。
ブースティングは、前のモデルの誤りを次のモデルが補うように逐次学習します。これに対してブレンディングは、異なるモデルを並列に学習し、その予測をメタモデルで組み合わせます。
ブレンディングで組み合わせるモデルの選び方
予測性能だけでなく誤りの違い
ベースモデルは、単体の評価指標が高い順に選べばよいとは限りません。同じ特徴量とアルゴリズムのモデルは、同じサンプルで誤りやすいため、組み合わせの効果が小さくなります。
そこで、検証データ上の予測値や誤分類の位置を比較します。相関が低いモデル、異なる特徴量を使うモデル、異なる種類のバイアスを持つモデルを候補にします。
分類における確率の意味と校正
クラス確率をメタ特徴量にする場合、モデルごとに確率の尺度が異なる点に注意します。異なるモデルの「0.8」が、同じ正解頻度を意味するとは限りません。
確率を使うなら、信頼度曲線や適合度を確認し、必要に応じて確率校正を行います。確率の比較が難しい場合は、決定関数や予測ラベルを使う設計もあります。ただし、これらは情報量が減るため、検証データで比較して決めます。
前処理と利用可能な特徴量の統一
ベースモデルごとに前処理が異なっても、どのデータで前処理を適合したかは厳密に管理します。
全データで標準化や欠損値補完を先に行うと、ブレンド用データの情報が漏れる可能性があります。カテゴリ変数の変換や特徴量選択も、全データで先に行うと同じ問題につながります。
前処理をモデルごとのパイプラインに含め、学習分割の中だけで適合させます。こうすると、評価時と本番の処理をそろえやすくなります。
ブレンディングで失敗しやすい点とデータリーク対策
ベースモデルの訓練データへの予測の混入
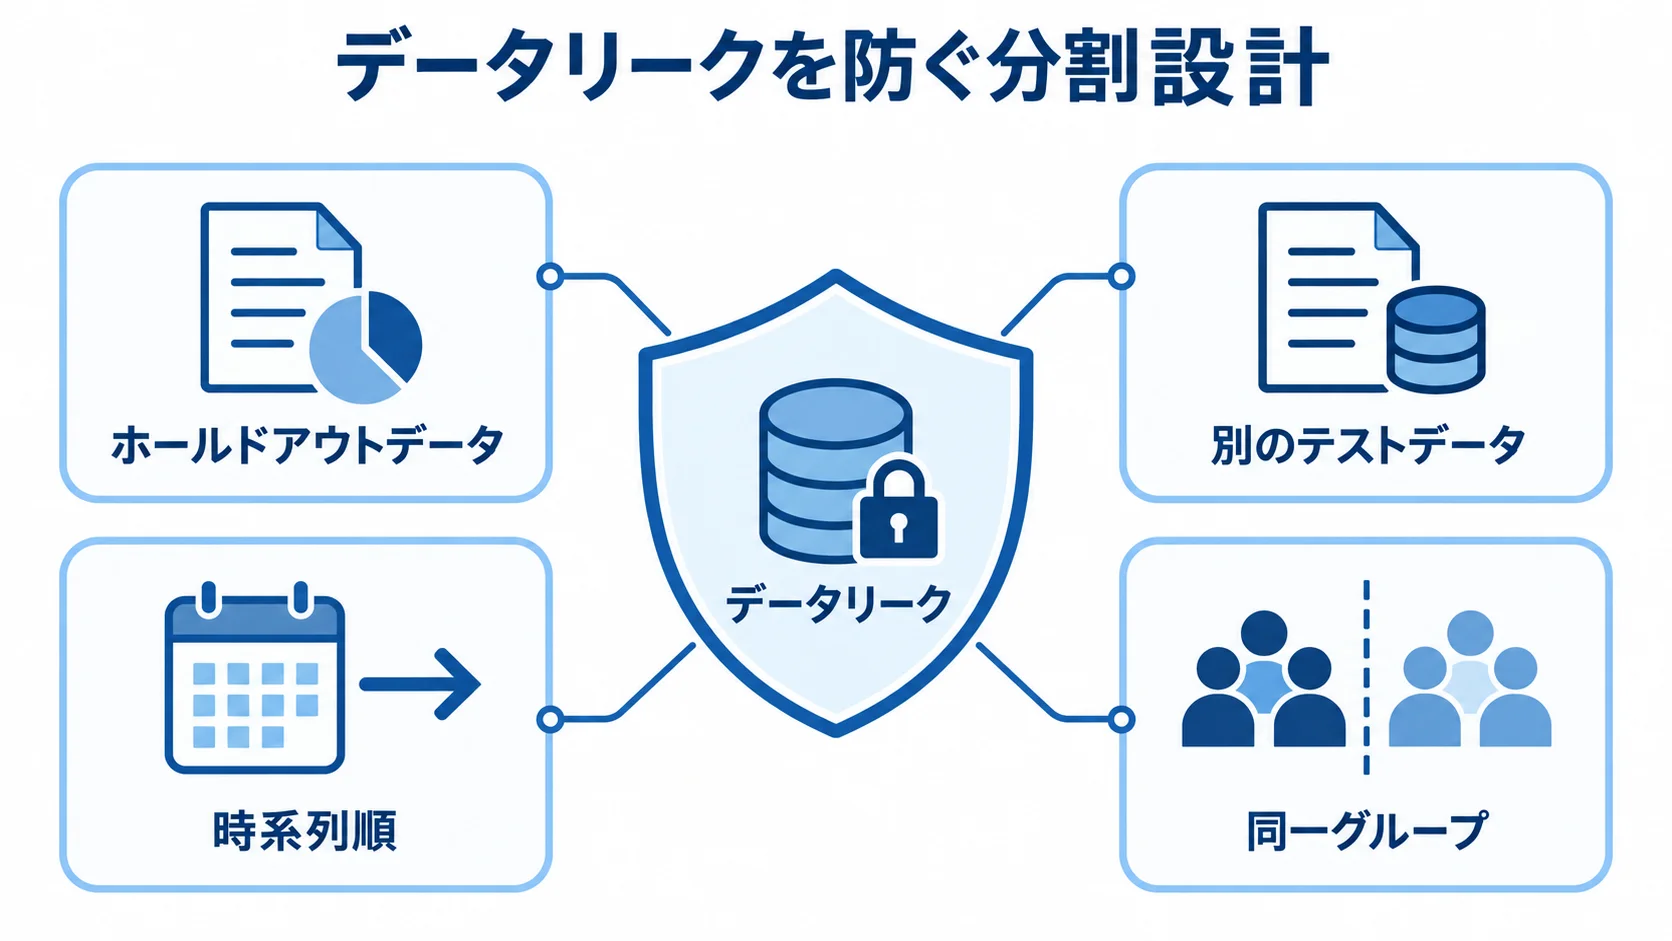
典型的な失敗は、ベースモデルが学習したデータへの予測を、そのままメタモデルの学習に使うことです。その結果、メタモデルが訓練データへの過度な適合を高品質な予測と誤認する原因になります。
ブレンディングでは、ベースモデルが見ていないホールドアウトデータから予測を作ります。
ブレンド用データと最終評価の兼用
ブレンド用データでメタモデルの設計やハイパーパラメータを何度も調整すると、そのデータにも適合してしまいます。そのため、最終性能の確認用に、別のテストデータを残しておきます。
開発中はテストデータを見て判断しないようにし、前処理や特徴量作成の手順も含めて、テストデータから切り離します。
時系列・グループデータの分割ルール
時系列データをランダムに分割すると、未来の値から過去を予測する形になり、実運用より高い指標が出ることがあります。
顧客、店舗、患者などの同一グループの観測が複数ある場合、同じグループが学習側と評価側にまたがると、個体固有の情報が漏れます。予測時点と評価単位に合った分割を、先に決めておきます。
ブレンディングの評価と運用|精度以外の測定項目
単一モデルとブレンディングは、同じテストデータ、指標、前処理条件で比較します。分類では正解率に加え、適合率・再現率・F1・ROC-AUC・PR-AUCなどから、業務上の損失に合う指標を選びます。
回帰ではMAEやRMSE、R²などを使います。外れ値に敏感な指標と敏感でない指標を併記すると、判断しやすくなります。
モデル数による推論時間やメモリ使用量も記録します。加えて、モデルファイルのサイズ、再学習時間、監視のしやすさも残します。
精度がわずかに上がっても、推論コストや障害時の切り分け負担が大きければ、単一モデルや単純平均が適する場合があります。
ブレンディングを採用しやすいケース
採用しやすさは、モデルの誤り方と評価データの量から判断します。
- 誤りを補完できる:異なるアルゴリズムが異なるサンプルで誤る
- 評価データを確保できる:ホールドアウト後も学習量が足りる
- 推論コストを許容できる:複数モデルを実行できる
- チームで管理できる:入力・出力・再学習の手順を運用できる
単純な方法が適するケース
データが少なく、ホールドアウトを確保すると学習が不安定になる場合は、交差検証や正則化を含む単一モデルの改善を先に検討します。
モデルの予測が強く相関していると、複雑さに見合う効果が出ない可能性があります。説明責任や低遅延が最優先なら、単一モデルや固定重みの平均が適することもあります。
ブレンディングまとめ|モデルを増やす前の検証設計
ブレンディングは、複数のベースモデルの予測をメタモデルへ入力し、最終予測を学習する手法です。ホールドアウトデータを使うため、投票や単純平均より柔軟に組み合わせ方を学習できます。
スタッキングは、交差検証によるアウトオブフォールド予測を使う構成が一般的です。ブレンディングは、1つのホールドアウトを使うシンプルな構成として整理できます。
モデルを追加する前に、各段階で使うデータを決めておきます。採用時は、データリークを防ぐ分割と確率校正を確認します。加えて、時系列やグループ単位の評価と推論コストも見ておきます。
単体モデルや固定重みの平均を含め、ブレンディングとスタッキングを同じ条件で比べます。精度の差が、業務上の価値と運用負担に見合うかを判断します。再現可能な実験記録と運用後の性能監視を用意すると、精度向上の理由を説明しやすくなります。
機械学習モデルの改善は、アルゴリズムだけでなく、評価データの作り方、特徴量の品質、現場で許容できる誤りの定義にも左右されます。
よくある質問(FAQ)
Q. ブレンディングとは何ですか?
ブレンディングとは、複数のベースモデルの予測をメタモデルに入力し、最終予測を作るアンサンブル学習の手法です。ベースモデルが学習に使っていないホールドアウトデータから予測を作ります。
Q. ブレンディングとスタッキングの違いは何ですか?
どちらもベースモデルの出力をメタモデルに渡します。ブレンディングはホールドアウトデータへの予測を使い、スタッキングは交差検証によるアウトオブフォールド予測を使う構成が一般的です。
Q. 投票や単純平均と何が違いますか?
投票や単純平均は、多数決や平均などの固定ルールで予測を組み合わせます。一方で、ブレンディングはメタモデルを学習し、データに応じた組み合わせ方を決めます。
Q. ブレンディングでデータリークを防ぐには?
ベースモデルが学習したデータへの予測を使わず、見ていないホールドアウトデータから予測を作ります。前処理は学習分割の中だけで適合させ、最終評価用のテストデータを調整に使わないようにします。
Q. ベースモデルは何個組み合わせればよいですか?
決まった正解はありません。誤り方が異なるモデルを少数から比較し、精度向上と推論・保守コストのバランスで決めます。ただし、モデルを増やしても予測がほぼ同じなら、ブレンディングの効果は限られます。
参考資料
アンサンブル各方式、スタッキングの実装、交差検証による予測の仕様は、次の公式資料で確認できます。
scikit-learn User Guide の資料で、題名は「Ensembles: Gradient boosting, random forests, bagging, voting, stacking」です。URLはhttps://scikit-learn.org/stable/modules/ensemble.htmlです。
scikit-learn「StackingRegressor」の資料です。URLはhttps://scikit-learn.org/stable/modules/generated/sklearn.ensemble.StackingRegressor.htmlです。
scikit-learn「StackingClassifier」の資料です。URLはhttps://scikit-learn.org/stable/modules/generated/sklearn.ensemble.StackingClassifier.htmlです。
scikit-learn「cross_val_predict」の資料です。資料URLは https://scikit-learn.org/stable/modules/generated/sklearn.model_selection/cross_val_predict.html です。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。