
交差検証(Cross-validation)は、データを複数のグループ(fold)に分け、学習と検証を入れ替えながら繰り返して、モデルの汎化性能を評価する方法です。
KFoldの仕組みと種類、データリークへの対策を順に見たうえで、スコアの見方と実務での確認事項にも触れます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
交差検証とは、学習と検証を複数回繰り返す評価方法
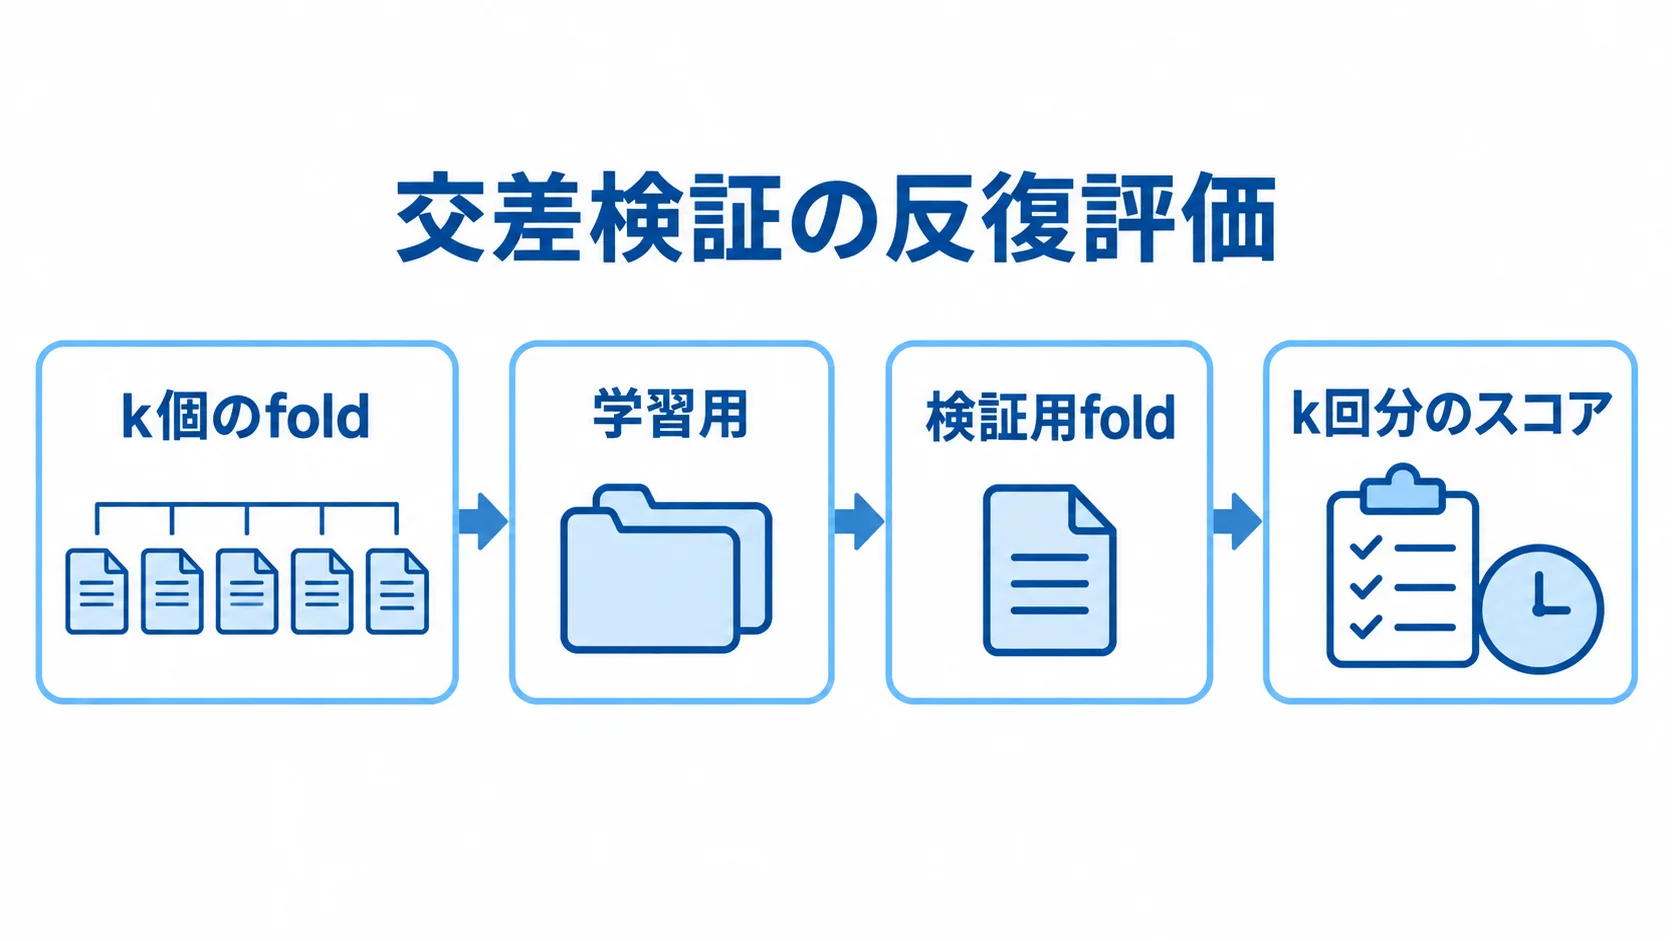
交差検証では、データをk個のfold(分割)に分けます。1回目は1番目のfoldを検証用にし、残りを学習用にします。2回目以降は、検証用のfoldを順番に入れ替えて、同じ手順を繰り返します。
そのうえで、k回分のスコアを平均します。必要に応じて、標準偏差や最小値、最大値も確認します。
たとえば5-foldなら、同じデータから5通りの学習と検証の組み合わせを作ります。各回では、未知データに近いfoldを評価に使います。
1回の分割だけに依存する場合と比べると、交差検証ではモデル性能のばらつきを把握しやすくなります。一方で、fold数を増やすほど学習回数と計算時間も増えます。
交差検証で推定するのは未知データへの性能
交差検証で知りたいのは、学習に使っていないデータでモデルがどの程度機能するかです。
- 学習データへの適合:過度に合わせすぎていないかを確かめます。
- 候補の比較:モデルやハイパーパラメータの選択肢どうしの差。
- 分割による変動:データの分け方によって、評価がどれほど変わるか。
ただし、交差検証で使ったデータは、モデル選択の判断にも使われています。そのため、最終性能を確かめるテストセットは別に残します。
scikit-learnの公式ガイドは、検証データに合わせて調整を続けると、その情報がモデルへ漏れると説明しています。こうなると、汎化性能を正しく測れません。
ホールドアウト法と交差検証の違い
ホールドアウト法は、データを学習用と検証用に一度だけ分ける方法です。実装しやすく、データ量が十分な場合や学習コストの高いモデルに向いています。
難しいデータが検証側に偏るとスコアは低くなり、簡単なデータが偏るとスコアは高くなる可能性があります。
交差検証は、検証用データを入れ替えて複数回評価するため、1回の分割による偶然を抑えられます。特に、データが少なく学習用のサンプルを確保したい場合に有効です。
一方で、5-foldなら基本的に5回、10-foldなら10回の学習が必要になります。そのため、推論コストや学習時間とのバランスを取ることが欠かせません。
実務では、開発用データを交差検証でモデル選択に使い、最後まで触らないテストセットは別に保持します。時系列データでは、未来のテスト期間を先に見ない分割にします。そうすることで、将来時点の性能を確認できます。
fold数の決め方:データ量・計算時間・評価の安定性
5-foldや10-foldがよく使われますが、fold数に決まった正解はありません。fold数を増やすと、各回の学習データは増えます。一方で、学習回数と計算時間も増えます。
サンプルが少ないと、1つのfoldに少数クラスがほとんど入らないことがあります。さらに、同じグループが偏る問題も起こり得ます。
まず、データの最小単位と件数を確認します。そのうえで、各foldに必要なクラス、グループ、期間が入るかを点検します。
計算コストが高い深層学習や大規模な特徴量探索では、開発初期に少ないfoldで候補を絞る方法もあります。最後に、最終候補だけ設定を固定して再評価します。
fold数を変えると結論が逆転する場合は、データ量や分割の設計そのものが不安定な可能性があります。
交差検証の主な種類と使い分け
分割方法は、データが独立同分布とみなせるか、クラスに偏りがあるかで変わります。同じ対象から複数のサンプルが生じる場合や、時間の順序がある場合も考慮します。代表的な方法は、データの特徴と本番の予測単位に合わせて選びます。
KFold:基本的なk分割の交差検証
KFoldは、データをk個のfoldに分け、各foldを1回ずつ検証側に回す方式です。回帰やクラスに偏りがない一般的なデータでは、まずKFoldが出発点になります。
データの並び順に意味がある場合は、無条件にshuffleしてよいかを確認します。ランダムに混ぜると、未来の情報が過去の学習に入り込むことがあるためです。
StratifiedKFold:クラス比率を保つ分割
分類で陽性と陰性の比率が大きく異なると、通常のKFoldでは、少数クラスがほとんど入らないfoldが生じることがあります。
- 比率を保つ:各foldのクラスの割合がおおむね保たれるように分けます。
- 少数クラスの評価:医療検査や不正検知など、陽性が少ない問題で使い、accuracyだけに頼らず確かめます。
ただし、層化しても統計的な不確実性は残ります。scikit-learnの公式資料は、fold間のスコアのばらつきが小さく見える可能性を説明しています。
平均スコアだけでなく、実際の少数クラス数、再現率、混同行列も確認します。
GroupKFold:同じ対象を学習と検証に分けない分割
顧客や患者、設備など、同じ対象から複数のレコードが作られる場合があります。それらをランダムに分けると、同じ対象の特徴を学習したモデルを、その対象で検証してしまいます。
- グループを分離する:GroupKFoldは指定した対象を学習側と検証側の両方に入れません。
- グループ列を決める:患者の検査値なら患者ID、工場のセンサー値なら設備IDを使います。
- 適用先を定める:新規顧客向けか既存顧客の翌月向けかで、設計と評価の意味が変わります。
分割単位は、機械学習の担当者だけでなく、データを作った業務担当者と相談して決めます。
TimeSeriesSplit:時間の順序を守る分割
売上や需要の予測、設備の異常検知、アクセス数の予測では、未来のデータを予測します。そのため、ランダム分割は避けます。
- 未来情報を遮断する:ランダム分割では、未来の季節性や市場環境が学習側に入り、現実には得られない情報で評価することがあります。
- 過去から後の期間を検証する:1月から6月で学習して7月で評価し、次は1月から7月で学習して8月で評価します。
- 期間の重みを検討する:トレンドが変わる事業では、古い期間を含めるか、直近期間を重くするかも考えます。
TimeSeriesSplitのような方法で時系列の順序を守ると、運用時の予測に近い条件で評価できます。
交差検証で最も注意したいデータリーク
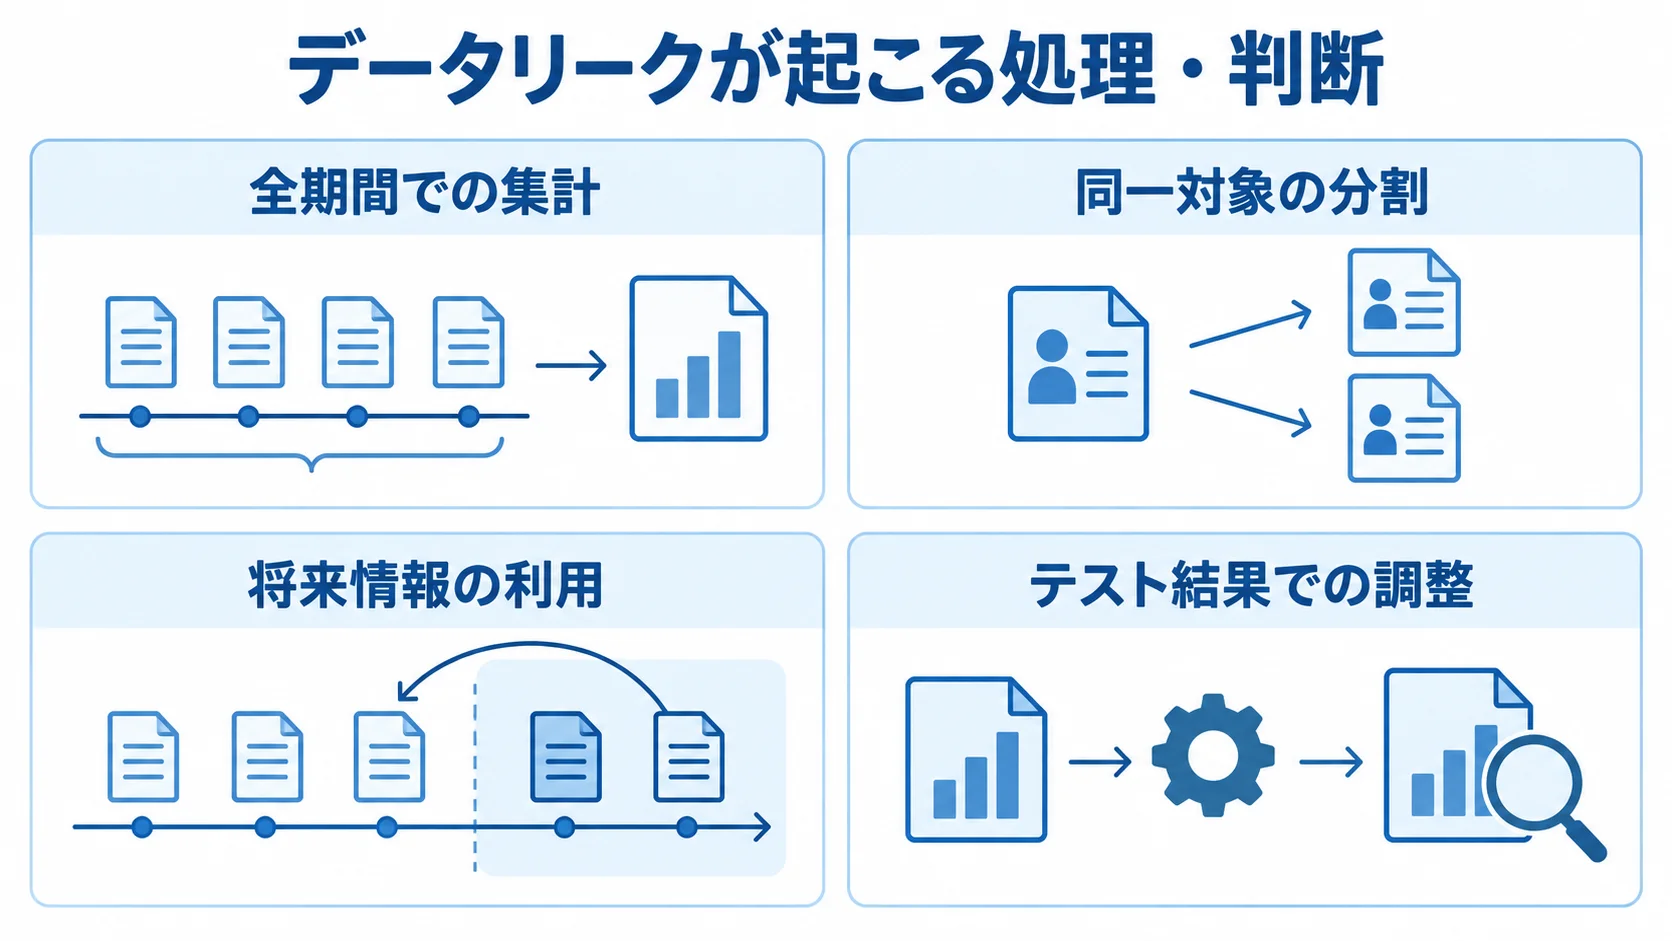
データリークとは、本番の予測時には使えない情報が学習や検証に入り込み、実際より高いスコアが出る状態のことです。
分割前に全データで標準化や欠損値補完、特徴量選択を行うと、検証foldの情報が学習側へ漏れることがあります。交差検証の分割自体が正しくても、こうした漏れは起こります。
対策としては、各foldの学習データだけで前処理のパラメータを学習し、そのパラメータを検証データへ適用します。scikit-learnでは、前処理とモデルをPipelineにまとめると、交差検証の各回で処理順を管理しやすくなります。
同様に、特徴量の作成でも、未来の集計値や予測対象期間の後に確定する情報を混ぜないようにします。
よくあるリークの例
本番時点で使えない情報が評価に混ざりやすい例として、次のような処理や判断があります。
- 全期間での集計:分割前に、データ全体の平均値や最大値を計算する。
- 同一対象の分割:同じ顧客・患者・設備のレコードをランダムに分ける。
- 将来情報の利用:解約や故障の後に確定する情報を特徴量に入れる。
- テスト結果での調整:数値を見ながら、モデルや特徴量を何度も調整する。
- 検証情報での判断:検証データの分布や正解ラベルを意思決定に利用する。
各特徴量については、予測時点で存在するか、誰がいつ確定するか、将来の値を参照していないかを確認します。さらに、モデルのコードに加えて、データ抽出SQL、集計バッチ、業務システムの確定タイミングまでレビューします。
ハイパーパラメータ調整と評価の役割分担
モデルの種類を変えたり、正則化の強さや木の深さ、学習率などを調整したりします。これを検証スコアに合わせて何度も繰り返すと、検証データにも間接的に適合します。
nested cross-validationは、候補を比べる内側の交差検証と、調整後の性能を測る外側の評価を分けて行う方法です。選択バイアスを抑える考え方でもあります。
すべての案件で必要とは限りません。候補数が多い、データが少ない、研究結果を厳密に比較したいといった場合に検討します。
一般の業務システムでも、テストセットを残し、モデル選択用のデータと最終報告用のデータを分けると、評価の信頼性を高められます。
どのデータを何回見たかの記録は、手法名よりも大切です。
検証設計では、分割方法に加えて対象期間と除外条件を文書化します。さらに、グループ列や乱数シード、評価指標も残しておきます。
テストセットの保存場所も明記し、後から同じ実験を再現できるようにします。そうすれば、精度の変化がデータやモデル、分割方法のどれによるものかを切り分けやすくなります。
交差検証のスコアの見方:平均とばらつき
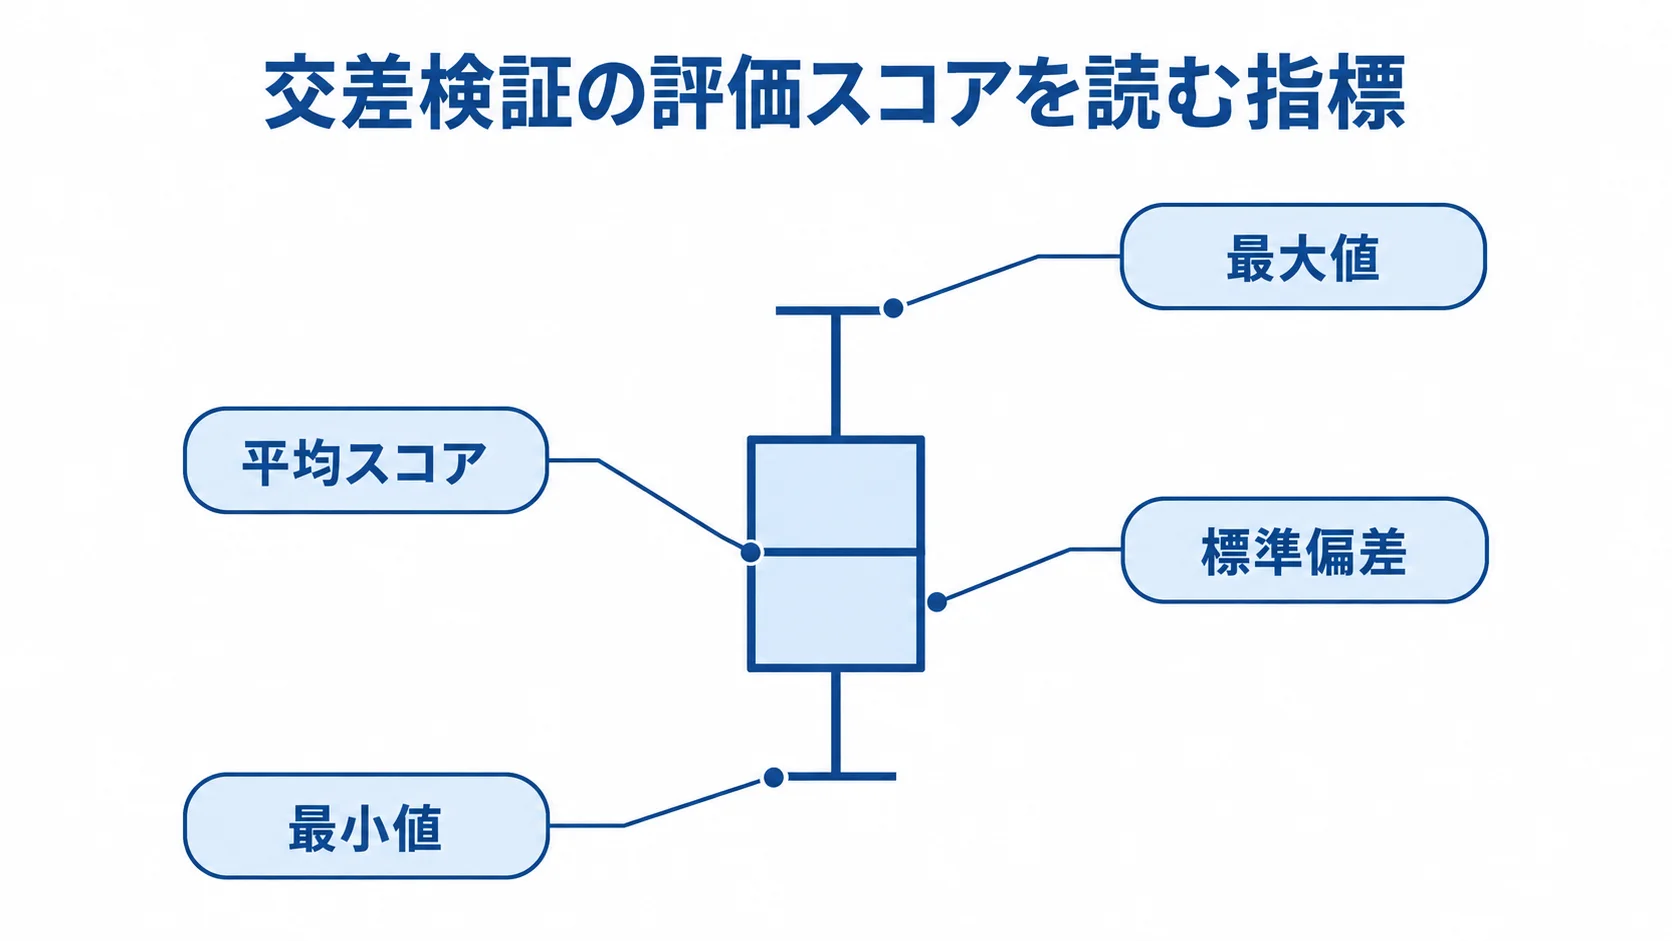
平均スコアだけで判断すると、特定のfoldだけ極端に悪いケースを見落とすおそれがあります。平均に加えて標準偏差を見ると、fold間の振れ幅が分かります。さらに、最小値と最大値を並べると、安定性を確認しやすくなります。
各foldのデータ件数とクラス比率も記録します。業務上重要な期間や顧客群を含むfoldが、どの評価結果に対応するかも残しておきます。
複数の評価指標を使う場合は、どれを最終判断に使うかを先に決めておきます。たとえば、不正検知で再現率だけを最大化すると、誤検知が増える可能性があります。
誤検知が増えると、確認業務が回らなくなることもあります。そのため、再現率と適合率に加えて、確認件数や見逃しコストも合わせて評価します。モデル選択のルールは、事前に合意しておきます。
交差検証を実務で使うためのチェックリスト
検証を実務につなげるには、予測単位から運用まで、次の5項目を確認しておきます。
- 予測単位と分割方法:顧客・患者・設備・日付などの単位を定め、KFold、Stratified、Group、時系列から方式を選ぶ。
- テストセット:最後まで使わない評価用データを確保する。
- 処理範囲:前処理、特徴量選択、探索を各foldの学習データ内で行う。
- 評価と性能:指標を業務上の成功・失敗に対応させ、平均、fold間のばらつき、重要セグメント別の結果を確認する。
- 記録と再評価:乱数シード、分割方法、データ期間、除外条件、ライブラリのバージョンを記録し、分布変化の検知後に見直す運用を決める。
分割方法の設計まで含めた交差検証
交差検証は、限られたデータで学習と検証を複数回行い、モデルの汎化性能を推定する方法です。KFoldは、その基本形にあたります。
クラスに偏りがあればStratifiedKFoldを、同じ対象から複数行が生まれるならGroupKFoldを使います。時間順序があるデータには、TimeSeriesSplitを選びます。
回数を増やすことよりも、本番時点で使える情報だけを使い、業務の予測単位に合わせて分割することが大切です。
最後まで触らないテストセットで、最終確認を行います。検証計画には、平均スコアとばらつき、業務KPI、データ更新後の再評価を含めます。
この計画があれば、机上の精度を本番の判断へつなげやすくなります。
よくある質問(FAQ)
交差検証の設計と運用でよく聞かれる疑問に答えます。本番で使える情報の範囲や、最終評価の扱いにも注意してください。
Q. 交差検証とは何ですか?
交差検証とは、データを複数のfoldに分け、学習用と検証用を入れ替えながらモデル性能を評価する方法です。平均スコアとばらつきを見ることで、未知データへの汎化性能を推定できます。
Q. KFoldとホールドアウト法はどう違いますか?
ホールドアウト法は一度だけ分けるので計算が速い一方で、分割の偶然に評価が左右されます。KFoldは複数回評価するぶん計算量は増えますが、データが少ない場合でも結果の安定性を確認しやすくなります。
Q. fold数はいくつに設定すればよいですか?
5分割や10分割がよく使われますが、正解はデータ量と計算コストで決まります。fold数を増やすほど学習データは増える一方、計算時間が伸び、fold間の相関も高くなりがちです。
5分割を基準にして、平均、標準偏差、実行時間を比べながら決める方法が実務的です。
Q. StratifiedKFold、GroupKFold、TimeSeriesSplitはどう使い分けますか?
クラス比率を保ちたい分類にはStratifiedKFoldを、同じ顧客・患者・設備をまたいで分けたくない場合はGroupKFoldを使います。未来を予測する時系列データには、TimeSeriesSplitを使います。
データの生成単位と本番の予測単位に合う分割を選びます。
Q. 交差検証を使えばデータリークは防げますか?
交差検証を使っても、データリークは起こり得ます。分割前に全データで標準化や欠損値補完を行うと、検証foldの情報が学習側へ漏れるためです。
前処理とモデルをPipelineにまとめ、各foldの学習データだけで前処理を学習させると、リークを抑えられます。
Q. 交差検証をした後もテストセットは必要ですか?
はい、必要です。交差検証のスコアを見ながらモデルや特徴量を調整すると、検証データにも間接的に適合する可能性があります。
モデル選択に使わないテストセットを残し、採用モデルの最終性能は一度だけ確認します。
参考資料
交差検証の分割方法や機械学習の関連仕様を確認するための資料です。
- scikit-learn User Guide「3.1. Cross-validation: evaluating estimator performance」
- Google for Developers「Linear regression: Loss」
- TensorFlow「tf.keras.losses」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。