
次元の呪いとは、特徴量の次元が増えるとデータが空間の中でまばらになり、距離・推定・探索・計算が難しくなる現象です。
入力データの品質や対象業務の制約、評価方法が合わないと、精度が高く見えても実運用の成果にはつながりません。特徴量設計や次元削減などの場面でも、この現象は関係します。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
次元の呪いの定義と役割
次元の呪いは、データから得たい判断を具体的な計算へ落とし込むための枠組みとして捉えると分かりやすいです。そのためには、入力、出力、学習または推定の条件を分けて定義しておく必要があります。どの時点までに利用できる情報だけを使うかも、あらかじめ決めておきます。
たとえば、予測対象の未来にしか存在しない値を入力に含めると、検証のときだけ結果が良く見える情報漏えいが起きます。
実務では、採用の理由を手法の名前だけに頼らず、表現できる関係や必要なデータ量を業務上の制約と照らし合わせます。推論速度や説明責任、更新頻度も、あわせて確認しておきます。
まず小さなベースラインとの差を測ってから複雑な構成へ進むと、改善の根拠を発注側にも説明しやすくなります。
次元の呪いの仕組み|入力から結果が出るまで
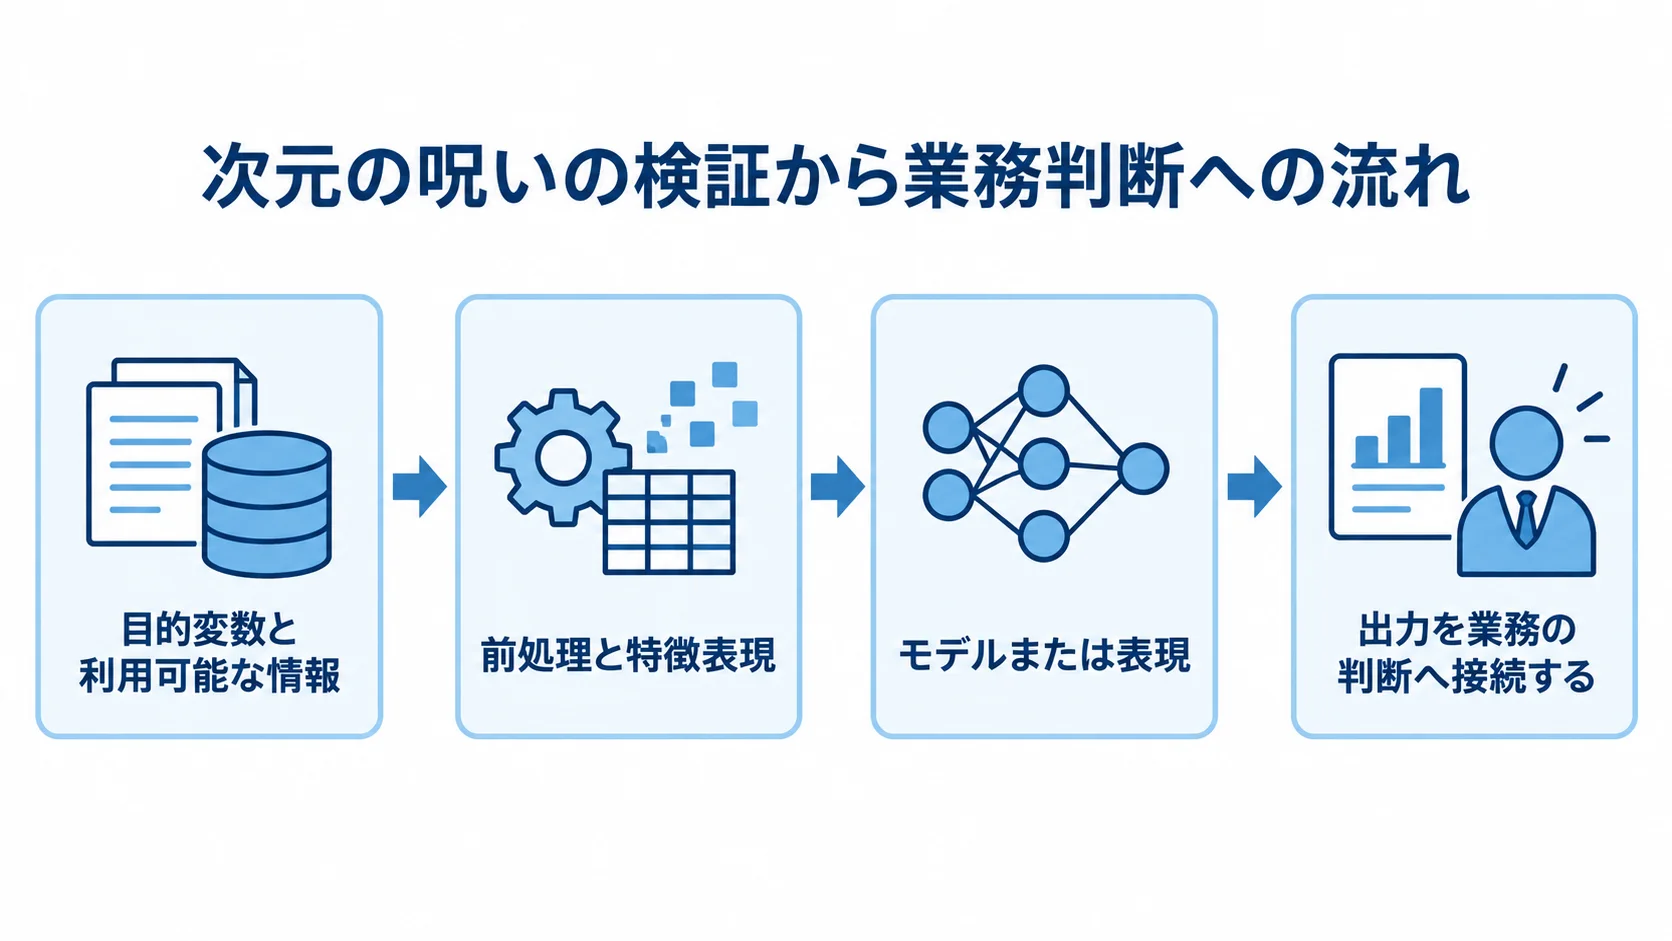
1. 目的変数と利用可能な情報の定義
まず、何を当てるのか、いつ予測するのか、結果を誰がどう使うのかを、発注側と開発会社で決めておきます。
分類ならクラスの定義、回帰なら単位と許容誤差、推薦なら候補集合と表示位置を、はっきりさせておきます。
学習データと本番データの分布が違うと、理論どおりの性能が出ないことがあります。そこで、期間や地域、顧客区分などの切り口で分布を確認します。
2. 前処理と特徴表現の固定
前処理と特徴表現は、学習時と推論時で同じ規則を使えるように組み、記録も残しておく必要があります。
- 対象と規則:欠損値や外れ値、単位、カテゴリ、画像解像度、トークン化などの扱いを、学習時と推論時でそろえる。
- 評価データ:検証に使う情報を見てから変換器を学習しない。評価結果に情報が混ざるのを防ぐため。
- 記録:前処理をパイプラインとして保存し、バージョン、学習期間、除外条件を残す。
次元の呪いを活かす工夫と、前処理の再現性を守る作業は、どちらも同じくらい大切です。
3. モデルまたは表現の学習と推定
計算の中心は、入力から出力を作るパラメータをデータから決める部分です。
正則化や停止条件、初期値、乱数、バッチサイズなどの設定も、結果を左右します。
候補を増やすほど、検証データを何度も見て選ぶことになり、それ自体が過学習につながります。そのため、最終評価用のデータは別に確保しておきます。
4. 出力の業務判断への接続
出力を業務で使うには、次の運用項目を決めておく必要があります。
- 処理条件:自動処理を始める前に、しきい値、確認者、例外時の扱いを決めておく。
- 例外対応:低信頼の結果は保留にし、重要な判断は人が確認する。学習範囲外の入力には警告を出す。
- 調査記録:入力の要約、モデル版、処理時刻、信頼度を残し、後から原因を調べられるようにする。
# 検証の概念例
train, valid, test = split_by_time(data)
preprocess.fit(train)
model.fit(preprocess.transform(train), train.target)
pred = model.predict(preprocess.transform(valid))
report_metrics(valid.target, pred)
# test は最後の一度だけ確認する
上のコードは考え方を示す例です。
実装では、分割の単位がユーザーや設備などの主体をまたいでいないかを確認します。さらに、同じ対象の重複レコードにも注意が必要です。
ライブラリの既定値をそのまま使わず、データの性質と業務要件に合わせて設定し、その内容も記録しておきます。
次元の呪いを使うメリットと適用しやすい場面
特徴量設計や次元削減などは、次元の呪いへの対策として検討されます。正則化やサンプル数の計画、最近傍検索の方式選択も、同じ文脈で扱われます。
入力と出力の関係を再利用できる形で扱えます。
また、人手の判断を補助し、同じ条件なら同じ基準で処理できます。検証や改善の履歴も残せます。
導入の可否は精度だけでは決めず、処理時間や推論コストといった運用の負担や、説明のしやすさ、誤りの影響も合わせて評価します。
誤検出を減らすのか、見逃しを減らすのかによって、指標やしきい値は変わります。そのうえで、小規模な検証を業務フローにつなげ、改善箇所を確認します。
他の手法との違い|選択時に見る観点
過学習はモデルの複雑さに関する問題で、次元の呪いは空間とデータ密度の問題です。ただし、両者は互いに影響し合います。
違いは、必要なデータ量や計算量に表れるほか、パラメータの解釈や誤り方にも出ます。
目的が予測か可視化か、教師ありか教師なしかによっても、評価の設計は変わります。比較表だけで決めず、小さな共通データで試します。比較では、次の観点をそろえて確かめます。
- 必要なデータ量:利用できるデータ規模に合うか
- 解釈と説明:パラメータや結果を説明できるか
- 計算量と誤り方:計算の負担と誤りの特徴が許容範囲か
単純なベースラインの設定
平均値、最頻値、多数決、線形モデルなどを先に測っておくと、追加のコストに見合う改善がどれだけあるかが分かります。
ベースラインより少し良いだけなら、データ品質の改善や業務ルールの見直しのほうが、費用対効果に優れることがあります。
検証データと本番条件の一致
検証では、データの分割方法と評価指標を、実際の利用時に合わせます。ランダムな分割が、いつも適切とは限りません。
- 時系列:未来のデータを学習に混ぜない
- 同一対象:顧客や撮影場所を分割でまたがせない
- ラベル:作成日を考慮に入れる
クラス不均衡がある場合は、正解率だけでなく、適合率や再現率、適合率と再現率の調和平均、校正なども確認します。
限界と失敗しやすい点|精度指標の見方
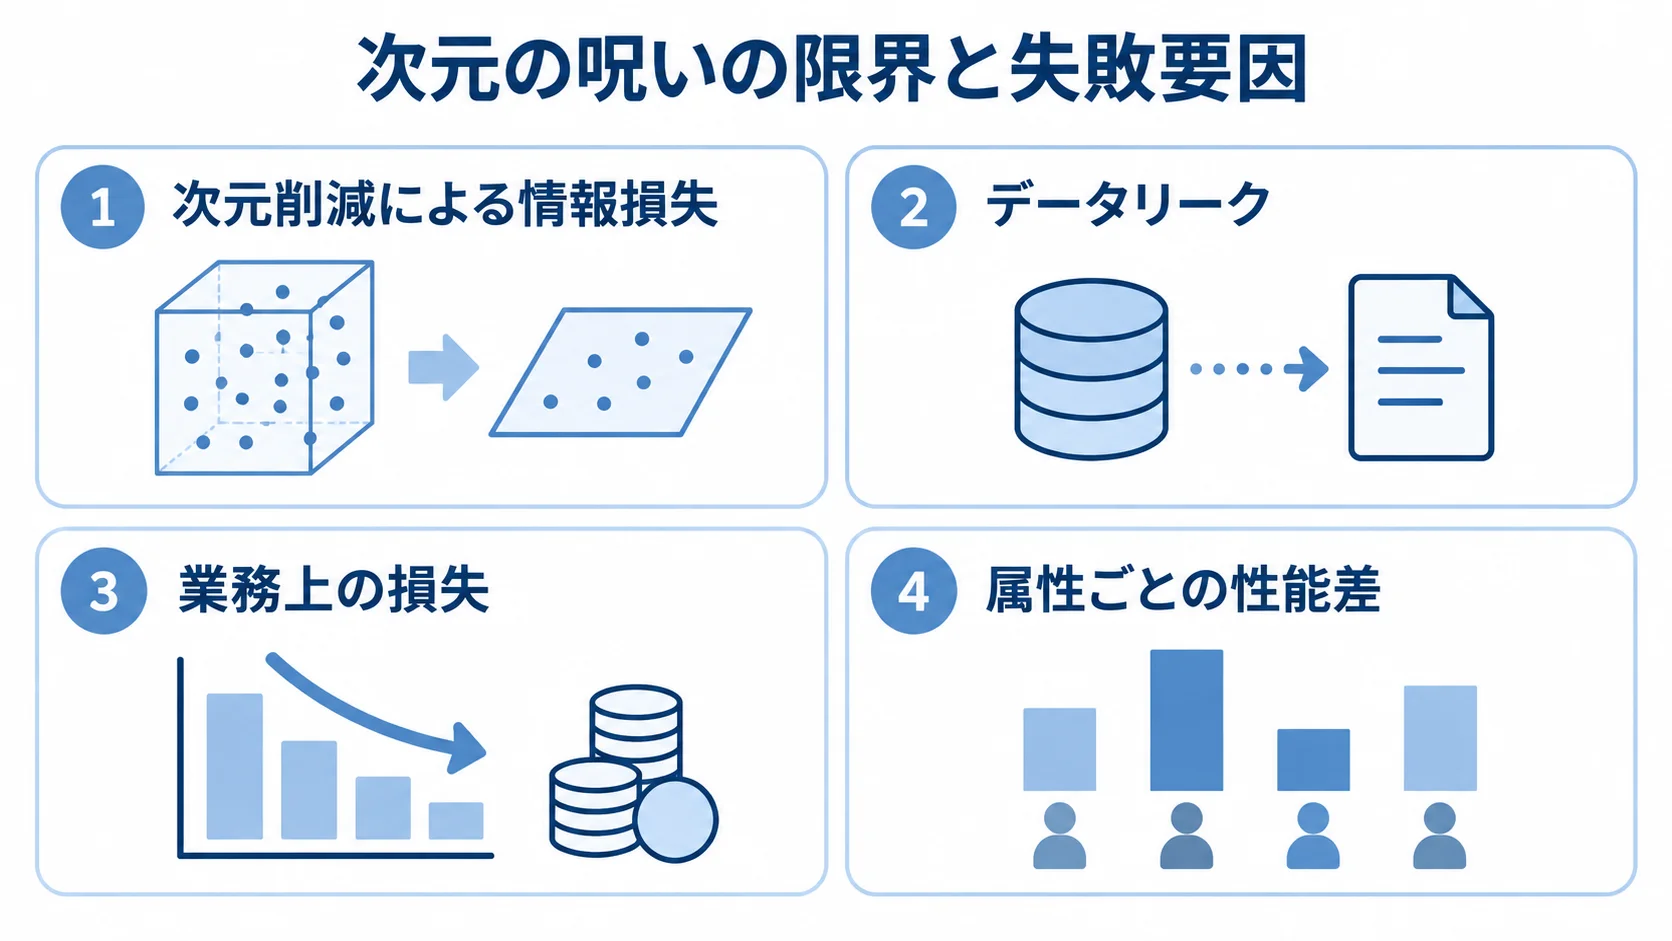
次元削減では情報を失うおそれがあります。全列削除や可視化だけで、問題が解決するわけではありません。
学習データにない条件では結果が崩れることがあり、欠損やノイズを別の意味だと誤認することもあります。
評価指標が業務上の損失を表していない場合も、失敗につながります。そこで、データを増やす前に失敗例を分類し、誤りが集中する条件を確かめます。
データリークにも注意が必要です。目的変数を作るときだけ分かる情報や将来の更新値、全期間で集計した平均値が混ざると、検証スコアは実力を示しません。
同じ対象の重複画像も、リークの原因になります。特徴量の生成は分割の内側で行い、学習・検証・テストの境界をコードと文書の両方で確かめます。
公平性や安全性、プライバシーも、適用範囲に関わる大切な要素です。
属性ごとの性能差や、誤判定がもたらす不利益を検討します。
保存期間やアクセス権、削除要求への対応も確認しておきます。人の評価や推薦に使う場合は、出力が最終決定を自動的に固定しないよう、運用を組みます。また、異議申立ての経路も用意しておきます。
導入後の運用|再現性と監視の設計
本番では、入力分布や欠損率を監視します。
推論件数、処理遅延、しきい値別の件数も、あわせて見ておきます。
正解ラベルが後から得られる課題では、遅延を考慮した評価ジョブを別に設けます。
学習時と運用時の指標は、混同しないようにします。
性能の低下に気づいたら、データの変化、前処理の変更、外部要因を順に切り分けます。
モデルや設定を更新するときは、旧版との比較、段階的な展開、ロールバック手順を準備しておきます。
バージョンだけでなく、特徴量の定義やデータ抽出の条件も結果に影響します。依存ライブラリやハードウェア、乱数も、同様に影響することがあります。
再現できない実験は、改善の根拠として扱わないようにします。
実務での進め方|小さな検証の積み重ね
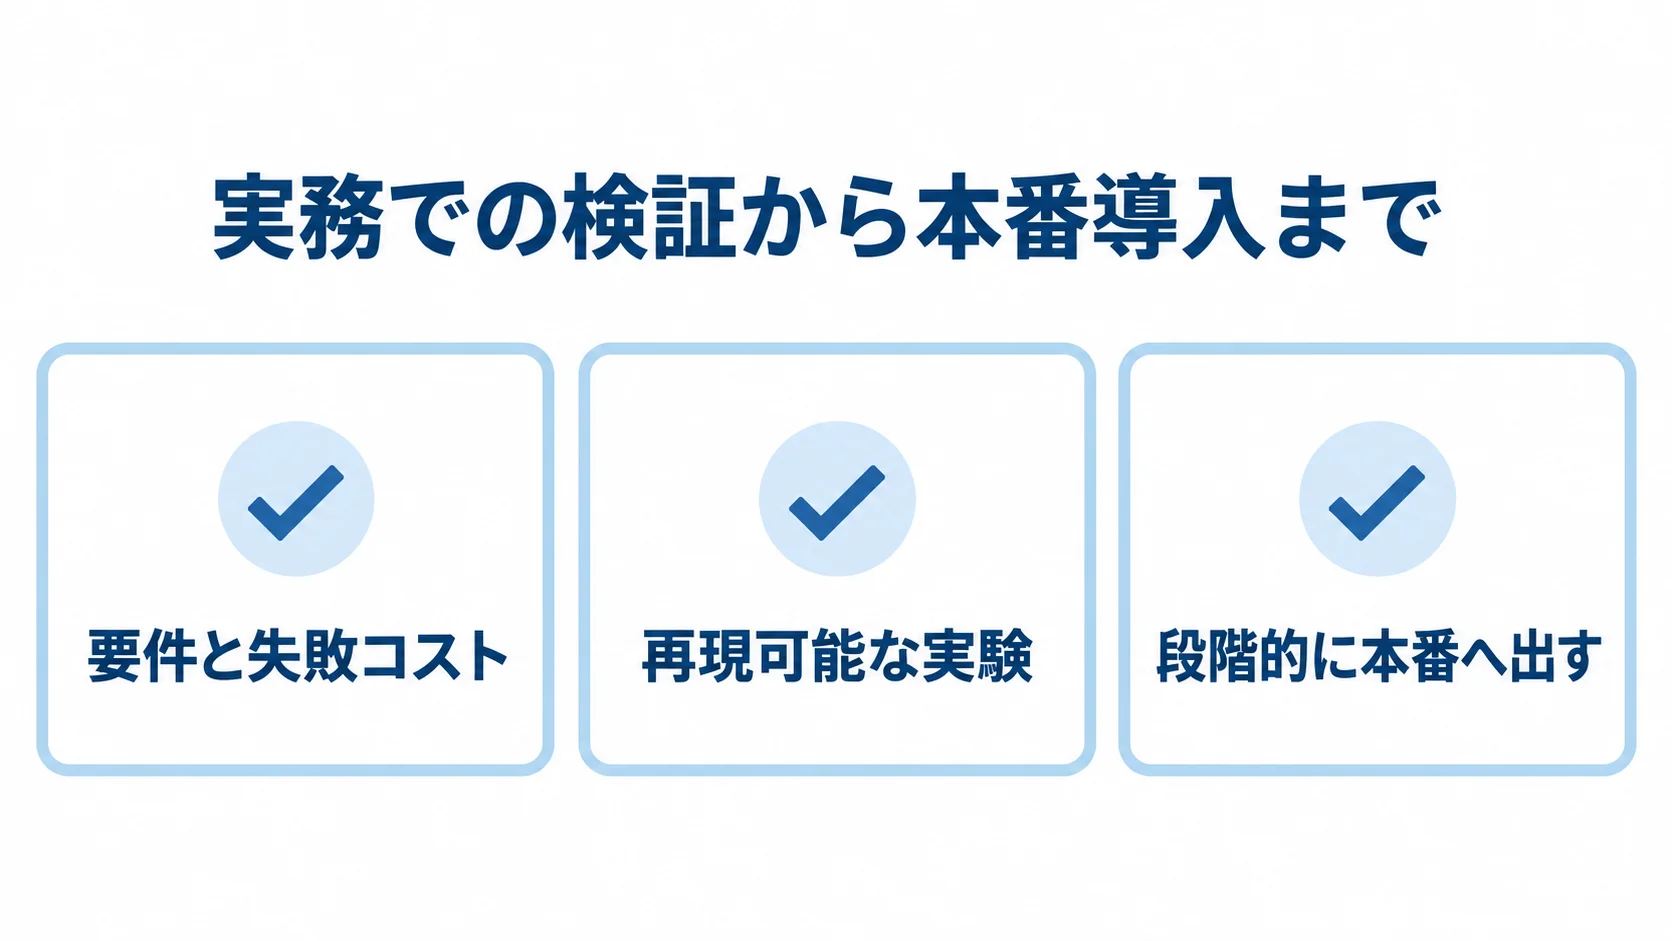
要件と失敗コストの事前整理
発注側と開発会社で、対象ユーザー、入力の更新頻度、許容できる遅延を文書にまとめておきます。あわせて、誤り1件あたりのコストと、手動確認に回せる件数も書き出しておきます。
この情報があれば、高性能化よりデータ収集の改善を優先するか、リアルタイム処理をやめてバッチ処理にするかを判断できます。
再現可能な実験の作成
データ分割から前処理、学習、評価、可視化までを一つの実行手順にまとめ、設定ファイルと結果を保存します。
候補を比較するときは、同じ分割と同じ評価指標を使います。
そのうえで、設定を変えた理由と期待する効果を記録します。なお、結果が悪化した場合も記録に残します。
段階的な本番展開
最初は、人の判断を補助するシャドーモードや、一部の対象に限定した運用から始めます。
既存の手順と比べ、誤りの確認にかかる時間や利用者の納得度を測定します。数値が改善しても担当者の作業が増えるなら、UIや説明の改善も含めて評価し直します。
よくある質問(FAQ)
Q. 次元の呪いとは何ですか?
次元の呪いは、特徴量の次元が増えるとデータが空間にまばらになり、距離・推定・探索・計算量などが急速に難しくなる現象です。
評価では、目的と制約を決めたうえで、入力から結果を得るまでの手順として見ます。
Q. 次元の呪いはどのような場面で使いますか?
次元の呪いの考え方は、特徴量設計や次元削減、正則化、サンプル数計画、最近傍検索の方式選択などで使われます。まずは小さな検証で業務上の改善を確かめ、そのうえで適用範囲を広げます。
Q. 次元の呪いを使うときの注意点は何ですか?
次元削減では情報を失うおそれがあり、全列削除や可視化だけで問題が解決するわけではありません。
データ分割、入力品質、誤りの影響、運用監視を合わせて設計してください。
Q. 似た手法とはどう違いますか?
過学習はモデルの複雑さに関する問題で、次元の呪いは空間とデータ密度の問題です。両者は互いに影響し合うので、目的、データ量、計算コスト、説明責任を共通の評価条件で比べることが大切です。
Q. 導入前に何を確認すべきですか?
導入前には、目的変数、利用できる情報、評価指標、失敗時の対応、データとモデルの更新手順を確かめます。そのうえで、ベースラインとの差を測ってから本番導入を判断します。
参考資料
本記事の定義と実装上の論点は、次の公式資料を参照しています。仕様やライブラリの挙動は更新されることがあるため、導入時は利用するバージョンの文書を確認してください。
- https://scikit-learn.org/stable/modules/unsupervised_reduction.html
- https://scikit-learn.org/stable/modules/decomposition.html
- https://scikit-learn.org/stable/modules/neighbors.html
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。