
データ拡張とは、既存の学習データにラベルを保つ変換や合成を加えて、実運用で起きる入力の変化にモデルを対応させる方法です。画像や自然言語などで使われ、変換後もラベルの意味が変わらないことが前提になります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
データ拡張とは?ラベルを保った変換で学習例を増やす方法
データ拡張では、元データを変換した例を訓練時に生成します。そのうえで、入力が変動しても同じ予測を出せるよう、モデルを学習させます。
画像分類では、対象物の位置や明るさが変わる場面、撮影時の軽いぼけなどを想定できます。ただし、変換後も目的変数の意味が保たれることが重要です。たとえば、文字認識で上下反転を許すと、別の文字として扱う場合があるため、変換が妥当かはタスクごとに確認します。
変換の実施方法には、元データを保存して固定の派生データを作る方法と、各バッチでランダムに変換する方法があります。ランダム変換は毎回異なる見え方を作れる一方で、乱数やライブラリのバージョンを記録しないと再現しにくくなります。
検証時は本来の分布を測る必要があるため、通常はランダム拡張を使いません。検証時の処理は、必要なサイズ変更や正規化だけに限ります。
データ拡張を設計する基本原則
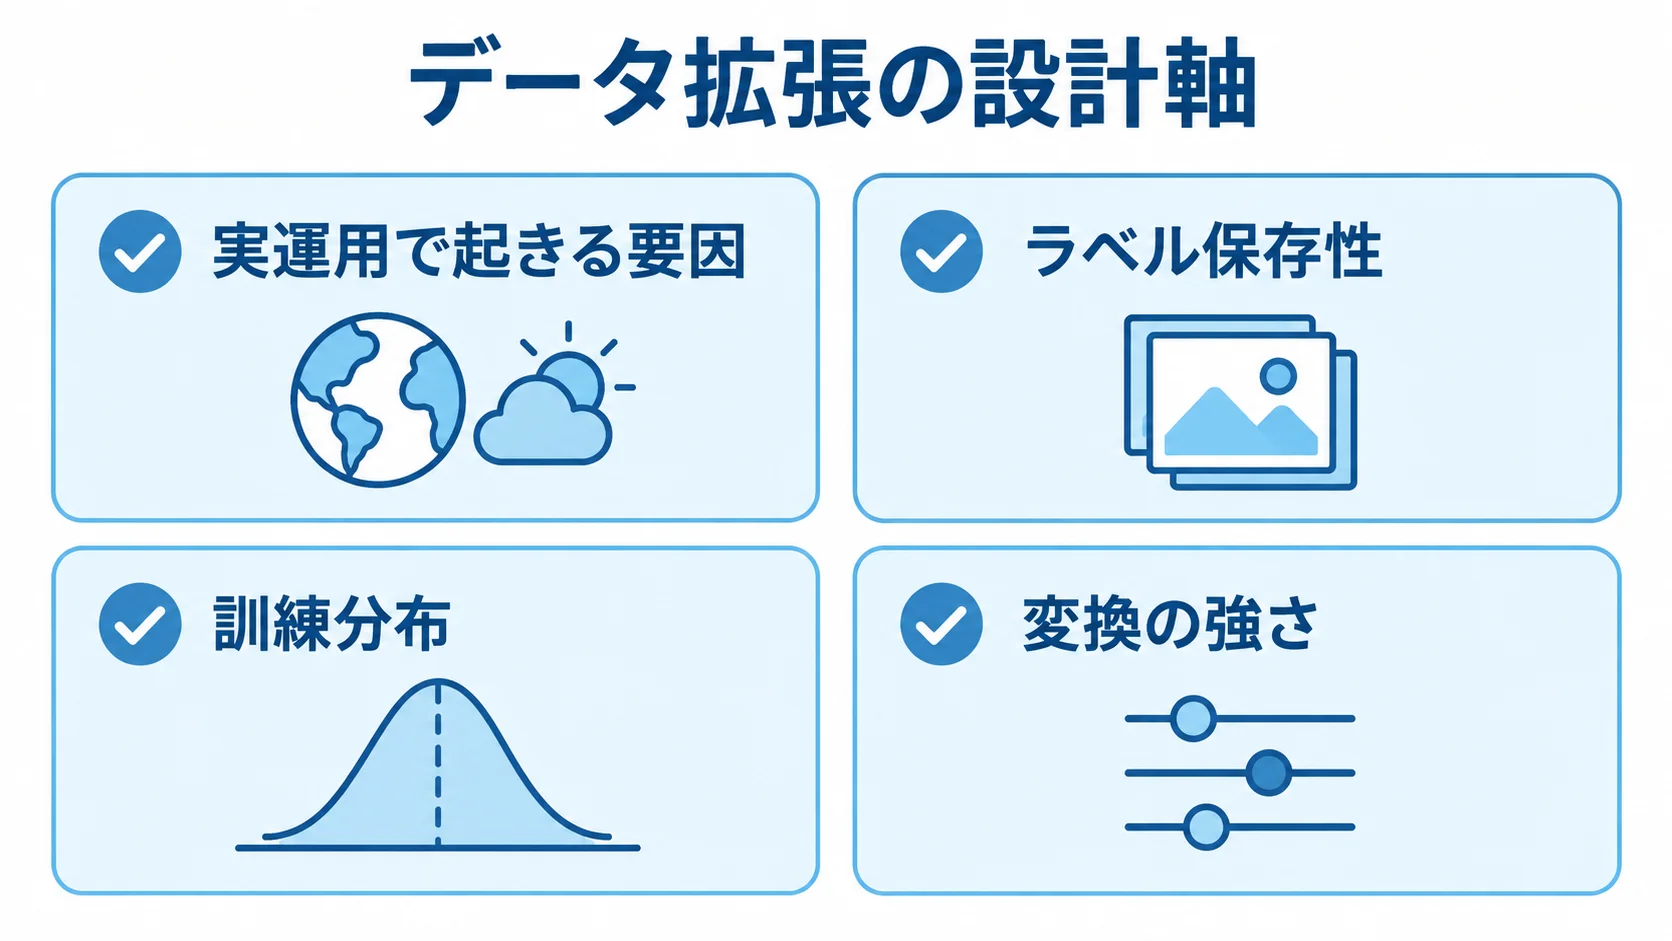
実運用で変わる要因にもとづく変換の選定
変換は、実際の入力で起きる変動を模倣するために使います。まず、現場でどのような変化が起きるかを洗い出します。
- 画像・音声:カメラの角度や照明、センサーのノイズ、録音環境
- テキスト:入力文の表記ゆれ
変動の頻度や範囲を決めたうえで、変換の強さを設定します。その際は、現場のサンプルとドメイン担当者の確認を基にします。さらに、変換の種類を増やしすぎると、実運用では起きない極端なデータまで学習してしまうことがあります。
変換後もラベルが変わらないかの確認
ラベル保存性は、データ拡張の中心となる条件です。そのため、変換後もラベルが保たれるかを対象ごとに確かめます。
- ラベルが保たれる例:犬の写真を少し回転させても、通常は犬のままです。
- 意味が変わる例:道路標識を上下反転させると、意味が変わることがあります。
物体検出では、画像の変換に合わせてバウンディングボックスを移動します。また、セグメンテーションではマスクにも同じ幾何変換を適用します。ただし、変換を入力だけに適用すると、画像とラベルの位置関係が壊れます。
訓練分布を広げすぎることへの注意
データ拡張で現実にない分布まで広げると、モデルの性能が落ちる可能性があります。特に、色の変更が強すぎると、色が重要なタスクの信号を壊します。
変換ごとに適用確率と強度を記録します。そのうえで、変換なし、弱い変換、強い変換を同じ検証分割で比べます。
画像のデータ拡張|回転・切り抜き・明るさの調整
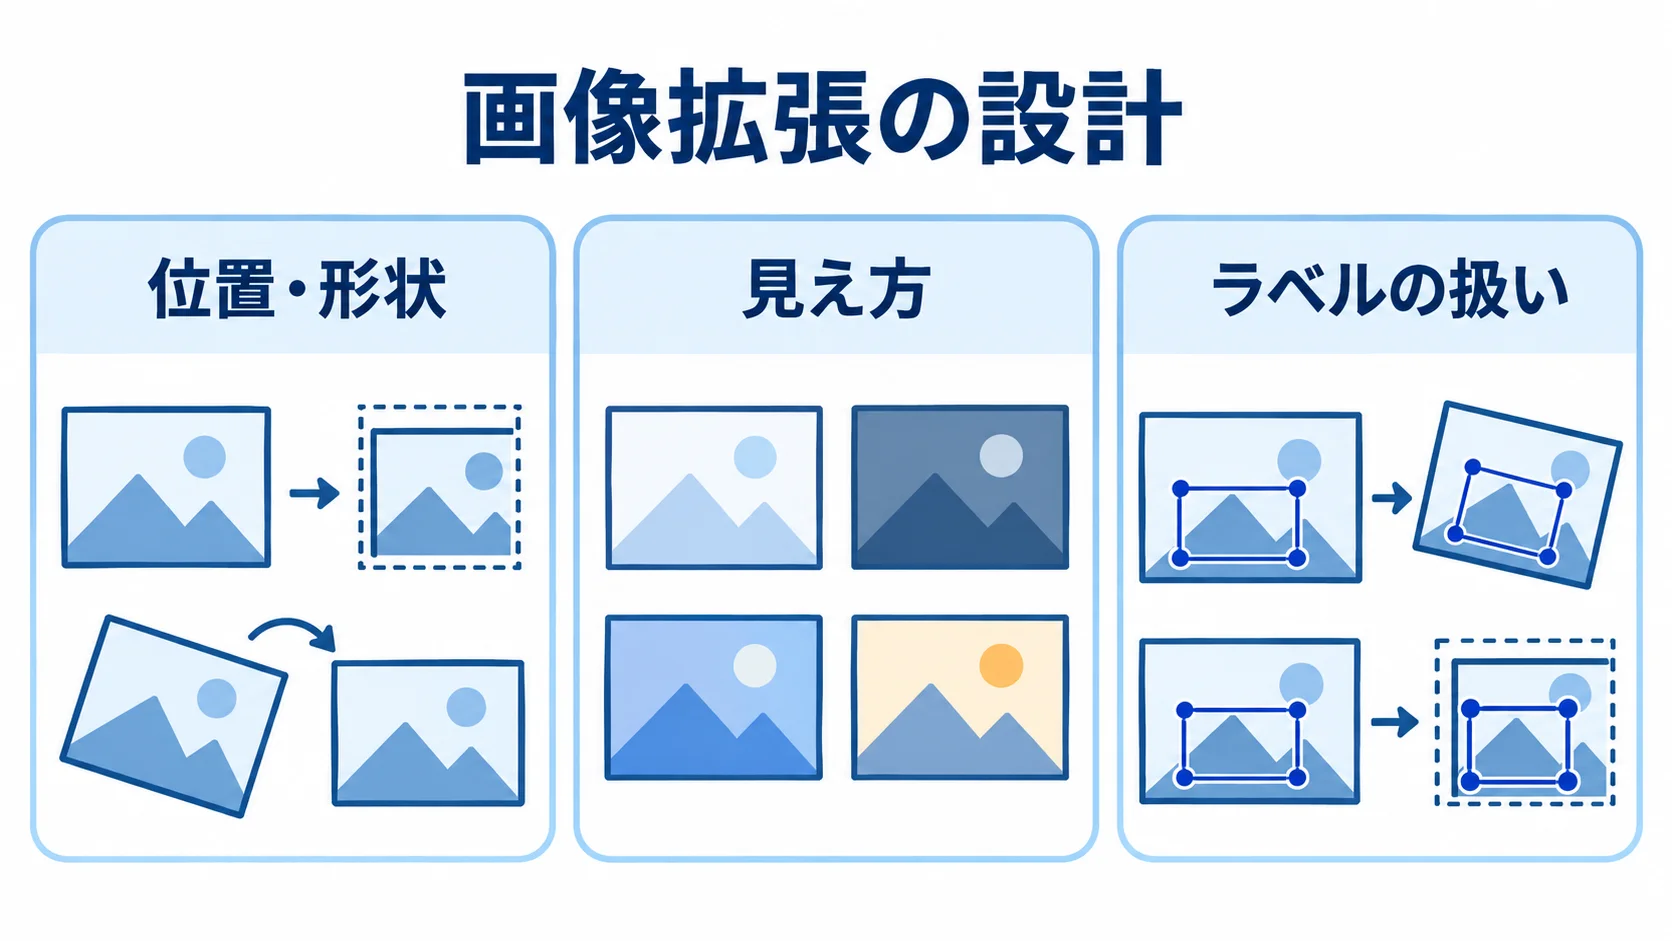
画像拡張では、位置や形状を変える操作と、色や明るさなど見え方を変える操作を使い分けます。
- 位置・形状:ランダムな切り抜き、水平反転、回転、リサイズ
- 見え方:色調や明るさの変更、ぼかし、ノイズ付加
物体の位置が予測に関係しない場合は、切り抜きや平行移動で位置への依存を減らせます。ただし、医用画像や文字画像では左右が意味を持つことがあるため、水平反転を無条件には使えません。
画像分類と物体検出では、同じ変換でもラベルの扱いが異なります。画像全体のクラスが変わらなくても、切り抜きで対象が消えることがあります。また、検出対象が画像の外へ移動する場合もあります。
切り抜きで対象が小さすぎて失われる場合は、最小面積や対象の残存率を条件にします。
セグメンテーションのマスクには、クラス境界をぼかさない補間方法を選びます。たとえば、最近傍補間を使います。
# torchvisionを使う概念例。実際の強度と順序はタスクで検証する
from torchvision import transforms

train_transform = transforms.Compose([
    transforms.RandomResizedCrop(size=224, scale=(0.8, 1.0)),
    transforms.RandomHorizontalFlip(p=0.5),
    transforms.ColorJitter(brightness=0.2, contrast=0.2),
    transforms.ToTensor(),
])

valid_transform = transforms.Compose([
    transforms.Resize(256),
    transforms.CenterCrop(224),
    transforms.ToTensor(),
])
訓練用と検証用では変換を分けます。訓練用にはランダム変換を入れ、検証用には比較できるよう固定した前処理を使います。
正規化の平均と標準偏差は、事前学習モデルや学習データの仕様に合わせます。特に、訓練時と推論時でサイズ、色チャンネル、画素値の範囲がずれると、性能が不安定になります。
自然言語のデータ拡張|意味とラベルの整合性の確保
自然言語では、意味とラベルが保てるかを確かめてから変換を選びます。候補として、次のような方法があります。
- 語句・文の変更:同義語への置換、文の削除や入れ替え
- 入力の揺らぎ:表記ゆれ、翻訳を介した言い換え、ノイズ付加
語の置換では、感情や否定の意味、固有名詞、法的な意味が変わる場合があります。たとえば、肯定と否定を分類するタスクで否定語を削除すると、ラベルが壊れます。そのため、変換後の文章をサンプリングし、人手で意味とラベルを確認します。
トークナイザーを使うモデルでは、文字列の変更によって未知語やトークン長が増えることがあります。拡張後は、最大長を超えて重要な部分が切り捨てられていないかも確認します。
入力の正規化も推論時と一致させます。また、生成モデルで言い換えを作る場合は、生成器のバージョンと温度を記録します。プロンプトやフィルタ条件も残しておきます。
評価データに、重複文や個人情報が混ざらないようにします。
音声・時系列のデータ拡張|時間構造の維持
音声では、録音環境の違いや話し方の揺れを、音と時間の二つの面から模倣します。
- 音の変化:背景ノイズ、音量、ピッチの変更
- 時間の変化:速度変更、時間マスク
音声認識では、速度を少し変えると話者や録音条件の変動を模倣できます。ただし、速度を極端に変えると、発話内容を聞き取れなくなります。
話者識別では、ピッチ変換がラベルの手掛かりを壊す可能性があります。そのため、各タスクで保持する情報と変化させたい情報を分けて考えます。
時系列では、時間の切り出しや窓のずらし、微小なノイズ、振幅のスケール変更を使える場合があります。
未来の値を過去の入力へ混ぜる補間や、予測対象期間を含む移動平均は、リークになります。このため、予測時点より前に利用できるデータだけで変換します。
異常検知では、人工的に増やした異常が現実と異なるパターンにならないかに、特に注意します。
表形式データのデータ拡張|合成前の制約の確認
表形式データでは、ラベルや列どうしの制約を保てる方法を選びます。候補として、次のような方法があります。
- 少数クラス:オーバーサンプリング
- 値の生成:数値へのノイズ付加、カテゴリの組み合わせ作成
表形式データは、画像のような単純な変換ではラベルを保ちにくいです。そのため、年齢が負にならない、合計が内訳と一致するといった制約を満たす必要があります。
時系列データでは、データの順序も守る必要があります。また、実在しない組み合わせを増やすと、モデルの境界が不自然になることがあります。
SMOTEなど近傍を使う手法を分割前に実行すると、元のサンプルと合成のサンプルが訓練と検証にまたがる可能性があります。そのため、先にテストを分離し、交差検証の各訓練部分だけでオーバーサンプリングします。
さらに、カテゴリ変数や欠損値の扱い、グループ所属、個人情報の再現も確認します。合成データを使った場合は、その利用を実験記録とモデルカードに記載します。
データ拡張のリーク対策|評価データを加工しないこと
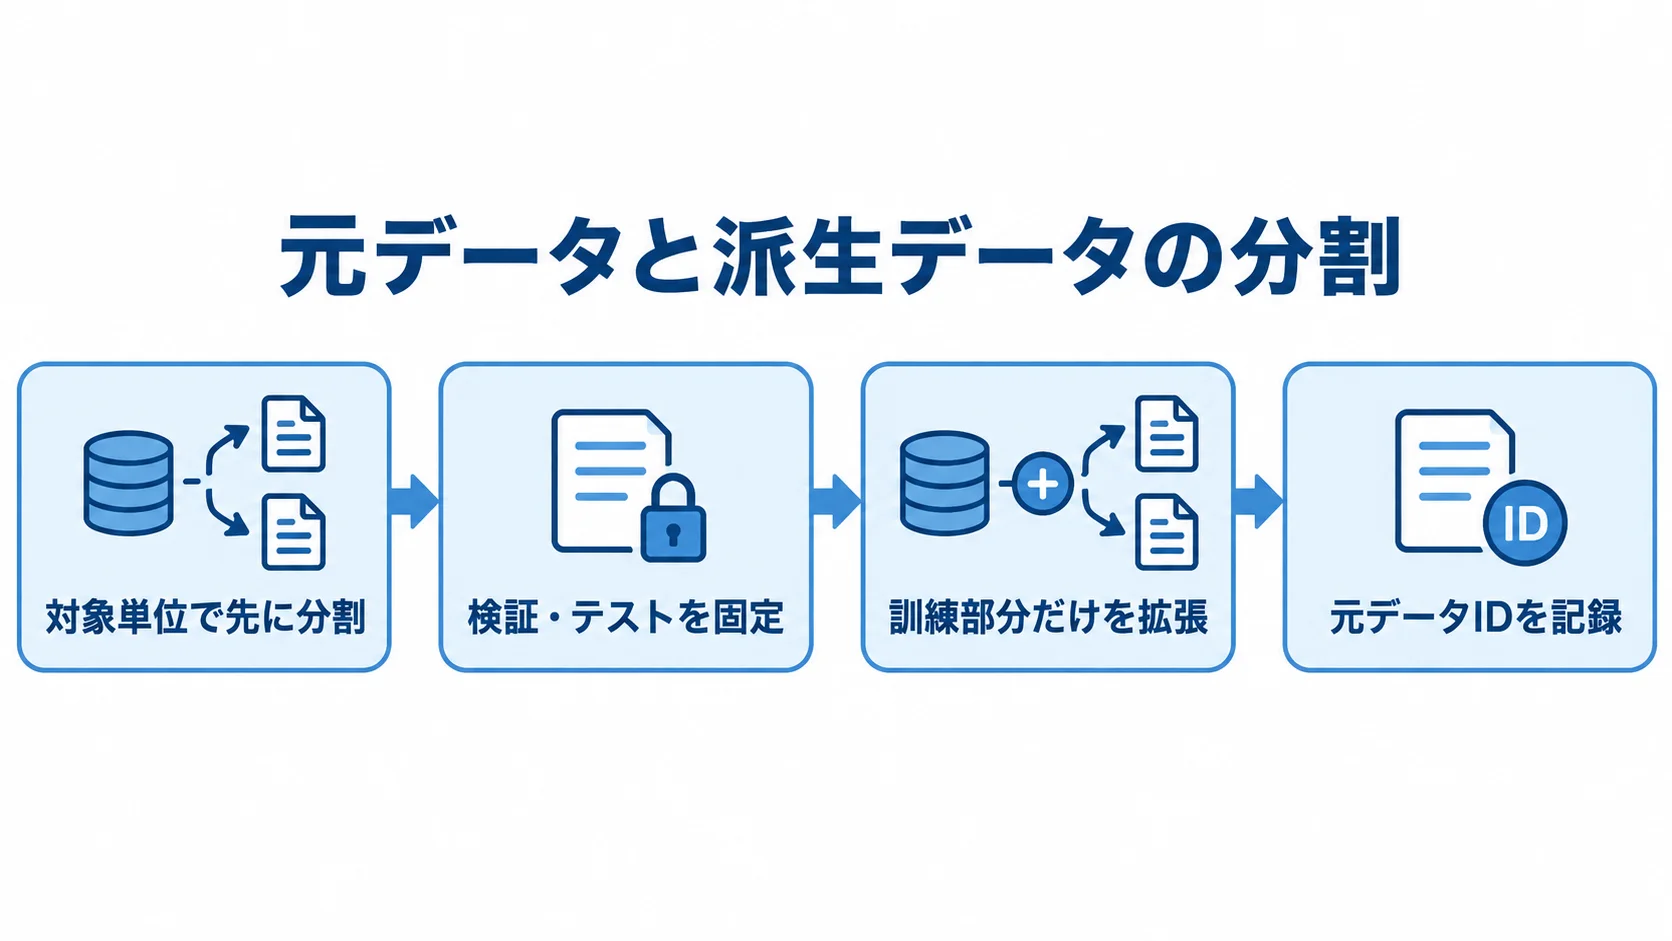
元データと派生データが訓練と検証の両方に入らないよう、分割を先に行います。そのうえで、データ拡張は訓練データだけに適用します。
元画像と拡張画像をランダムに分けると、ほぼ同じ内容が訓練と検証に入ってしまいます。文章の言い換えや時系列の窓でも、同じ問題が起きます。
そのため、元の対象、ユーザー、時点を単位として先に分割します。検証とテストを固定したうえで、訓練部分を拡張します。
学習中の変換をキャッシュする場合は、保存先とデータセットのバージョンを分けておきます。検証用の設定を訓練に使ったり、古い拡張データを残したりすると、実験を比べられなくなります。
データのハッシュや変換パラメータを記録します。さらに、生成時刻と元データIDも残します。なお、派生データに不要な個人情報は残さないようにします。
データ拡張の効果を評価する方法
拡張なしのベースラインと、同じ検証・テスト分割で比べます。そのうえで、平均指標に加えて、確認する観点をそろえておきます。
- 入力条件:条件別の性能、ノイズの多いサンプル
- データ群:少数クラス、境界例
- 変換の効果:一度に増やさず、一種類ずつアブレーション
平均精度が上がっても、重要ケースの再現率が下がるなら採用しないという判断もあります。比較対象の計算予算も記録します。
訓練データの増加による効果と、学習回数の増加による効果は区別します。拡張によって1エポック内の見え方が増えるため、同じ回数でも、モデルが経験するデータが変わります。
学習の条件として、学習時間、乱数、バッチサイズをそろえます。学習率と早期終了の条件も同じにします。そのうえで、複数の乱数で再実験し、偶然の改善ではないかを確かめます。
再現性と運用コストの管理
乱数シードを固定しても、GPUや並列データローダー、ライブラリのバージョンによっては、結果が完全に一致しないことがあります。
再現性が必要な実験では、データ分割、変換設定、乱数を保存します。さらに、依存パッケージやハードウェア、学習ログも一緒に残します。
本番では、同じ変換を再実行するか、学習済みモデルだけを提供するかを決めておきます。
強いデータ拡張は、学習時間、GPUメモリ、入力パイプラインの遅延を増やします。そのため、オンライン変換がボトルネックになる場合は、前処理の並列化や一部のキャッシュを検討します。
固定の拡張データを保存すると、ストレージが増えるうえ、元データの削除や個人情報の管理も複雑になります。そのため、精度向上と計算・保管・監査のコストを、同じ評価表で比べます。
データ拡張を導入する実務フロー
データ準備から記録まで順に進めながら、変換の有効性とリークの有無を段階ごとに確かめます。
- 実運用で起きる入力の変動と、ラベルを保つべき条件の洗い出し
- 対象単位・時点でのテストデータの先行固定と、元データの重複の確認
- 変換なしのベースラインの作成と、評価指標・重要なサブグループの決定
- 変換を一種類ずつ追加したうえでの、強度・適用確率・ラベル処理の記録
- 訓練部分だけの拡張と、検証・テストでの本来の分布の利用
- 複数の乱数での再実験と、計算時間・推論時前処理・モデルサイズの比較
- 採用した変換と適用範囲を、データ辞書・モデルカード・運用手順へ残すこと
導入後は、想定した変動に対する性能を実データで再確認します。たとえば、暗い画像を増やした場合は、実際に暗い環境で撮影された画像で測ります。
言い換え文を増やした場合は、実際の表記ゆれや誤字を含む入力で確認します。人工データだけで判断せず、現場のサンプルと人手のレビューを合わせて採否を決めます。
データ拡張まとめ|現実の変動を安全に学習へ取り込むための要点
データ拡張は、ラベルを保つ変換や合成で訓練データの見え方を増やし、実運用のゆらぎへの頑健性を高める方法です。
分野ごとに見ると、画像では回転や切り抜き、自然言語では表記ゆれや言い換えが候補になります。音声・時系列ではノイズや時間変換、表形式では制約を満たす合成を検討します。
タスクの意味を変える変換は避け、実際に起こる変動から設定を決めます。また、評価データは先に分離し、元データと派生データが分割をまたがないようにします。
データ拡張は、データ不足を万能に解決する手段ではありません。そのため、効果はベースラインと同じ評価分割をそろえ、サブグループ別の指標で判断します。計算コストや再現条件も、あわせて比べます。
採用する価値は、ラベル品質と代表性、分布変化、監査・個人情報の要件を含めて判断します。
よくある質問(FAQ)
Q. データ拡張とは何ですか?
データ拡張とは、既存の学習データにラベルを保つ変換や合成を加え、実運用で起きる入力の変動を学習させる方法です。たとえば、画像の回転や文章の表記ゆれがあります。
Q. 検証データにもデータ拡張を適用しますか?
通常は、訓練データだけにランダムな拡張を適用し、検証・テストでは本来の分布を測ります。元データと派生データが分割をまたぐと、評価が高く見えるリークになります。そのため、先に対象単位で分離します。
Q. 画像でよく使われるデータ拡張は何ですか?
位置や形状を変える操作には、ランダムな切り抜きやリサイズ、水平反転、回転があります。見え方を変える操作には、明るさやコントラストの変化、ぼかし、ノイズなどがあります。
ただし、左右や色がラベルに関係するタスクでは、変換が意味を保つか確認します。
Q. 自然言語のデータ拡張で注意する点は何ですか?
同義語への置換や言い換えでは、否定や感情、固有名詞の意味とラベルが変わらないかを確認します。
トークン長や未知語を記録するほか、個人情報や生成条件も残します。そのうえで、変換後の文章を人手でも点検します。
Q. データ拡張の効果はどう評価しますか?
拡張なしのベースラインと、同じ検証・テスト分割で比べます。そのうえで、全体の指標に加えて、想定した変動や重要なサブグループ別の性能も確認します。
また、複数の乱数や学習時間、推論コストを記録します。人工データだけで改善を判断しないことが大切です。
参考資料
データ拡張の変換や合成方法は、次の資料で確認できます。詳細はリンク先をご覧ください。
- PyTorch Torchvision「Transforming images, videos, boxes and more」
- TensorFlow「Data augmentation」
- TensorFlow「tf.image」
- imbalanced-learn「Over-sampling」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。