
データカタログの開発会社は、基盤との適合性、業務要件、運用支援の3点を比べて選ぶと、信頼できるデータ活用につながります。
候補として挙げるのは、ripla、AWS、Microsoft、Google Cloud、Databricks、Informaticaの6つです。
▼全体ガイドの記事
・データカタログ開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
データカタログのパートナー選びが重要な理由
データカタログは、社内に分散したデータ資産の場所、意味、更新状況を一覧にする仕組みです。データベースやファイルを一か所にコピーするものではありません。所有者や利用目的、加工の流れもメタデータに含めるため、必要な人が信頼できるデータを見つけられるようになります。
そのため、ツールの機能に加えて、要件定義、権限設計、用語の合意、導入後の更新運用まで考えてくれるパートナーを選ぶ必要があります。
適切なパートナー選定が成否を分ける理由
技術メタデータはスキャンで集められても、業務上の意味や責任者が決まっていなければ、利用者は検索結果をそのまま信用できません。また、パートナーには接続技術に加えて、業務部門と管理者の合意形成を支援できる力も求められます。
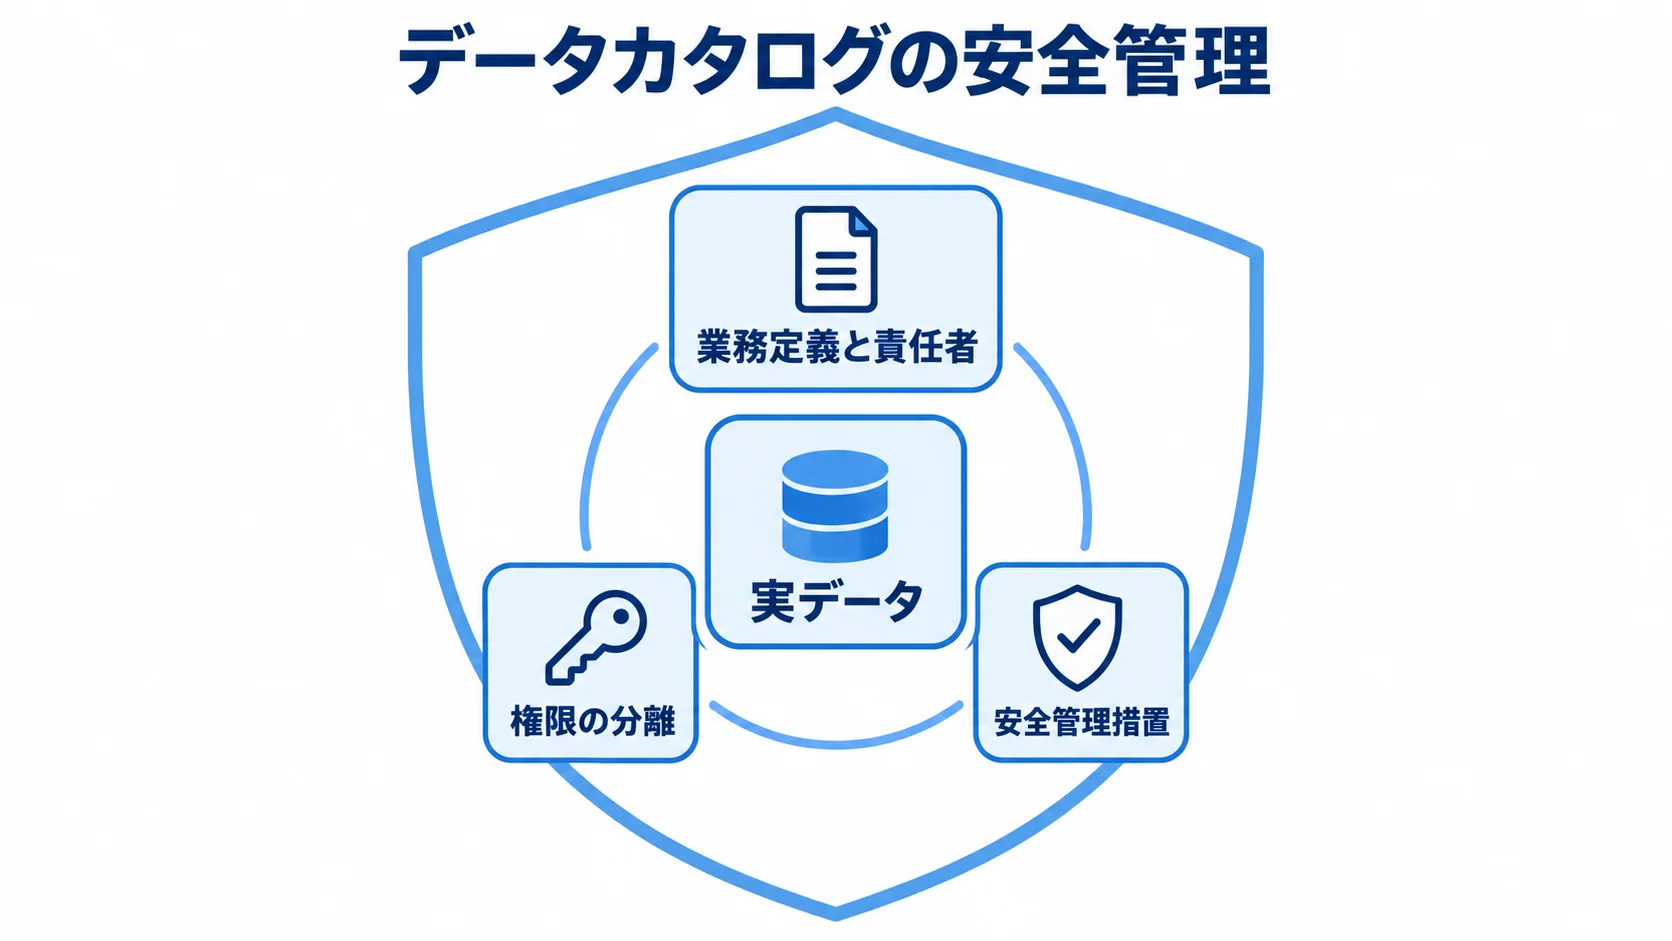
運用では、個人情報や機密情報の存在を示すメタデータが含まれることもあります。
- 業務定義と責任者:返品を売上に含めるか、顧客住所の正本、問い合わせ回答者を決めておく必要があります。
- 権限の分離:カラム名や説明文、サンプル値、申請履歴も含め、実データとカタログの権限を別々に設計します。
- 安全管理:合意形成や閲覧範囲の設計を支援できる会社を選ぶことです。
あわせて、個人情報保護委員会のガイドラインが示す組織的・人的・物理的・技術的な安全管理措置も踏まえておきます。
発注前に確認すべきポイント
PoCでは、対象範囲、見積もり、評価手順を分けて整理します。
- 対象範囲:データソース、利用者、業務用語、リネージュ、個人情報の分類を、先に洗い出しておきます。
- 検証ドメイン:顧客・財務・営業など、価値とリスクが大きく責任者を置きやすい領域から始めます。
- 見積もり:ライセンス、従量課金、初期コネクタ設定を分けます。用語集、品質ルール、IAM・SSO、移行、教育、保守は、それぞれ別項目として扱います。
- 評価手順:4〜8週間のPoC後に、検索利用率や問い合わせ時間を測り、段階展開します。
株式会社 ripla|コンサルから開発まで一気通貫で支援
riplaは、コンサルティングから開発まで一貫して支援します。IT事業会社として社内DXを推進した経験を活かし、成果を出すことと、システムが業務に定着することの両方を支えます。
営業・顧客・生産・販売管理など、幅広い基幹システムの構築・導入実績があります。企業の業務要件に合わせて柔軟に対応できる体制です。
特徴と強み
riplaは製品の導入を目的とせず、業務課題から必要なシステムを考えます。そのうえで、探す時間の短縮や指標定義の統一など、導入目的を先に明確にします。
目的に応じて、クラウドのマネージドサービス、SaaS、オープンソース、既存システムとの連携を組み合わせます。また、部門やデータドメインを絞ったPoCも設計し、全社一括の導入を前提にはしません。
検索画面の提供にとどまらず、データオーナーやスチュワードの役割、用語承認、品質異常の通知、アクセス申請まで運用に落とし込みます。
得意領域・実績
営業・顧客・生産・販売管理では、データが複数のシステムやExcelに分散しがちです。riplaは業務システムの経験を活かし、現場の業務フローと管理側のガバナンスをつなぎます。
製品の機能選びで迷う場合や、既存システムを含めて段階的に整えたい場合にも相談できます。対象システムや利用者の役割に加えて、用語集や帳票、問い合わせ例を用意しておくと、検討が具体化します。
製品ライセンスの契約先と、要件定義・開発・運用支援の担当範囲は分けて確認します。特に、見積もりに含めるのは必要な支援だけにすることが大切です。
Amazon Web Services(AWS)|AWS中心のデータレイクとの親和性の高さ
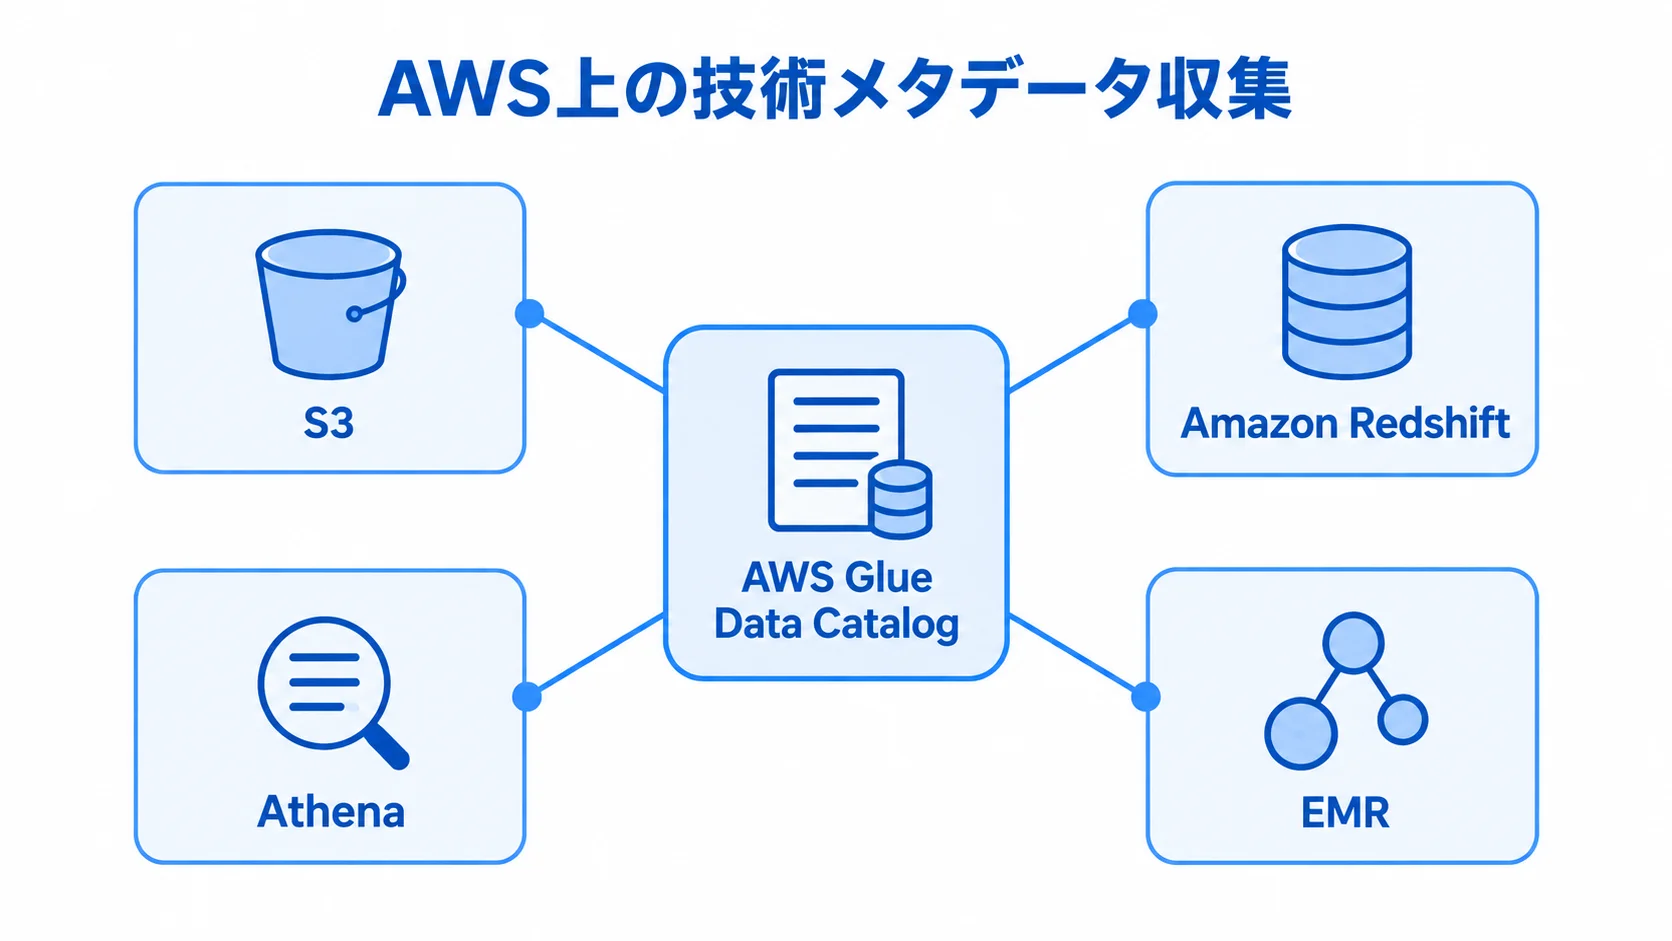
Amazon Web Servicesは、AWS Glue Data CatalogとLake Formationを中心に据えています。AWS上のデータ資産を管理したい企業に適しています。
S3、Amazon Redshift、Athena、EMRを中心にデータレイクを構築している場合は、技術メタデータを収集できます。さらに、IAMと連携でき、分析基盤へつなげやすい点も特徴です。
特徴と強み
AWS Glueの料金と、追加で設計が必要な機能を分けて見ておきます。
- 無料枠:メタデータオブジェクトは、最初の100万件まで無料です。
- 超過料金:10万オブジェクトあたり月額1米ドルです(出典:AWS Glue Pricing、2026年8月確認)。
- 別料金:クローラー、ETL、統計計算、Iceberg保守、S3などにも料金が発生します。
- 追加設計:業務用語集、部門責任者、検索ポータルは、支援範囲に含まれるかを確認します。
AWS Glue Data Catalogは、データソースからテーブルやスキーマなどの技術メタデータを集める中央リポジトリです。総額を判断するには、カタログ料金に加えて、別料金の項目もあわせて見る必要があります。
技術メタデータの収集とアクセス制御を早く整えたい企業に適しています。
得意領域・実績
AWS中心のデータレイクを運用し、S3のデータを分析や機械学習に再利用したい企業に適しています。
AWSのBMW Group事例では、技術メタデータと、人が読めるデータポータルを整備しました。さらに、組織内500人超が探索できる状態です(出典:AWS BMW Group case study、2026年8月確認)。
- 業務用語:Glueのメタデータと業務用語をどう結ぶかが要点です。
- 権限:Lake Formationと実データのアクセス権を、どう同期させるかを確認します。
- 運用範囲:AWS外のSaaSやオンプレミス、運用者の役割、品質是正手順まで含められるかが論点です。
導入パートナーには、どこまでを提案に含められるかを尋ねます。
Microsoft|Microsoft PurviewでMicrosoft環境を統合管理
Microsoft Purview Unified CatalogとData Mapを組み合わせて使います。そのため、AzureやMicrosoft Fabricの環境を統合管理できます。また、OneLakeやMicrosoft 365も管理対象にできます。
技術メタデータだけでなく、ガバナンスドメイン、データ製品、用語、品質、アクセス申請を業務の役割と結び付けていく方向です。
特徴と強み
Purviewの機能は、業務概念から技術資産、利用までを一続きで扱える点に特徴があります。
- 資産の関係づけ:業務概念やデータ製品を技術資産と関連付けます。
- 利用体験:データの発見、信頼性、保護を一つにまとめます。
- 課金基準:管理対象アセット数と品質・健全性管理の処理単位による従量課金です。
課金モデルは2025年1月6日に始まりました(出典:Microsoft Learn「Billing in Microsoft Purview Data Governance」、2026年8月確認)。
費用はスキャン数だけでなく、データ製品や用語に結び付けるテーブル数、品質ルールの実行回数によっても変わります。そのため、試算の前に、サブスクリプション、テナント、リージョン、対象アセット数、スキャン頻度を整理しておきます。
得意領域・実績
Azure、Power BI、Microsoft Fabricを中心に分析基盤を整備している企業に適しています。Microsoft 365のID・権限管理を活かしたい企業にも合います。
- 運用体制:オーナーやスチュワードを置き、業務部門が検索や申請を行う運用に合います。
- 他クラウド:AWSやGoogle Cloudのコネクタと、リネージュの対応範囲の確認が必要です。
新しいUnified Catalogと従来のData Catalogをどう使い分けるか、課金対象アセットをどう定義するか、表示権限と実データ権限をどう揃えるかを確認します。
用語承認や品質ルールの担当者、利用状況の測定方法まで設計できる支援会社を選びます。
Google Cloud|Knowledge Catalogで検索・品質・リネージュを統合
Google Cloudは、BigQuery、Cloud Storage、Lookerを中心にデータを扱う企業に適しています。旧Data Catalogからは、名称と機能の方向性が変わっています。
2026年は、Knowledge Catalogとして発見、意味づけ、品質、リネージュを統合する形を取ります。あわせて、データプロダクトをAIが使えるコンテキストにまとめる動きも強まっています。
特徴と強み
Knowledge Catalogの費用は、処理、保存、API、関連サービスごとに分けて確認します。
- 標準処理:1DCU時間あたり0.060米ドルからです。
- プレミアム処理:リネージュ・品質・プロファイリング込みで1DCU時間あたり0.089米ドルからです。
- 関連サービス:BigQuery、Dataflow、Managed Service for Apache Sparkの処理料金は別です。
メタデータ保存は1GiBあたり月額2米ドルからです。
API呼び出しには無料枠と超過料金があります(出典:Google Cloud Knowledge Catalog pricing、2026年8月確認)。
Dataplexを発展させたKnowledge Catalogは、業務コンテキストやデータプロダクトも集約します。
自然言語検索やAIエージェントの回答を支える方向に進んでいます。「売上の定義」や指標の元データを自然な言葉で探したい場合には、将来の拡張として検討できます。
得意領域・実績
導入時は、自社環境や運用条件に照らして確認します。
- 適する企業:BigQueryを中心に、品質、リネージュ、Lookerの分析モデル、自然言語探索をつなげたい企業です。
- 移行確認:Knowledge Catalogへの移行状況を見ておく必要があります。
- 保守上の注意:古いAPIや連携方式を前提にすると、将来の保守費用が膨らむおそれがあります。
- AI活用:先に用語とアクセス権を整えたうえで、誤ったコンテキストを検索結果に混ぜない運用を設計します。
旧Data Catalogは2026年1月30日に終了しました(出典:Google Cloud Data Catalog release notes、2026年8月確認)。
Databricks|Unity CatalogでLakehouseとAI資産を統合管理
Databricksは、データとAIを同じLakehouseで扱い、アクセス制御、監査、リネージュ、モデルやAI資産を統合管理したい企業に適しています。
Unity Catalogは、Databricks上のテーブル、ビュー、モデルなどを対象にします。データ利用の安全性を高め、追跡できる状態を保つガバナンスの仕組みです。
特徴と強み
作成元のクエリやノートブック、下流で使うダッシュボードをたどれます。
スキーマ変更の影響分析や監査に活用できます(出典:Databricks「Lineage in Unity Catalog」、2026年8月確認)。
Unity Catalogのリネージュ機能で足りない範囲を、外部資産でどう補うかを確認します。
- 外部資産:Databricks外のETLやBIまで完全自動で把握できるとは限りません。
- 上流・下流:SalesforceやMySQLなどの上流、TableauやPower BIなどの下流は、外部資産として登録する必要があります。
- 要件化:Lakehouse外の周辺システムまで含めた追跡範囲を、要件として明記します。
得意領域・実績
Unity Catalogが自社の基盤に合うかどうかと、Databricks外を含む管理範囲を見極めます。
- 適する基盤:Delta Lake、Apache Spark、機械学習モデルを運用し、技術者が同じ基盤を使う企業です。
- AIの追跡:学習データの出所、変換履歴、モデルでの利用状況を記録します。
- 導入設計:メタストアの単位と、外部リネージュを手動で連携するか自動にするかを確認します。
- 全社管理:業務用語集や外部資産の統合に必要な製品と連携の費用を比べます。
Informatica|マルチクラウド・オンプレミスを横断するガバナンス
Informaticaは、Cloud Data Governance and Catalogを中心に据えています。複数クラウド、オンプレミス、SaaSにまたがる資産を横断して管理したい大企業向けです。業務コンテキスト、分類、品質、リネージュ、アクセス管理を組み合わせて、データガバナンスの全体像を作りたい場合に候補になります。
特徴と強み
既存のデータ統合、品質、マスターデータ管理と連携します。カタログをデータ管理プログラムの一部として扱えます(出典:Informatica「Cloud Data Governance and Catalog Data Sheet」、2026年8月確認)。
導入時は、製品連携、総保有コスト、段階導入の条件を整理しておきます。
- 費用範囲:ライセンス、連携製品、導入支援、運用教育まで含めて考えます。
- 段階導入:対象ドメイン、コネクタ、品質ルール、利用者を範囲として定めます。
得意領域・実績
Informaticaは、複数環境と全社的なガバナンスを一体で扱う場合に検討します。
- 適する環境:AWS、Azure、Google Cloud、オンプレミスが混在する企業です。
- 統合対象:部門や買収企業ごとに異なるデータ管理を統合します。
- ガバナンス:規制対応、監査、品質証跡、業務用語集を一体で整えます。
- 契約・検証:コネクタ、変換補完、データ返却を確認したうえで、主要システムでPoCを行います。
PoCでは、収集精度と運用負荷を確かめます。
データカタログのパートナー選びで確認するポイント
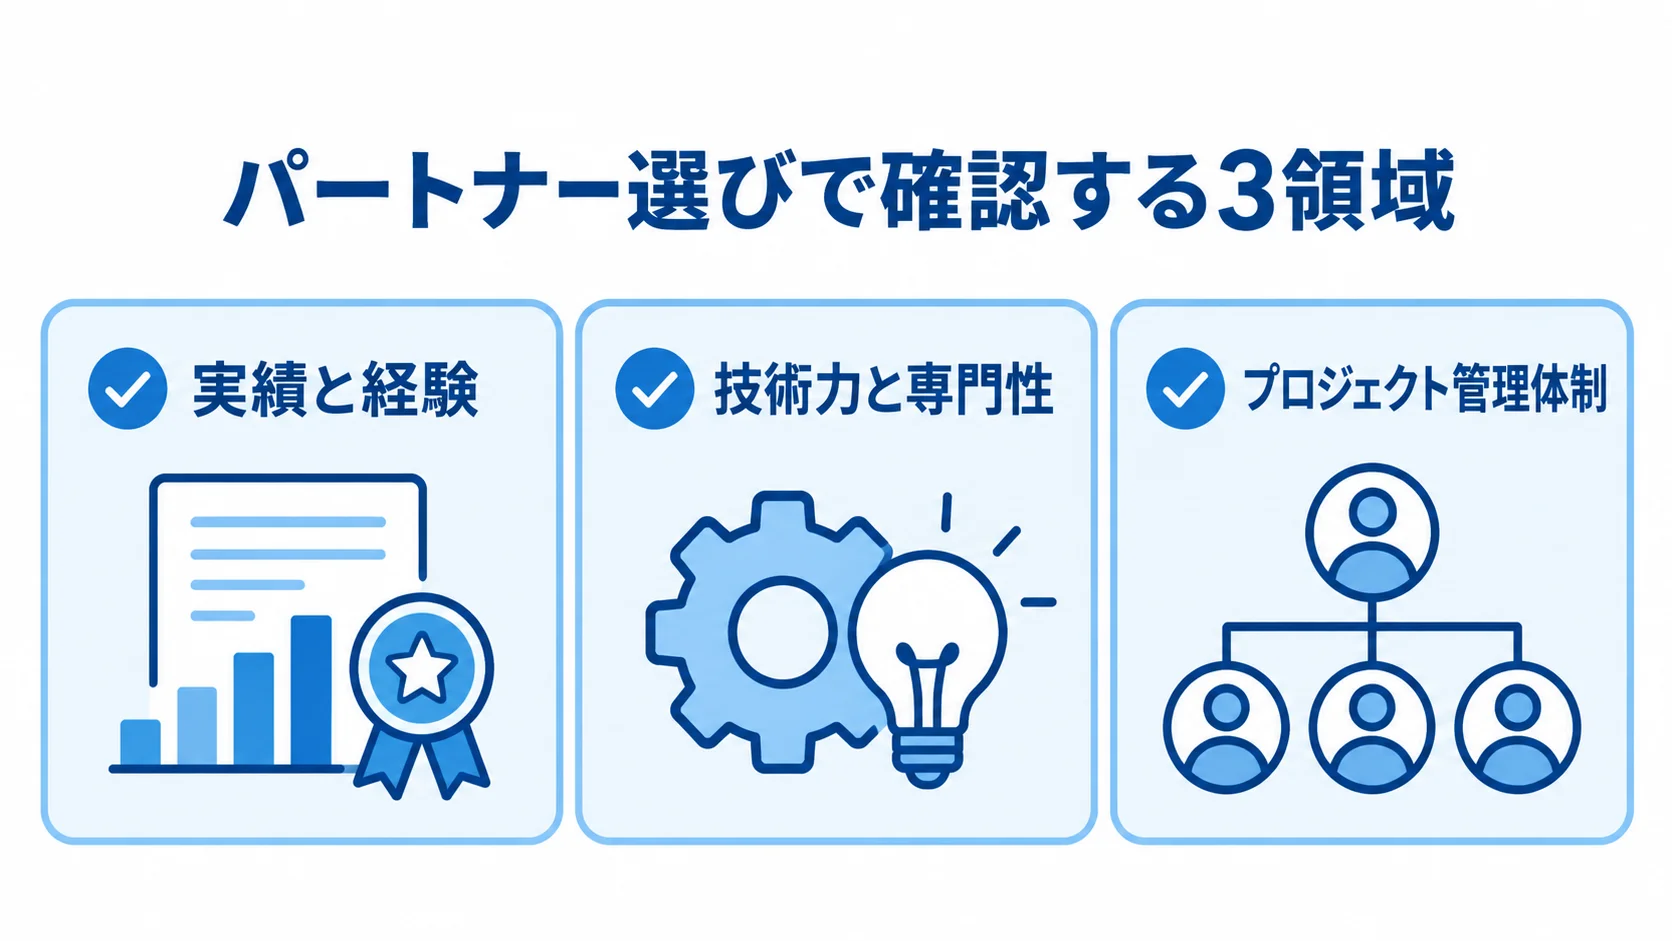
6社を比べるときは、知名度や機能数だけでなく、自社のデータ基盤、業務課題、運用人員に照らして評価します。
製品ベンダーは機能とロードマップを持ち、開発会社やSIerは要件定義・実装・移行・定着を担います。そのため、役割ごとに分けて見積もりを読みます。
実績と経験の確認方法
導入件数だけでなく、対象データソース、利用者数、部門、用語数、品質ルール、導入後の利用率を確認します。
同じクラウド構成の事例がなければ、業界だけにこだわらず、同じ権限要件やデータ量を扱った経験を尋ねます。また、事例の数字が、ベンダーの公式情報か提案会社の実装範囲かを分けて確認します。
技術力と専門性の評価
技術評価では、接続性と、運用時の復旧・追跡機能を合わせて確かめます。
- 更新と復旧:差分更新、スキーマ変更、失敗時の再実行
- 追跡と分類:カラム単位のリネージュ、個人情報の自動分類
- 連携:API連携とコネクタの対応範囲
メタデータの古さの検知、所有者が退職したときの引き継ぎ、品質違反の是正期限も、デモやPoCで確かめます。検索の速さだけでなく、結果の意味を説明できることが重要です。
プロジェクト管理体制の確認
体制と費用は契約前に整理し、導入後の運用まで見積もりに含めます。
- 参加者:データオーナー、業務スチュワード、情報システム、セキュリティ担当者を、あらかじめ決めておきます。
- 契約内容:責任者と作業分担、成果物を明記します。レビュー回数、障害対応、保守窓口も含めます。
- 運用移行:用語更新や権限申請が止まらないよう、教育と引き継ぎが必要です。
費用の比較方法は、公開価格のあるクラウドサービスと個別見積もりの製品で異なります。
3〜10ソース程度のPoCは300万〜800万円、10〜30ソースの部門導入は800万〜2,000万円です。
全社・マルチクラウドは2,000万〜5,000万円以上が概算目安です。
上記の金額は、データ基盤やメタデータ管理に近い作業量をもとにした推定値で、公開されている共通の相場ではありません。そのため、ライセンス、従量課金、開発、教育、運用人件費を分けて、相見積もりを取ります。
データカタログに関するよくある質問
発注の段階では、製品の選定に加えて、費用、導入範囲、権限、運用体制について質問が寄せられます。比較の初期に確認しておきたい内容を紹介します。
データカタログはDWHやデータ辞書と何が違いますか?
データカタログは、DWHのようにデータを集めて分析する保管基盤ではなく、分散した資産の場所、意味、所有者、品質、利用関係を検索できる仕組みです。
データ辞書が用語や項目の定義を中心にするのに対し、カタログは技術メタデータ、用語集、リネージュ、品質、権限、利用申請を横断して管理します。
データカタログの開発費用はいくらですか?
小規模PoCは300万〜800万円、部門導入は800万〜2,000万円、全社・マルチクラウドは2,000万〜5,000万円以上が概算の目安です。
一律の公開価格ではなく、接続数や利用者数、用語・品質の整備を踏まえた推定で、権限、移行、教育、運用設計も含みます。クラウドの従量課金や製品ライセンスは、別項目として扱います。
3社程度から同じ条件で見積もりを取ります。
データカタログは何から始めればよいですか?
解決したい業務課題とKPIは、一つか二つに絞ります。たとえば、売上定義の問い合わせ時間を50%短縮する、所有者未設定の資産をゼロにする、再利用件数を増やす、といった指標です。
責任者を置ける一つのデータドメインで、4〜8週間のPoCを実施します。検索の有用性、メタデータの鮮度、権限設計、運用負荷を評価してから、対象を広げます。
まとめ|自社のデータ基盤と運用体制に合う会社の選び方
おすすめの開発会社やベンダーは、既存の基盤と目的によって変わります。AWSのデータレイクで技術情報を集めるならAWS、Microsoft環境を統合するならMicrosoftが候補になります。
また、BigQueryとAI向けの検索ならGoogle Cloud、LakehouseとAI資産のリネージュならDatabricksが候補です。さらに、複数クラウドやオンプレミスを横断するなら、Informaticaが候補になります。
製品と開発支援の比較
製品はコネクタ数だけでなく、用語集、オーナー、スチュワード、品質、リネージュで比べます。加えて、権限、監査、API、データ返却条件も比べます。
製品ベンダーの機能と、開発会社の要件定義・実装・教育・運用支援は、同じRFPで整理します。そうすると、担当範囲の重複や抜けを防げます。
対象ドメインとKPIの決め方
PoCでは、対象選定から拡大判断まで順に確認します。
- 対象選定:問い合わせが多く、責任者を置きやすい顧客・売上・財務などから選びます。
- PoC:4〜8週間で調査時間、検索利用率、再利用件数を測ります。
- 運用指標:所有者設定率と、品質違反の是正日数も見ておきます。
- 拡大判断:数値と運用負荷を確かめたうえで、対象システムを増やします。
▼全体ガイドの記事
・データカタログ開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。