
DataLoaderは、同一リクエスト内のデータ取得をまとめ、重複を排除してキャッシュするユーティリティです。GraphQLのN+1問題を抑える用途で知られています。
導入では、手法名を選ぶより先に、誰のどの意思決定を支えるのかを決めておきます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
DataLoaderの定義と役割
DataLoaderは、同じリクエスト内で重複して行われるデータ取得を、キャッシュで防ぐ仕組みです。GraphQLのN+1問題を抑える用途で知られています。
定義を実務に落とすときは、入力、処理、出力、仮定を分けて記録しておきます。
入力に将来の情報が混ざると、検証のときだけ有利に見える結果になることがあります。
対象範囲が変わると、結果が実態を反映しなくなることがあります。そのため、データの発生時点と評価時点をそろえ、除外条件や欠測の扱いを先に決めておきます。
DataLoaderの仕組み|処理の流れと判断材料
1. 目的とデータの単位の定義
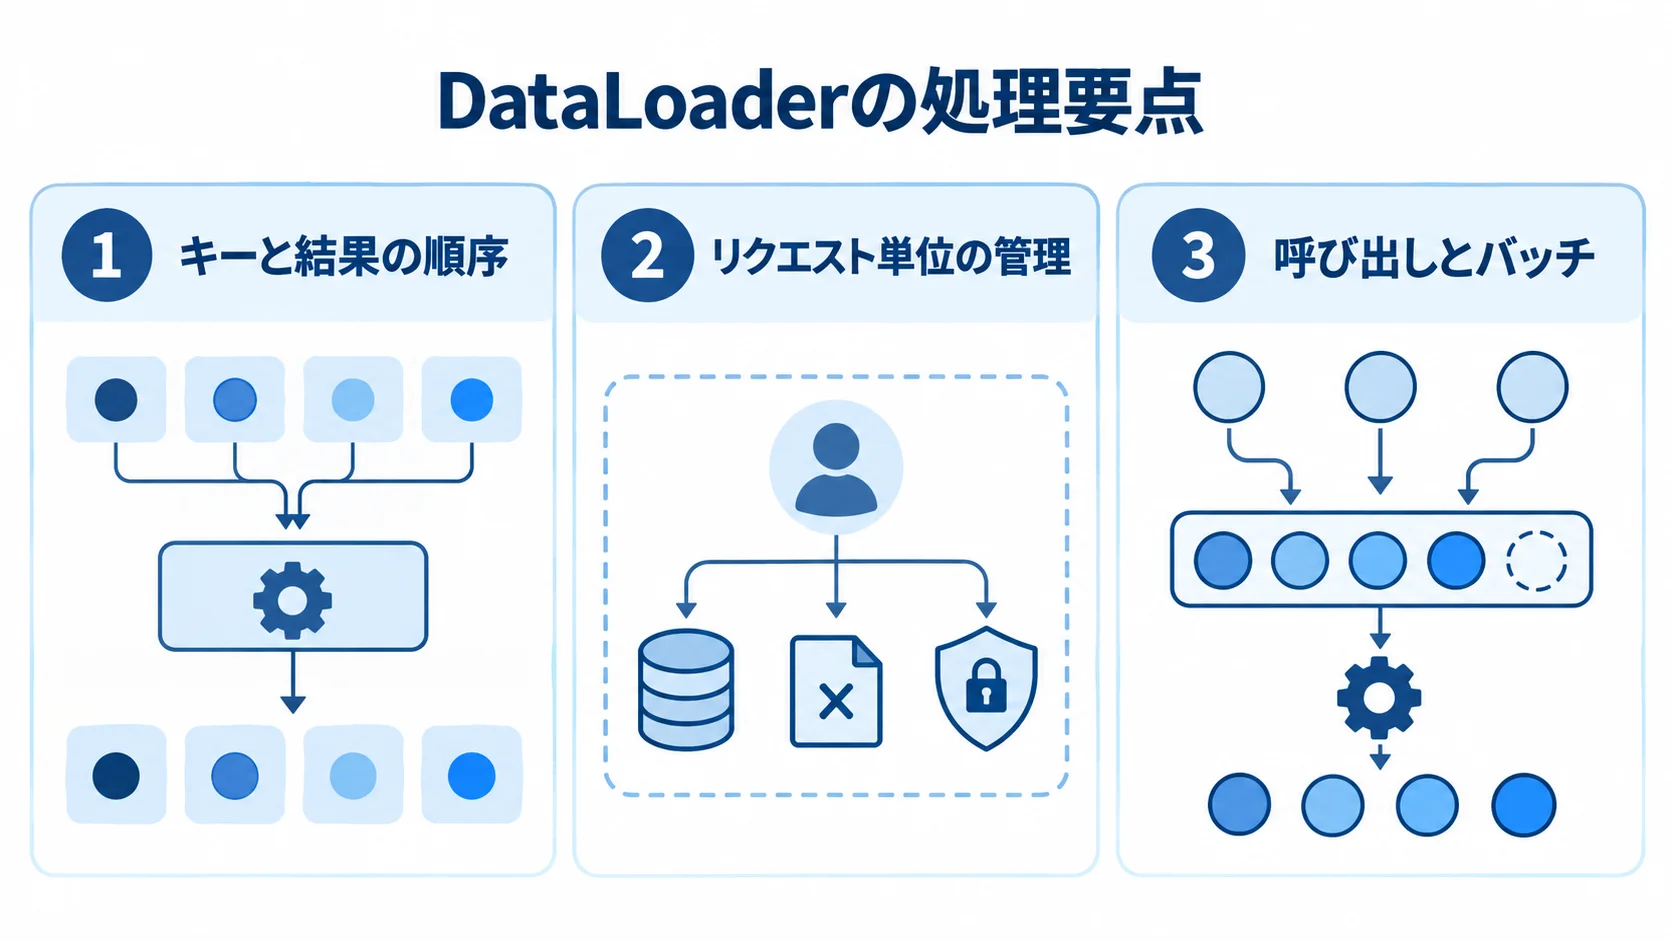
DataLoaderの処理と検証の前提は、次の4点にまとめられます。
- キーと結果の順序:キーを一時的に集めてバッチ関数へ渡し、キーと同じ順序で結果を返します。
- リクエスト単位の管理:キャッシュ、エラー、認証コンテキストの管理。
- 検証条件:目的変数や評価値の意味、観測単位を確定し、対象期間と使える変数も決める。
- 対象外の扱い:業務上の対象外を後から都合よく除かず、除外件数と理由をログに残します。
2. 候補の評価と設定の記録
候補を比べても結果を再現できるよう、設定と記録の要点を押さえます。
- 評価の役割:候補となる設定やモデルを複数用意し、訓練、検証、最終評価を分けておく。
- 前処理:変数選択を含め、全データへ先に当てないこと。
- 処理の保存:再現できるパイプラインの形で保存しておく。
- 再現用の記録:乱数やライブラリのバージョン、設定値、入力データのスナップショットを残す。
3. 結果を判断できる形への変換
出力は、スコアや係数のままにせず、利用者が判断できる単位に戻します。そのうえで、判断の前に確認する運用指標として、呼び出しの回数や処理の状況を見ておきます。
- 呼び出しとバッチ:呼び出し回数とバッチサイズを確かめる。
- 処理状況:遅延やキャッシュヒットの状態を、メモリやエラー対応とあわせて見る。
点推定の数字だけでなく、不確実性、対象外の条件、判断を覆す反証も併記します。
DataLoaderの使い方|実務での適用場面
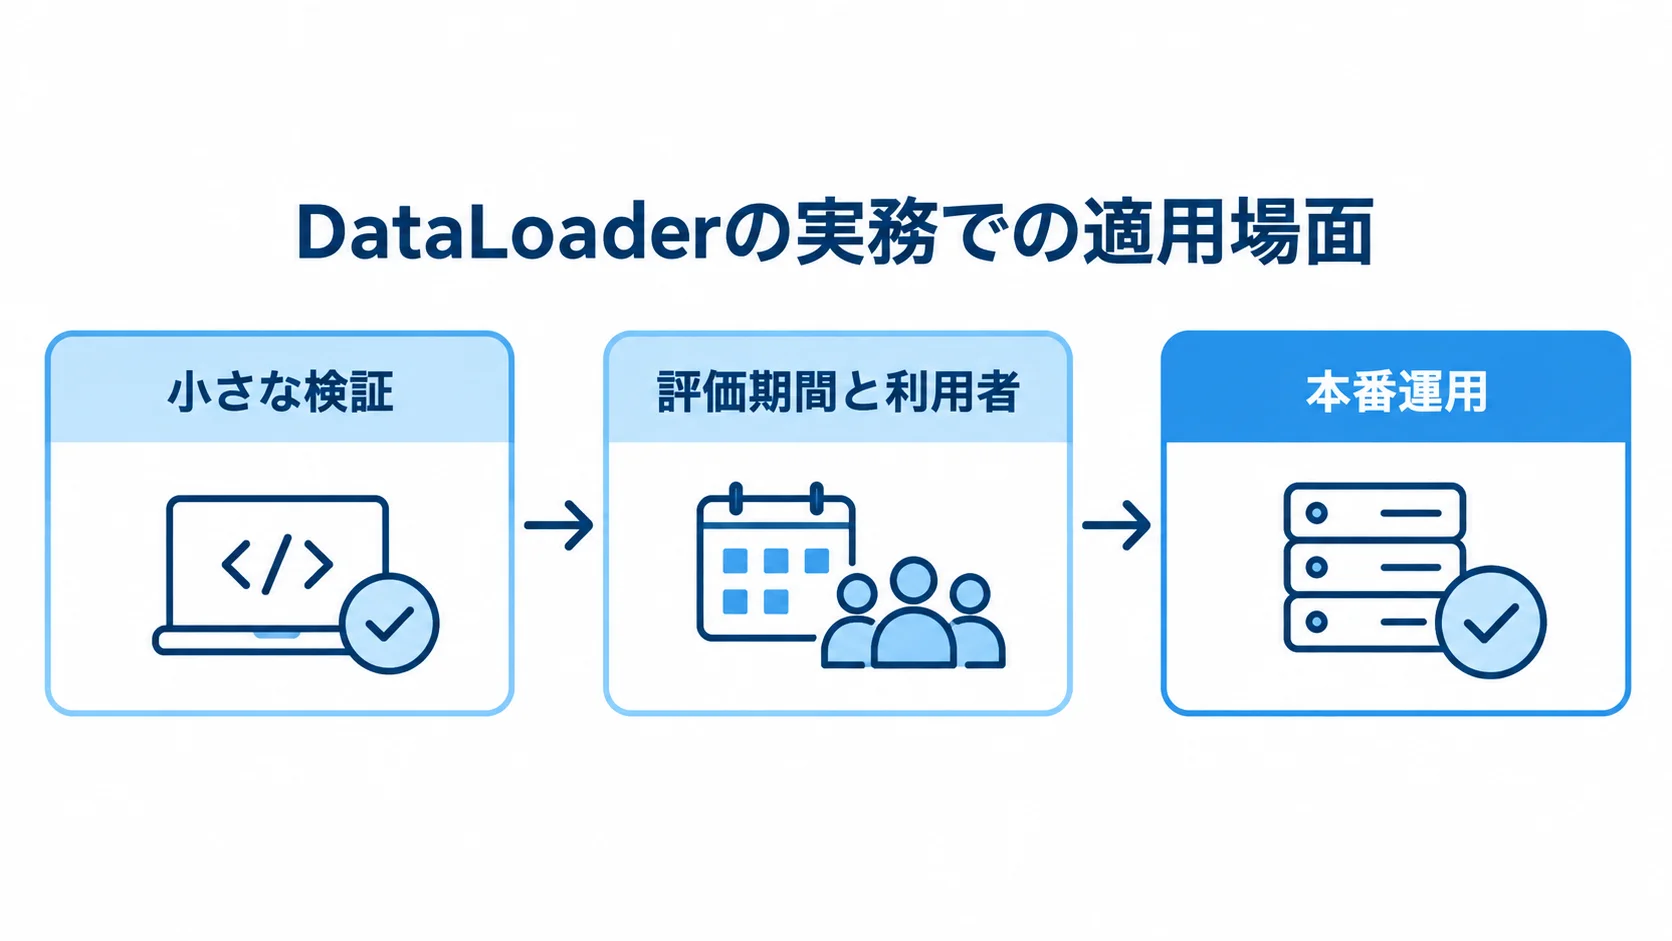
小さな検証の始め方
Resolverが関連データを個別に取得し、同じデータベースやAPIを何度も呼ぶ場面で役立ちます。また、バッチサイズとキャッシュの寿命を制御します。
最初は代表的なデータと明確な成功条件に絞り、基準手法との差を測ります。ただし、短期の指標が改善しても、それだけで採用を決めないようにします。
採用の可否は、運用負荷、説明可能性、更新頻度に加えて、例外処理まで含めて判断します。
評価期間と利用者の整合
未来の情報を使えない業務では時系列分割を使い、同じ顧客や案件が繰り返し現れる場合は、グループ単位で分割します。
レポートを読む人が結果の意味を誤解しないよう、指標の単位と分母を明記し、対象範囲と信頼区間も書いておきます。
本番運用への移行
本番運用では、次の3点を整えておきます。
- 状態の監視:入力の欠損率と分布を見るほか、結果の品質、処理時間、エラー率も追います。
- 悪化時の対応:再学習・再推定の条件、承認者、ロールバック先を決めておく。
- 集計ログ:検証時と同じ集計を再現できるログを残します。
DataLoaderと関連手法の違い
HTTPキャッシュやDBのJOINは、DataLoaderとは別の層で働く最適化です。DataLoaderはアプリケーション内の呼び出しをまとめるもので、永続キャッシュの代わりにはなりません。
比べるときは、データ分割と目的、評価期間をそろえ、前処理と計算予算も同じ条件にします。手法ごとに答えられる問いが違うなら、単純な順位付けは避けます。代わりに、精度と安定性、説明、費用を並べ、保守性も含めた判断表を作ります。
DataLoaderの評価方法|指標の読み方
主要指標と不確実性
DataLoaderの挙動を判断するには、次の運用指標を見ます。
- 呼び出しとバッチ:回数と、まとめた件数の大きさ。
- 処理性能:遅延とキャッシュヒットの状況。
- 資源と障害:メモリ使用量とエラー対応の状況。
診断と再現性
平均値だけでなく、期間別、グループ別、極端なケース別にも結果を確かめます。
設定を変えた感度分析も行います。
別データでの確認や、複数シードでの再実験を行い、結論が一つの偶然に依存していないかを点検します。
DataLoaderで起きやすい失敗と対策
データと前処理の問題
次の操作は、性能や推定を楽観的にしてしまうおそれがあります。
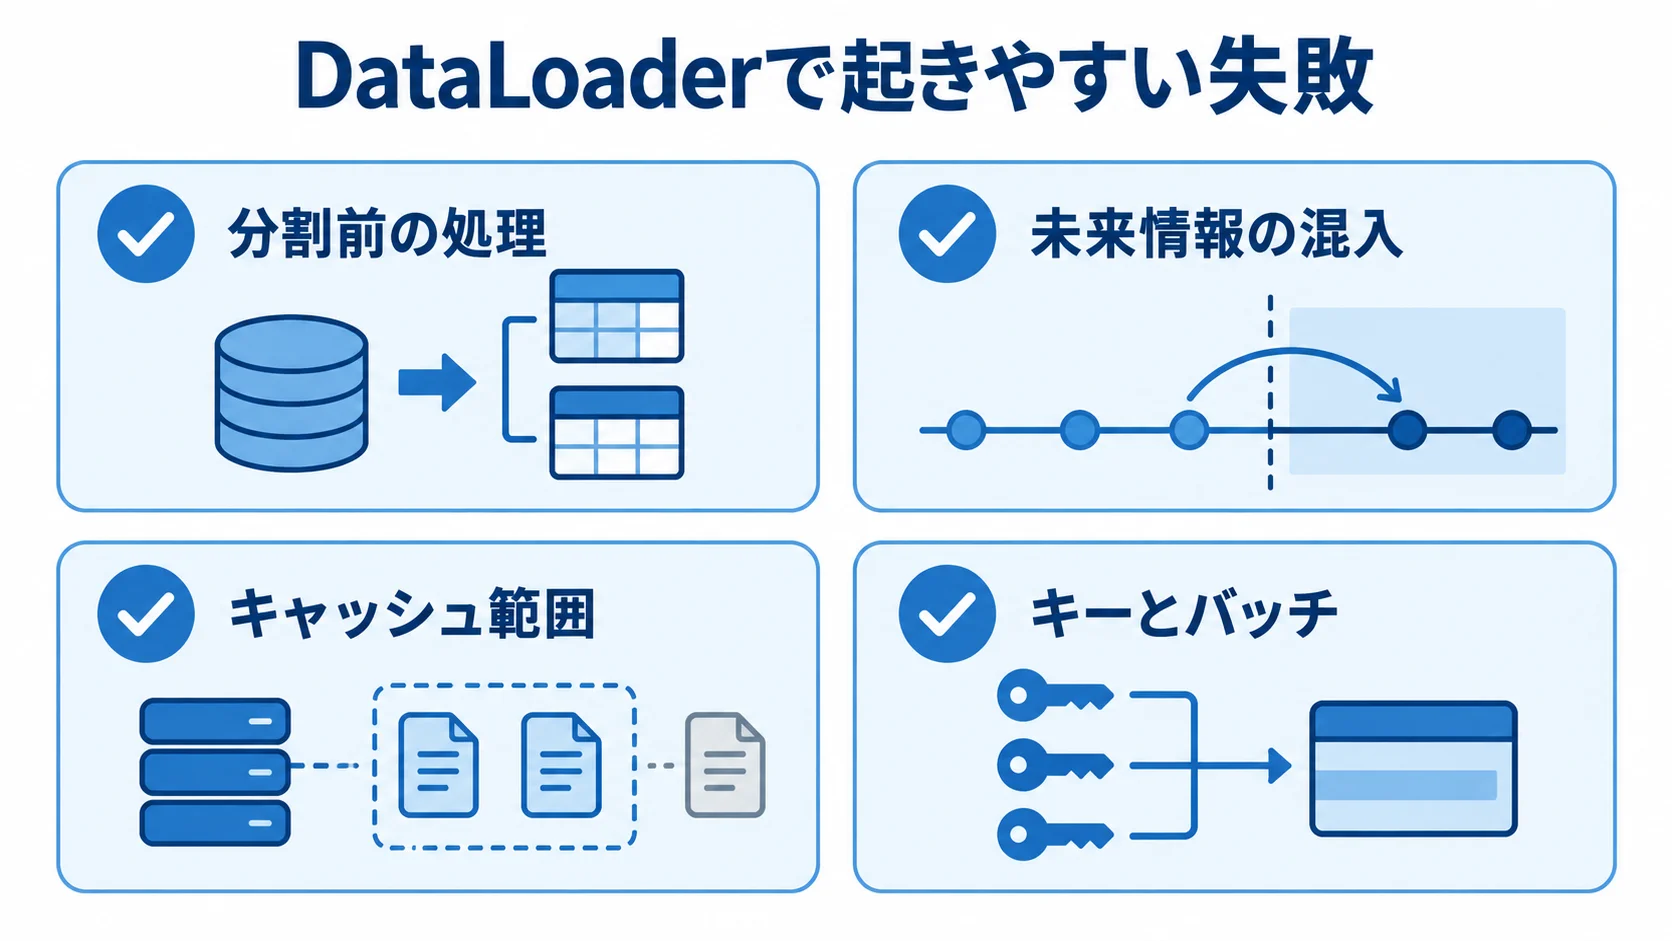
- 分割前の処理:全データで集計や標準化、補完を済ませてから分割する。
- 未来情報の混入:将来の値を入力に含めてしまう。
- 評価対象の選別:結果を見て評価対象を選ぶこと。
前処理は学習側だけに限定し、処理の前後で件数と値域を監査します。
指標と問いの混同
DataLoaderでは、実装や設定まわりで次の失敗が起こりえます。
- キャッシュ範囲:リクエストをまたいでキャッシュしてしまう。
- キーとバッチ:キーの順序を誤ったり、バッチ関数で欠損が生じたりする。
- 権限と規模:権限が混在したり、巨大なバッチを扱ったりする。
指標が改善しても、それが業務成果や因果効果を意味するとは限りません。そのため、分析が答える問いと意思決定者の問いを並べて確かめます。両者に差があるなら、足りない仮定やデータを明示します。
運用条件の変化
制度や価格、顧客構成は移り変わり、季節性や計測方法も変わります。そこで、次の2項目を監視します。
- 入力:分布と欠測の状況。
- 結果:品質と、主要グループごとの差。
再評価のきっかけは、事前に決めておきます。
DataLoaderを採用する判断基準
同じリクエスト内で重複取得が起き、バッチAPIを用意できるなら、DataLoaderを採用できます。その際は、データの分離単位も守ります。
採用しない場合も、基準手法と見送った理由、次に必要なデータを記録しておきます。記録があれば、将来の再検討が容易になります。
説明資料では、数式やアルゴリズムだけでなく、仮定と分からない範囲を示します。利用者が反証条件や適用範囲を確かめられるようにします。
成功例だけでなく失敗例も残しておくと、結果を利用する人が判断しやすくなります。
DataLoaderまとめ|目的・前提・評価の要点
まとめると、DataLoaderは同一リクエスト内の取得を束ね、重複をキャッシュで防ぐ仕組みです。
知られている用途は、GraphQLのN+1問題の抑制です。
価値を出すには、対象と時間、入力と出力を定義し、仮定も明らかにしておきます。そのうえで、基準手法と同じ条件で評価し、小さく検証してから適用範囲を広げます。
設定、データ、評価結果は、再現できる形で保存します。
精度や有意性だけでなく、誤りのコストや説明可能性、運用負荷も判断材料になります。また、影響を受ける人への公平性も含めて判断してください。
よくある質問(FAQ)
Q. DataLoaderとは何ですか?
同一リクエスト内のデータ取得をまとめ、重複を排除してキャッシュするユーティリティです。GraphQLのN+1問題を抑える用途で知られています。
Q. DataLoaderはどのような場面で使いますか?
同一リクエスト内で重複して行われるデータ取得をまとめ、GraphQLのN+1問題を減らしたいときに使います。
Q. DataLoaderを使うときの評価指標は何ですか?
呼び出し回数とバッチサイズを見ます。遅延やキャッシュヒットのほか、メモリとエラー対応も確かめます。
Q. DataLoaderで起きやすい失敗は何ですか?
リクエストをまたぐキャッシュやキー順序の誤りに注意します。あわせて、バッチ関数の欠損や権限の混在、巨大バッチにも気をつけます。
Q. DataLoaderと似た手法はどう使い分けますか?
DBやHTTPのキャッシュとは異なり、DataLoaderはアプリ内の呼び出しを、リクエスト単位でまとめます。
参考資料
本記事で扱う定義と実務上の注意は、次の公式資料を参照しています。
https://github.com/graphql/dataloader、https://www.apollographql.com/docs/apollo-server/data/fetching-rest。
仕様や前提は更新されるため、実装時は利用するバージョンの公式ドキュメントも確認してください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。