
深層強化学習は、強化学習の方策や価値関数をディープニューラルネットワークで表現し、状態と報酬の経験から複雑な意思決定を学ぶ方法です。表形式のQテーブルでは扱いにくい画像、センサー値、長い状態ベクトルから、行動に必要な特徴を自動的に獲得します。ゲームやロボット制御などで使われていますが、学習の不安定さやサンプル収集コスト、報酬設計、安全性が課題です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
深層強化学習の仕組み:方策と価値のネットワーク近似
強化学習では、エージェントが状態を観測して行動を選び、その結果として報酬と次の状態を受け取ります。一方、深層強化学習では、状態から行動ごとのQ値や行動の確率分布をネットワークが出力します。
状態の数が膨大でも、行動に必要な特徴を学習できるのが利点です。なお、学習時は探索を含めて行動し、評価時は固定した方策で測定します。
DQNによるQ値の推定
DQNは状態を入力として、行動ごとのQ値を出力します。学習では、ベルマン方程式に基づく目標値との差を損失として扱います。DQNの学習を安定させる工夫は、経験再生とターゲットネットワークです。
- 経験再生:過去の遷移をランダムに取り出して使い回す仕組み
- ターゲットネットワーク:学習の目標値を安定させる役割
実装の例として、PyTorchの公式チュートリアルにも、両者を組み合わせた例があります。
方策最適化による行動分布の直接更新
方策勾配法やPPOは、行動の確率分布をパラメータとして直接表し、そのまま更新します。更新には、得られたリターンやアドバンテージを使います。方策系の方式を選ぶときは、行動の種類とデータ収集の条件を見ます。
- 連続行動:方策の分布を直接扱いやすいという特徴
- オンポリシー学習:方策系では、データ収集が欠かせません
オンポリシー方式では、環境のステップ数が増えることがあります。DQN系と方策系は、行動空間、データの再利用、安全性の3点で比べます。
代表アルゴリズムと問題の性質による選び方
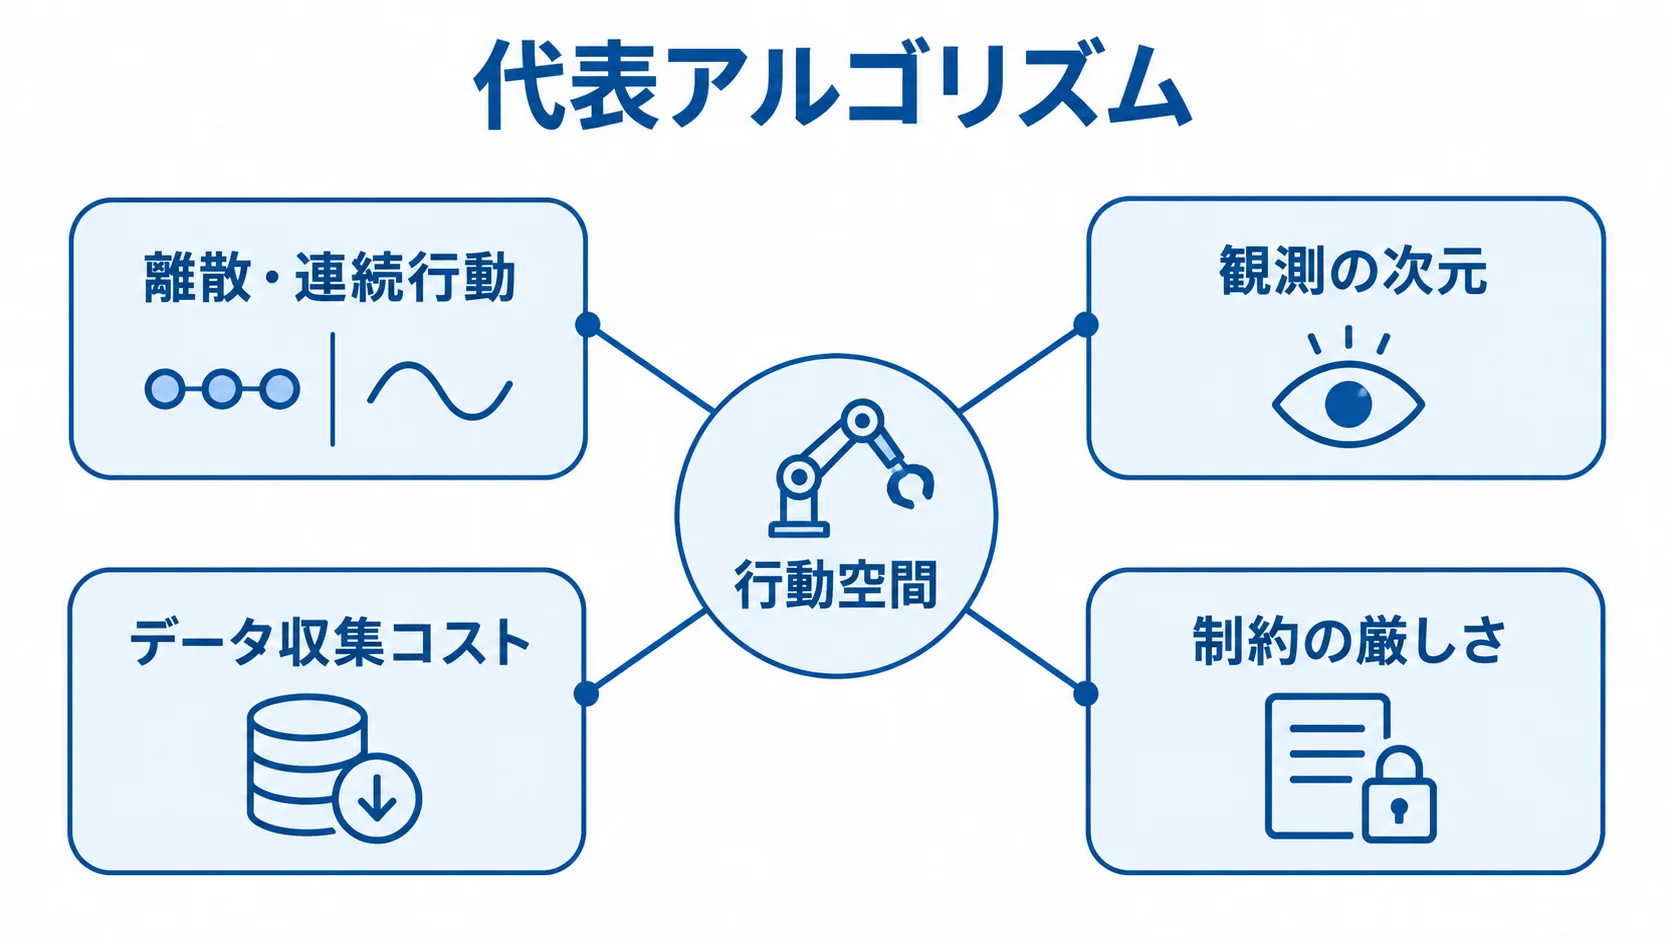
DQNからPPOまでは、行動空間や方策の更新方法に応じて役割が異なります。
- DQN:離散行動のQ値を学習し、経験再生を使います。
- DDPG・TD3:連続行動で、決定的方策とQ関数を組み合わせる方式
- SAC:報酬と方策エントロピーを考慮し、探索を維持する設計
- VPG・A2C:方策勾配と価値推定を使う基本的な方策最適化
- PPO:方策の更新幅を制限して、学習を安定させます。
方式を選ぶときは、離散か連続かという行動の種類、観測の次元、データ収集コストを整理します。さらに、オフラインログの有無や制約の厳しさも見ておきます。そのうえで、小さな環境でベースラインを再現してから、複雑なモデルへ進みます。
シミュレーションと評価環境を分けた開発の進め方
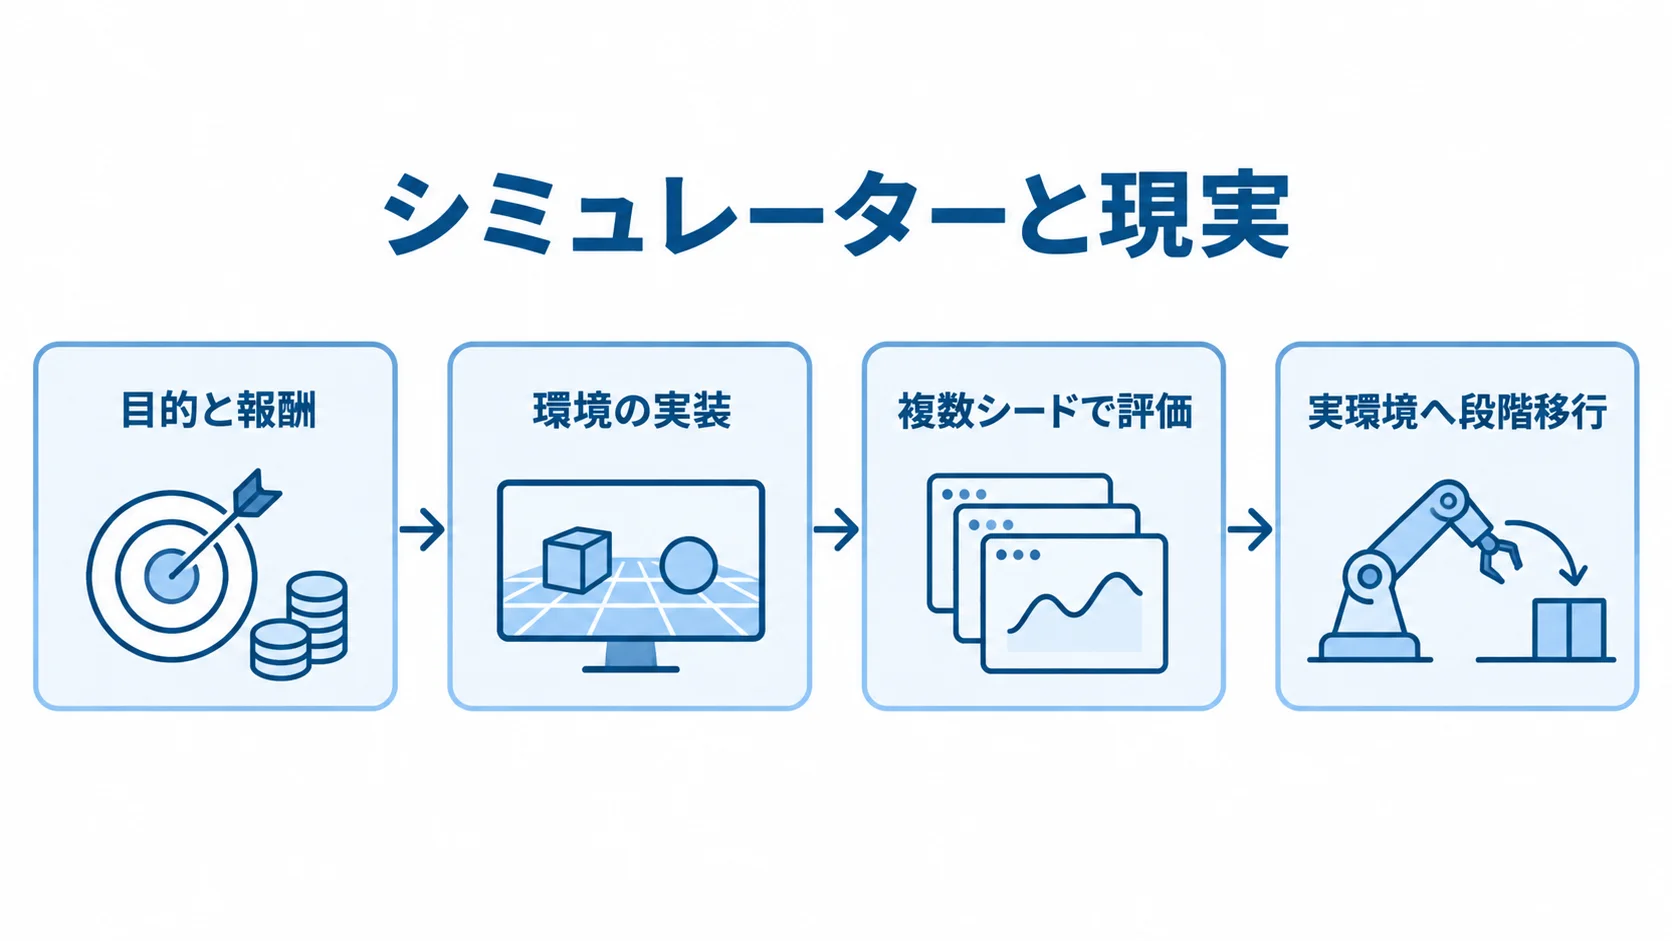
開発は、目的と報酬を決めるところから始めます。続けて環境とベースラインを整え、学習を評価してから、最後に実環境へ移ります。各段階で必要な確認を順に行います。
- 目的と報酬:最大化する業務指標と禁止事項、終了条件
- 環境の実装:状態、行動、遷移、報酬、リセットを個別に検証
- ベースライン:ルール、ランダム、既存モデルとの比較を可能にする
- 学習条件:乱数、ネットワーク、バッファ、評価頻度の記録
- 複数シードで評価:平均、ばらつき、失敗軌跡の確認
- 実環境へ段階移行:上限、承認、停止、ロールバックの準備
シミュレーターと現実では、物理、遅延、ノイズ、利用者の反応が異なる場合があります。こうした差があると、学習した方策が本番で崩れることがあります。その対策として、現実のログを使った検証、ドメインランダム化、保守的な行動制約を組み合わせます。
報酬だけでなく安全性と再現性を見る評価
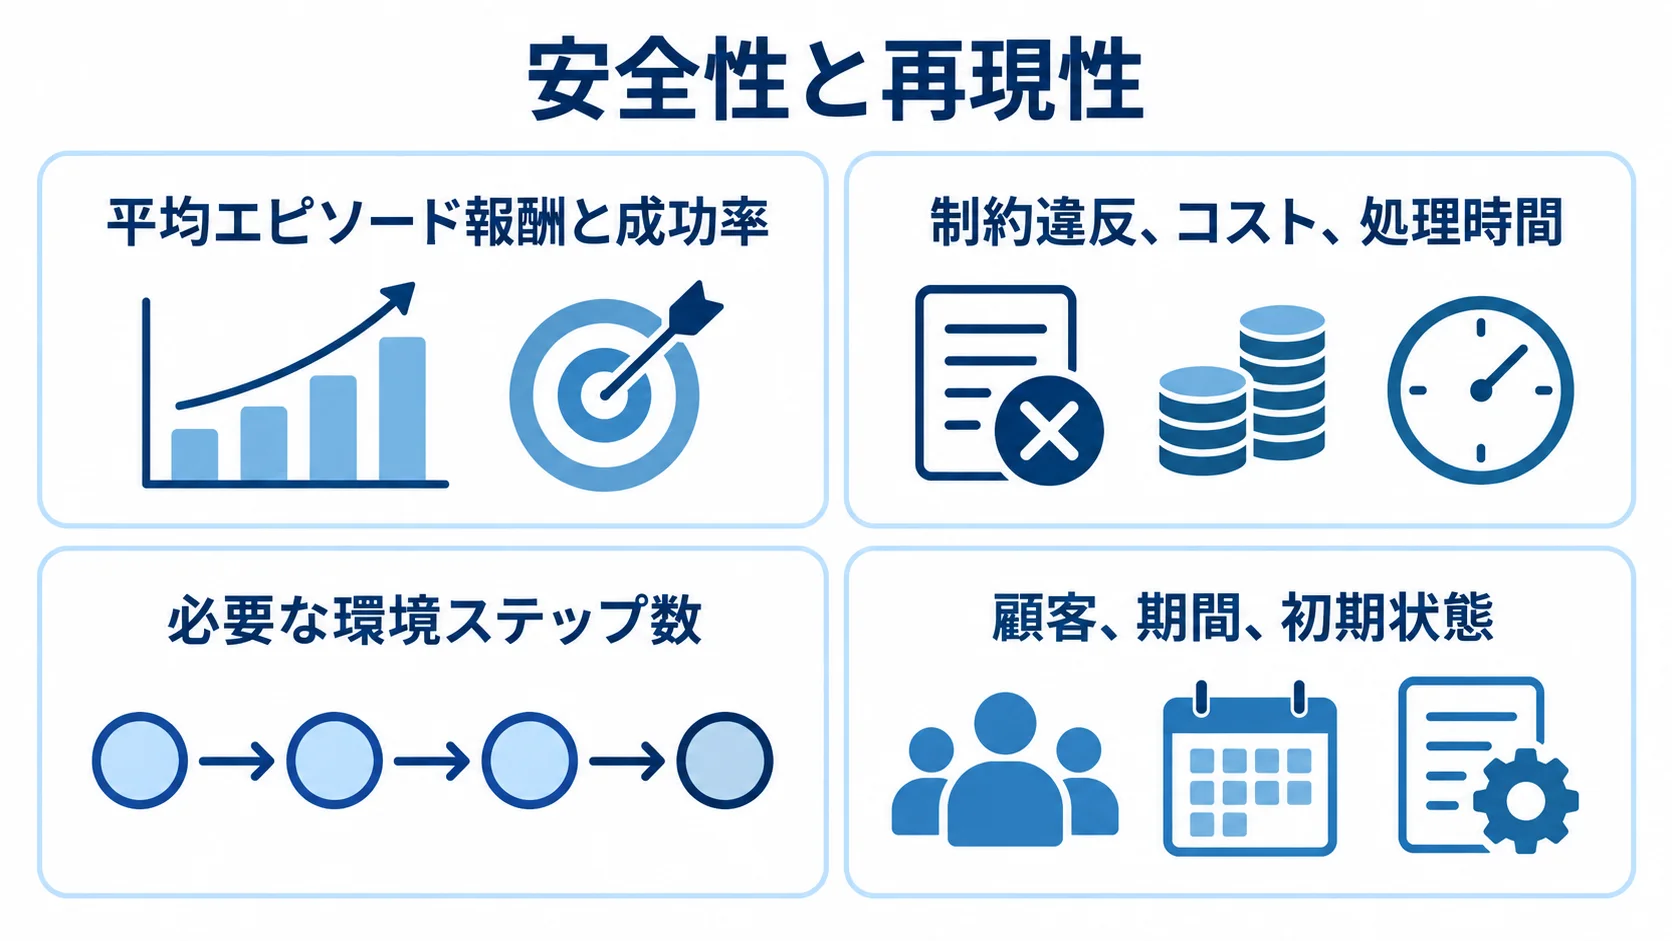
深層強化学習では、報酬に加えて安全性と再現性も評価します。指標を分けて測ることで、方策の特性を確認できます。
- 成果:平均エピソード報酬と成功率
- 安全性と運用:制約違反、コスト、処理時間の確認
- 学習効率:必要な環境ステップ数を測る
- 分布変化への頑健性:顧客、期間、初期状態を変えて評価
探索を含む学習時の報酬と、固定方策の評価時の報酬は、別物として区別します。なお、ログから学ぶ場合は、データにない行動を過大評価する危険があります。
その対策として、行動のカバレッジ、分布外検出、保守的な価値推定を検討します。シミュレーションによる反実仮想評価も選択肢に入ります。
深層強化学習で起きやすい失敗と対策
学習の発散
学習が発散した場合は、まず学習の設定と推移から原因を探します。
- 学習設定:学習率、報酬スケール、ターゲット更新の見直し
- モデルの状態:勾配、正規化、ネットワーク初期化の確認
小さな環境で損失とQ値の推移を図にして、複数シードで再現性を確かめます。
報酬の抜け道と設計の見直し
報酬の抜け道を防ぐには、報酬以外の面も同時に見ておく必要があります。
- 品質と安全:報酬外の品質、安全、顧客への影響を並行して監視
- 禁止行動:報酬ではなく制約として扱います。
代表的な軌跡は人が確認し、その結果をもとに報酬の設計を繰り返し見直します。
実環境での探索コスト
実環境での危険な探索を減らすには、学習の進め方を工夫することが欠かせません。
- 探索を減らす:シミュレーター、オフラインログ、事前学習の活用
- 方策を保守的にする:慎重に動く方策を使い、危険を抑えます。
導入後にも、旧方式へ戻せる切り替えを用意しておきます。
深層強化学習は複雑な状態から意思決定を学ぶ仕組み
深層強化学習は、ニューラルネットワークで方策や価値を近似し、経験から長期の報酬を最大化する方法です。DQN、方策勾配法、PPOなどを、行動空間とデータの条件で使い分けます。
報酬の抜け道、学習の不安定さ、シミュレーションと本番の差、安全な探索が主な論点です。導入に向けては、ベースライン、複数シード、制約、停止手順を整えたうえで、平均報酬だけで判断しないことが重要です。
よくある質問(FAQ)
深層強化学習について、よく寄せられる疑問に答えます。
Q. 深層強化学習とは何ですか?
ニューラルネットワークを使って、強化学習の方策や価値関数を表し、複雑な状態から行動を学ぶ方法です。
Q. DQNとの関係は何ですか?
DQNは深層強化学習の代表例で、ニューラルネットワークにより離散行動のQ値を近似する手法です。
Q. アルゴリズムはどう選びますか?
方式は、行動の種類とデータ収集コストを整理して選びます。オフラインログや安全制約の有無も確かめ、ベースラインと比べて決めます。
Q. 何を評価すればよいですか?
報酬と成功率に加えて、制約違反やコストも評価します。さらに、複数シードのばらつきと、環境の違いへの頑健性まで確かめます。
Q. すぐ本番へ導入できますか?
本番へすぐ移すのではなく、まずシミュレーションとオフライン評価を行います。そのうえで、制約、人の承認、停止とロールバックを整え、段階的に検証します。
参考資料
深層強化学習の基本概念と、本文で触れたDQNとPPOの解説を確認できる資料です。
- OpenAI Spinning Up「Key Concepts in RL」
- PyTorch「Reinforcement Learning (DQN) Tutorial」
- OpenAI Spinning Up「PPO」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。