
分散表現は、単語や文書などを多数の数値からなるベクトルで表し、意味や関係を連続空間で扱う表現です。
意味検索や推薦、分類などのほか、類似度計算にも使われます。ただし、学習データの偏りや語義の多義性もベクトルに反映されるため、距離を意味そのものと見なさず、用途に合う指標で検証します。
分散表現の定義:意味をベクトルで表す仕組みと活用方法
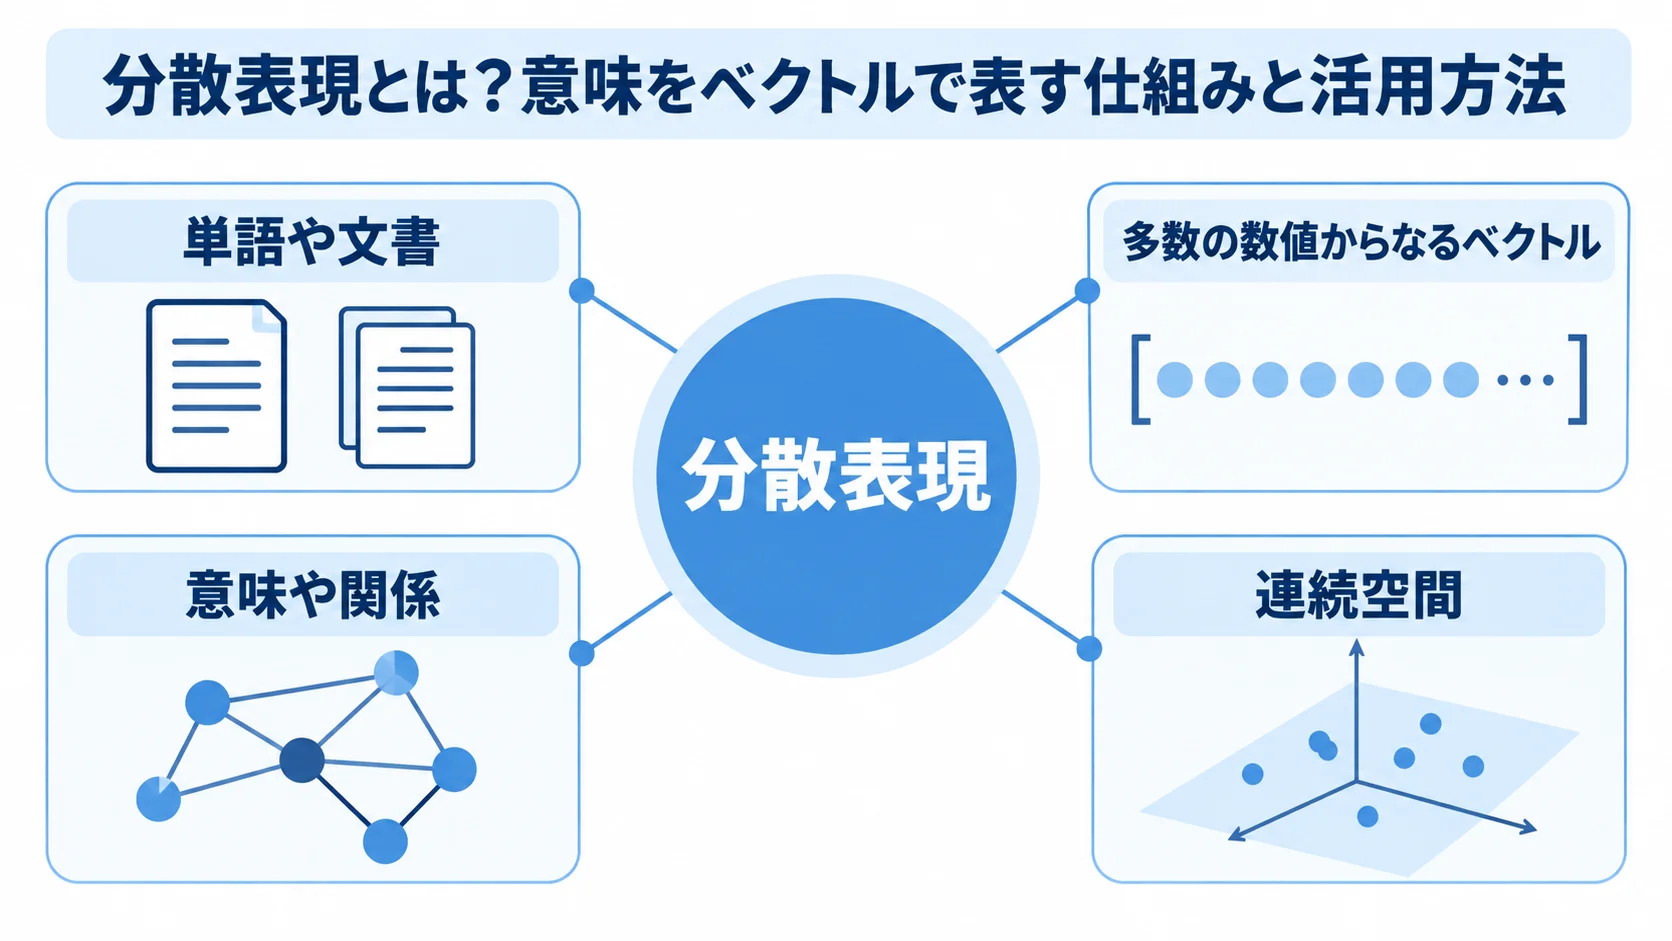
ここでいう分散表現は、単語や文書などを多数の数値からなるベクトルに置き換え、意味や関係を連続空間の中で扱う表現です。この表現では、似た用法を持つ対象どうしの距離や方向を、モデルが利用できる形で表します。単語IDのような離散記号とは違い、この性質によって意味の近さを扱えます。
重要なのは、用語を覚えることより、何を入力として、どの処理を行い、誰にどの結果を返すのかを境界を決めて定義することです。入力と出力の例を用意すると、実装者と利用者の認識をそろえやすくなります。さらに、導入前には、現在の手作業や既存システムで困っている点も記録しておきます。
精度だけを追うと、コストや遅延、監査、例外処理が後回しになります。そのため、目的は一つに絞り、成功条件と対象外の条件を先に決めてください。
また、出力が推定や生成である場合は、結果を事実として扱える範囲を明示します。人が確認する工程、根拠を保存する工程、誤りを訂正する工程を設計に含めることで、試作から本番への移行が安定します。
分散表現が必要になる背景と解決できる課題
従来の方法では、入力形式が少し変わるだけで処理が止まったり、担当者ごとに判断が揺れたりします。
分散表現は、似た用法を持つ対象の距離や方向をモデルに利用させることで、このばらつきを減らす選択肢になります。ただし、曖昧な入力を自動的に正解へ変えるものではありません。
対象業務を分解すると、意味検索や推薦、分類などの用途で適用候補を見つけられます。業務ごとに利用者やデータの機密性を確かめ、処理の頻度と誤りの影響を一覧にします。そのうえで、効果が大きくリスクを管理しやすい範囲から始めます。
人の判断を置き換えるのか、判断材料を増やすのかによって、必要な要件は変わります。判断材料を増やす場合は不確実性や根拠を表示し、判断を置き換える場合は、誤操作を止める承認や権限分離が必要になります。
分散表現の基本的な仕組み
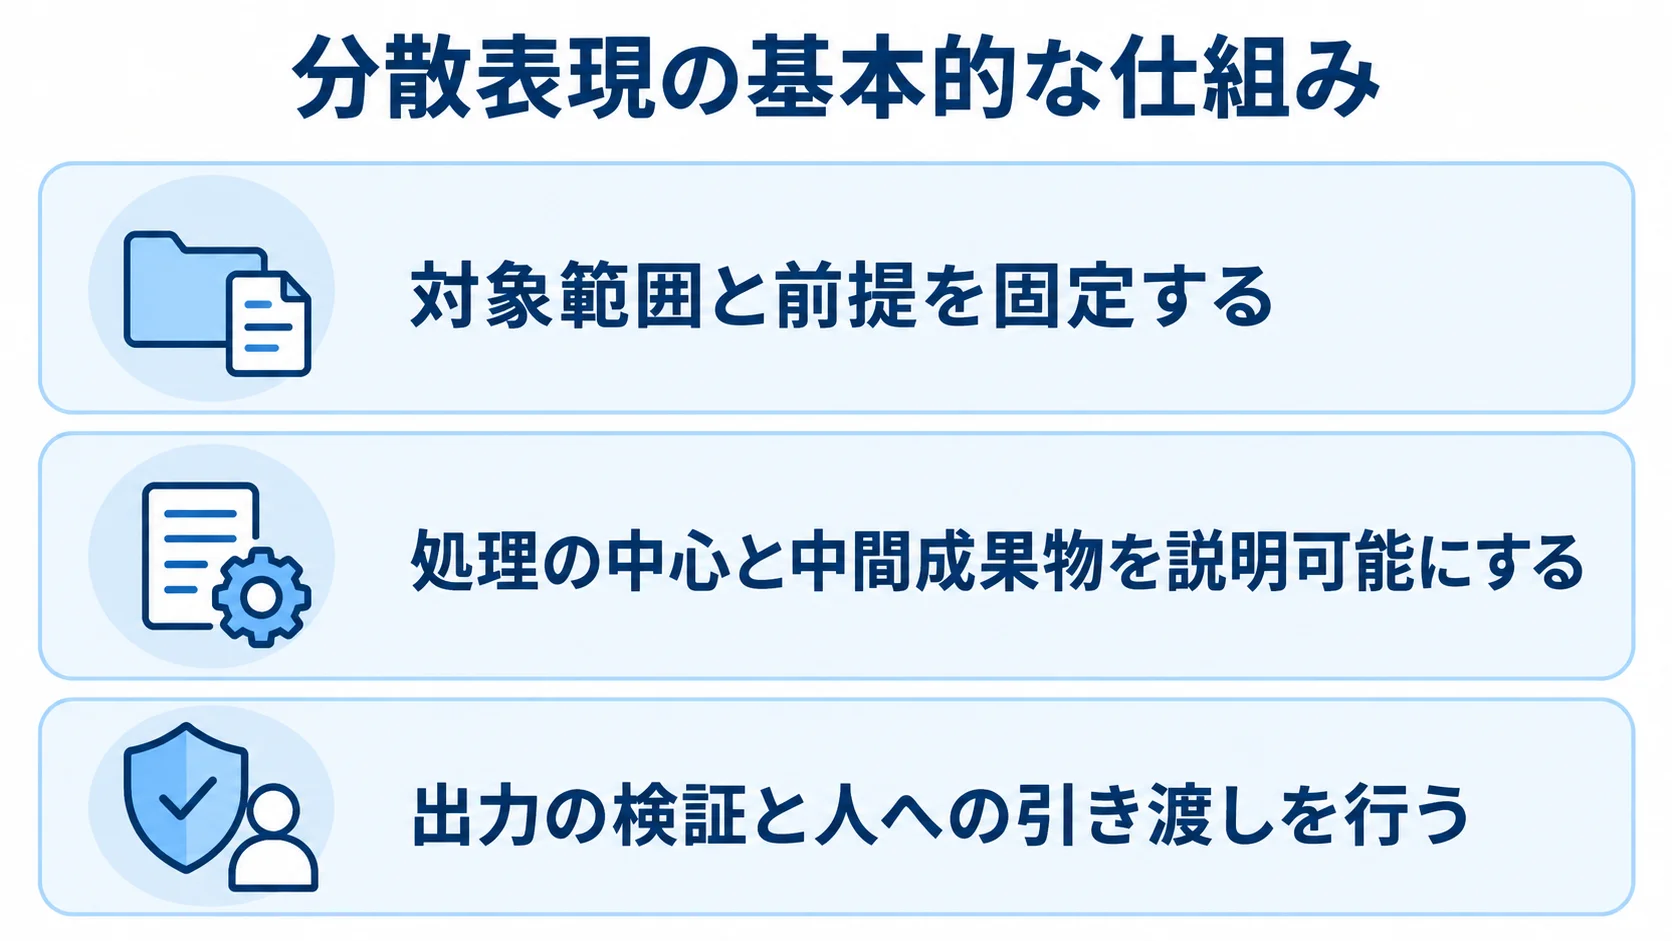
対象範囲と前提の固定
最初に、対象データの単位や期間を決め、形式や欠損、利用できるメタデータも定義しておきます。分散表現では、対象範囲や前処理の違いが結果に直接影響します。そのため、条件とバージョンを記録してください。
入力や観測値が欠けている場合は、欠損の理由と扱いを記録します。除外や補正を行うときは、対象条件を明示したうえで、結果が特定のグループへ偏っていないかを確かめます。
処理の中心と途中結果の説明可能性
共起や文脈、画像とテキストなどの学習信号から埋め込みを獲得し、それを下流のタスクへ入力します。途中の計算結果や抽出項目、判定条件を適切な粒度で保存しておくと、失敗の原因を切り分けやすくなります。
処理を一つのブラックボックスにせず、入力、変換、推論、検証、出力の段階に分けて、入力から出力までの流れを追えるようにします。各段階にタイムアウトと上限を置けば、想定外のループや急激なコスト増を抑えられます。また、データを無期限に保存する前提は置かず、個人情報や秘密のマスキング方針も決めておきます。
出力の検証と人への引き渡し
出力は文字列として表示する前に、スキーマと必須項目を検査し、値の範囲と参照元も確かめます。検査に失敗したときは、補正を無限に繰り返さないよう、再試行の回数を制限して安全なエラーへ切り替えます。
最終利用者が確認すべき箇所を明示し、承認前は外部送信や更新を実行できないようにします。承認者と時刻は監査ログに残します。さらに、入力の識別子や使ったデータ、手順も記録しておくと、後から判断を再現できます。
関連技術との違い|word2vec、GloVe、Transformer、埋め込み、コサイン類似度
分散表現と混同されやすい技術には、word2vecやGloVe、Transformerなどがあります。埋め込みやコサイン類似度も、併せて押さえておきたい用語です。
似ている部分があっても、入力の単位や学習の有無が違い、実行時の責務や評価方法も異なります。そこで比較表を作り、目的と必要データ、更新方法、失敗時の対応を並べると、選びやすくなります。
既存のルールや単純な検索で足りる場合は、複雑な構成を加えないほうが、説明可能性と保守性を保てます。採用を決める前に、小さな基準実装を用意して、同じデータで差を測っておきます。
境界が重なる場合は併用もできますが、責任範囲は分けておきます。たとえば、検索は検索器、生成は生成器、アクセス制御はアプリケーションが担当します。分散表現に安全対策を丸ごと任せないことが大切です。
分散表現を導入する手順
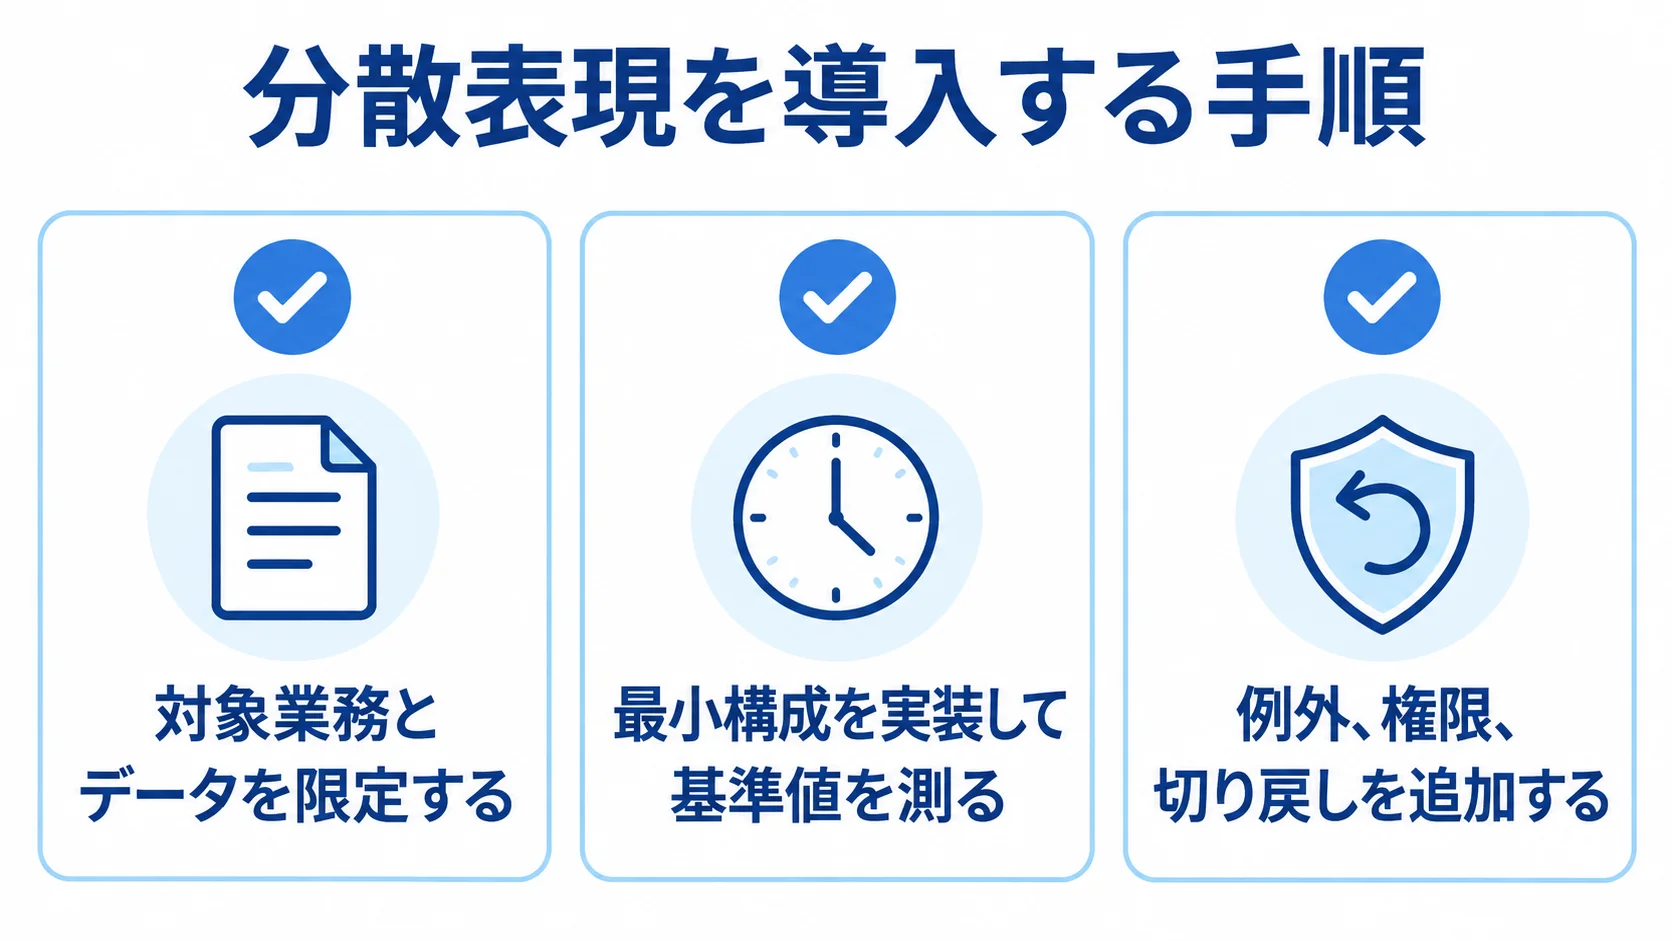
対象業務とデータの限定
最初の検証では、意味検索や推薦、分類などのうち一つを選びます。そのうえで、入力件数と更新頻度、許容できる誤りを定義しておきます。
個人情報や秘密情報を含まない代表データを用意し、本番データをそのまま持ち出さないようにします。データの権利や利用目的を確認し、保存期間と第三者提供の有無も確かめます。評価用データと開発用データは分け、検証結果を見ながらテストデータを何度も調整しない運用にします。
最小構成の実装と基準値の測定
最初から機能を増やさず、入力から出力までの最短経路を実装します。また、実行時間や計算資源、失敗の種類をログに記録し、改善前の基準値を作ります。
出力の正しさを人手で採点する場合は、複数の評価者に同じ基準を渡し、判定の一致度を確かめます。自動指標だけでは、もっともらしい誤りや危険な表現を見逃すことがあるため、人の目による確認も組み合わせます。
例外、権限、切り戻しの追加
距離を意味そのものと誤解しやすい分散表現では、リリース前に正常系以外の動きも確かめます。
- 学習データの偏りと語義の多義性の考慮
- 空入力・古いデータ・外部停止のテスト
- 規定外の出力を止めて人へ渡す
例外が起きたとき、どこまで自動で進めるかは、開発会社と発注側で決めておく必要があります。
権限は最小限にとどめ、読み取りと書き込み、参照と送信を分けます。新しい版は段階的に提供し、データと手順、設定を一緒にバージョン管理しておけば、問題が出たときに前の版へ戻せます。
result = component.run(input_data)
validated = validate_schema(result)
if not validated.ok:
    return request_human_review(validated.errors)
return persist_with_audit_log(validated.value)
上の擬似コードは、処理結果をそのまま使わず、検証と人への引き渡しを挟んだ最小のパターンです。
実際の実装では、入力と出力のスキーマや認証を、対象サービスの公式仕様に合わせます。タイムアウトや再試行、監査ログの設定も、公式仕様を基準に決めます。
便利なライブラリを使う場合は、既定の権限や外部通信の動作も確かめてください。
分散表現の評価方法|品質・安全性・コストの同時測定
品質評価では、類似度評価や検索Recall、下流タスクのF1を用途に合わせて組み合わせます。クラスタ品質とバイアス評価も、対象に応じて加えます。
平均値だけで判断せず、入力の種類や難易度ごとに分けて、特定のグループだけ悪化していないかを確かめます。評価データの作り方と採点基準は、変更履歴を残してください。
安全性は、攻撃的な入力や機密情報の混入を含むテストで確認します。さらに、権限外の要求や誤った外部操作も、同じテストに含めます。
成功例だけを集めると安全性の弱点が見えにくくなるため、失敗した入力を再現テストへ加えます。修正後は、別の機能が壊れていないかを回帰確認します。
コスト評価では、1件あたりの計算量や外部APIの料金を見ます。ストレージや監視、レビューにかかる人の時間も合わせて集計します。品質が少し上がっても、遅延や確認作業が増えて業務全体が悪化するなら、構成を見直します。
分散表現で起こりやすい失敗と対策
代表的な失敗は、学習データの偏りや語義の多義性がベクトルに反映されたまま、距離を意味そのものと誤解してしまうことです。
原因は、機能の限界や入力データ、評価設計、権限や運用のどこにあるかで分けます。そのうえで、どの層で直すかを決めます。データの欠落やアクセス制御の問題は、出力文を工夫しても解消できません。
再現性のない評価や、テストが少なすぎること、開発と採点で同じデータを使うことは避けます。変更前後では同一条件を保ち、モデルやデータの版と乱数を保存します。プロンプトや検索設定も、保存対象に含めます。
利用者への説明を省くと、誤りが見つかっても適切に訂正されにくくなります。自動処理であることや確認が必要な場合を、画面や文書で示します。問い合わせ先とデータの利用目的も記載します。
分散表現を本番運用するチェックポイント
本番では、品質指標に加えて、エラー率や遅延、タイムアウトを監視します。資源使用量や入力分布の変化も見ておきます。閾値を超えたときは、通知するだけでなく、処理を安全側へ切り替えるランブック(手順書)を用意します。
データやモデルを更新するときは、承認者と変更理由を記録します。段階リリースやサンプル監査も行い、影響を確かめます。利用者からの訂正を学習やテンプレート改善に反映する場合は、個人情報や権利の扱いを改めて確認します。
導入を定着させるには、技術担当者だけでなく業務担当者も結果を判断できる手順が必要です。そこで、週次や月次で類似度評価や検索Recallなどを確認し、継続、縮小、停止の基準を発注側と開発会社で合意しておきます。
分散表現まとめ|小さく試し、測れる形で広げる方針
適用候補は、意味検索や推薦、分類です。このほか、クラスタリング、RAGの埋め込み、類似度計算にも使えます。目的やデータの境界が曖昧だと、評価できない結果や予期しないリスクを招きます。
実装では、入力を検証し、処理を段階に分けたうえで、出力をスキーマと業務ルールで確認します。
学習データの偏りや語義の多義性がベクトルに反映され、距離を意味そのものと誤解しやすいという前提に立ち、権限、監査、切り戻しを最初の試作から組み込んでください。
最終的には、類似度評価や検索Recall、下流タスクのF1を定期的に測ります。クラスタ品質とバイアス評価も含め、品質とコスト、安全性のバランスを見ながら改善します。
小さな対象で得た失敗の知見を文書に残してから、データ量や利用者を段階的に増やすと、長く使える仕組みにつながります。
よくある質問(FAQ)
Q. 分散表現とは何ですか?
分散表現は、単語や文書などを多数の数値からなるベクトルで表し、意味や関係を連続空間で扱う表現です。導入では、入力と処理、出力、失敗時の扱いを定義し、用途に合う評価指標で効果を確かめます。
Q. 分散表現は何に使えますか?
代表例は、意味検索や推薦、分類です。このほか、クラスタリング、RAGの埋め込み、類似度計算にも使えます。導入するときは、対象業務で誤りが与える影響やデータの権利、確認工程を整理し、小さな範囲から検証します。
Q. 分散表現を導入するときの注意点は何ですか?
学習データの偏りや語義の多義性がベクトルに反映され、距離を意味そのものと誤解しやすい点に注意が必要です。入力検証や最小権限、出力チェックを設けます。加えて、監査ログと切り戻しを用意し、失敗例を回帰テストへ追加します。
Q. 分散表現の効果はどの指標で評価しますか?
類似度評価や検索Recall、下流タスクのF1などに加え、クラスタ品質やバイアス評価も、用途に合わせて測ります。平均値だけでなく、難易度や利用者層別の結果も示します。遅延やコスト、安全性も併記します。
Q. 分散表現と関連技術はどう使い分けますか?
関連技術には、word2vecやGloVe、Transformerなどがあり、埋め込みやコサイン類似度も含まれます。比べるときは、目的と必要データ、更新頻度を並べ、権限や失敗時の責任範囲も確かめます。そのうえで、最小構成で差を測ってから選びます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響を確認したい方は、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をご覧ください。
参考資料
分散表現の仕組みと実装を確認するための資料です。
- TensorFlow「Word embeddings」・Stanford CS224N
公式資料 - 各サービス・ライブラリの公式ドキュメント(利用時点の仕様と料金を確認)
- 一次資料の更新履歴とセキュリティ告知(導入前に最新版を確認)
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。