
Docker Swarmのシステム開発は、要件整理から定着まで6つのフェーズを順に進めます。業務要件に合う基盤を運用するには、この順序で各段階の完了条件をそろえることが大切です。
システムの全体像は、完全ガイドで詳しく扱っています。
▼全体ガイドの記事
・Docker Swarmのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Docker Swarmのシステムの全体像
Docker Swarmのシステムは、Docker EngineのSwarm modeで、複数のサーバー上のコンテナサービスを運用する構成です。その上に、Web、API、バッチなどのサービスを配置します。キューなども、同じように配置します。
Docker公式は、追加ソフトウェアなしでCLIからクラスタを管理できる機能と説明しています(出典: Docker Docs「Swarm mode」、2026年8月確認)。
managerとworkerの役割分担
managerはクラスタの状態やサービスの配置を管理し、workerはコンテナを実行します。managerは望ましい状態を保持し、実際との差を埋めるようにサービスを再配置します。
replica数、配置先、CPUやメモリの上限も、managerが管理します。本番のmanagerは、障害時でも管理情報を保つため、3台または5台の奇数構成が候補になります。
ただし、managerを増やしても、DBが冗長化されるとは限りません。managerのquorumと、DBやアップロードファイルのバックアップ・復元の設計は、それぞれ別に確認します。
業務システムの基盤とデータの分け方
業務システムは、managerとworkerだけでは構成できません。そこで、基盤とデータに関わる要素をあわせて設計します。
- 基盤:private registry、ロードバランサー、リバースプロキシ、overlay network
- データ:データベース、永続ストレージ、バックアップ
- 運用:CI/CD、監視、ログ管理
statelessなWebやAPIは複数のreplicaへ分散しやすい一方、DB、セッション、ファイル、ジョブの状態は別途保護が必要です。DBコンテナを増やしても、整合性やフェイルオーバーは実現しません。そのため、マネージドDBやDB専用ノードも比較します。
Docker Swarmのシステム開発の6フェーズ
先にサーバーを作ってから業務要件を当てはめると、開発は失敗しやすくなります。そのため、要件整理から定着までを、業務の目的と基盤の設定を結び付けながら進めます。
各フェーズの完了条件を文書に残しておくと、見積もり範囲の認識違いを抑えられます。
フェーズ1:要件整理と業務要件・非機能要件の決定
最初に、利用者、業務、既存システムとの連携データを整理します。あわせて、利用時間帯とピーク時の同時アクセス数も確認します。
次に、許容停止時間と、障害からの目標復旧時間であるRTO、戻せるデータ時点を示すRPOを定めます。監査ログの保存期間と個人情報の範囲も、この段階で決めます。
要件整理では、次の項目をチェックリストにして確認します。
- 環境と通信:本番・ステージング・開発の数、外部公開ポート
- ノードとサービス:manager・workerの想定台数、サービスごとのreplica数
- データ:DB・ファイル・セッションの保存先
- 復旧と運用:バックアップ頻度と復元目標、夜間・休日の障害対応者
- 納品物:設計書・設定ファイル・ソースコード
非機能要件が曖昧だと、後から監視や性能、冗長化を加えることになり、そのぶん費用と期間が膨らみます。
フェーズ2:選定でSwarmを採用する範囲の見極め
必要な運用機能とチーム体制を基準に、SwarmとKubernetesのどちらを使うかを選びます。
- Swarmが候補:Compose環境から少人数でWeb/APIを複数台へ展開したい場合
- Swarmが候補:宣言的なサービス管理、ローリング更新、簡潔な運用を重視する場合
- Kubernetesも比較:複雑なマルチテナント制御、周辺製品、組織内標準化、大規模自動化を求める場合
Docker Docsは、managerが望ましい状態を監視し、障害で減ったreplicaを再配置すると説明しています(出典: Docker Docs「Swarm mode」、2026年8月確認)。
Swarmの方が簡単そうに見えても、3年後に保守できる人材と障害対応者がいるかを確認して決めます。さらに、将来Kubernetesへ移る場合にアプリを再利用できるかも検討します。
フェーズ3:再配置されても壊れない設計・開発
アプリ、ネットワーク、データの設計を分けて、再配置後もサービスを維持できる構成にします。
- アプリ配備:Dockerfileでイメージ化し、Composeとstack deployで環境別に配備する
- 通信設計:LB、DNS、TLS、firewall、ノード間通信を整理する
- データ設計:DBの配置、復元時間、セッションやファイルの保存先を決める
イメージタグは、latestだけに頼らず、コミットIDやリリース番号で固定します。あわせて、registryからの取得、healthcheck、サービスごとのCPU・メモリの上限(resource limit)を確認します。
routing meshでは、どのノードの公開ポートで受けても、稼働中のタスクへ転送できます。
service discoveryには7946番のTCP/UDP、ingress networkには4789番のUDPなどが必要です(出典: Docker Docs「Use Swarm mode routing mesh」、2026年8月確認)。公開範囲は広げすぎず、必要な送信元と宛先だけを許可します。
host bind mountを使うと、タスクが別ノードへ移ったときに同じデータを読めないことがあります。そこで、共有ストレージ、マネージドDB、DB専用ノードを比較します。
セッションを共有ストアに置き、ファイルをオブジェクトストレージなどに分けておくと、Webを複数replicaへ展開できる状態になります。
フェーズ4:テストでの更新・障害・復元の確認
画面表示の確認だけでなく、単体・結合テストと障害時の復旧も確認します。たとえば、ノード停止やコンテナの異常終了を再現します。
- 基盤障害:ノード停止、registry停止、overlay network分断、manager一時停止、ディスク不足
- アプリ障害:DB接続エラー、処理中の注文やバッチの二重実行
受入条件は数値で定めます。具体的には、指定replica数を維持できるか、ローリング更新中の許容停止時間を守れるかを確認します。さらに、失敗リリースを前版へ戻せること、RPO内で復元できること、監視通知が届くことも確かめます。
負荷試験では、平均値だけでなくピーク時の応答時間も見ます。CPU・メモリ使用率やログ量も、あわせて記録します。
フェーズ5:稼働での切り替え手順と監視の運用移行
本番稼働では、切り替えと監視の担当者や確認事項を、運用手順にまとめます。
- 切り替え準備:日時、担当、確認項目、戻し方、連絡先をランブックに記載する
- 移行と利用者対応:差分取り込み、停止時間、DNS・ロードバランサー切り替え、旧環境の維持期間を決める
- 監視と通知:サービスや基盤を監視し、担当者・対応期限・手順をアラートに紐付ける
利用者に影響が出る場合は、業務シナリオを確認するとともに、切り替え直後の問い合わせ窓口も用意します。
監視では、ノードの死活に加えて、replica数や再起動、CPU・メモリ・ディスクを見ます。証明書、registry、DBなども監視の対象に入れます。バックアップ、キュー、外形監視も、あわせて設定します。
アラートには、誰が何分以内にどの手順で対応するかを紐付けます。なお、通知は増やしすぎないように絞ります。
フェーズ6:定着での手順・教育・改善の継続
稼働後は、開発担当者だけが操作する状態を避け、設定や復旧に必要な手順を運用ドキュメントへ残します。
- 構成と秘密情報:stack定義、Dockerfile、環境変数一覧、Secrets更新
- 保守と復旧:証明書更新、バックアップ復元、ノード追加・交換、rollback、障害時の連絡
ソースコードに加えて、Infrastructure as Codeや監視設定も納品対象にします。そのため、担当者が替わっても引き継げる状態になります。
月次では、脆弱性のあるイメージやDocker Engineを確認します。あわせて証明書とバックアップ容量を確かめ、ログ量やコストも見ます。
四半期ごとに、復元テストや障害訓練を行い、RTOを満たせるかを測定します。
運用を外部委託する場合は、一次・二次対応の分担と、平日・休日の受付時間を契約に明記します。作業承認と月次レポートの内容も、あわせて決めておきます。
Docker Swarmのシステム開発の費用相場とコストの内訳
Docker SwarmはDocker Engineの機能として使えるため、ライセンス費用だけを見ると低コストに見えます。
一方で、業務システムでは要件定義からコンテナ化、移行、監視まで、多くの作業が費用になります。認証やネットワークの作業も、費用に入ります。さらに、バックアップや障害訓練、保守も費用に含まれます。
以下の金額は、リサーチノートに基づく工数の推定レンジです。公定価格ではありません。要件や既存資産によって、金額は大きく変わります。SLAやデータ量も、金額を左右します。
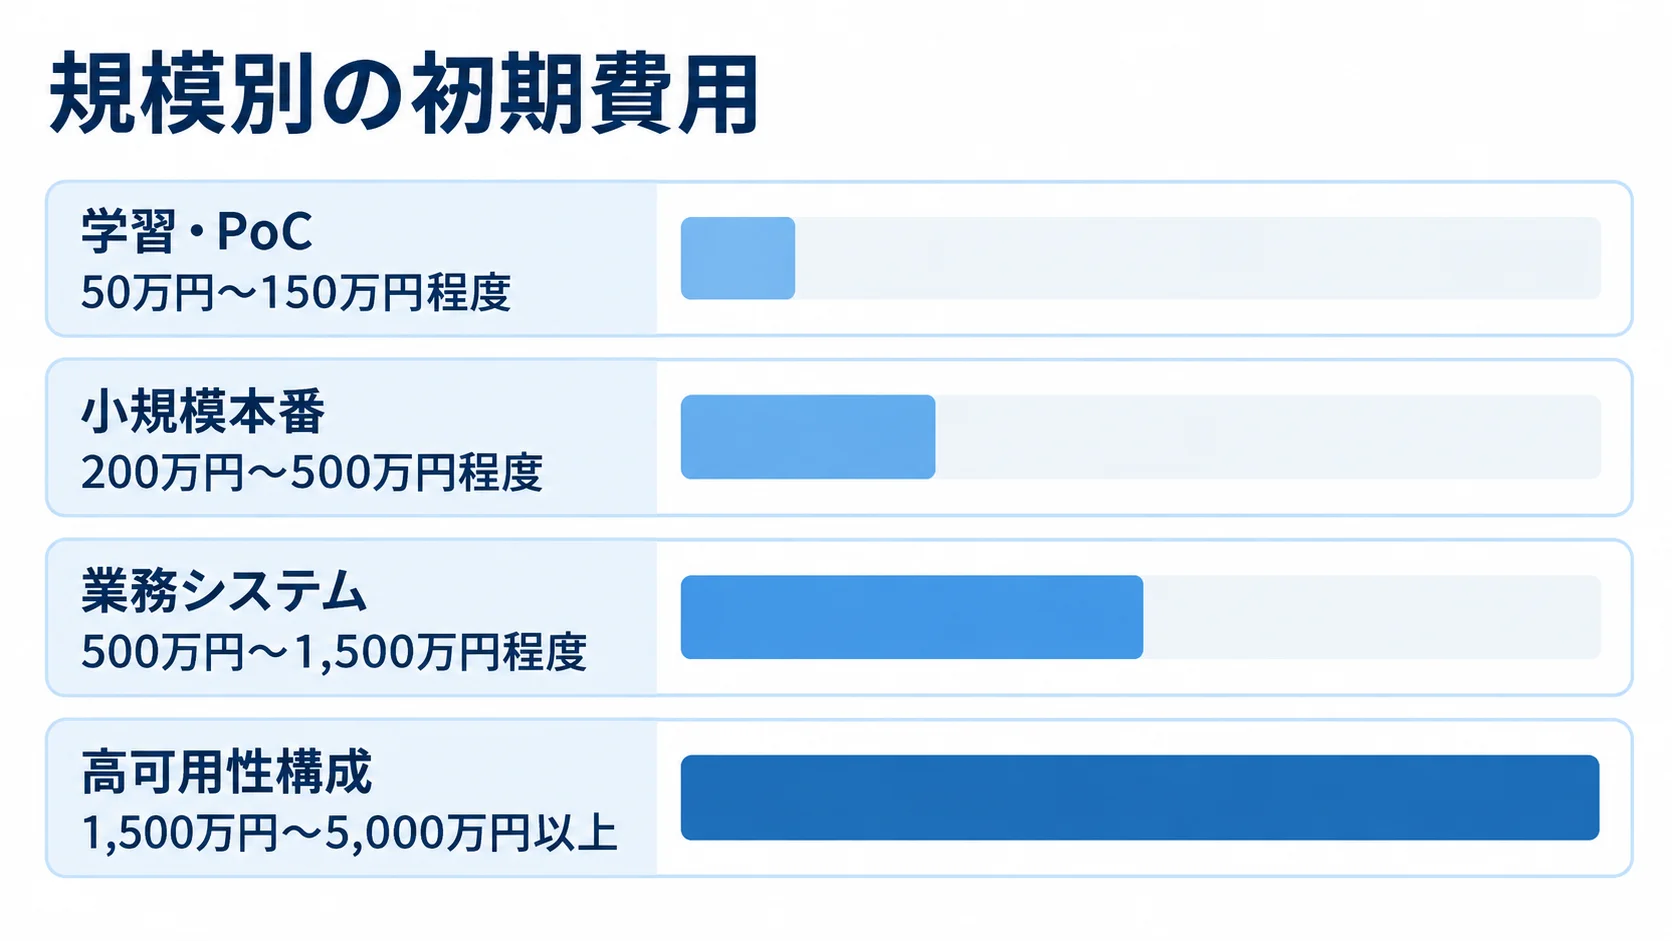
規模別の初期費用の目安(50万円から5,000万円以上)
初期費用は、環境の規模と対象作業によって変わります。ここに示す各金額は、見積もりを始めるための概算です。
- 学習・PoC:1〜2台の非本番環境でCompose移植、イメージ化、基本設定、簡易デプロイを行う場合は50万円〜150万円程度
- 小規模本番:3〜5台でregistry、TLS、CI/CD、監視、バックアップ、リリース手順まで含む場合は200万円〜500万円程度
- 業務システム:認証、DB、バッチ、外部連携、移行、権限、障害試験、教育を含む場合は500万円〜1,500万円程度となるケース
- 高可用性構成:環境分離、災害対策、監査ログ、負荷試験、24時間運用設計まで必要な場合は1,500万円〜5,000万円以上となる場合
これらは公開された標準価格ではありません。要件や既存資産を確認したうえで、個別に見積もります。
クラウド料金のサーバー代と運用費の分け方
クラウド料金は、サーバー費用と、周辺サービスや運用の費用を分けて試算します。
- サーバー条件:manager・workerの台数、CPU・メモリ、ディスク、転送量
- 周辺費用:ロードバランサー、registry、監視、ログ、バックアップ
AWS LightsailのLinux/Unixは、0.5GBが月額5米ドル、2GBが12米ドル、4GBが24米ドル、8GBが44米ドルです(出典: AWS「Lightsail instance bundles」、2026年8月確認)。
5台を2GB相当でそろえると、インスタンスだけで月額60米ドルです。3台のmanagerと2台のworkerを4GB相当とする例では、月額120米ドルになります。
後者はサーバー部分だけを見た机上の例です。バックアップ保存やスナップショット、ロードバランサーは、別途かかります。監視やログ・データ転送の費用も、別に見込む必要があります。外部DBや商用サポート、運用作業費も、別途必要になります。
米ドルを円に換算すると、為替の動きで金額が変わります。そのため、提案書には確認日と通貨を書き、月額インフラ費と初期構築費を分けて示します。
保守費の目安(初期費用の15〜20%)
保守費は、作業範囲と対応時間を踏まえて見積もります。あわせて、契約の対象範囲を明確にします。
- 年間費用の目安:初期開発費の15〜20%程度。初期構築500万円なら年間75万円〜100万円程度(出典: 社内一次Q&A「業務システム全般_12」、2026年)
- 保守作業:Docker Engine・イメージ・証明書の更新、脆弱性対応、監視、バックアップ確認、問い合わせ
- 手厚い対応:24時間365日監視、即時駆け付け、複数環境の更新、緊急対応、復元訓練は時間と作業量で見積もる
無料で使える機能があっても、運用品質を保つための費用がかからないわけではありません。年間契約では、対象作業と対象外の作業、追加作業の単価を明確にします。
Docker Swarmのシステム開発で見積もりを取る際のポイント
監視や復元試験が別料金かどうかは、見積もりの内訳を見て確かめる必要があります。そこで、RFPには環境数やノード構成、SLAを記載します。
RTO・RPOやデータ分類、移行量も含めます。運用時間と納品物も、あわせて記載します。
初期費用とクラウド費用、保守費は、それぞれ分けて提示してもらいます。追加変更費も、別の項目にしてもらいます。
要件と責任分界の見積書への記載
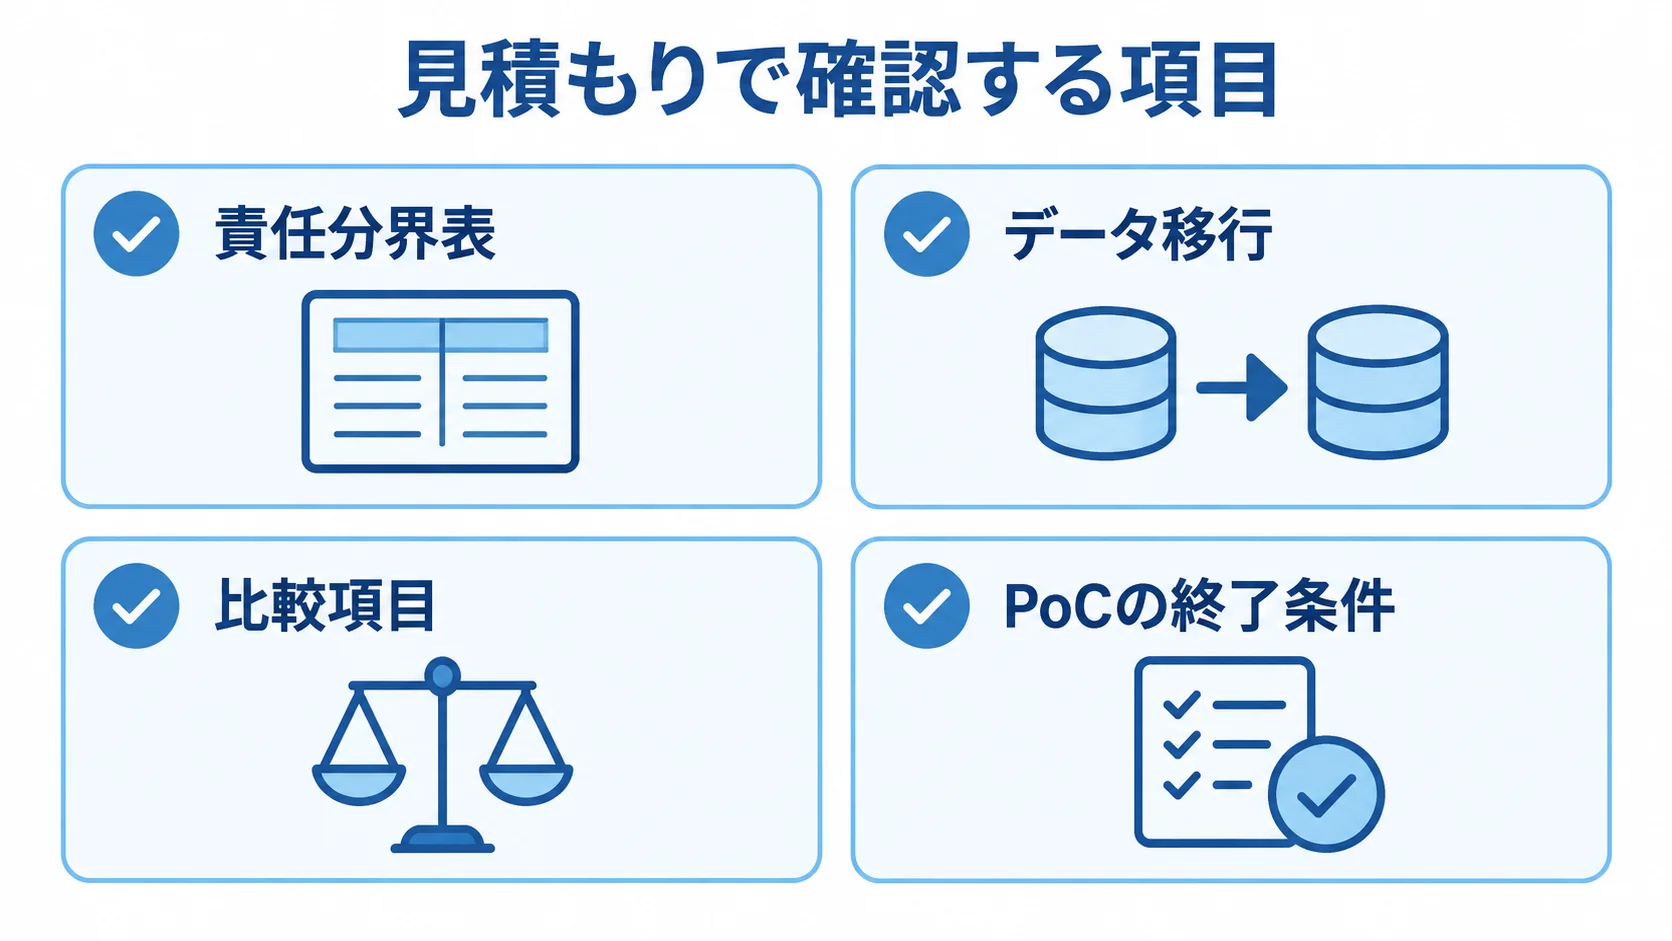
見積もりでは、開発会社と発注者のどこまでを誰が担当するかを明記します。そのうえで、アプリ側と基盤側の作業を分けて整理します。
- アプリ側:業務要件、画面、API、バッチ、外部連携
- 基盤側:Dockerfile、stack定義、registry、ノード、ネットワーク、TLS、監視、バックアップ、復元試験
発注者がDBを用意する場合は、責任分界表に接続情報と性能を書き込みます。バックアップや障害時の窓口も、同じ表で決めておきます。
データ移行では、発注者の確認作業も定義します。抽出と変換、クレンジングは前段の作業として分けます。件数照合と差分移行は、その次の段階として分けます。リハーサルと切替当日の移行も、別に定義します。
個人情報を扱う場合は、アクセス権や操作ログ、委託先管理を検討します。国外での取扱いや、漏えい時の報告と通知も、あわせて検討します。これらは、技術要件と契約条件の両方に反映します。
会社選定での確認事項(Swarmの知識と業務システムの経験)
会社選定では、Swarmの操作に加えて、業務システムの開発と運用をまとめて説明できるかを確認します。
- 対応力:要件定義、アプリ、インフラ、セキュリティ、移行、監視、障害訓練
- 障害・移行への備え:manager quorum喪失、DB復元失敗、脆弱性発見、Kubernetes移行への方針
- 比較項目:担当者のSwarm運用経験、類似実績、保守時間、障害体制、IaC納品、権利、引き継ぎやすさ
Portainerは、15,000人規模の企業がコンテナ環境の管理を課題としていた事例を紹介しています(出典: Portainer「Global Energy Company」ケーススタディ、2026年8月確認)。
個別の事例を、そのまま一般化せず、自社の体制に置き換えて評価します。
安さだけでなく後から増えやすいリスクの比較
安価な提案を受けた場合は、費用に含まれる作業とPoCの終了条件を確かめます。そのうえで、後から増える費用を見積もります。
- 含まれる作業:要件定義、性能試験、監視、バックアップ、脆弱性対応、文書、教育
- 見積もりの明細:「本番クラスタ構築一式」ではなく、作業ごとの人日・単価・環境数・前提・除外条件を確認
- PoCの終了条件:statelessサービスでデプロイ、更新、rollback、ノード停止、監視、復元を試す
「一式」と書かれた見積もりでは、ノード追加や証明書更新、registry障害、DB復元の費用を確かめにくくなります。ログ保存や休日対応の費用も、見えにくくなります。
PoCの目的と終了条件を定めておかないと、検証が長引きがちです。そのため、本番移行、中止、Kubernetes移行の条件を、開始前に関係者で合意します。
Docker Swarmのシステム開発でよくある質問
業務で使う場合は、技術コマンドよりも、自社の要件と運用を続けられるかで判断します。導入前によくある質問を、判断軸とあわせて見ていきます。
Docker SwarmとKubernetesはどちらを選べばよいですか?
小〜中規模のWeb/APIや社内業務で、Dockerとの連続性、分かりやすい設定、少人数での運用を重視するならSwarmが候補です。
複雑なポリシー制御やマルチテナントを優先する場合は、Kubernetesも比較します。豊富なエコシステムや組織標準化を重視する場合も、Kubernetesを比べます。そのうえで、3年分の人材・保守・移行費用で判断します。
データベースをDocker Swarmで複数台にすれば冗長化できますか?
冗長化できるとは限りません。複数台の構成には、レプリケーションや整合性、フェイルオーバーの仕組みが必要です。バックアップや復元、書き込み先の制御も、あわせて求められます。
replica数を増やすことは、DBの冗長化とは別の話です。そのため、マネージドDB、DB専用ノード、正式なクラスタ構成を比較し、RTO・RPOとデータ量に合う方式を選びます。
パスワードや個人情報をコンテナへ安全に渡せますか?
パスワードやTLS鍵、SSH鍵は、Dockerfileやソースコードへ埋め込まず、Docker Secretsなどを使って必要なサービスだけに渡します。
Docker Docsによると、Secretsは転送中と保存時に暗号化され、実行中のサービスへメモリ上のファイルとしてマウントされます(出典: Docker Docs「Manage sensitive data with Docker secrets」、2026年8月確認)。
個人情報保護法への対応は、Secretsの利用に加えて、権限やログの設計まで含めて進めます。委託先の管理、バックアップ、漏えい対応も、あわせて設計します。
Docker Swarmは2026年時点でも本番採用できますか?
採用の可否は、製品の将来性に加えて、自社の要件と保守体制で判断します。Docker資産を活かして少人数でWeb/APIを運用するなら、本番の候補になり得ます。
PoCでは、更新、障害、復元を確認します。候補の会社が現行版を保守できない場合や、必要な監視・バックアップ製品がない場合は、別案も検討します。
将来の移行計画を説明できない場合も、Kubernetesやマネージドサービスを含めて再検討します。
Docker Swarmのシステム開発の進め方まとめ
Docker Swarm開発は、コンテナを複数台で動かすことだけでなく、業務要件と運用を基盤へ落とし込む取り組みです。
要件整理では、RTO・RPOや停止時間を決め、データ分類と監査要件も整理します。選定では、Swarm、Kubernetes、マネージドサービスを比べます。そのうえで、設計ではstatelessなサービスとデータを分けます。
発注前の6フェーズの完了条件の確認
発注前には、6フェーズの完了条件を成果物で確かめます。資料は、要件と選定、設計とテスト、運用の3つに分けて集めます。
- 要件と選定:要件整理の成果物、採用理由、比較案
- 設計とテスト:クラスタ・ネットワーク・データ設計、テスト計画
- 運用:切り替え・rollback手順、監視・バックアップ運用書
見積もりは、初期開発費とクラウド・外部サービスの月額費を分けて見ます。保守費や追加変更費、発注者側の協力作業も、別に示してもらいます。そろった資料があれば、将来の運用負担まで比べられます。
小さなPoCで復旧まで確認してから本番へ進む流れ
全社業務を一度に移さず、影響を限定したサービスでPoCを行い、復旧まで確認してから本番へ進みます。
- デプロイ、ローリング更新、rollback、ノード障害、秘密情報の更新、バックアップ復元を確認します。
- 結果をもとに本番ノード数、監視、保守体制、Kubernetesとの比較を見直します。
- 採用に迷う場合は開発会社へ相談し、管理できる成果物と体制も含めて提案を比べます。
▼全体ガイドの記事
・Docker Swarmのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。