
ドメイン適応は、学習データ(ソースドメイン)と予測対象データ(ターゲットドメイン)の分布が違うときに、モデルをターゲット側へ適応させる方法です。
カメラや顧客、地域などが変わって性能が下がる問題に対応します。ターゲット側のラベルの有無で、使う方法が変わります。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
ドメイン適応によるデータ分布のずれの縮小
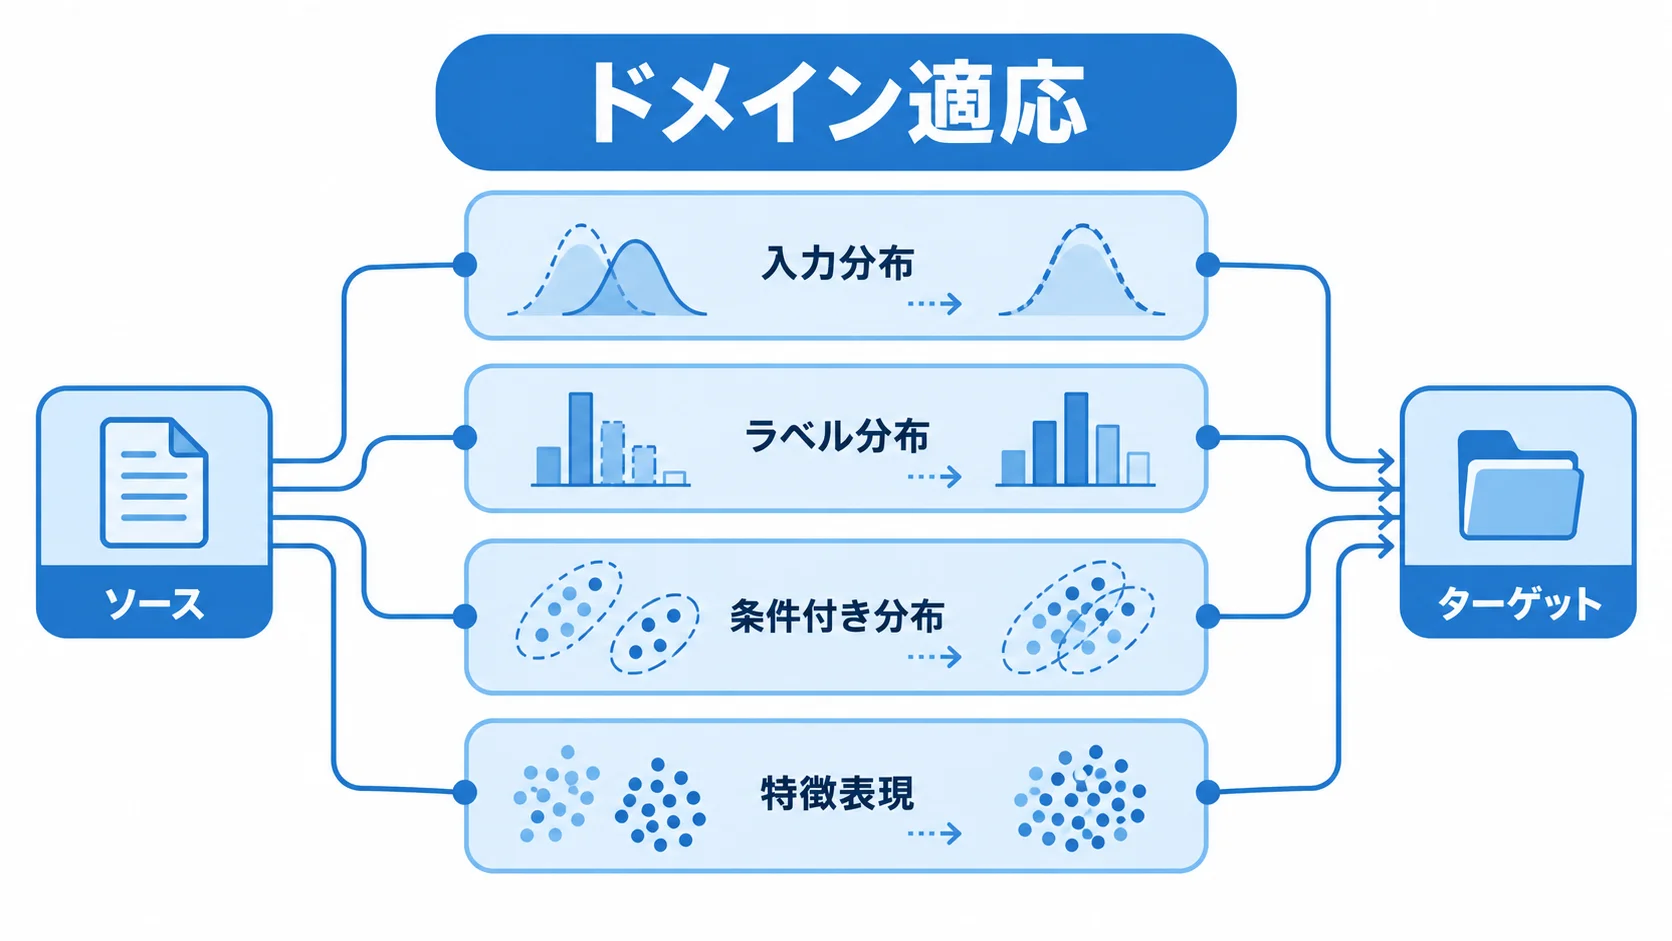
ソースとターゲットで入力分布、ラベル分布、条件付き分布が違うと、同じモデルでも予測が不安定になります。その対策には、特徴表現を近づける方法や、ターゲットのラベルで微調整する方法があります。ほかにも、疑似ラベルを使う方法や、ドメイン識別器で差を減らす方法などがあります。
教師ありと教師なしの使い分け
ターゲットにもラベルがある場合は、ソースとターゲットのラベル付きデータを使って共同で学習します。一方で、ターゲットが未ラベルのときは、特徴の整合や疑似ラベルを使います。ほかに、データ変換や自己教師あり事前学習なども用います。
たとえば、KerasのAdaMatchの例では、ソースのラベル付きデータとターゲットのラベルなしデータを使う、教師なしドメイン適応を扱っています。
転移学習の中でのドメイン適応の設計
転移学習は、既存モデルの表現を新しいタスクへ再利用する広い考え方です。一方で、ドメイン適応は、タスクが同じでもデータの環境や分布が変わる場面に焦点を当てます。
たとえば、TensorFlowのチュートリアルでは、事前学習済みモデルを固定して特徴抽出する方法と、上位層を微調整する方法を紹介しています。
全層をすぐに更新すると、ソースで学んだ一般的な特徴を壊したり、ターゲットの少量データへ過学習したりします。そのため、まず分類ヘッドだけを学習し、必要に応じて上位層を少しずつ解凍します。
ドメイン適応の前に行う分布差の測定
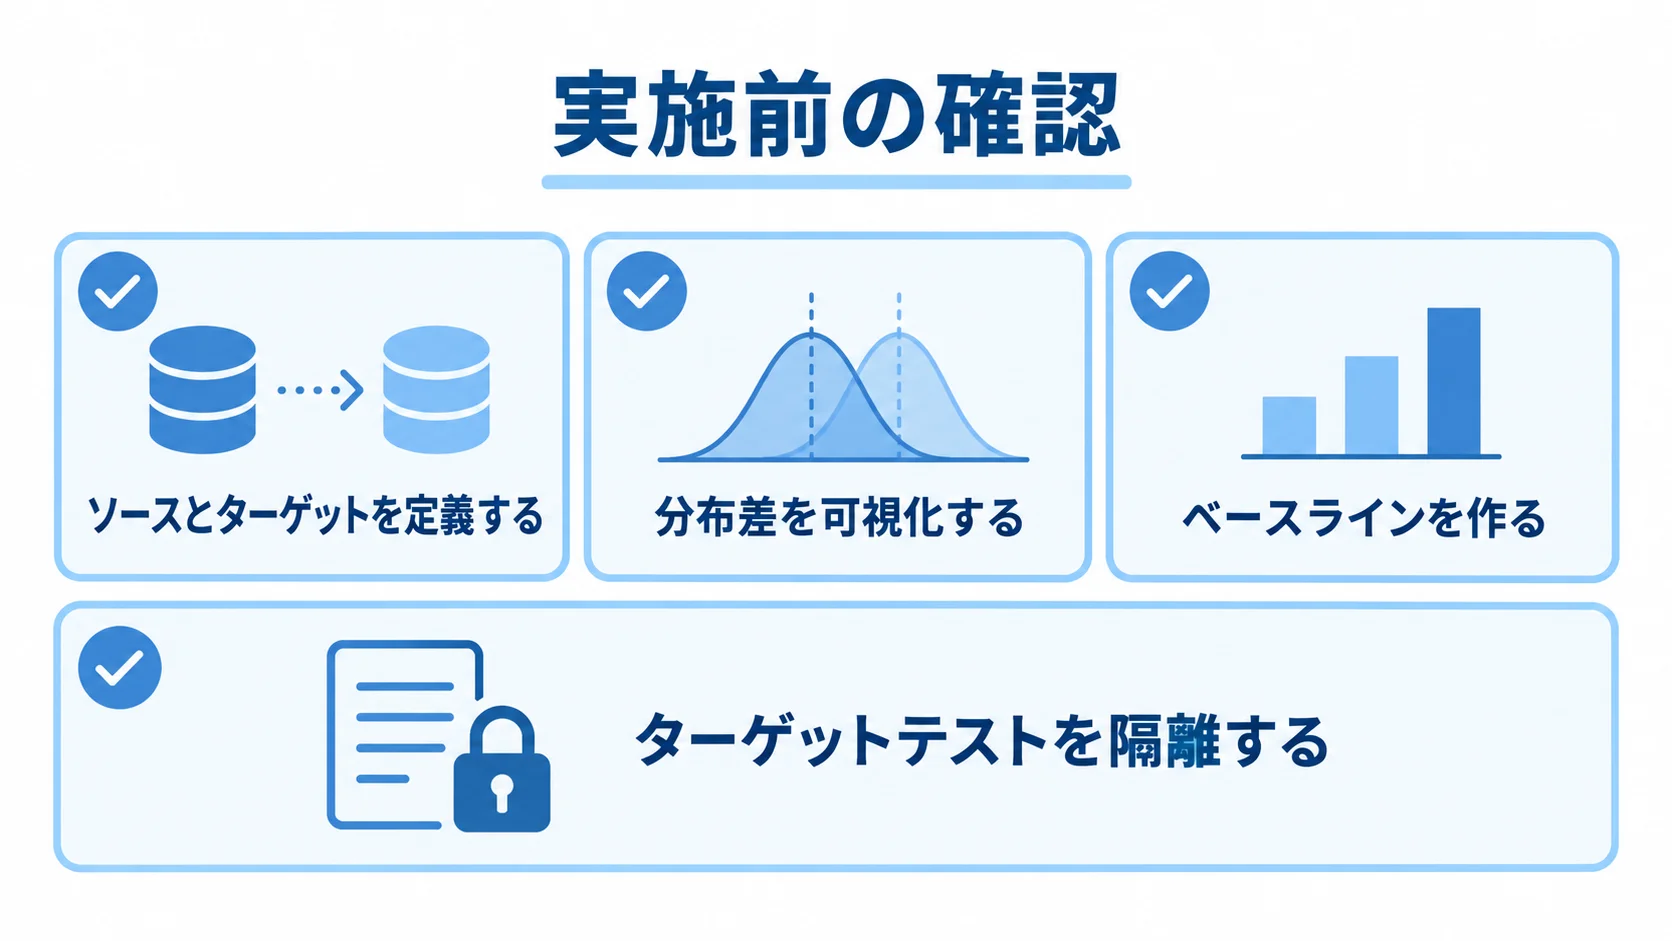
ドメイン適応を始める前に、確認事項を観点ごとに整理します。ソースとターゲットを定義する、分布差を確かめる、ベースラインを作るの3つを押さえたうえで、適応方法を選び、ターゲットテストを隔離します。
- ソースとターゲットを定義する:地域、顧客、装置、期間、ラベルの有無を一覧にする。
- 分布差を確かめる:特徴、クラス比率、欠損、画質、語彙の違いを見比べる。
- ベースラインを作る:ソースのみの学習、ターゲットの少量データによる微調整、ルールを基準として用意する。
- 適応方法を選ぶ:正規化、再重み付け、特徴整合、疑似ラベルから候補を比べて決める。
- ターゲットテストを隔離する:しきい値の調整やモデル選択に使わない。
適応前後と未知ドメインでの評価
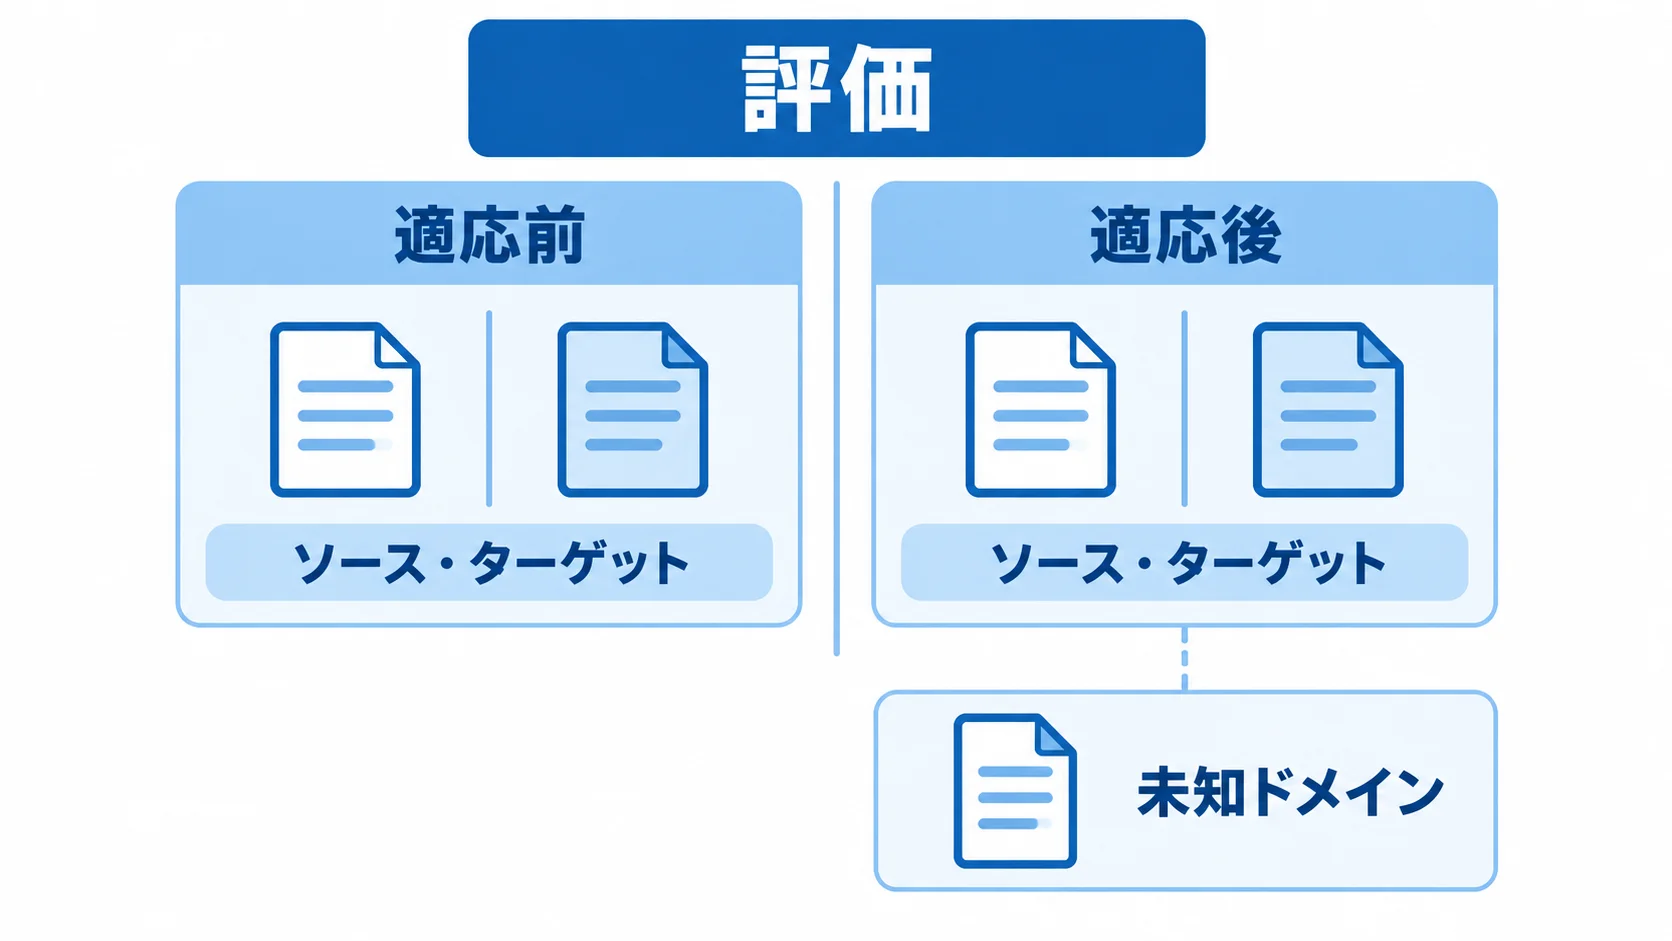
ソースとターゲットのそれぞれについて、精度、再現率、校正、クラス別性能を比べます。ただし、適応後にターゲットだけが改善し、ソースや別のターゲットで大きく悪化することもあります。
さらに、複数の顧客・期間・装置ごとに分けた外部ドメインの評価も行います。
ドメイン適応で起きやすい失敗と対策
誤った疑似ラベルの増加
疑似ラベルの誤りは次の学習へ引き継がれて連鎖します。そのため、信頼度のしきい値や教師モデル、少量の人手確認を使い、誤りが広がるのを抑えます。
ソースの性能の忘却
ターゲットに合わせて更新しすぎると、ソースで学んだ性能が失われます。そこで、ソースとターゲットの指標を並べて見ながら、微調整の範囲と学習率を調整します。
テストドメインを使った方法の選択
テストドメインで方法を選ぶと、評価が甘くなり、テスト漏えいにつながります。そのため、検証ドメインを別に置き、最終テストは一度だけ評価します。
ドメイン適応による環境変化への対応
ドメイン適応は、ソースとターゲットの分布差を抑えて、同じタスクを新しい環境でも使えるようにする方法です。実施では、教師ありか教師なしかに応じて、特徴整合、疑似ラベル、微調整を使い分けます。
導入する前に、分布差を測り、適応前後と未知ドメインの性能を確認します。そのうえで、誤ったラベル、ソースの性能の忘却、テスト漏えいが起きていないかも確かめます。
よくある質問(FAQ)
ドメイン適応によくある疑問に、順に答えます。
Q. ドメイン適応とは何ですか?
学習データと予測対象データの分布が異なるとき、モデルを対象側へ適応させる方法です。
Q. 転移学習との違いは何ですか?
転移学習は既存表現の再利用全般を指し、ドメイン適応は同じタスクで環境やデータ分布が変わる問題に焦点を当てます。
Q. ターゲットのラベルがなくても使えますか?
使えます。特徴整合、疑似ラベル、データ変換、自己教師あり学習などを比較します。
Q. 効果はどう評価しますか?
適応前後のソース・ターゲット性能、クラス別指標、未知ドメインの頑健性を比較します。
Q. 疑似ラベルの誤りは問題になりますか?
なります。信頼度しきい値や人手確認を使い、誤りが次の学習へ連鎖しないようにします。
参考資料
本文の転移学習の進め方とAdaMatchの例は、次の資料で確認できます。
- TensorFlow「Transfer learning and fine-tuning」
- Keras「Semi-supervision and domain adaptation with AdaMatch」
- TensorFlow Blog「On-device model personalization」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。