
Elasticsearchのシステムは、Web・EC検索、社内文書検索、ログ分析に分けて押さえると、検索時間の短縮や問い合わせ削減に役立ちます。
用途、構成と設計、開発の進め方、費用相場の順に、発注前に押さえる内容をまとめました。詳細は関連記事でも確認できます。
▼関連記事一覧
・Elasticsearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Elasticsearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Elasticsearchのシステム開発の見積相場や費用/コスト/値段について
・Elasticsearchのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Elasticsearchのシステムの概要
Elasticsearchは、Apache Luceneを基盤にした分散型の検索・分析エンジンです。データと処理を複数のサーバーに分散させるため、大量の文書やイベントを扱えます。
キーワード検索や条件による絞り込みに加えて、集計や関連度順の表示も組み合わせられます。さらに、ベクトル検索やハイブリッド検索にも対応しており、全文検索とAI検索を同じ基盤で扱う構成も増えています。
業務データベースと検索インデックスの違い
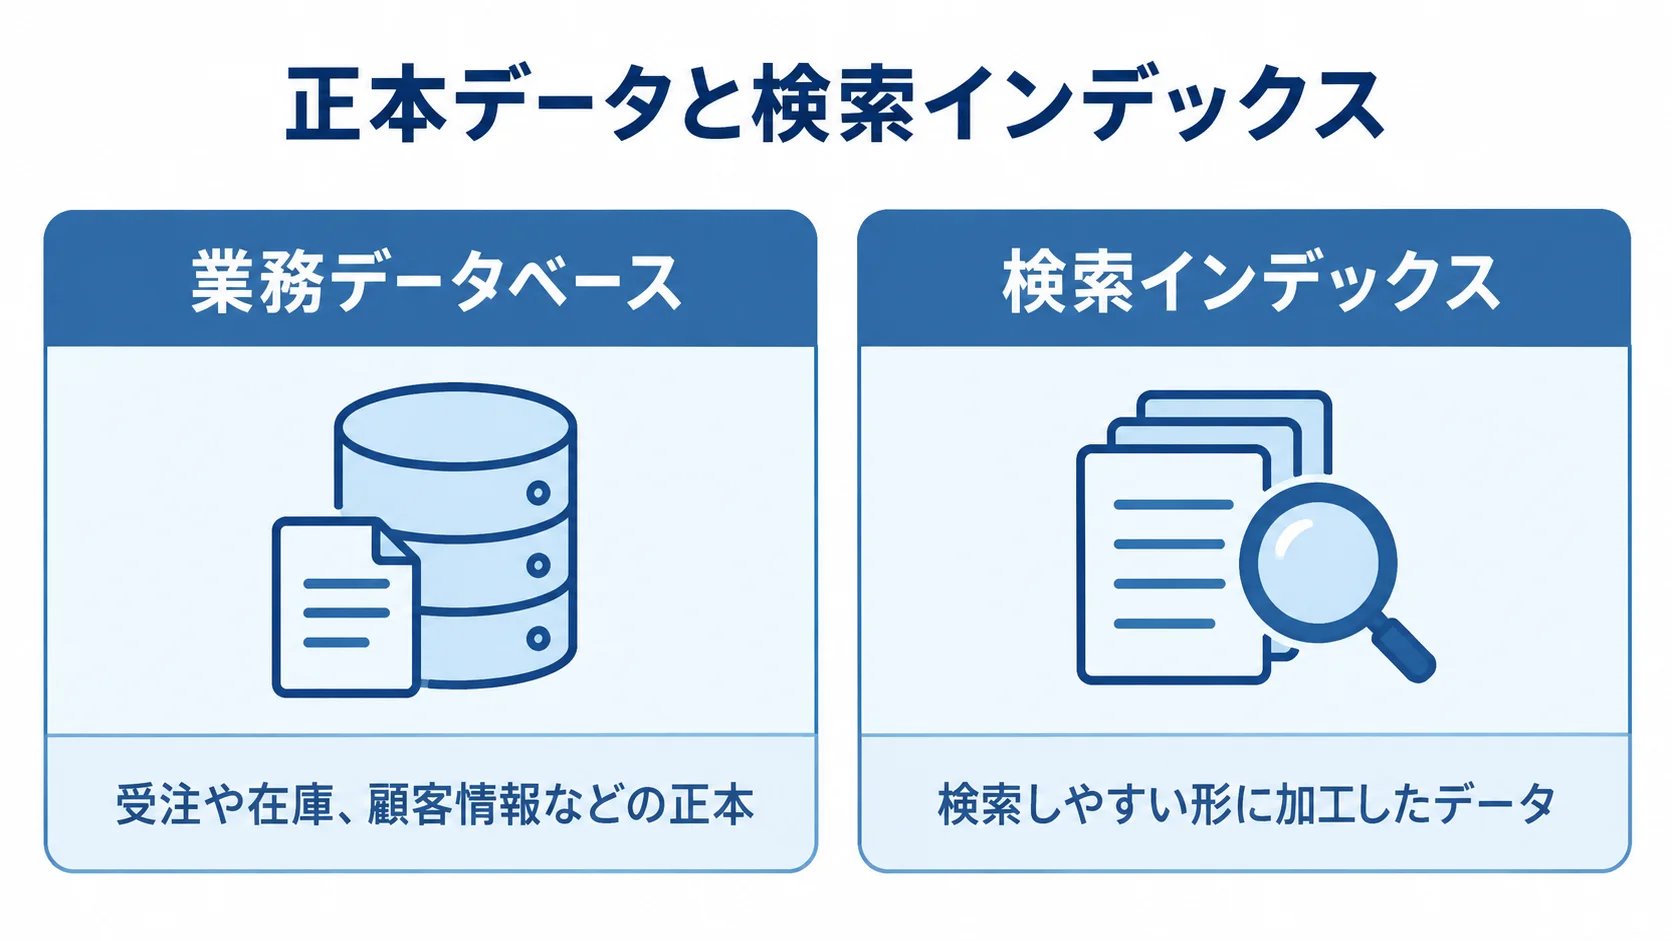
業務データベースは、受注や在庫、顧客情報などの正本を一貫性のある状態で管理します。一方で、検索インデックスは、検索しやすい形に加工したデータを保持します。
通常は、データベースや文書管理システムを正本とし、その内容を更新イベントや定期連携でElasticsearchに反映します。
発注側は、検索結果の更新が数秒から数分遅れることを認めるか、削除依頼を何分以内に反映するかを、要件定義で決めておきます。
主な機能
検索機能には、全文検索や、カテゴリや価格による絞り込みがあります。さらに、検索候補のサジェスト、関連度や業務ルールに基づくランキング、日付や数値の集計も備えています。
ログ基盤では、時系列データを取り込んで、ダッシュボードやアラートへつなげられます。文書検索では、PDFやOfficeファイルから本文を抽出し、メタデータと権限情報を付けます。そのうえで、閲覧可能な文書だけを返します。
Elasticsearchのシステムの種類と用途
用途によって、必要なデータモデルや検索品質は変わります。可用性や保管期間の要件も、用途ごとに違います。発注側は、検索時間の短縮や問い合わせ削減などの業務目標を先に決め、自社の課題に近い用途を見極めます。
Webサイト・ECの商品検索
検索の対象は、商品名や説明文、ブランドです。型番やカテゴリも対象に加え、キーワード検索と絞り込みを組み合わせます。売れ筋や在庫、季節性を順位に反映する場合は、業務ルールもスコアに組み込みます。
検索ログでクリックされなかった語やゼロ件の語を確認すると、同義語辞書や商品データの不足に気づけます。
社内文書・FAQのエンタープライズサーチ
規程や契約書、マニュアルを横断して検索し、過去の問い合わせも対象にできます。部署、公開範囲、有効期限は、インデックスに持たせておくと実務で使いやすくなります。さらに、作成者と更新日も加えると役立ちます。
権限連携では、画面で隠すだけでなく、クエリの段階で利用者が許可された文書だけを対象にします。権限変更や文書削除も、インデックスに反映します。
ログ分析・オブザーバビリティ・セキュリティ監視
アプリケーションログやアクセスログ、メトリクスを集約し、トレースも加えて、障害の兆候や原因を調べます。取り込み量と保存期間は大きくなりやすいため、開発会社はホット・ウォームなどの保存階層を設計します。
一定期間が過ぎたデータの削除、圧縮、バックアップも、発注側と開発会社で決めておきます。セキュリティ用途では、認証失敗や不審なアクセスを検知するルールと監査ログを整えます。さらに、検索基盤へのアクセス権も分けておきます。
ベクトル検索・ハイブリッド検索・RAG
AI検索では、検索方式と取得する文書の扱いを、用途に合わせて設計します。
- ベクトル検索:単語の一致に加えて、文章の意味の近さで候補を探す仕組みです。
- ハイブリッド検索:キーワード検索とベクトル検索を組み合わせた方式です。
- RAG:検索文書を生成AIに渡して回答を作り、正しい文書を権限どおり取得できるかを評価します。
2025年4月公開の9.0および8.18では、ベクトル圧縮、意味検索、再ランキングが強化されました。ES|QLなども強化されています(出典:製品公式リリースノート、2025年)。また、AIを導入する前には、データの整備も必要です。
Elasticsearchのシステム構成と設計ポイント
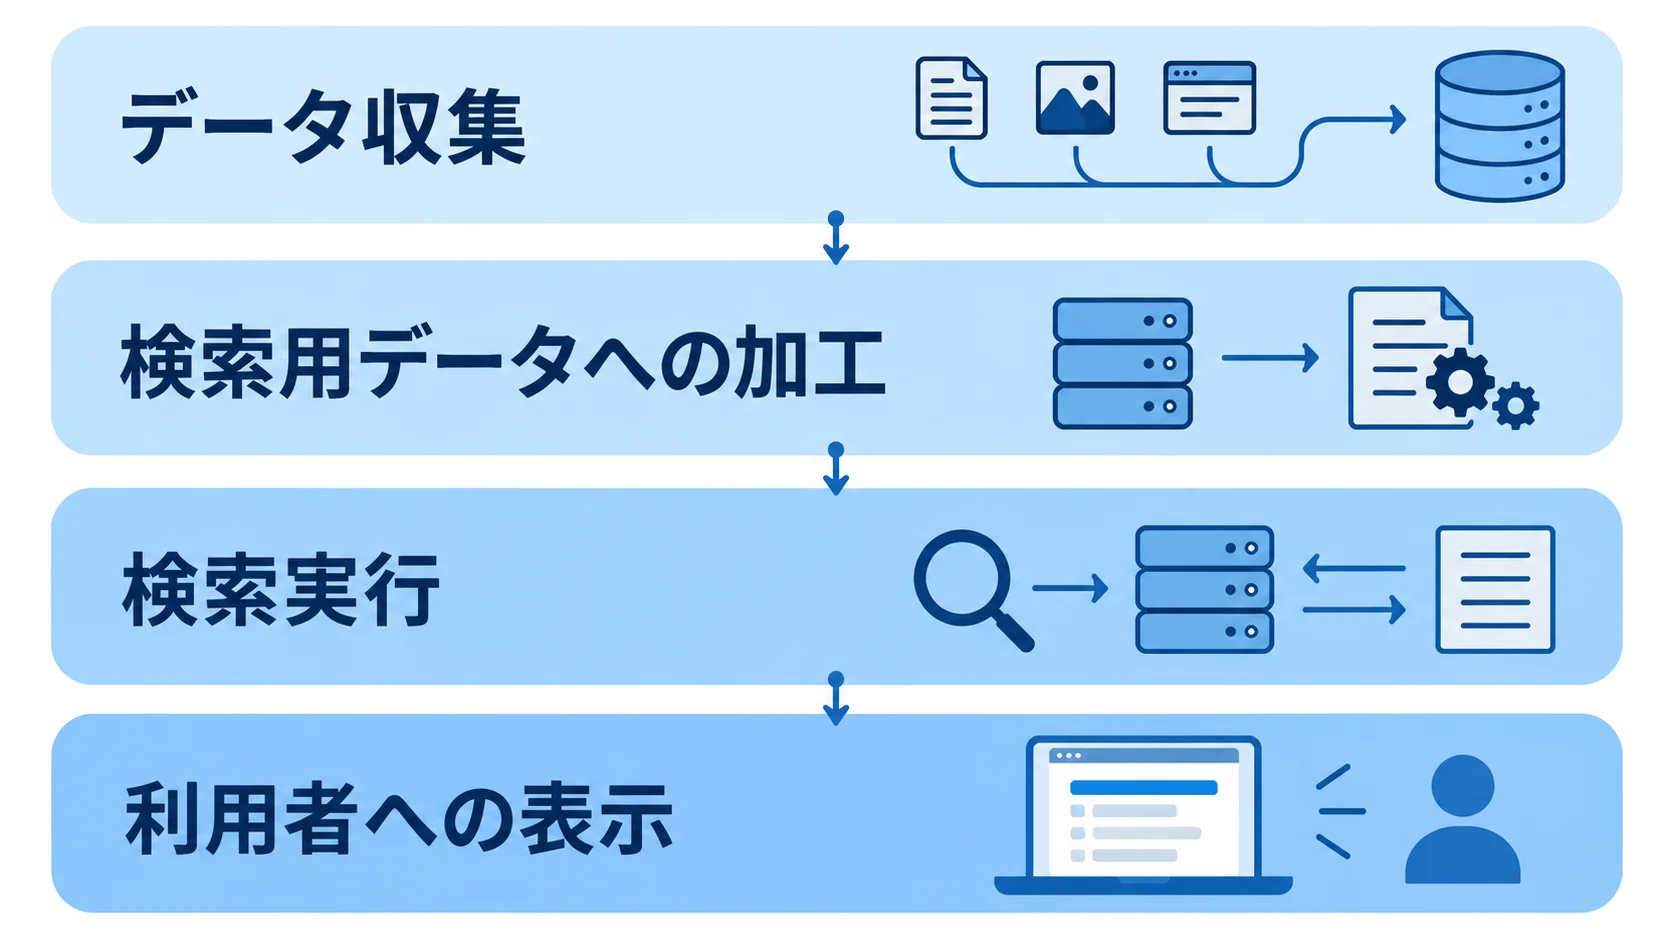
検索システムは、データ収集と検索用データへの加工、検索実行、利用者への表示に分けると設計しやすくなります。
小規模な試作では、これらを一つにまとめても構いません。本番では、障害復旧や負荷分散、権限情報の扱いまで含めて、開発会社が各層の境界を定めます。
データ収集と取り込みパイプライン
データベースやファイルサーバーのほか、SaaSやアプリケーションログからもデータを受け取ります。受け取りには、APIやエージェント、メッセージキュー、ETLなどを使います。
取り込みの際には、文字コードや日時、数値の形式をそろえます。個人情報や削除フラグ、権限情報の扱いも、取り込み時に統一します。
失敗したデータを再処理できる仕組みも必要です。取り込みを画面と同期させると、外部の障害で画面まで止まってしまうため、非同期処理と再送キューを用意します。
インデックス・シャード・レプリカの設計
シャードとレプリカの役割を分けたうえで、データ量や負荷に応じて構成を決めます。
- プライマリシャード:文書の一部を、独立したLuceneインデックスとして保持する役割です。
- レプリカシャード:プライマリのコピーとして、障害への備えと検索処理の分散に役立ちます。
- 設計条件:検索数や更新頻度、復旧時間、ノード障害時の余力を踏まえて決めます。
公式資料では、プライマリシャード数はインデックス作成時に決まり、レプリカ数はインデックス処理を止めずに変更できると説明されています(出典:クラスタ・ノード・シャード公式ドキュメント、2026年8月確認)。
検索API・画面・管理機能
アプリケーションは、REST APIや各言語のクライアントを通じて検索条件を渡し、結果を画面に表示します。検索APIには、ページング、タイムアウト、検索対象の制限を設けます。さらに、入力値の検証とレート制限も加えます。
管理機能では、同義語辞書や重み付け、除外語を確認できるようにします。検索ログやゼロ件クエリ、クリック率も、確認の対象に含めます。こうしておくと、公開後の改善が特定の人に偏りにくくなります。
Elasticsearchのシステム開発の進め方
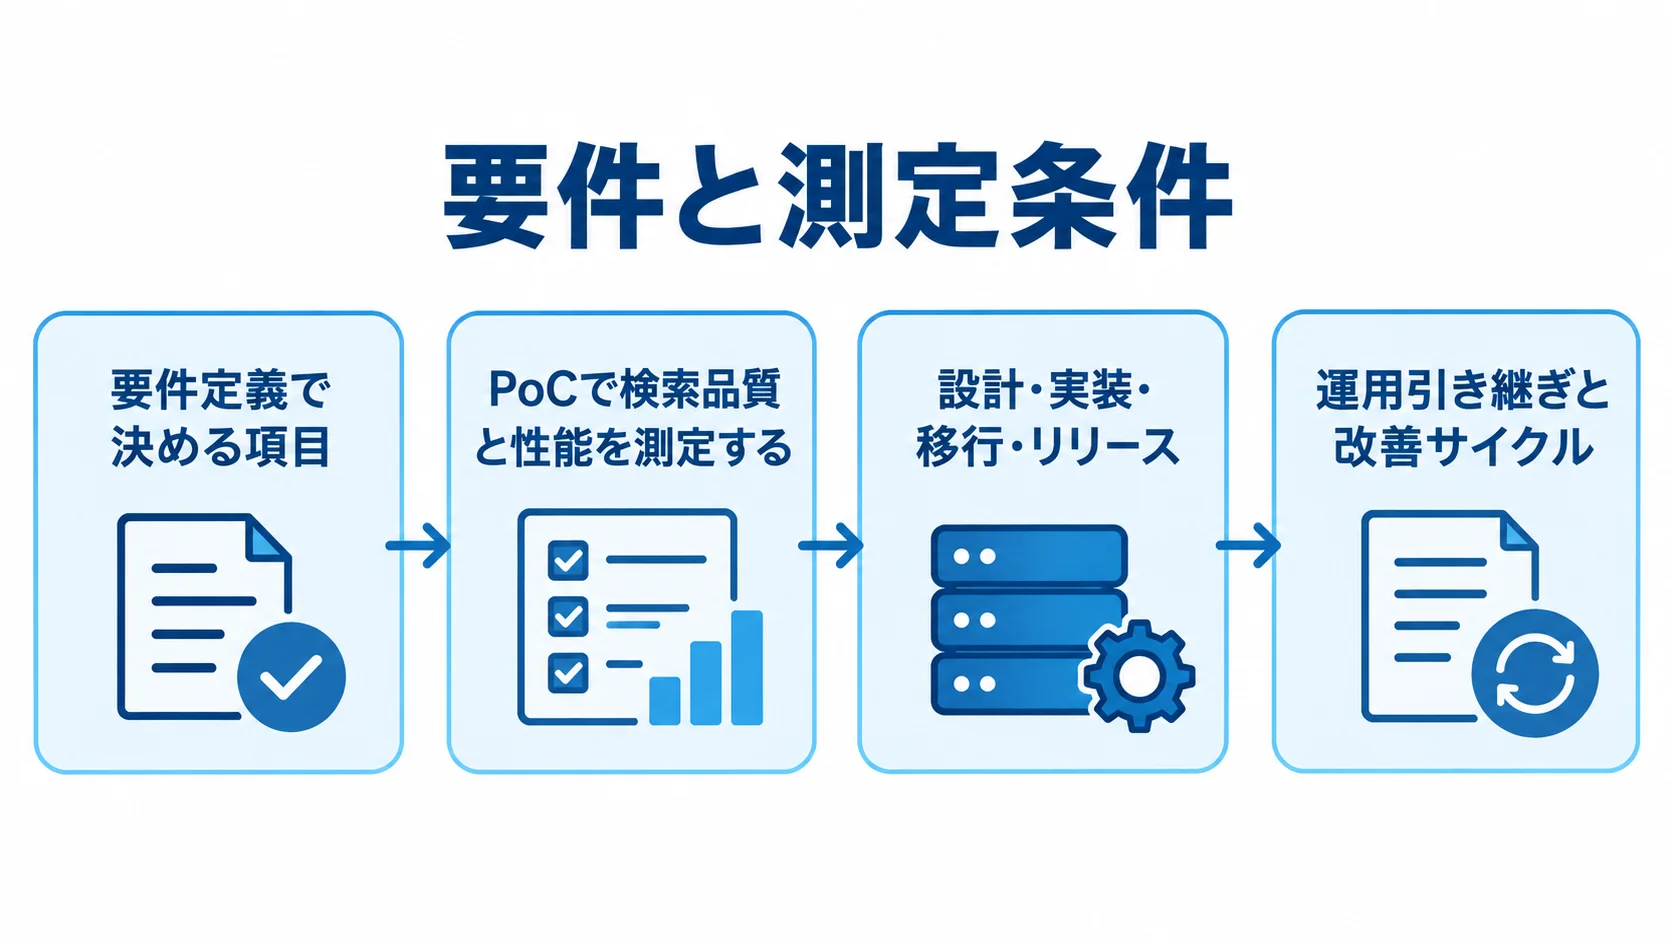
開発は、まず業務課題とデータの状態を確かめ、段階的に進めます。製品は、その後に決めます。
検索品質は、画面の見た目とは別に確かめる必要があります。そのため、代表的な検索語と正解結果を用意し、PoCと負荷試験を通じて本番条件に近づけます。
▶ 詳細はこちら:Elasticsearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義で決める項目
要件定義では、誰が何を検索し、どの業務時間を短くするかを決めます。そのうえで、検索対象のデータソースや文書形式、件数を洗い出します。あわせて、1日あたりの追加量や更新頻度を見積もり、保存期間と削除期限も決めます。
同時利用者数と目標のレスポンスタイムを決めます。稼働時間や障害時のRTOとRPOも定めておきます。正本のシステムと検索基盤、画面それぞれが、どこまで責任を持つかも文書にしておきます。
たとえば「5秒以内」だけでなく、平常時のP95を1秒以内、ピーク時のP99を3秒以内と、測定条件まで決めておきます。そうすると、見積もりと試験の内容が具体的になります。
PoCでの検索品質と性能の測定
PoCでは、実データに近い代表サンプルと、利用者が入力する検索語を使います。検索語ごとの正解順位やクリック率で、品質を比べます。
評価項目は、正しい文書が上位に出る割合や、必要な文書を取りこぼさない割合です。加えて、ゼロ件率やサジェストの妥当性、権限外データの混入の有無も確かめます。
性能面では、P95レイテンシや同時アクセス数、取り込み遅延を測り、障害からの復旧時間も確かめます。成功条件を先に決めておくと、後からAI検索を加えた場合も、全文検索との指標の差を判断できます。
設計・実装・移行・リリース
設計では、mappingやanalyzer、インデックスライフサイクルを定めます。シャードやレプリカ、バックアップは、データ量や復旧時間に応じて決めます。監視や権限モデルも、設計の中で定めます。
実装では、取り込み処理と検索APIを分けたうえで、失敗時の再送や重複排除をテストします。更新順序や削除の反映も、テストの対象に含めます。
移行では、全件投入と差分同期の手順を作ります。さらに、切り替えや旧システムとの照合、ロールバックの手順も用意します。また、公開後に検索ログを分析し、同義語やランキングを改善する作業も、初期計画に入れておきます。
運用引き継ぎと改善サイクル
納品時には、開発会社が構成図やデータ項目一覧、mappingをそろえます。辞書やクエリ、テスト結果も、納品物に含めます。さらに、監視項目や障害対応、復旧手順を資料にまとめ、バージョンアップの手順も用意します。
運用では、ディスク使用率やJVMメモリ、CPUを定期的に確認します。GCや検索レイテンシも見ます。取り込み失敗や未処理キュー、シャードの偏りも対象になります。
月次でゼロ件検索や離脱の多い語を見直すと、導入効果を継続的に高められます。
Elasticsearchのシステム開発費用相場
費用は、利用料だけでなく、開発の工程全体を合計して考えます。要件定義やデータ診断、連携、検索チューニングの工数も含まれます。
画面開発や権限、性能試験の工数も必要です。移行や監視、保守も含め、合計で見ます。
Elasticsearch単体の委託費を示す公的統計はありません。下の数字は、一般的な業務システムの工数に、検索基盤ならではの作業を組み合わせた目安です。
実際の予算を立てるには、データ量と要件を示し、PoCと負荷試験を経て再見積もりします。
▶ 詳細はこちら:Elasticsearchのシステム開発の見積相場や費用/コスト/値段について
規模別の開発・導入費用
開発規模ごとの費用と期間の目安は、次のように分かれます。
- 小規模PoC:1データソース、数万〜数百万件を対象に、費用は50万〜150万円、期間は2〜6週間。
- 小規模本番:1〜3連携と基本権限を含み、費用は150万〜500万円、期間は2〜4か月。
- 中規模:数千万件規模で、冗長化や監視、権限連携を含み、費用は500万〜1,500万円、期間は4〜8か月。
- 大規模:全社検索や24時間運用を含み、費用は1,500万〜5,000万円超、期間は8〜18か月となる場合があります。
大規模な基幹連携や段階移行を含むスクラッチ開発は、3,000万円から数億円まで幅があります。費用を押し上げるのは、データクレンジングやPDF抽出、日本語辞書です。さらに、複雑な権限や長期ログ保管も費用を増やします。
社内の規程やFAQ、業務文書を合計1億件規模で横断検索する場合は、本文抽出や権限同期、複数ゾーン冗長化が必要です。加えて、初回投入と差分更新も必要になります。
監査ログと検索品質の評価も必要です。文書の重複や古い版の整理も発生するため、見積もりでは「1億件に対応するサーバー」の費用に加えて、これらの作業も含めます。
まずは数百万件の代表データでPoCを行い、1億件に拡張した場合の容量、検索速度、再インデックス時間を試算します。
クラウド利用料とランニングコスト
利用料と運用費は、構成の前提と継続作業を分けて考えます。
- 料金の変動要因:リージョン、CPU・メモリ、保存量、転送量、機能、為替によって変わります。
- 運用費:利用料に加えて、バックアップや転送、監視、脆弱性対応、検索改善、サポートを計上します。
- 保守費の目安:開発費1,000万円なら年150万〜200万円程度の場合があります。24時間監視や長期ログ保存では増えます。
製品公式のStandardプラン例は、月額99米ドルからです。この価格は、本番構成とストレージ120GB、2ゾーンを前提にしています。
1米ドル150円で換算すると、月約1万5,000円、年額約18万円です。最小構成の参考値です(出典:製品公式クラウド料金ページ、2026年8月確認)。
見積書は「Elasticsearch一式」とまとめず、工程と月額項目に分けて比較します。
費用を抑える方法と注意点
目的が明確な1用途・1データソースでPoCを行うと、不要な連携や過剰なクラスタを避けられます。また、マネージドサービスや標準の取り込み機能を使えば、初期のインフラ運用工数を減らせます。
安価な単一ノードを本番に流用すると、障害時に検索が止まったり、再構築が長引いたり、保存容量が足りなくなったりすることがあります。そのため、発注側は初期費用と障害時の業務損失を合わせて判断します。
クラウド・オンプレミス・OpenSearch系サービスの選び方
実行環境は、費用だけでなく、最新機能への追従やデータの配置で選びます。そのほか、ネットワークや運用体制、既存クラウドとの親和性も判断材料になります。
どの方式でも、バックアップや監視、障害対応の担当を決めておきます。アップグレードやデータ削除については、誰が責任を持つかを明確にします。
マネージドクラウドが向くケース
サーバー構築やパッチ適用に人を割けず、短期間で本番へ進めたい場合は、マネージドクラウドが候補になります。ノード追加やバックアップ、監視の一部を任せられます。
利用料は、リソースと保存量に応じて増えます。そのため、取り込み量や検索負荷、ログ保持期間を料金計算機で試算し、検証環境を放置しない運用も組み込みます。
セルフマネージド・オンプレミスが向くケース
閉域網や既存設備が必要な場合、あるいは特定のデータ配置や細かなプラグイン管理を求める場合は、自社クラウドのセルフマネージドやオンプレミスが候補です。そのぶん、構成の自由度は高くなります。
OSやJVM、プラグイン、証明書の管理は自社で担います。バックアップや脆弱性対応、アップグレードも自社で行います。そのため、発注側は、夜間障害に対応する人員と復旧訓練を含む運用費を確保できるかで判断します。
OpenSearch系サービスと比較するときの注意
サービスごとの互換性、評価条件、移行作業を、同じ基準で比べます。
- 互換性:バージョンやAPI、プラグイン、ライセンス、画面、ベクトル検索機能が対象です。
- 動作検証:同じデータと代表クエリで、検索品質やP95レイテンシ、取り込み遅延、バックアップからの復旧、権限フィルタリングを測ります。
- 移行作業:移行費用には、インデックス再作成やマッピングの差異、クエリの書き換え、画面・監視・運用手順の更新も含みます。
ある主要クラウドの公式資料では、新しい世代のマネージドサービスはOpenSearch中心に提供されています。Elasticsearchは7.10などのレガシー世代として扱われています(出典:クラウドサービス公式ドキュメント、2026年8月確認)。
既存クライアントに加えて、将来の機能やアップグレード経路も検証します。
日本語検索・セキュリティ・運用で失敗しない方法
Elasticsearchの導入効果は、利用者が欲しい結果へ短時間でたどり着けるようになった時点で決まります。
日本語解析や権限を後から加えると、再インデックスや設計変更が起きやすくなります。特に、個人情報の扱いやログ監視も、後付けにすると設計の手戻りが増えます。
そのため、これらの要件は、PoCの段階から本番要件として扱います。
Kuromoji・同義語・表記揺れの設計
日本語は単語の区切りが空白で示されないため、解析の設定が検索品質を左右します。
- 解析設定:形態素解析や文字正規化、同義語、専門用語辞書を整えます。
- 検索語の確認:分解しすぎると意図しない結果が出るため、実データで試します。
Kuromojiの検索向けモードには、長い複合名詞を分解しつつ、元の複合語も扱える設定があります。
製品名や業務用語については、ユーザー辞書を追加できます(出典:Kuromoji公式リファレンス、2026年8月確認)。
テストでは、専門用語や略語、全角と半角、旧字体も対象に含めます。
アクセス権・個人情報・監査ログの保護
社内文書や顧客情報を扱う場合は、認証だけでなく、認可も検索結果に反映します。利用者や部署の権限をクエリに適用し、文書やフィールドの単位で制御を設計します。
通信時と保存時の暗号化、ネットワーク制限、秘密情報の管理も決めておきます。個人情報保護委員会の安全管理措置では、アクセス制御や不正アクセス防止、ログ確認、委託先監督などが重要です。
監査ログには、認証失敗や拒否されたアクセス、権限変更を残します。検索操作の記録も残します。保存期間と閲覧者も、あらかじめ決めておきます。
容量・障害・バージョンアップの管理
容量、障害対応、更新作業は、あらかじめ運用計画に含めておきます。
- 容量管理:保存期間と取り込み量から将来の使用量を予測し、古いデータは移動するか削除します。
- シャード調整:多すぎるとメモリや復旧時間を圧迫し、少なすぎると負荷の分散が難しくなります。
- 障害訓練:ノード停止やディスク逼迫、取り込み停止、検索遅延、誤削除を想定します。
- 更新確認:バージョンアップの前に、クライアントやプラグイン、クエリ、分析設定を検証します。
シャード数は、実データに近いサイズで試験します。障害が起きたときに備えて、スナップショットからの復旧と再インデックスを定期的に訓練します。
Elasticsearchの開発会社・ベンダーの選び方
開発会社やベンダーは、インストールだけでなく、データ設計や検索品質、日本語対応を担えるかで選びます。そのうえで、既存連携や権限、性能試験、運用移行まで対応できるかを確かめます。
導入後も辞書やランキングの改善は続くため、初期価格だけでなく、相談体制や、引き継ぎやすい形で納品されるかも確認します。
検索・連携・運用の実績の確認
検索画面の実績に加えて、mappingやanalyzer、Kuromojiの経験を確かめます。同義語辞書やランキング調整の経験も、あわせて尋ねます。連携については、DBやファイルとの方式に加えて、ログや認証基盤との方式も聞きます。
削除や再インデックスの手順と、複数ゾーン構成を確かめます。監視と障害時の連絡体制も確認します。匿名化された画面を見るだけでなく、実装担当者に代表クエリを見せてもらいます。
検索品質と性能をどう測るかを説明してもらい、提案の中身を評価します。
見積書と契約範囲の比較
見積書は、要件定義やデータ診断、PoC、クラスタ設計、連携に分けてもらいます。そのうえで、検索APIや画面、権限、性能試験の項目も立ててもらいます。移行や教育、保守も、工程として分けて示してもらいます。
クラウド利用料とライセンスの扱いを確かめます。バックアップや監視、問い合わせ対応の有無も確認します。「検索精度の改善」を含む場合は、対象クエリ数と評価方法、辞書更新回数、納品時の品質基準を契約に書きます。
将来の移管に備えて、所有権と納品範囲を明確にします。対象には、ソースコードや設定、辞書があります。さらに、テストデータや運用手順も含めます。
RFPに記載する項目
候補先を同じ条件で比べられるよう、RFPに業務要件とシステム条件をそろえます。
- 目的とデータ:利用者、データソース、件数、増加量を記し、検索語の例と正解結果も添えます。
- 性能と運用:同時アクセスや目標レイテンシ、更新遅延、保存期間を記し、権限と個人情報の扱いも書きます。
- 契約条件:稼働時間やRTO・RPO、納期、予算、既存環境を示したうえで、PoCや追加費用も比べます。
提案は、価格だけでなく、リスクや前提条件、追加費用が発生する条件も見ます。
▶ 詳細はこちら:Elasticsearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Elasticsearchのシステム開発の発注/外注/依頼/委託方法について
よくある質問(FAQ)
最後に、導入前に特に質問されやすい点を取り上げます。答えはデータ量やセキュリティ要件で変わるため、一般論をそのまま採用せず、代表データで検証します。
Elasticsearchを業務データベースの代わりに使えますか?
原則として、受注や在庫などの正本を管理する業務DBと検索インデックスは分けて考えます。Elasticsearchは検索や集計に使い、正本側から非同期で同期する構成が一般的です。
厳密な更新整合性やトランザクション、複雑なリレーションが中心なら、その用途に合う業務DBを使います。検索の要件だけを、Elasticsearchに切り出します。
Elasticsearchは無料で導入できますか?
無償で使える機能や構成があっても、サーバーやストレージ、バックアップ、監視の費用は発生します。さらに、保守や開発人員の費用もかかります。
マネージドサービスは、運用機能を利用料に含む一方で、データ量や検索負荷に応じて月額が増えます。ライセンスの有無だけでなく、初期費用と3年間の運用総額を比べることが現実的です。
何件くらいからElasticsearchが必要ですか?
必要かどうかは、件数に加えて、検索の複雑さや同時アクセスの多さで変わります。たとえば、数万件でも、複雑な全文検索や高い同時アクセスが必要なら候補になります。
数百万件でも、単純な条件検索であれば別の方式で足りる場合があります。そのため、検索語や更新頻度、レスポンスタイム、将来の増加量でPoCを行い、現行方式の遅延や運用負荷と比べます。
最初からRAGやAI検索を導入するべきですか?
最初からの導入は、必ずしも求められません。まずは全文検索の段階で、文書の正規化と権限、検索ログ、評価データを整えます。
その後に、ベクトル検索やハイブリッド検索、RAGを段階的に加えると、改善効果とリスクを分けて測れます。AIを使う場合は、根拠の表示と権限フィルタリングを先に決めます。回答の評価や機密情報の扱いも、あわせて先に決めておきます。
まとめ
Elasticsearchは、Web・EC検索や社内文書検索、ログ分析を支える検索基盤です。セキュリティ監視やAI検索にも使われます。
業務DBを正本とし、検索インデックスとの役割を分けます。そのうえで、シャードやレプリカ、取り込み、権限は一体で設計します。バックアップや監視も、同じ設計の中で扱います。
まずは用途・データ・評価指標の整理
導入前に、検索の対象と改善したい業務を決め、正本データと更新・削除の責任者を定めます。あわせて、件数や増加量、同時アクセス、保存期間を確認します。
日本語検索と権限の合格条件、初期費用と運用費を見る年数も決めます。そのうえで、1用途のPoCを行い、検索品質や性能、セキュリティ、復旧性を実データに近い条件で確認します。
開発会社やサービスの条件をそろえた比較
同じRFPで複数の候補を比べ、検索や連携、権限、性能試験、運用移行の対応範囲を確認します。
価格だけでなく、検索品質を改善する技術力や障害対応、どこまで中身を見せてもらえるか、将来の移行のしやすさも含めて判断します。
▼関連記事一覧
・Elasticsearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Elasticsearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Elasticsearchのシステム開発の見積相場や費用/コスト/値段について
・Elasticsearchのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。