
混合ガウスモデル(Gaussian Mixture Model:GMM)は、複数の正規分布からデータが生成されると仮定するモデルで、各データの所属確率を表します。
たとえば、クラスタAに70%、クラスタBに30%というように、一つのデータの所属を割合で示せます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
混合ガウスモデルが複数の正規分布を組み合わせる仕組み
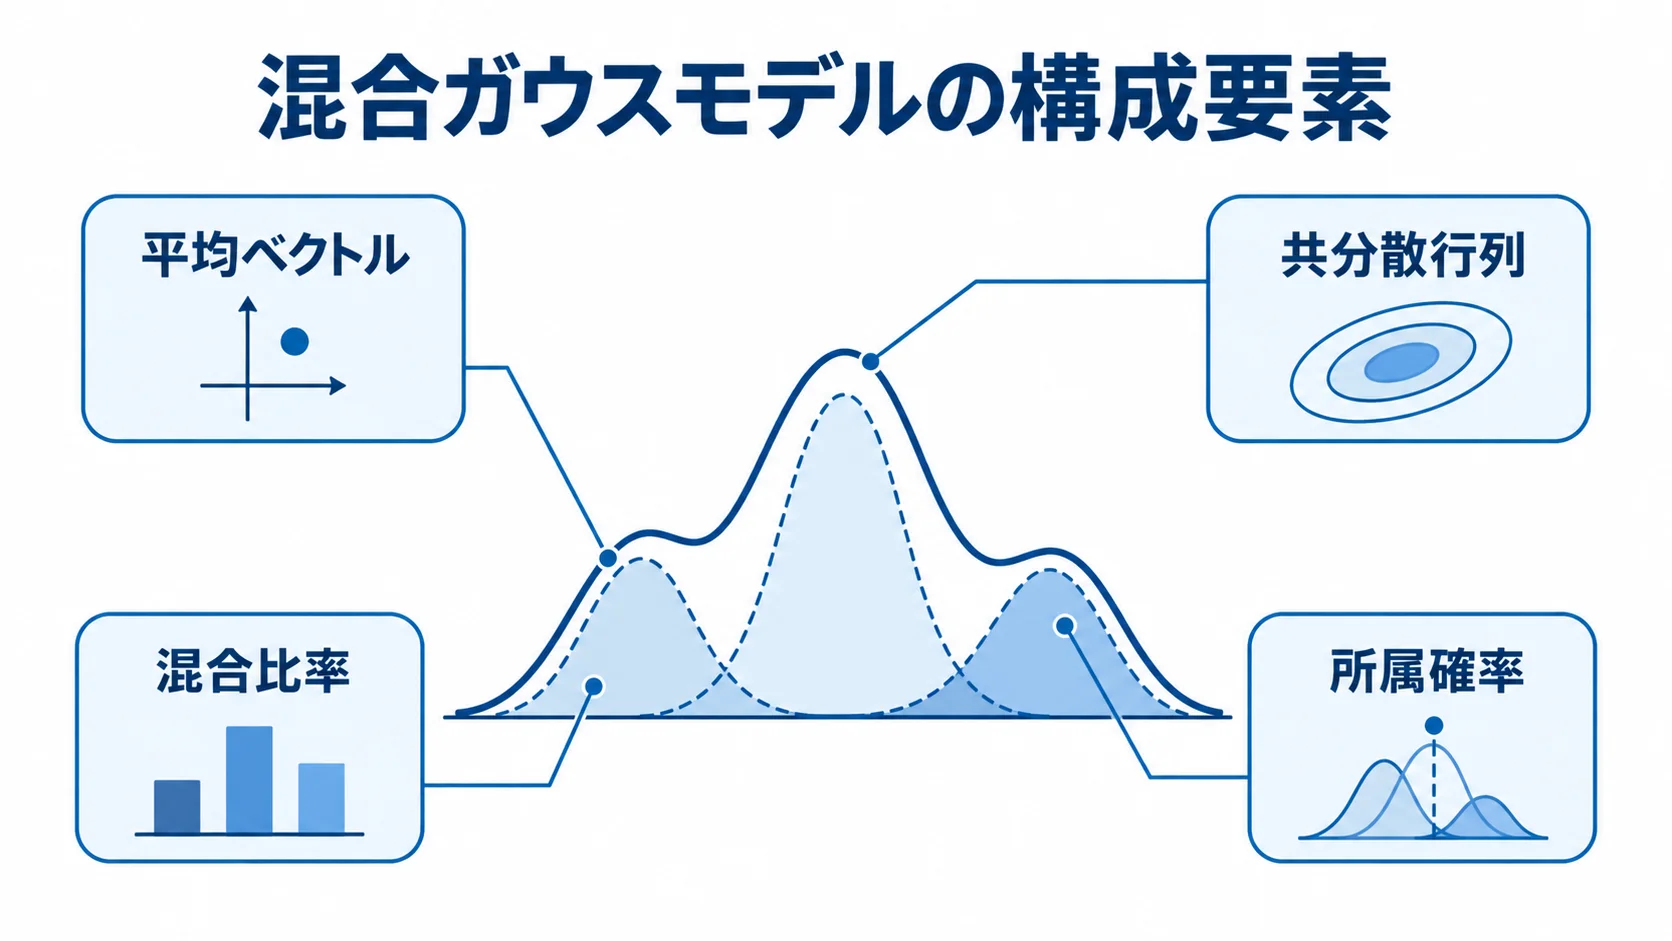
混合ガウスモデルは、複数のガウス分布に重みを付けて足し合わせた分布です。各成分(正規分布の一つひとつ)には、平均ベクトル、共分散行列、混合比率があります。
学習では、全成分の混合分布が観測データをどれだけ説明するかを最大化します。新しいデータが来たときは、各成分から生成された確率を比べ、所属確率や対数尤度を求めます。
クラスタへの所属の確率表現
k平均法は、データを最も近い中心へ一つだけ割り当てるハード割り当てです。一方で、混合ガウスモデルは、境界付近や複数の集団にまたがるデータの曖昧さを確率で表します。
たとえば、顧客が複数の行動パターンを持つ場合や、状態が徐々に変化するセンサー値では、確率を使って曖昧さを残した判断ができます。
共分散の形と成分の広がり
共分散行列は、各特徴の分散と、特徴同士がどの方向へ一緒に変化するかを表します。scikit-learnのGaussianMixtureでは、次の形式から選べます。
- full:成分ごとに固有の共分散を持つ形式
- tied:全成分で共分散を共有する形式
- diag:対角成分だけを扱う形式
- spherical:等方的な共分散を扱う形式
データ量に対して複雑な共分散を選ぶと、過学習しやすくなります。そのため、目的とサンプル数を踏まえて、形式どうしを比べて選びます。
EMアルゴリズムで成分と所属確率を交互に更新する流れ
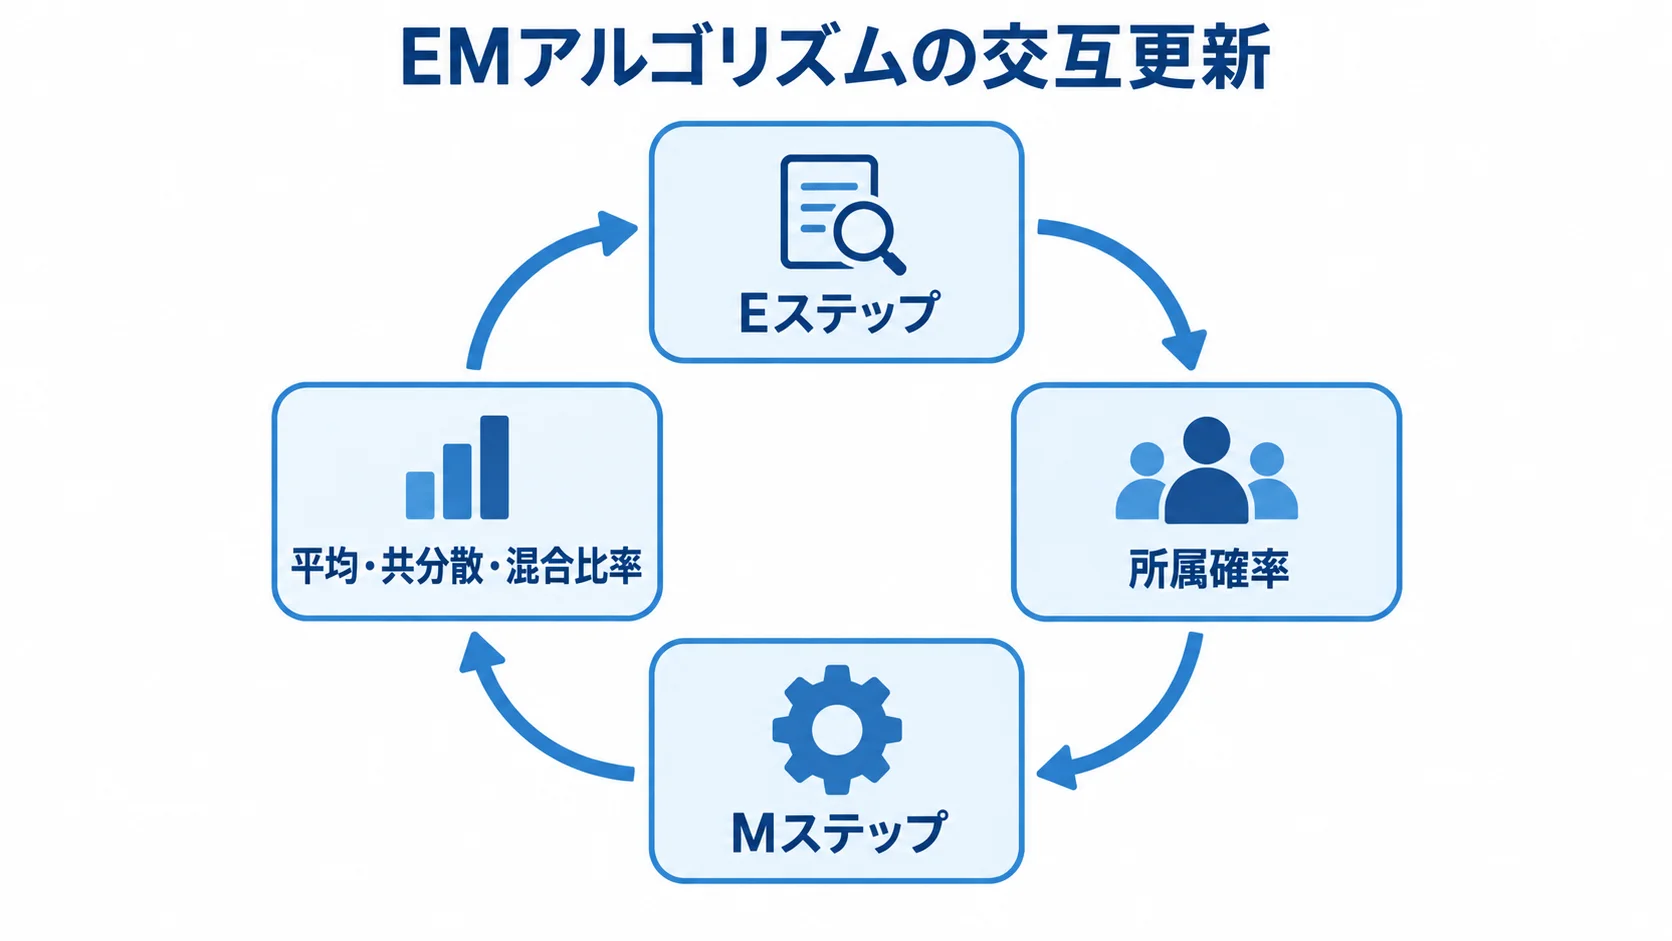
学習では、各データがどの成分から生成されたかを直接観測できません。そこで、EM(Expectation-Maximization)アルゴリズムは、次の2つの更新を繰り返します。
- Eステップ:現在のパラメータをもとに、各データの所属確率を計算
- Mステップ:所属確率を重みとして、平均・共分散・混合比率を更新
学習は、尤度の改善が小さくなるか、最大反復回数に達すると止まります。ただし、初期値によって局所最適解が変わる可能性があるため、開発側はn_initやrandom_stateを設定し、複数回の初期化で結果を比べます。また、成分の共分散が極端に小さくなったときは、正則化を加えるか、共分散形式を見直します。
成分数と共分散形式の選び方
成分数を増やすと、データを細かく説明できる一方で、パラメータ数も増えます。その結果、過学習や意味のない小さな成分が生じることがあります。
成分数は、対数尤度に加えて、複雑さを考慮するAICやBIC、検証データの対数尤度を見て決めます。さらに、所属確率の安定性と業務上の解釈も選定の材料になります。
full共分散は成分ごとに楕円の向きを表現できますが、パラメータが多くなります。一方で、diagやsphericalは制約が強い分、少ないデータでも安定しやすく、計算も抑えられます。
そのため、まず単純な形式を基準にし、複雑な形式による改善が再現するかを確かめてください。
前処理と特徴量の選び方が確率の意味を左右する点
ガウス分布と距離を使うため、特徴量の単位が異なると、一部の変数が尤度を支配することがあります。そこで、標準化や対数変換を行い、変換のパラメータは学習データだけで求めます。
長い裾や極端な外れ値があるときは、分布の仮定と合っているかを確認します。そのうえで、別の分布モデルやロバストな方法も比べます。
欠損値をそのまま扱えない実装もあるため、補完方法と、補完による不確実性を確認します。また、カテゴリ値を整数に変えると、数値の距離に意味がない場合があります。
特徴量は、クラスタの分かれやすさだけでは選びません。業務上説明できる変数を残すことも大切にします。
k平均法とは確率とクラスタ形状の扱いが違う点
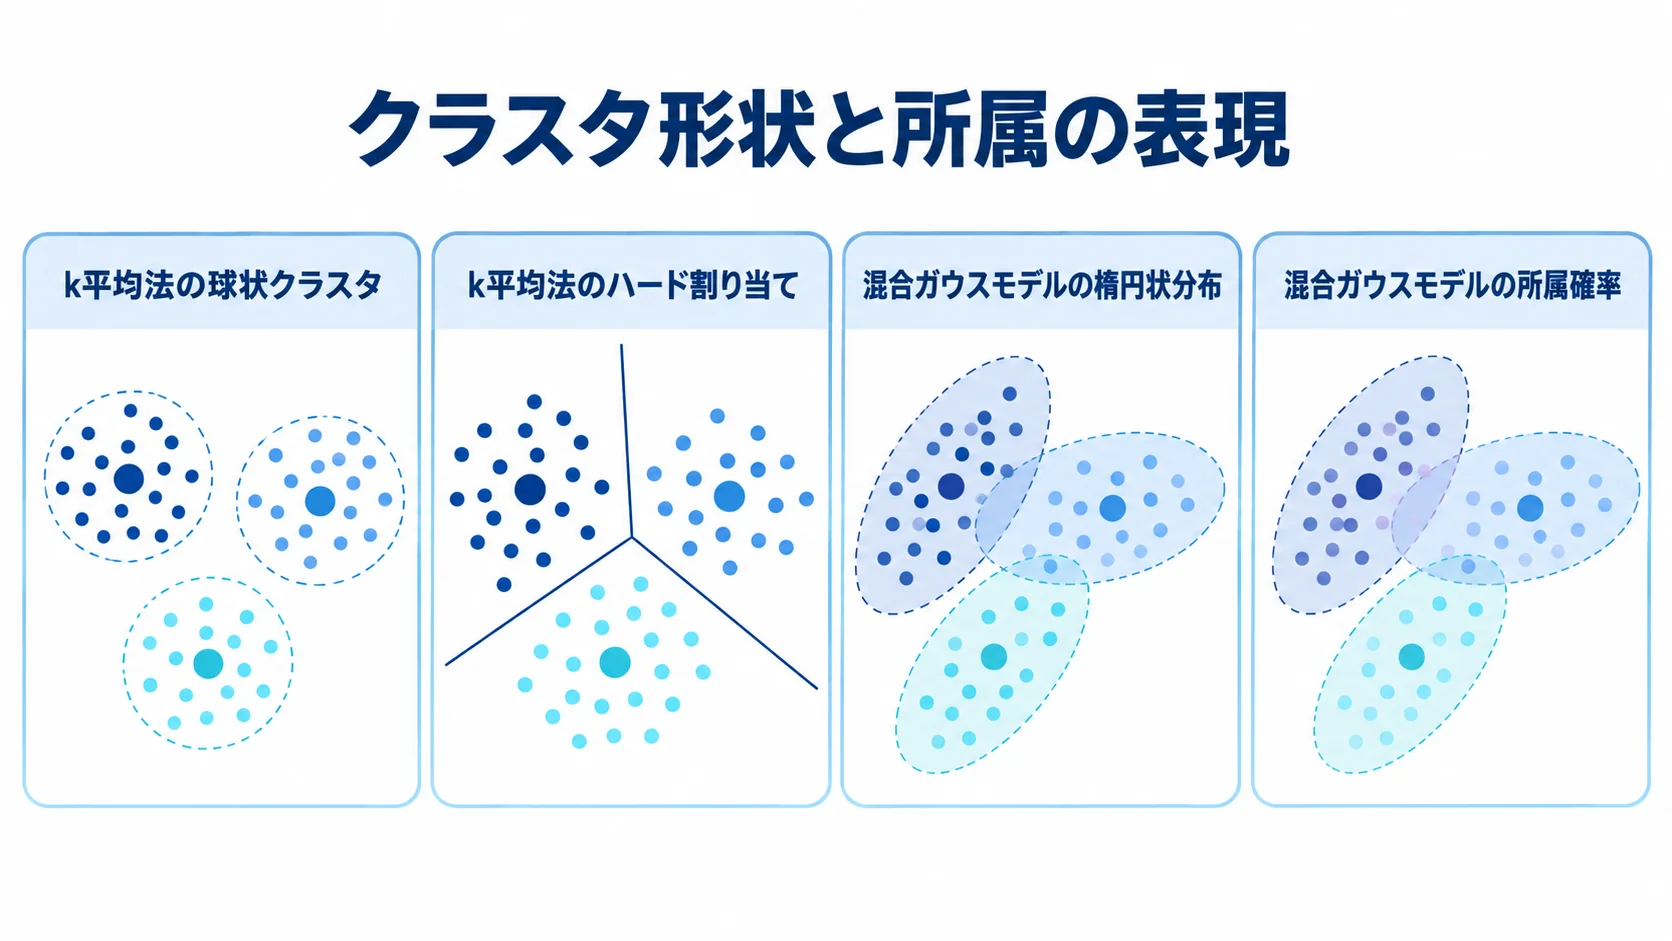
k平均法は、中心との距離の二乗和を小さくするため、概ね球状で大きさのそろったクラスタに向いています。一方で、混合ガウスモデルは共分散を使うため、楕円状の分布や重なりも表現できます。
混合ガウスモデルでは所属確率も得られます。ただし、正規分布の仮定とパラメータ推定が必要になります。
データが大きく複雑な場合は、計算量と結果の安定性を確認します。確率最大の成分へ割り当てる方法もあります。
また、確率が拮抗するデータを「要確認」とする設計も可能です。分類境界を無理に決めず、確率を後段の意思決定へ渡せます。
混合ガウスモデルの活用例
所属確率や尤度を使うと、次のような分析や確認ができます。
- 顧客セグメント:施策の対象と要確認の層を、所属確率で分ける
- 異常候補:学習した分布で尤度が低いデータを点検候補にする
- 画像・音声特徴:ベクトルの分布を成分に分け、検索や分類の候補を作る
- 需要や設備状態:複数の通常状態を確率で表し、状態の移り変わりを監視する
低い尤度が出ても、それが故障を指すとは限りません。通常と異なるデータが正当かどうかは、季節性や製品切替、キャンペーンから確かめます。センサーの欠測も、確認の対象になります。異常検知の閾値は、業務担当者と一緒に決めます。
所属確率を業務に渡す場合は、確率の校正にも注意が要ります。学習データで高い確率が出ても、本番環境で同じ信頼度になるとは限りません。そのため、期間別の確率分布や成分ごとの件数、実際の確認結果を記録しておき、その記録をもとに閾値を定期的に見直します。
自動通知では、確認できる件数と業務の緊急度を考慮して、通知の範囲を決めます。さらに、担当者の判断結果をフィードバックとして蓄積し、再学習や特徴量の改善につなげる運用を設計します。
混合ガウスモデルで起きやすい失敗と対策
成分番号を固定的な意味として扱う問題
EMの初期値が変わると、成分1と成分2の番号が入れ替わることがあります。そのため、番号に頼らず、平均や共分散などの特徴で成分を対応づけます。代表データや所属確率の傾向も手がかりになります。
成分数や共分散の増やしすぎと過学習
訓練データの尤度が高くても、未知のデータにうまく当てはまるとは限りません。そこで、BICや検証尤度を見て、複数の初期値で結果が安定するかも確かめます。さらに、業務での解釈も踏まえ、単純なモデルを基準に比べます。
標準化と外れ値の確認不足
入力の単位や外れ値によって、尤度の大きさが変わります。そのため、前処理と対象期間、欠損処理を揃えて、モデルと閾値を比べます。
混合ガウスモデルのチェックリスト
運用前に、モデルの前提、評価方法、確率の扱いを確かめておきます。
- 複数のガウス分布の仮説を立て、前処理(標準化、外れ値、欠損、カテゴリ表現)を確認したか。
- 成分数、共分散形式、初期化、乱数シードを比べたか。
- AIC・BIC・検証尤度と業務上の解釈を合わせて評価したか。
- 所属確率が拮抗するデータや低尤度データの扱いを決めたか。
- 再学習時に成分番号が入れ替わっても、対応づけを管理したか。
加えて、学習に使った期間と本番で判定する期間を分けて評価します。成分ごとの平均と共分散、混合比率を保存し、学習時の前処理も残しておきます。
再学習後は、どの成分が増えたか減ったかを確かめます。また、新しいデータの所属確率が全成分で低い場合に備え、未知の状態として扱うルールも用意します。
担当者が確認した異常候補や境界データを記録すると、原因調査と改善につなげられます。さらに、通知件数、確認時間、真の異常だった割合も追跡します。
閾値が現場の処理能力に合っているかを、定期的に見直します。評価結果は月次のモデルレビューに含めます。そのうえで、データ分布の変化と運用上の負荷を合わせて判断します。
確率的なクラスタリング手法としての混合ガウスモデル
混合ガウスモデルは、複数の正規分布を混ぜ合わせて、データの所属確率と分布のパラメータを学習します。そのため、k平均法より柔軟に、クラスタの形や曖昧な所属を扱えます。
一方で、成分数や共分散、初期値を確認するほか、正規分布の仮定が合っているかも見る必要があります。訓練尤度だけで意味づけせず、検証データや確率の安定性も確かめます。
代表データや、施策・監視のKPIと組み合わせて使います。そのうえで、前処理と再学習の条件を記録し、低尤度や境界データを確認できる運用まで設計することが重要です。
よくある質問(FAQ)
混合ガウスモデルを使うときによくある疑問を、Q&A形式で取り上げます。
Q. 混合ガウスモデルとは何ですか?
複数の正規分布を混ぜた確率分布を学習し、各データが成分に属する確率を求めるモデルです。
Q. k平均法との違いは何ですか?
k平均法が一つのクラスタへ割り当てるのに対し、混合ガウスモデルは所属確率と共分散を扱い、重なった楕円状の分布も表現できます。
Q. 成分数はいくつに設定しますか?
成分数は、AICやBIC、検証データの尤度を見て決めます。さらに、所属確率の安定性と業務上の解釈も判断材料にします。尤度だけで成分数を増やすことはしません。
Q. 標準化は必要ですか?
特徴量の単位や範囲が異なる場合は、多くのケースで必要になります。変換は学習データで決め、新しいデータにも同じ処理を当てはめます。
Q. 異常検知にも使えますか?
使えます。ただし、低尤度が必ず異常を意味するとは限りません。季節性や正当なイベントを確かめたうえで、閾値と確認の流れを業務担当者と決めます。
参考資料
混合ガウスモデルの実装や共分散形式は、次の資料で確かめられます。
- scikit-learn User Guide「Gaussian mixture models」
- scikit-learn「GaussianMixture」
- scikit-learn「sklearn.mixture」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。