
ジニ不純度は、決定木のノードの中に異なるクラスがどの程度混在しているかを表す指標で、分類木の分割を評価するときに使われます。値が0に近いほど、ノード内のクラスがそろっています。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
ジニ不純度とは?ノード内のクラス混在を測る指標
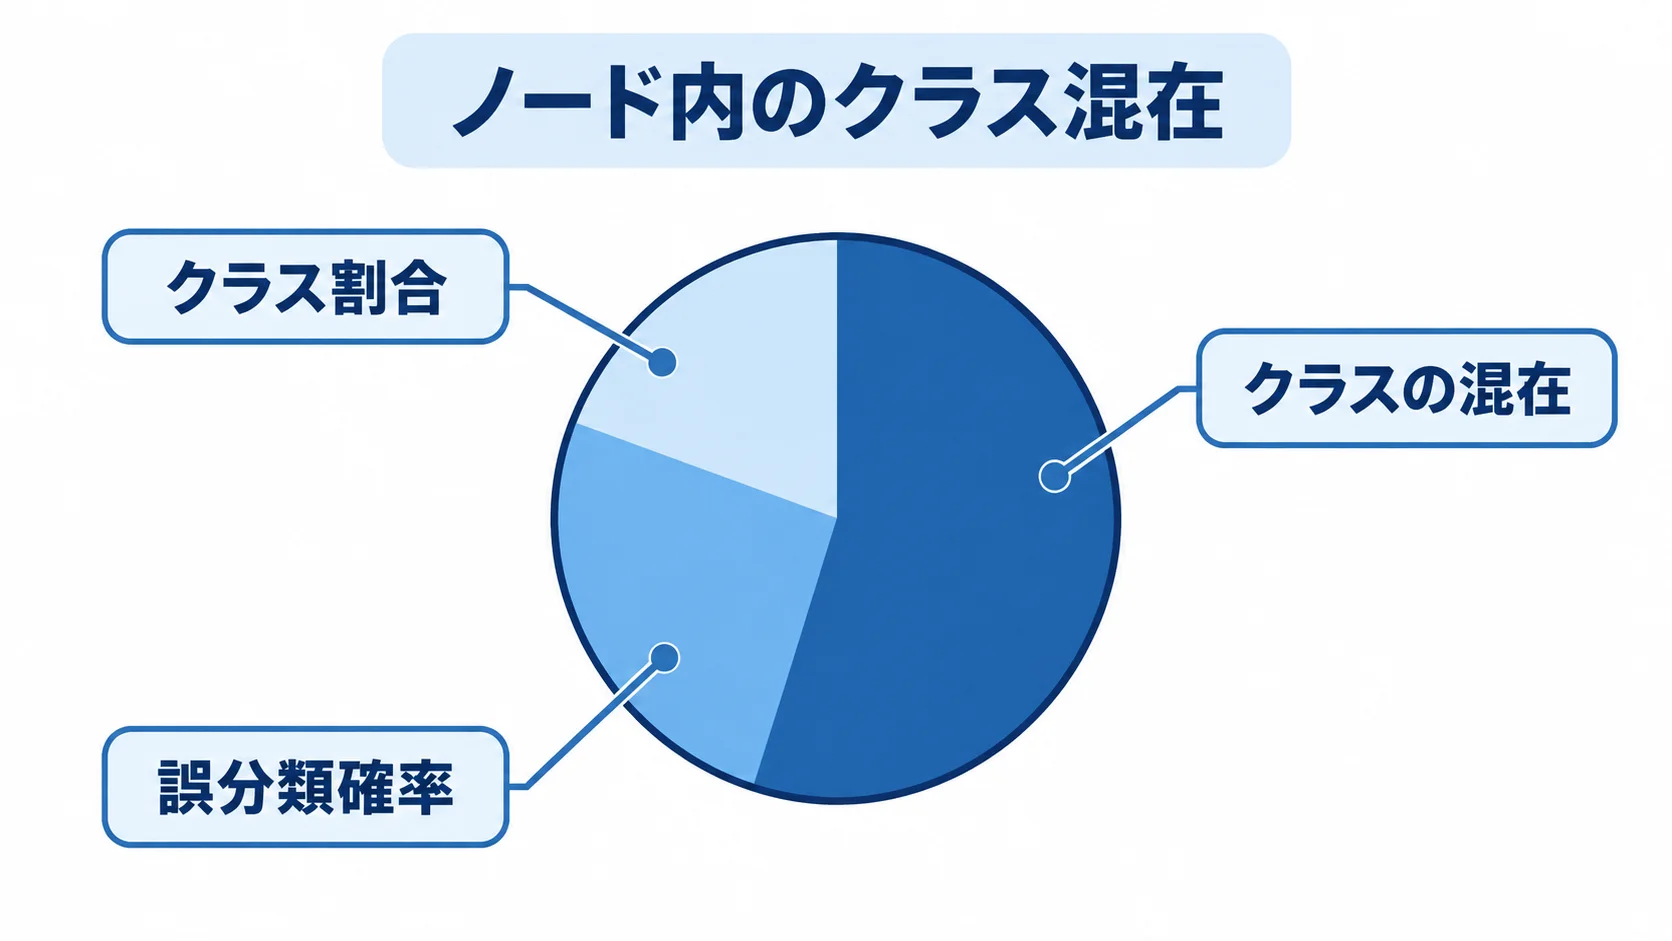
ジニ不純度(Gini impurity)は、ノードから1件を選び、ノード内のクラス割合に従ってランダムにラベルを付けたときの誤分類確率として説明できます。
二クラス分類で、一方のクラスが100%なら誤りは起きず、ジニ不純度は0です。反対に、クラスが50%ずつ混ざると、ランダムなラベル付けの誤りが最大になります。
ノード内のクラス k の割合を p_k とすると、ジニ不純度は次の式で計算します。
Gini = 1 - Σ p_k²たとえば、二クラスで割合が0.7と0.3なら、1-(0.7²+0.3²)=0.42 です。割合が0.5ずつなら0.50、1.0と0.0なら0になります。
多クラスでは、クラス数が増えるほど最大値が変わります。そのため、カテゴリ数の異なる問題どうしで、ジニ不純度の値をそのまま比べないようにします。
決定木でジニ不純度を使う仕組み|分割後の加重平均が小さい条件の選択
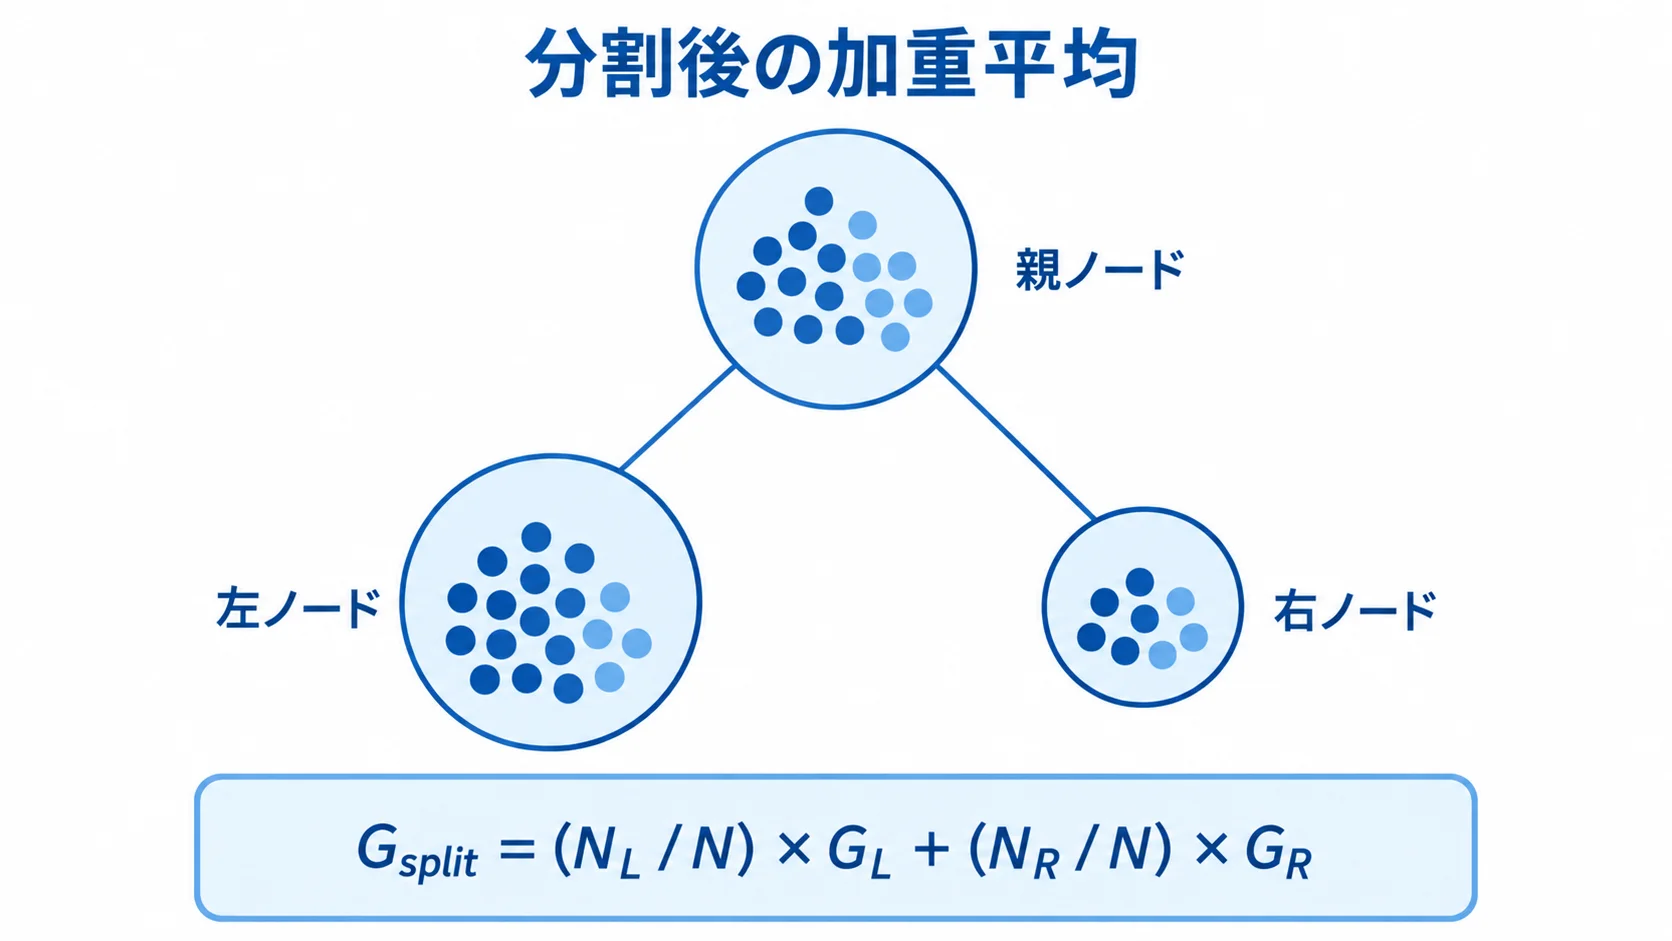
決定木は、特徴量としきい値の候補を試し、分割後の子ノードの不純度が小さくなる条件を選びます。親ノードのサンプル数を N とします。
左右の子ノードのサンプル数を N_L、N_R、それぞれのジニ不純度を G_L、G_R とします。このとき、分割後の評価値は次の加重平均になります。
G_split = (N_L / N) × G_L + (N_R / N) × G_R子ノードの一方が極端に小さい場合は、そのノードの不純度が低くても全体への影響は小さくなります。一方で、大きな子ノードの不純度が高いままだと、分割後の値はあまり改善しません。
学習アルゴリズムは、候補の中からこの値を最小にする分割を選びます。なお、親ノードとの差は、不純度減少や情報利得として扱います。
簡単な分割例
親ノードにクラスAが6件、クラスBが4件あるとします。このとき親のジニ不純度は 1-(0.6²+0.4²)=0.48 です。
分割後は、左ノードがA5件・B0件、右ノードがA1件・B4件になったとします。左の不純度は0で、右は 1-(0.2²+0.8²)=0.32 です。
子ノードの加重平均は 0.5×0+0.5×0.32=0.16 になります。親ノードの0.48と比べると、この分割でクラスの混在が減っています。
ジニ不純度とエントロピーの違い|分類木の分割基準の比較
エントロピーも、ノード内のクラスの混ざり具合を測る指標です。情報理論に基づいており、クラス割合を p_k とすると、式は -Σ p_k log(p_k) になります。
どちらの指標も、一つのクラスに集中すると0になり、クラスが均等に混ざるほど大きくなります。決定木の実装には、ジニ不純度またはエントロピーを使えるものがあります。
ジニ不純度は平方計算だけで求まるため、計算が比較的単純です。一方、エントロピーは対数を使い、混在の変化を異なる形で評価します。
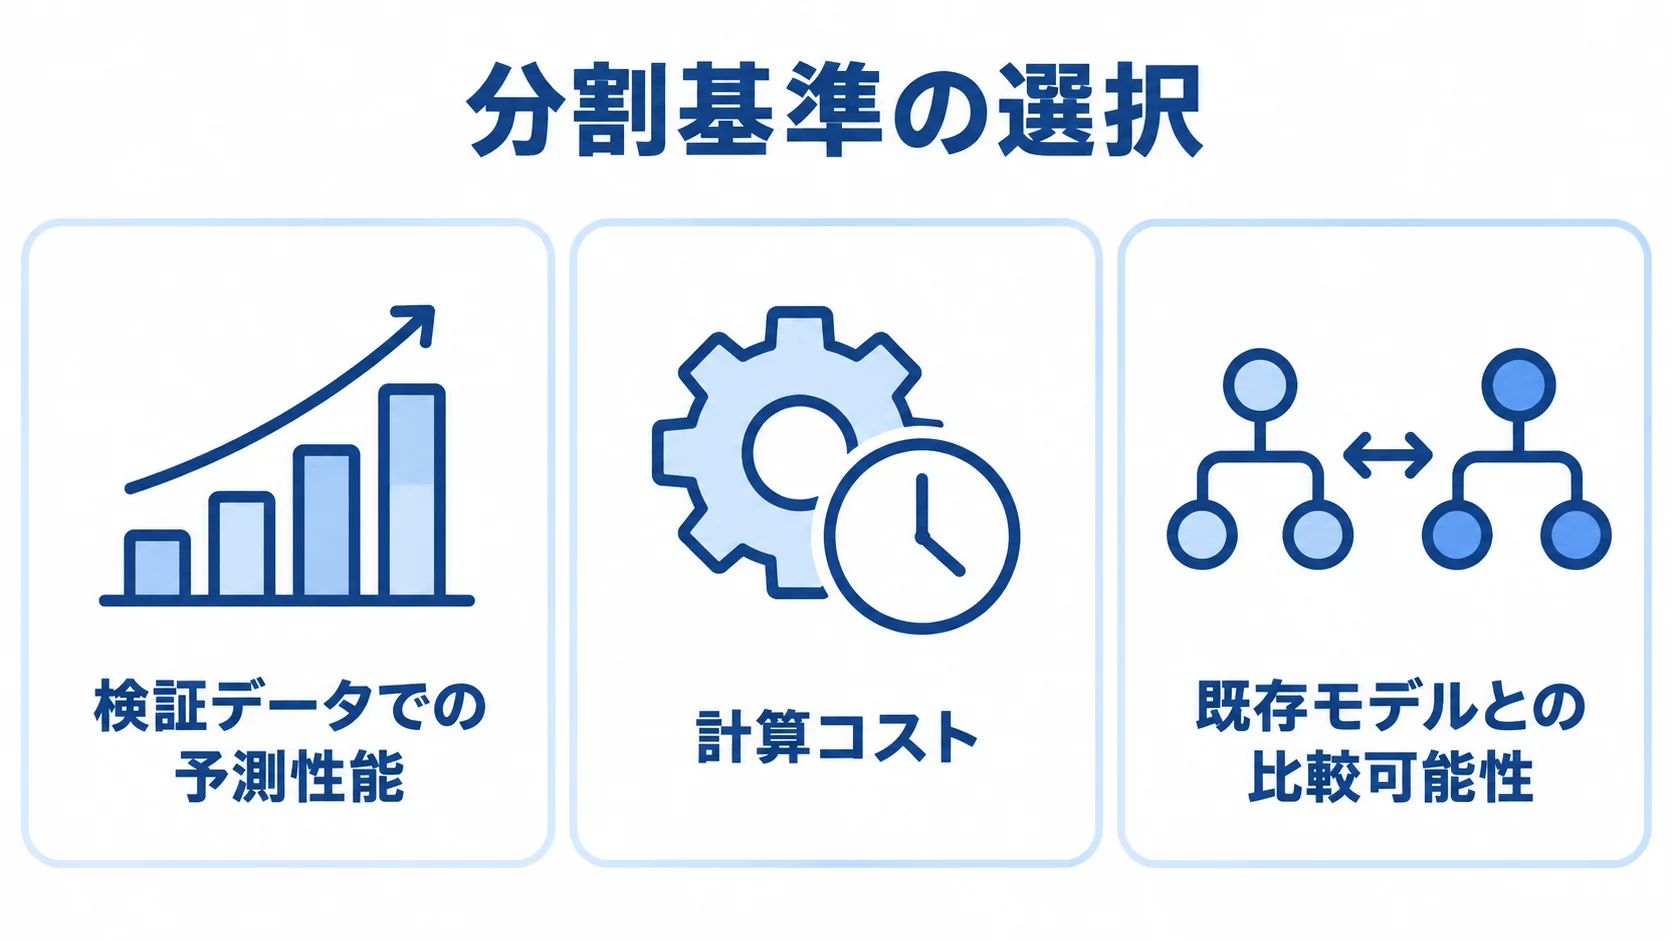
どちらの基準を使うかで最良の分割が入れ替わることはありますが、多くの実務データでは予測性能に大きな差が出ない場合もあります。基準を選ぶときは、次の3点を比べます。
- 検証結果:検証データでの予測性能の差
- 計算コスト:指標ごとの計算負荷の差
- 比較可能性:既存モデルとの比較条件がそろうかどうか
実装のパラメータによる指定
分類木の分割基準は、DecisionTreeClassifierのcriterionで次のように指定します。
criterion="gini":ジニ不純度を分割基準とする設定です。criterion="entropy"とcriterion="log_loss":情報量に基づく基準の設定です。
指定できる値は、ライブラリのバージョンによって異なる場合があります。そのため、使っている環境の公式ドキュメントで確認してください。
基準を変えて比べるときは、木の深さ、乱数、剪定条件などほかの設定を固定して、基準の差だけが結果に出るようにします。
ジニ不純度と過学習|木を深くしすぎないための制御
ジニ不純度を下げる分割を繰り返すと、訓練データに対して非常に純粋な小さなノードを作れます。ただし、サンプルの少ないノードまで分割すると、偶然のパターンを覚えてしまうことがあります。
その結果、未知のデータで誤りやすくなる過学習が起きます。これを抑えるには、max_depth、min_samples_split、min_samples_leaf などの制約を使います。
交差検証を使えば、木の深さと汎化性能のバランスを確かめられます。また、クラス不均衡の場合は、不純度を下げることだけを狙うと、多数派クラスをよく分ける木になることがあります。
これには、class_weight の設定、評価指標の見直し、少数クラスの再現率の確認を組み合わせます。学習時に重みを付けると分割評価にも影響するため、重みの意味と検証方法を記録しておいてください。
ジニ不純度から特徴量重要度を読むときの注意点
決定木やランダムフォレストでは、各分割による不純度の減少を合計して、特徴量重要度を計算できます。この不純度ベースの重要度は、MDIとも呼ばれます。
MDIは、木がどの特徴量を分割に使ったかを要約した値です。ただし、取りうる値の種類が多い連続特徴量や、カテゴリ数の多い特徴量は過大評価しやすい性質があります。
重要度が高くても、その特徴量が原因だとは限りません。相関した特徴量があると、重要度が分散したり片方に偏ったりします。
モデルを説明する目的であれば、検証データでのPermutation Importanceや、必要に応じてSHAPなど別の方法も併せて比べます。
重要度の算出に評価データを使う場合は、テストデータを繰り返し見て特徴量を選ばないようにします。
Permutation Importanceとの違い
Permutation Importanceは、検証データの特徴量をシャッフルして、予測性能がどれだけ悪化するかを測る方法です。モデルの汎化性能への寄与を見やすいという点が特徴です。
相関した特徴量の一方をシャッフルしても、代わりの特徴量が残るため、性能があまり落ちないことがあります。MDIと結果が食い違うときは、相関、特徴量の種類、評価データのサイズを調べます。
ジニ不純度を実務で確認する手順
1. クラス定義と分割単位の固定
各クラスの意味、判定期限、除外条件は文書にまとめておきます。同じ顧客や案件のレコードが複数ある場合は、学習データとテストデータにまたがらないよう、グループ単位で分けることを検討します。
時系列データでは、未来のラベル情報が過去の特徴量に入り込まないよう、予測時点を先に決めておきます。分割単位が曖昧なままだと、実運用で同じ結果を再現できません。
2. ベースラインと交差検証の用意
まず、多数派クラスを常に予測するベースラインを作ります。次に、決定木がどれだけ改善したかを確認します。評価には、accuracyだけでなく、少数クラスの再現率や混同行列も使います。
木の深さや分割基準は、訓練データの中で交差検証を行って比べます。一方で、最終的なテストデータは一度だけ評価します。
3. 木の構造と葉のサンプル数の確認
学習後は、木の構造と葉のサンプル数を確認して、過学習の有無や汎化性能を見極めます。
- ノードを可視化:分岐の条件や予測クラスを、クラス割合・サンプル数とあわせて表示します。
- 葉の汎化を確認:サンプルが数件だけの深い葉は、不純度が0でも未知データで正しく分類できるとは限りません。
- 指標を比較:訓練データと検証データの値を並べ、木を深くしたときに検証側の性能が落ちていないかを見ます。
from sklearn.tree import DecisionTreeClassifier

clf = DecisionTreeClassifier(criterion="gini", max_depth=4, random_state=42)
clf.fit(X_train, y_train)
print(clf.feature_importances_)上の例は、ジニ不純度を分割基準に指定する最小限のコードです。feature_importances_ で得られるのは不純度ベースの重要度で、因果効果や予測の安定性を直接示すものではありません。
再サンプリングした学習データや別の時期のデータで重要度が大きく変わる場合は、特徴量を採用する判断を保留します。そのうえで、Permutation Importanceや外部の知識も併せて検討します。
ジニ不純度の限界|数値を単独で解釈する際の注意
ジニ不純度は、ノード内のラベル分布を要約する値です。特徴量と目的変数の因果関係までは表しません。ラベルに誤りがあれば、純度の高い木でも実運用で失敗します。
学習時に将来の情報が混ざる場合や、カテゴリを数値として誤って扱う場合も、実運用での失敗につながります。そのため、データの生成過程と前処理を監査し、テストデータの独立性を守ります。
また、ジニ不純度はクラス数、クラス割合、サンプル重みに依存します。異なるデータセットで「0.2」と出ても同じ意味とはみなさず、同じクラス定義と評価条件をそろえて比べます。
ランダムフォレストでは、多数の木の平均的な重要度になります。そのため、単一の木の分割理由と、アンサンブル全体の重要度を分けて説明してください。
ジニ不純度のまとめ|分割の良さとモデル説明の切り分け
ジニ不純度は、決定木のノードにクラスがどれだけ混在しているかを測る指標です。計算式は 1-Σp_k² で、決定木は分割後の子ノードの加重平均が小さくなる条件を選びます。
値が0に近いノードは、クラスがそろっています。ただし、サンプル数の少ない純粋な葉は、過学習につながる可能性もあります。エントロピーを使った場合の結果とも比べながら、木の深さや葉の最小サンプル数を交差検証で調整してください。
特徴量重要度を読むときは、不純度ベースの偏りや相関、データリークの有無を確かめます。そのうえで、Permutation Importanceや混同行列を併用します。
ジニ不純度を「精度」や「原因」と混同しないよう、分割基準と説明手法は別々に評価します。
よくある質問(FAQ)
Q. ジニ不純度とは何ですか?
ジニ不純度は、決定木のノード内で異なるクラスがどれだけ混ざっているかを表す指標です。値が0に近いほど、一つのクラスにそろっています。
Q. ジニ不純度が0ならモデルは正しいですか?
いいえ。学習データの小さな葉で不純度が0になっても、未知データで正しく分類できるとは限りません。そのため、木の深さ、葉のサンプル数、検証データでの性能を確かめます。
Q. ジニ不純度とエントロピーはどちらが優れていますか?
一律の優劣はありません。どちらもクラスの混在を測りますが、計算式は異なります。木の深さや乱数などの設定をそろえたうえで、検証データの性能と計算コストで選びます。
Q. ジニ不純度による特徴量重要度は因果関係を示しますか?
示しません。不純度ベースの重要度は、分割による予測上の寄与を要約した値で、相関やカテゴリ数の影響を受けます。因果効果とは解釈せず、Permutation Importanceなども比べます。
Q. クラス不均衡ではジニ不純度に注意が必要ですか?
必要です。多数派クラス中心の分割になりやすいため、クラスごとの再現率や混同行列を確かめます。必要に応じて、class_weightやサンプリングも検討します。
参考資料
本文で扱った実装と決定木について参照した資料のパスは、modules/generated/sklearn.tree.DecisionTreeClassifier.html と modules/tree.html です。
特徴量重要度について参照した資料のパスは、auto_examples/inspection/plot_permutation_importance.html です。
- scikit-learn「DecisionTreeClassifier」
- scikit-learn User Guide「Decision Trees」
- scikit-learn User Guide「Feature importance evaluation」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。