
GraphQLの導入事例で知りたいのは、どんな企業がどんな課題を解決するために採用し、どんな成果と苦労があったかです。事例に絞り、発注企業の視点で掘り下げると、その答えは実名の事業会社の運用事例に表れています。
全体像は、まずGraphQL開発の完全ガイドでご確認ください。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
enechain社のGraphQL運用に学ぶ成功の型
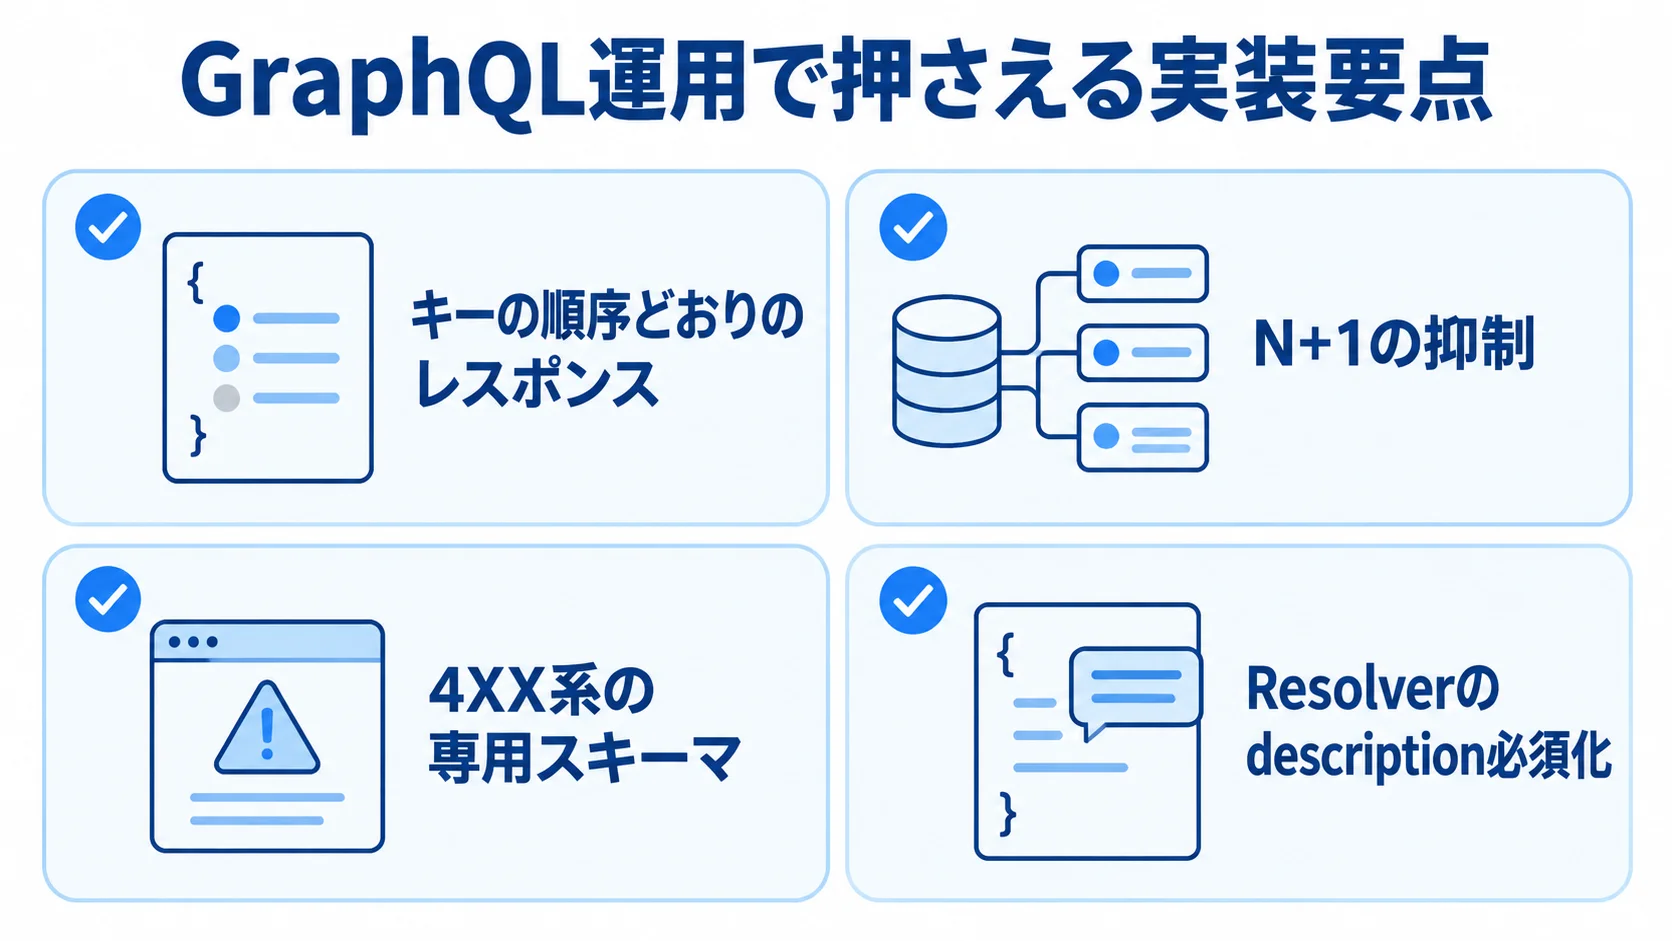
GraphQLの導入事例として、もっとも参考になるのがエネルギー取引プラットフォームを運営するenechain(エネチェーン)社の運用知見です(出典:enechain Tech Blog)。
同社はGraphQLを実際に運用するなかで直面した固有の課題と、その具体的な解決策を技術ブログで公開しています。これからGraphQLを採用する企業にとって、貴重な実例といえます。
特に、華やかな採用宣言ではなく運用の細部まで踏み込んだ知見である点が、発注判断に直結する価値を持ちます。
Dataloaderのキー順序制約とN+1問題への対処
GraphQLでもっとも有名な落とし穴が「N+1問題」です。一覧データを取得したあと、その各要素に紐づく関連データを一件ずつ個別に問い合わせてしまい、データベースへのアクセスが爆発的に増える現象を指します。
たとえば10件の注文を取得し、それぞれの顧客情報を個別に取得すると、1回+10回で合計11回のクエリが発行されます。これは、GraphQLの柔軟さの裏にある代表的な性能課題です。
この問題の標準的な解決策が「Dataloader」と呼ばれる仕組みで、複数の問い合わせを一括(バッチ)にまとめて発行することで、アクセス回数を削減します。ただし、enechain社の事例で示唆に富むのは、このDataloaderに「リクエストされたキーの順序どおりにレスポンスを返さなければならない」という制約がある点です。
データベースから取得した結果は、必ずしも要求した順序と一致しません。そのため、開発者が明示的に並べ替えを実装しないと、まったく別のデータが紐づくという深刻なバグを生みます。
Dataloaderを使う開発では、キーの順序を守る実装と、N+1を抑える設計の両方を見ておく必要があります。
- 並べ替えの実装:キーの順序どおりにレスポンスを返すための処理
- N+1の抑制:一覧の件数が増えても、クエリ数が膨らまない設計
この知見が発注企業にとって重要なのは、「GraphQLを入れればN+1が自動的に解決する」という誤解を正してくれるからです。Dataloaderを正しく実装するには相応の技術力が必要で、それを怠れば、性能問題やデータ不整合といったより厄介なトラブルを抱え込みます。
GraphQL採用を提案するベンダーが、こうした運用上の落とし穴まで理解しているかは、選定時の見極めポイントになります。
4XX専用スキーマとESLintによる規約強制
enechain社のもう一つの優れた工夫が、エラーハンドリングの設計です。エラーの性質に応じて表現方法を変えることで、開発者体験と堅牢性を両立させています。
同社は、エラーを4XX系と5XX系に分けて、それぞれ別の扱いにしています。
- 4XX系のエラー:クライアント側の入力ミスなどに起因するため、専用のスキーマとして型定義し、クライアントが型補完を効かせて処理できるようにする
- 5XX系のエラー:サーバー内部の障害で、GraphQLのSpec(仕様)どおりに扱う使い分け
さらに注目すべきは、Resolver(各フィールドのデータ取得処理)の「description(説明文)」を必ず記述するルールを、ESLintプラグインで機械的に強制している点です。GraphQLのスキーマは仕様書を兼ねるため、説明文が充実していればフロントエンド開発者が自己解決でき、コミュニケーションコストが下がります。
しかし、説明文の記述は人の善意に任せると形骸化しがちです。そこで、これをLintツールで必須化することで書く人による差をなくし、ドキュメントとしての品質を組織的に担保しています。
これらの事例からは、GraphQLの成功が「導入の判断」よりも「運用ルールの設計と強制」にかかっていることが分かります。
スキーマ駆動開発の強みを活かすには、規約をツールで自動チェックする文化が欠かせません。発注企業としては、こうした運用設計まで含めて提案できるパートナーかどうかを見極める必要があります。
あえてRESTを選んだBotoi社の逆張り事例
GraphQLの事例を学ぶうえで、「GraphQLを採用しなかった事例」も同じくらい大切です。GraphQLが万能ではないことを、実名の判断が示してくれるからです。
150以上のエンドポイントを抱えながら、あえてRESTを選んだBotoi社の判断を見ていきます(出典:Botoi)。この逆張りとも言える選択の理由を理解すると、自社がGraphQLを採用すべきかどうかの判断軸が見えてきます。
キャッシュ最重視でRESTとCDNを選んだ理由
Botoi社は、自社サービスで多数のエンドポイントを運用していますが、API設計としてGraphQLではなくRESTを採用しました。その最大の理由が「キャッシュ可能性の最重視」です。
RESTはURLごとにリソースが一意に定まるため、CDN(コンテンツ配信網)やHTTPキャッシュとの相性が抜群に良いのです。さらに、同じデータへのリクエストは、キャッシュから即座に返せます。
Botoi社はこのCDNキャッシュを活用し、レスポンスを20ms未満という高速なレベルで実現しています。
一方、GraphQLはすべてのリクエストを単一のエンドポイント(多くはPOSTメソッド)に送る構造です。そのため、URL単位の標準的なHTTPキャッシュが効きにくいという弱点があります。
クエリ内容ごとにキャッシュを管理する独自の仕組みを構築すれば対応できますが、その分だけ運用は複雑になります。コンテンツ配信が中心で、同じデータを大量のユーザーに高速に返すことが最優先の要件であれば、RESTとCDNの組み合わせが理にかなっています。
判断するときは、次のような点が手がかりになります。
- 最優先の要件:キャッシュ可能性を第一に置けるかどうか
- 運用の負担:クエリごとのキャッシュ管理を引き受けられる体制
参考として、APIプロトコルごとのレイテンシ目安は、REST 50〜200ms、GraphQL 50〜300ms、gRPC 10〜50msとされています。Botoi社が達成した20ms未満は、キャッシュを効かせた結果であり、プロトコル単体の数値ではありません。
ここから分かるのは、「速さ」は採用するプロトコルだけで決まらず、キャッシュ戦略やアーキテクチャ全体で決まるということです。GraphQLを選ぶ前に、自社の最優先要件がキャッシュ可能性なのかを問い直す価値があります。
事例から逆算するGraphQLが向く場面
enechain社の採用とBotoi社の非採用を並べて見ると、GraphQLが向く場面の輪郭がはっきりしてきます。GraphQLが真価を発揮するのは、Web・iOS・Androidといった複数の異なるクライアントが、それぞれ少しずつ異なるデータの組み合わせを必要とする、BFF(Backend For Frontend)的な状況です。
RESTで各クライアント専用のエンドポイントを乱立させるより、GraphQLで一つのスキーマから必要なデータだけを取得させるほうが、オーバーフェッチもアンダーフェッチも避けられます。
GraphQLとRESTやgRPCは、向いている場面がそれぞれ異なります。
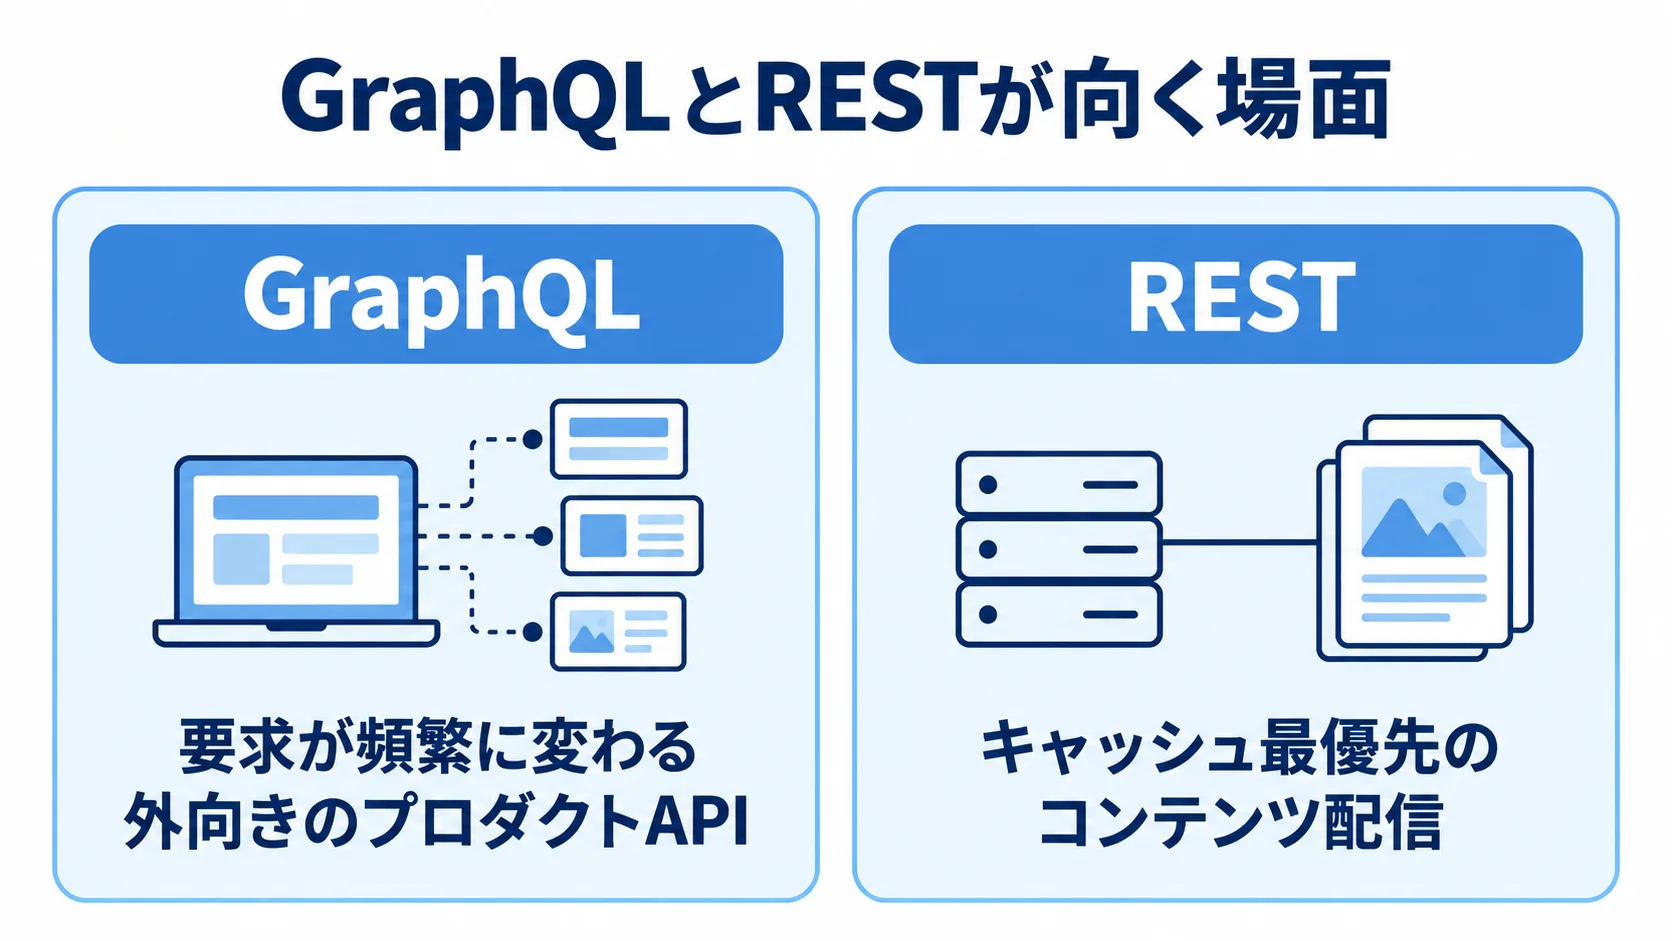
- GraphQLが向く場面:クライアントが多様で、要求が頻繁に変わる外向きのプロダクトAPI
- RESTやgRPCが向く場面:キャッシュ最優先のコンテンツ配信(REST)、マイクロサービス間の高速な内部通信(gRPC)
GraphQLの柔軟さが最も活きるのは、要求が次々に変わる外向きのプロダクトAPIの場面です。事例を通じて自社のユースケースをこの軸に当てはめれば、流行に流されない技術選定ができます。
riplaがフルスクラッチ受託でAPI設計を選ぶときも、まず「クライアントの数と多様性」「キャッシュ要件」「内部通信か外部公開か」の軸で要件を整理します。事例が示す適材適所の原則に立ち返れば、GraphQLありきの選定を避け、後悔しない選択につなげられます。
GraphQLセキュリティとML検知の研究事例
GraphQLの活用事例を語るうえで、セキュリティは避けて通れない観点です。GraphQLは柔軟である分、悪意あるクエリによる攻撃面も広がります。
機械学習でGraphQLのセキュリティを守ろうとする学術研究から、発注企業が押さえておくべき現実的な示唆を読み取ります(出典:arXiv)。最先端の研究だからこそ見える「効果」と「限界」の両面は、技術選定を冷静に判断する材料になります。
SQLi・XSS検知の高精度とその実態
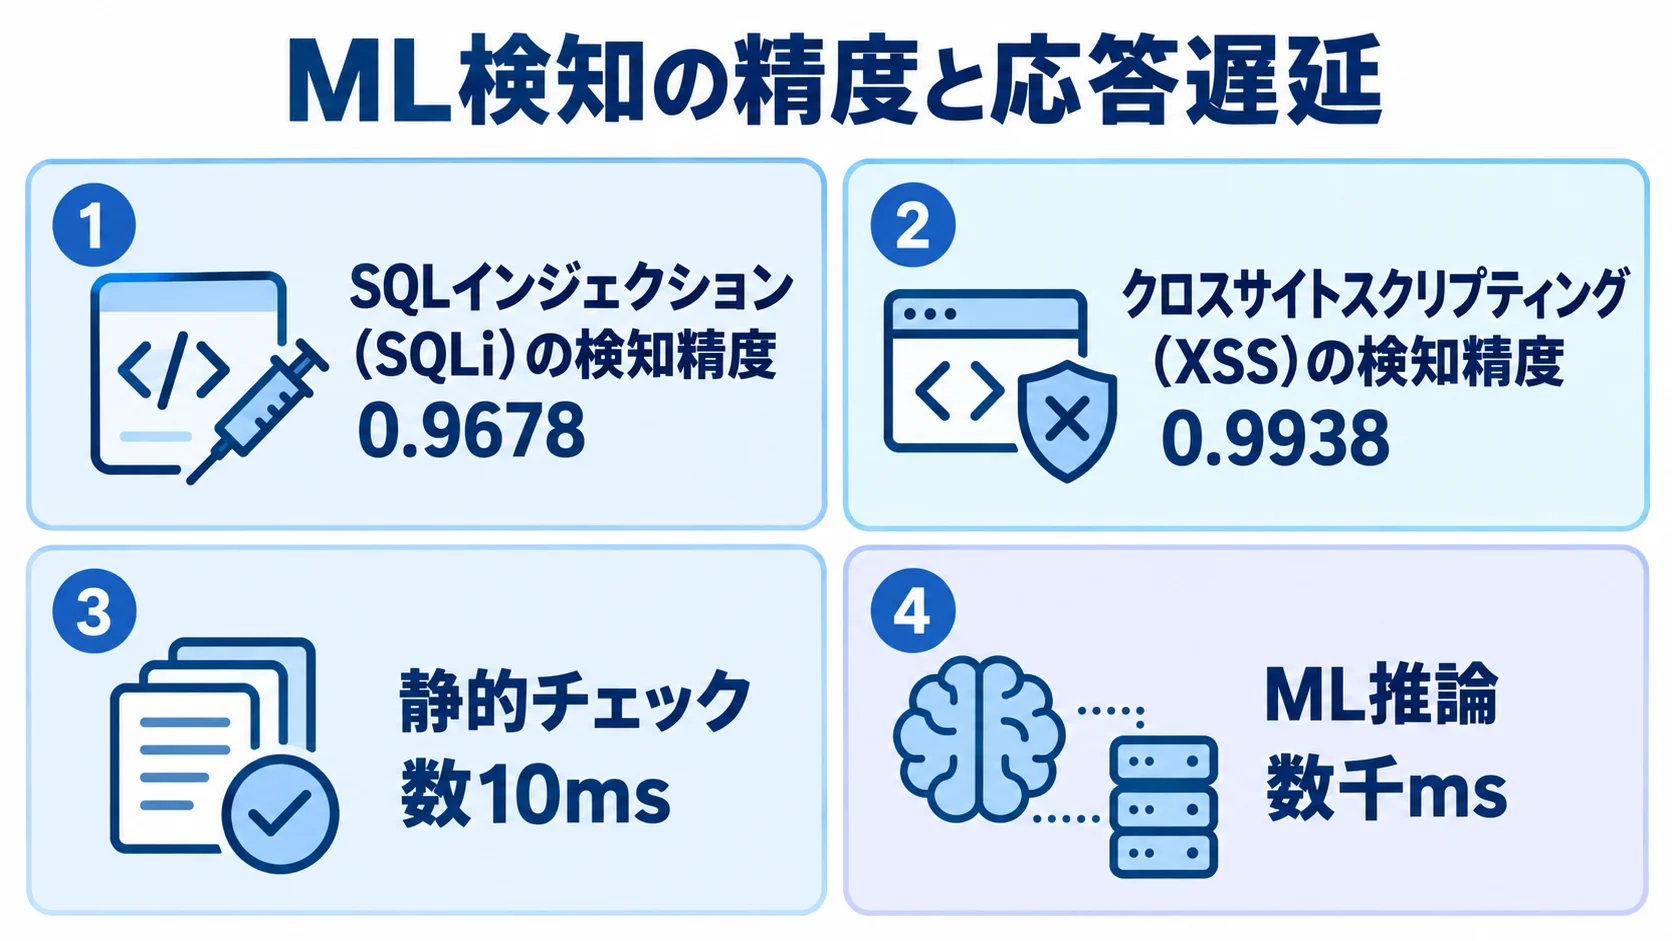
GraphQLへの攻撃検知に機械学習を応用した研究では、印象的な精度が報告されています。SQLインジェクション(SQLi)の検知ではAccuracy(正解率)が0.9678でした。
さらに、クロスサイトスクリプティング(XSS)の検知ではRandom Forestを用いて、Accuracy 0.9938という高い数値が示されています。これだけ見ると、機械学習による検知はほぼ完璧に近い精度で悪意あるクエリを見抜けるように思えます。
この研究では、LLM(大規模言語モデル)やSBERT、CNN(畳み込みニューラルネットワーク)といった手法を組み合わせ、GraphQLクエリの意味を理解したうえで悪意の有無を判定しています。
従来のパターンマッチング型のフィルタでは見逃しがちな、巧妙に偽装された攻撃クエリも検知できる点に、このアプローチの強みがあります。GraphQLの柔軟なクエリ構造を逆手に取った攻撃に対して、有望な防御策といえます。
この研究は、検知の仕組みと、精度の裏にある応答遅延の2点から見ておく必要があります。
- 検知の仕組み:クエリの意味を理解し、悪意の有無を判定する
- 精度と性能:高い精度の裏にある、応答遅延の問題
ただし、高い精度の数字だけを見て「これを入れれば安全」と早合点するのは禁物です。次に述べるとおり、この高精度には現実的な運用上のトレードオフが伴います。そのため発注企業は、セキュリティ製品の宣伝で示される精度の数字を鵜呑みにせず、運用時のコストまで含めて評価する姿勢が求められます。
ML推論が招くレイテンシのボトルネック
この研究が示すもっとも重要な示唆は、高精度の裏にあるレイテンシ(応答遅延)の問題です。従来の静的チェックのみであれば数10msで完了する応答が、機械学習による推論を挟むと数千msにまで跳ね上がるというボトルネックが報告されています。
この事実は、GraphQLのセキュリティを語るうえで極めて実務的な教訓を含んでいます。つまり、検知精度を追求すると、応答速度が100倍規模で悪化しかねません。ユーザー体験を重視するサービスにとって、これは無視できないトレードオフです。
この教訓を実務に当てはめるなら、ML推論の使い方と静的チェックとの組み合わせを考えることになります。
- ML推論の適用範囲:すべてのクエリに当てると性能が破綻するため、リスクの高い経路に限定
- 静的チェックとの併用:従来の静的チェックとの組み合わせによる検査
最新技術の華々しい精度の数字と、実運用でのレイテンシ要件は、慎重に天秤にかける必要があります。発注企業がここから学ぶべきは、「セキュリティと性能はしばしばトレードオフの関係にある」という原則です。
GraphQLのDoS対策やインジェクション対策を提案するベンダーが、このレイテンシ問題を理解したうえで現実的な落としどころを示せるかどうかは、技術力を見極める格好の試金石になります。riplaも、セキュリティ施策を性能とのバランスのなかで設計することを重視しています。
まとめ
GraphQLの活用事例を振り返ると、成功も非採用の判断も、結局は「事業要件から逆算してAPI設計を適材適所で選ぶ」という一点に集約されます。
enechain社の運用事例は、Dataloaderのキー順序制約への対処や、4XX専用スキーマと5XXのSpec準拠の使い分けを示しています。また、ESLintでResolverのdescriptionを必須化するという運用ルールの設計こそが成功の鍵であることを教えてくれます。GraphQLの強みは、導入の瞬間ではなく地道な運用設計から生まれるのです。
一方、Botoi社があえてRESTとCDNを選び20ms未満を達成した事例は、GraphQLが万能ではないことを示します。さらに、arXivの研究が示すML検知の数千msのボトルネックは、セキュリティと性能のトレードオフという現実を突きつけます。
自社のユースケースがGraphQL向きかを冷静に見極め、採用するなら運用ルールまで設計する一歩を踏み出してください。riplaはフルスクラッチ受託と国内開発を組み合わせ、事業から逆算したAPI設計と体制づくりを一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。