
GraphQLは「次世代のAPI」として華々しく語られる一方で、安易な導入が深刻な失敗を招くケースが後を絶ちません。GraphQL開発・導入の失敗は、過剰な技術選定、性能と安全の問題、全面リプレイスの落とし穴に大きく分けられます。
「RESTより優れている」という宣伝文句を鵜呑みにすると、キャッシュが効かず性能が出ない、N+1問題で負荷が集中する、運用が複雑化して保守できる人がいなくなるといった失敗を招きます。全体像はGraphQL開発の完全ガイドで確認できます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
過剰な技術選定という最大の失敗パターン
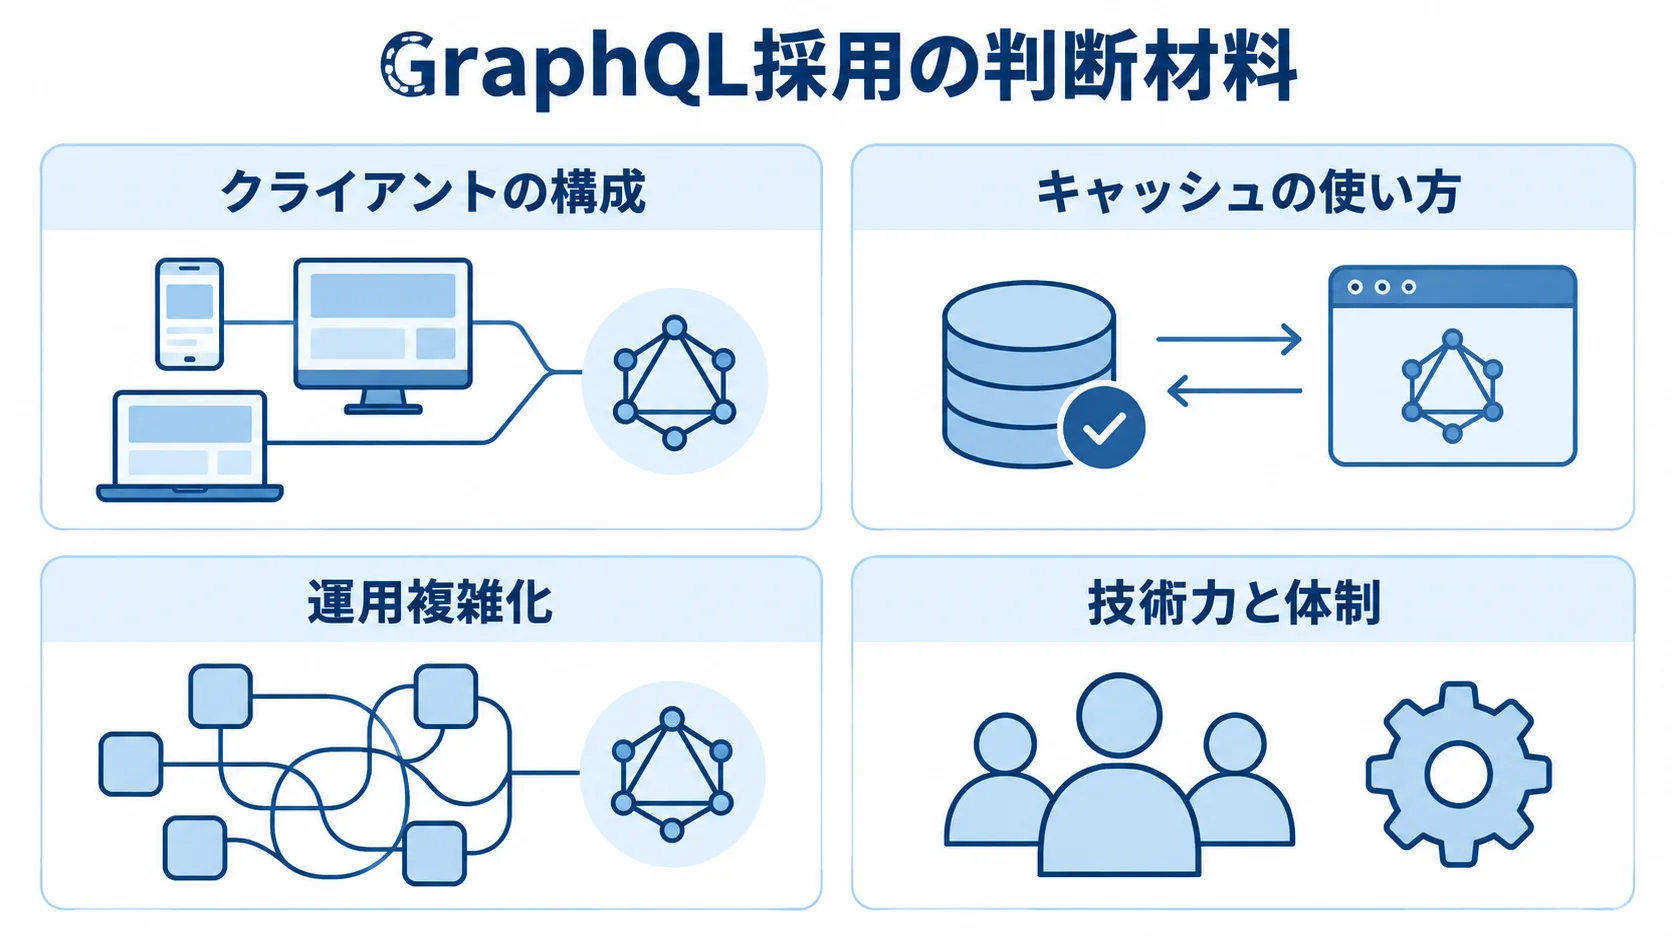
GraphQL導入でもっとも根深い失敗は、技術的なミスではなく「選定の誤り」です。本来GraphQLが不要な場面で、流行や「モダンだから」という理由で採用すると、メリットを得られないままデメリットだけを抱えることになります。これが、過剰な技術選定という最大の失敗パターンです。
クライアントが単一なのに採用する失敗
GraphQLのメリットが活きるのは、Web・iOS・Androidなど複数の異なるクライアントが、それぞれ少しずつ違うデータを必要とする場面です。ところが、単一のWebアプリしかないのにGraphQLを採用する失敗が頻発しています。
クライアントが一つしかなければ、RESTで専用のエンドポイントを用意すれば十分で、GraphQLの柔軟さは過剰になります。この失敗が深刻なのは、メリットがないままデメリットだけを引き受けてしまう点です。
たとえば、GraphQLは単一エンドポイントにPOSTで送る構造のため、RESTなら簡単に効くCDNやHTTPキャッシュが効きにくくなります。Botoi社は、150以上のエンドポイントを抱えながらキャッシュを最重視してRESTを選び、CDNで20ms未満を達成しました。不要なGraphQLの採用は、こうしたキャッシュという武器を自ら手放すことになります(出典:Botoi)。
採用の判断で確かめたいのは、次の2点です。
- クライアントの構成:Web、iOS、Androidなどの種類と、画面ごとに必要なデータの違い
- キャッシュの使い方:CDNやHTTPキャッシュで配信できる内容がどれだけあるか
発注企業がこの失敗を避けるには、「自社のクライアントは本当に多様か」を冷静に問うことです。
提案されたGraphQLが、技術トレンドへの追随ではなく、自社のクライアント構成に基づいているかを確かめるべきです。
クライアントが単一なら、GraphQLを採用しないことが最大のリスク回避策になります。流行に流されず採用を見送れるかどうかが、失敗を分けます。
運用複雑化が招く技術的負債
過剰な技術選定がもたらすもう一つの失敗が、運用複雑化という技術的負債です。GraphQLを実用レベルで運用するには、継続的な運用ルールを整備し、手をかけ続けることが欠かせません。
enechain社は、Resolverのdescription必須化をESLintで機械的に強制しています。これは相応の技術力と運用文化があって初めて成り立つものです(出典:enechain Tech Blog)。
導入時の華やかさの裏で、運用フェーズに重い負担がのしかかります。運用体制が整わない組織がGraphQLを採用すると、スキーマは荒れ、N+1対策は漏れ、保守できる人がいなくなるという負のスパイラルに陥ります。
メリットだったはずの生産性向上は失われ、複雑なだけで誰も触れないシステムが残ります。これはまさに、過剰な技術選定が技術的負債に転じる典型例です。
- N+1対策:Dataloaderによる一覧取得の最適化を、運用の中で保ち続けること
- スキーマ規約:規約を機械的に守らせる仕組みと、エラー設計の使い分け
この失敗を避けるには、GraphQLを「使いこなすための継続的なコスト」を、導入前に見積もることが大切です。
発注企業は、N+1対策やスキーマ規約を継続できる技術力と体制が開発会社にあるか、特定の人に頼らず保守できるかを正直に評価する必要があります。その体制がないなら、シンプルなRESTを選ぶほうが長期的には堅実です。
技術の華やかさより、自社が運用し続けられるかを優先する姿勢が、負債化を防ぎます。
N+1問題とDoSリスクという性能・安全の失敗
採用を決めた後は、技術的な失敗が待ち受けています。GraphQL特有のN+1問題による性能破綻と、柔軟さを逆手に取られるDoSリスクは、対策を怠ると本番環境でサービスを停止させかねない深刻な課題です。
どちらも設計段階で潰しておくべきリスクです。起きる仕組みを知ったうえで、設計に組み込む必要があります。
N+1問題による性能破綻とDataloaderの罠
GraphQLでもっとも有名な失敗が、N+1問題による性能破綻です。一覧データの各要素に関連データを紐づけて取得する際、要素ごとに個別の問い合わせが発行され、データベースへのアクセスが膨らみます。
たとえば10件の一覧なら1+10回、100件なら1+100回と、データ量に比例してクエリが増え、レイテンシが悪化します。GraphQLのレイテンシ目安が50〜300msと、RESTの50〜200msより上限が大きいのは、この非効率が起きやすいことの表れです。
ただし、その対策のDataloaderにも罠があります。enechain社の知見によると、Dataloaderには「リクエストされたキーの順序通りにレスポンスを返さなければならない」という制約があります(出典:enechain Tech Blog)。
データベースから取得した結果は要求順と一致するとは限りません。そのため、開発者が明示的に並べ替えを実装しないと、まったく別のデータが別の要素に紐づいてしまいます。
この失敗は、性能問題より厄介なデータ不整合を引き起こします。Dataloaderを入れたつもりでも、この制約を見落としやすいのです。
防ぐには、次の2点を押さえておく必要があります。
- 設計段階での組み込み:N+1対策とDataloaderの正しい実装を設計に含め、テストで検証すること
- 発行回数の計測:一覧取得でクエリが何回発行され、想定どおりバッチ化されているか
発注企業は、提案や設計レビューの際に「N+1対策をどう講じ、どう検証するか」を必ず問うべきです。
これを曖昧にしたまま進めると、本番でデータベースが悲鳴を上げてから気づくことになります。
柔軟さを逆手に取られるDoSリスク
GraphQLの「クライアントが自由にクエリを組み立てられる」という柔軟さは、セキュリティ面では諸刃の剣です。攻撃者は、深くネストした関連データを再帰的に要求する重いクエリを組み立てられます。
たとえば「ユーザーの友達の友達の友達……」と無限に近い深さで関連を辿るクエリを一つ投げるだけで、サーバーは膨大な処理を強いられ、過負荷で停止しかねません。これがGraphQL固有のDoS(サービス妨害)リスクです。
RESTではエンドポイントが返すデータが固定されているため、こうした任意の重いクエリは原理的に書けません。GraphQLの柔軟さが、そのまま攻撃面の広さに転じるのです。
一見動いていても、悪意あるクエリ一つで簡単に落とされてしまいます。
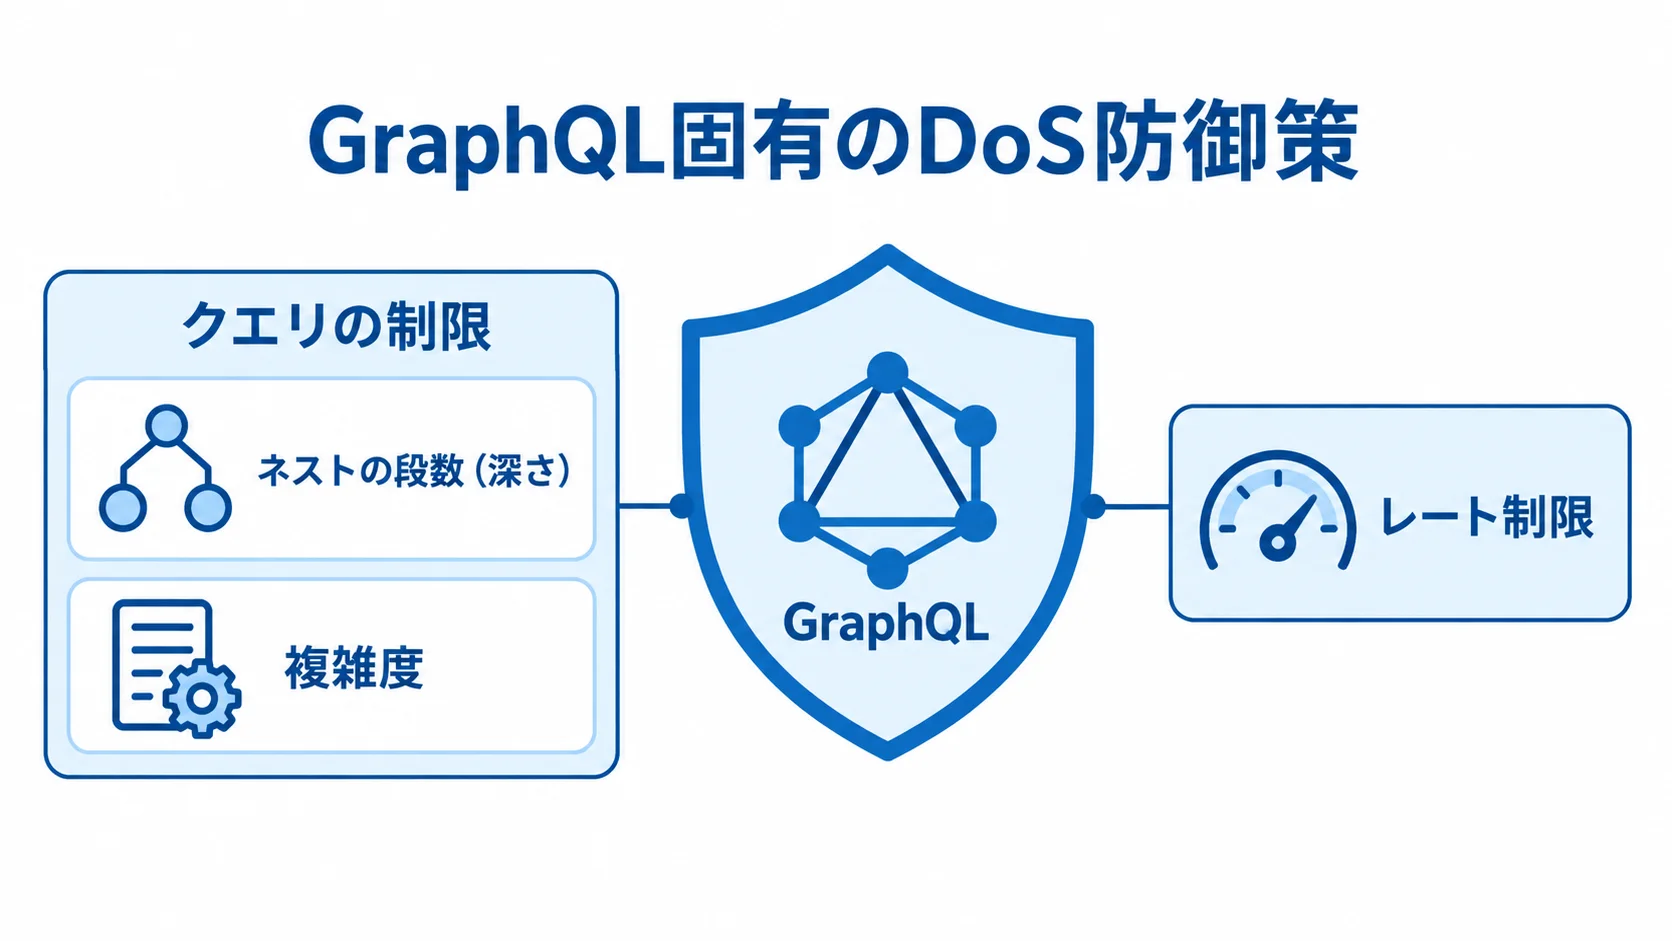
防御策として押さえたいのは、次の2点です。
- クエリの制限:ネストの段数(深さ)と複雑度に上限を設けること
- レート制限:同じ相手からの要求の頻度を抑えること
これらを怠るのは、GraphQL導入における典型的かつ重大な失敗です。発注企業がこのリスクを軽視すると、セキュリティインシデントという最悪の失敗に直結します。
提案書にDoS対策が明記されているかを、必ず確認すべきです。
GraphQLの柔軟さは便利な反面、防御策とセットでなければ、外部公開APIにおいて致命的な脆弱性になり得ることを忘れてはいけません。
セキュリティ対策の罠とリプレイスの落とし穴
DoS対策やインジェクション対策を講じる過程にも、別の失敗が潜んでいます。最新のセキュリティ技術を導入したつもりが、かえって性能を破綻させる罠になります。さらに、既存のRESTからGraphQLへ全面リプレイスする際の落とし穴も見過ごせません。
高精度ML検知が招くレイテンシ破綻
GraphQLのセキュリティを機械学習で守ろうとする研究では、印象的な精度が報告されています。SQLインジェクション検知ではAccuracy 0.9678に達しています。
また、XSS検知ではRandom Forestを用いて、Accuracy 0.9938という高精度を示しています(出典:arXiv)。この数字だけを見て「これを入れれば安全だ」と飛びつくと、思わぬ失敗が待っています。高精度の裏に、重大なレイテンシのボトルネックが潜んでいるからです。
同研究では、静的チェックのみであれば数10msで完了する応答が、機械学習による推論を挟むと数千msにまで跳ね上がると報告されています。すべてのクエリにML推論をかけると、応答速度が100倍規模で悪化し、ユーザー体験が破綻します。
高精度という魅力的な数字に引きずられて全面導入すると、性能という別の失敗を招きます。これは、セキュリティと性能のトレードオフを軽視した典型的な失敗です。
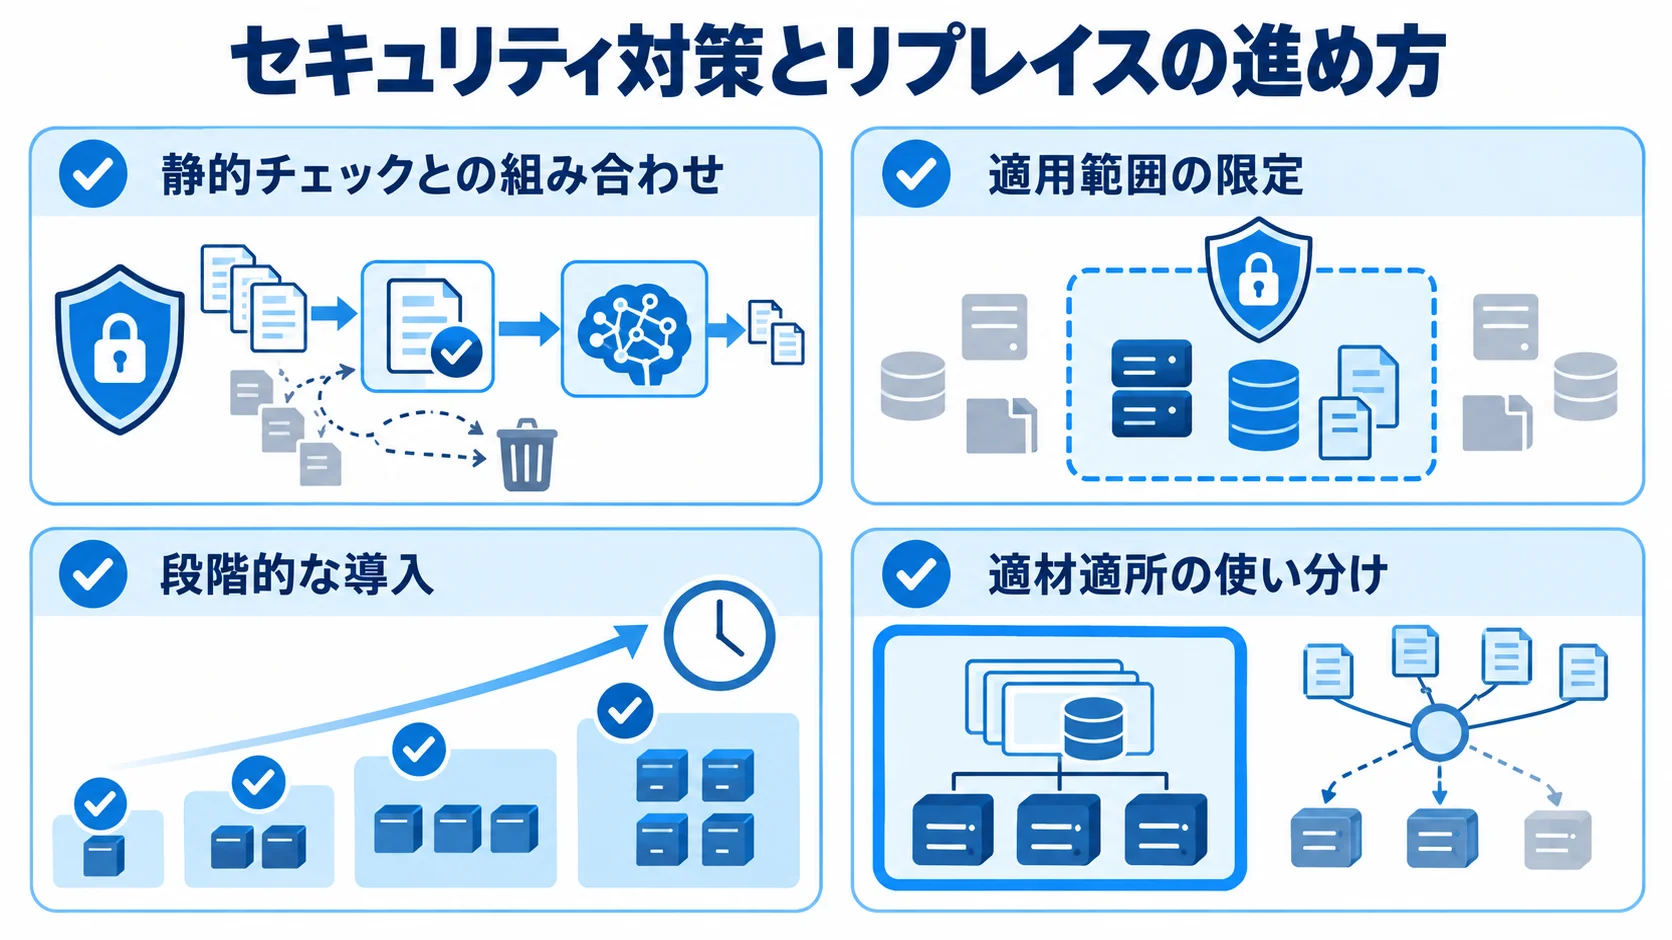
すべてのリクエストをMLで検査するのではなく、次の2つのような現実的な設計が必要です。
- 静的チェックとの組み合わせ:ML推論を、静的チェックと併せて使う設計
- 適用範囲の限定:リスクの高い経路に絞ってML推論を適用する設計
最新技術の精度の数字と、実運用のレイテンシ要件を、慎重に比べる必要があります。セキュリティ対策を提案するベンダーが、このトレードオフを理解して現実的な落としどころを示せるかは、技術力を見極める手がかりになります。
全面リプレイスの二重運用コスト
既存のREST APIからGraphQLへ全面的にリプレイスしようとする際にも、大きな落とし穴があります。
「モダンだから」という理由で安定稼働中のRESTを一気にGraphQLへ作り変えると、移行期間中は新旧両方のシステムを並行運用せざるを得ません。その結果、インフラコストと運用負荷が一時的に倍増します。
マイクロサービス移行では、旧システムと新システムを数年並行運用した事例もあります。このように、移行の二重運用コストは見積もり漏れしやすい隠れたリスクです。
さらに、既存エンジニアがGraphQLに不慣れであれば、再教育の学習コストと、それに伴う一時的な生産性低下も発生します。
RESTで問題なく動いているシステムを、明確な事業目的がないままGraphQLへ全面刷新すれば、相応のコストと新たなバグのリスクを抱え込むことになります。
リプレイスは、事業目的を実現するための手段です。「いつ・どこを・なぜGraphQLにするか」を事業目的から判断しなければ、コストばかりかさむ失敗になります。
この失敗を避ける現実的な進め方は、次の2点です。
- 段階的な導入:複数クライアントへのデータ提供など、メリットが明確に活きる一部の領域から始め、全面リプレイスは避けること
- 適材適所の使い分け:キャッシュ重視の配信はRESTのまま残すこと
こうした使い分けが、移行の隠れたコストとリスクを抑えます。riplaは、フルスクラッチ受託と国内開発の知見をもって、過剰な全面刷新を戒め、事業目的から逆算した段階的な進め方を支援しています。
GraphQLのメリット・デメリットを定量的に比較したい方は、後述の関連記事もあわせてご覧ください。
まとめ
GraphQL導入の失敗を振り返ると、根本原因の多くは「流行に乗った過剰な技術選定」にあります。
クライアントが単一なのに採用してキャッシュという武器を手放すことや、運用体制がないまま導入して技術的負債を抱えることは、導入後の技術的ミス以前に、選定段階で起きる失敗です。
だからこそ「採用しない勇気」が、最大の失敗回避策になります。Botoi社があえてRESTを選び、20ms未満を達成したのは、その好例です。
採用する場合も、N+1問題(Dataloaderのキー順序制約)による性能破綻、柔軟さを逆手に取られるDoSリスク、ML検知の数千msボトルネックといった罠が待ち受けます。また、全面リプレイスの二重運用コストも見落とせません。
これらを設計段階で潰し、段階的に導入を進めることが、失敗を構造的に回避する方法です。過剰な技術的負債を抱えないよう、事業要件から逆算した堅実な判断を心がけてください。riplaは、フルスクラッチ受託と国内開発を組み合わせ、過剰な技術選定を戒める伴走を一貫して提供しています。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。