
階層的クラスタリングは、データ間の距離をもとにクラスタを段階的に結合または分割し、樹形図で階層構造を作る教師なし学習です。結合の過程が木構造として残るため、同じ結果から大分類にも小分類にも切り替えて使えるのが特徴です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
結合過程を木構造で表す仕組み
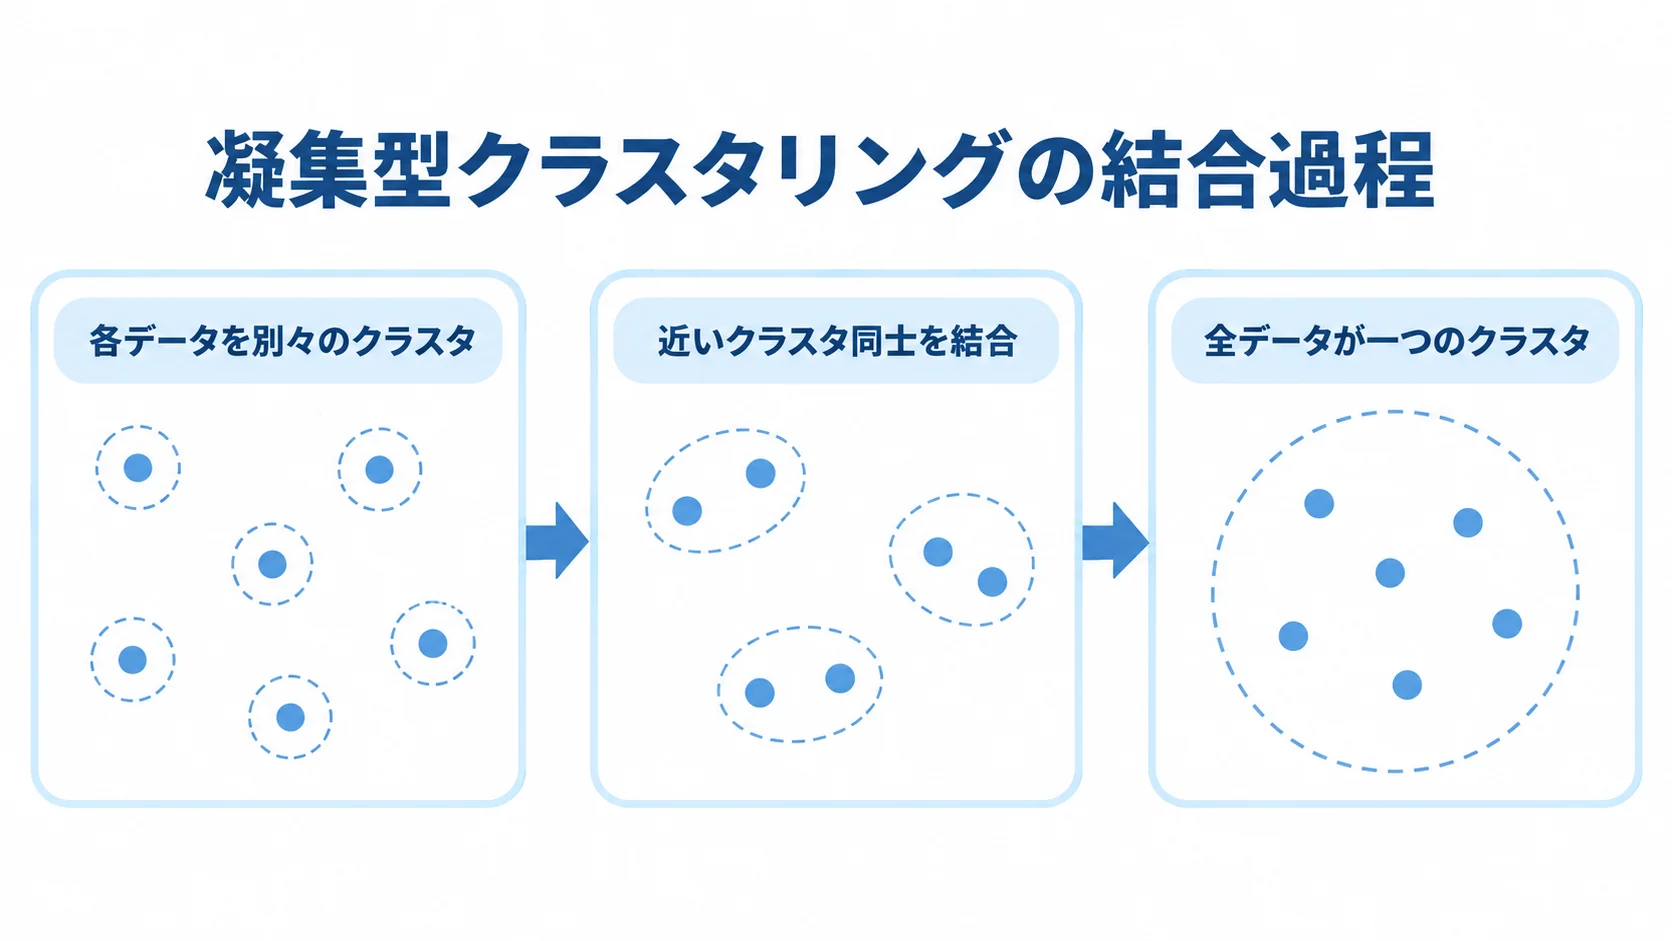
凝集型(agglomerative)では、まず各データを別々のクラスタとして扱い、近いクラスタ同士を順に結合していきます。結合を重ねると、最終的には全データが一つのクラスタにまとまります。
一方、分割型は全体から始めて遠いグループを順に分けていきます。実務では凝集型がよく使われます。
デンドログラムの高さと結合距離
デンドログラムで枝が結合した高さは、その結合に必要だった距離やコストを表します。低い位置で結合したデータ同士は近く、高い位置で枝を切ると大きなグループに分かれます。そこで、樹形図を見ながら業務で扱いやすい粒度を選びます。
linkageによるクラスタ間距離の決め方
scikit-learnのAgglomerativeClusteringでは、データの形と距離の意味に合う結合基準(linkage)を選びます。
- Ward:結合後の分散が小さくなるように結合する方式
- complete:クラスタ間で最も遠いデータ同士の距離
- average:クラスタ間の平均距離
- single:クラスタ間で最も近いデータ同士の距離
基準によって結合の進み方が違い、作られるクラスタも変わります。
距離の選び方と前処理
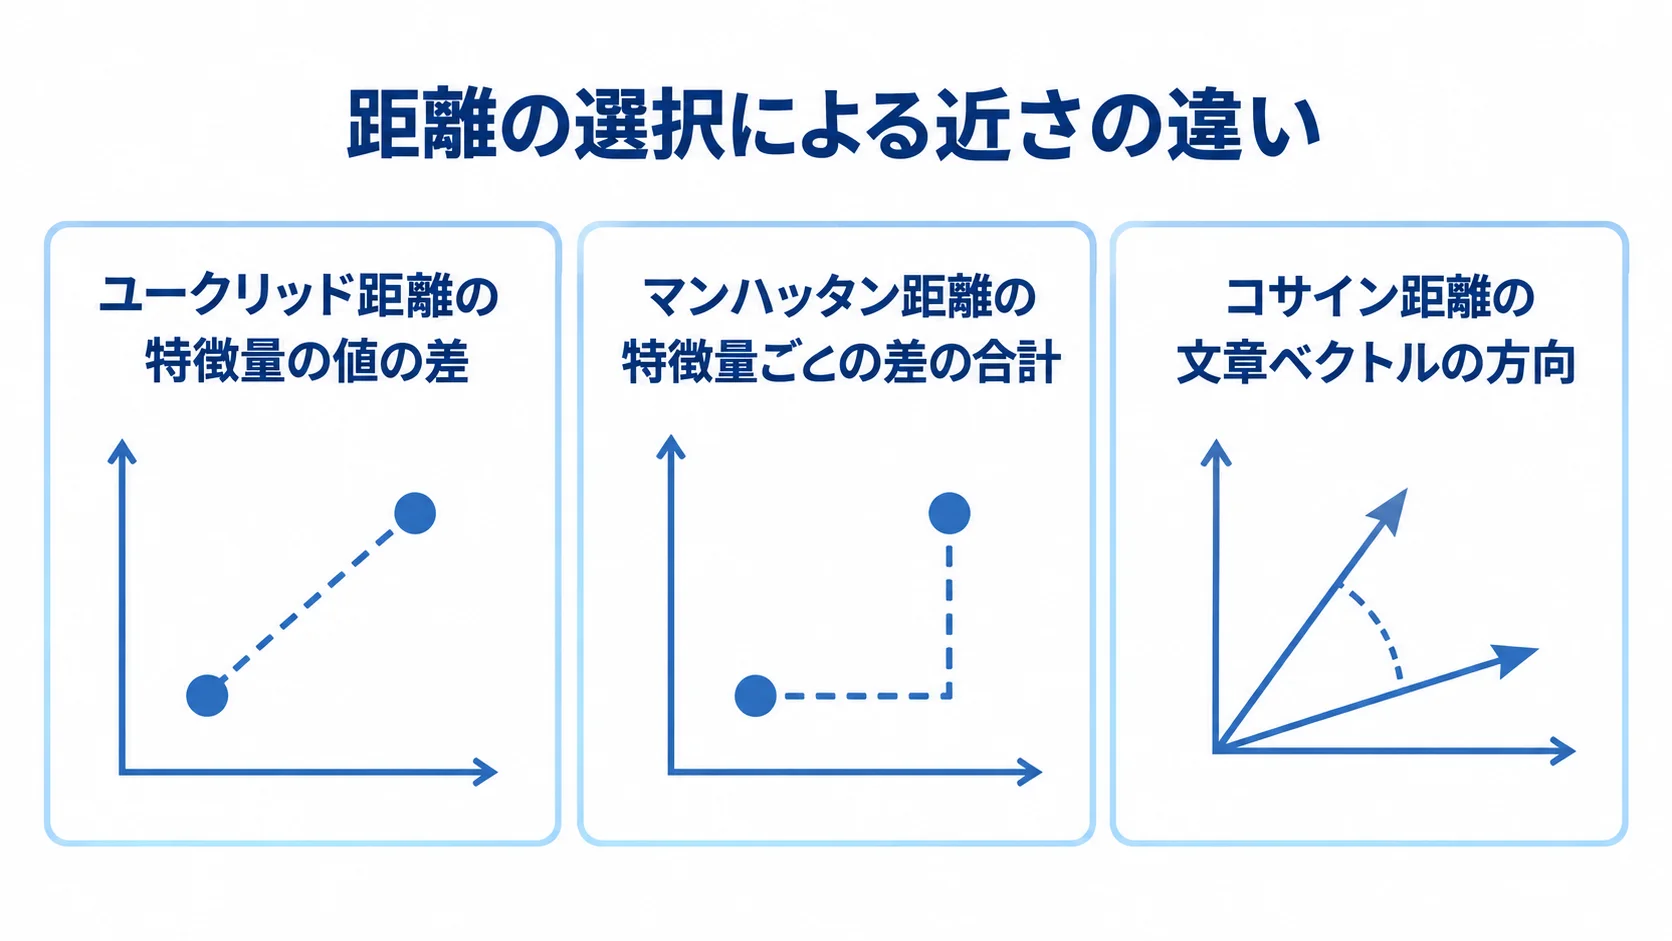
近いデータの意味は、どの距離を使うかで変わります。このため、特徴量の性質を踏まえて、次の距離から候補を選びます。
- ユークリッド距離:特徴量の値の差を距離として見る
- マンハッタン距離:特徴量ごとの差を合計した距離
- コサイン距離:文章ベクトルなど、方向の近さを重視する場合
標準化せずに値の大きい特徴量を混ぜると、他の特徴が距離に反映されにくくなります。そのため、売上や回数のように値の大きさが違う項目を比べるときは、スケール調整を検討します。
まず欠損や外れ値を確認し、カテゴリ変数や重複データも確かめます。そのうえで、前処理と距離を固定して比べると、差が設定によるものかどうかを見分けやすくなります。
Ward linkageは、scikit-learnの仕様上ユークリッド系の距離が前提になるため、この点にも注意が必要です。
樹形図と業務の粒度によるクラスタ数の決め方
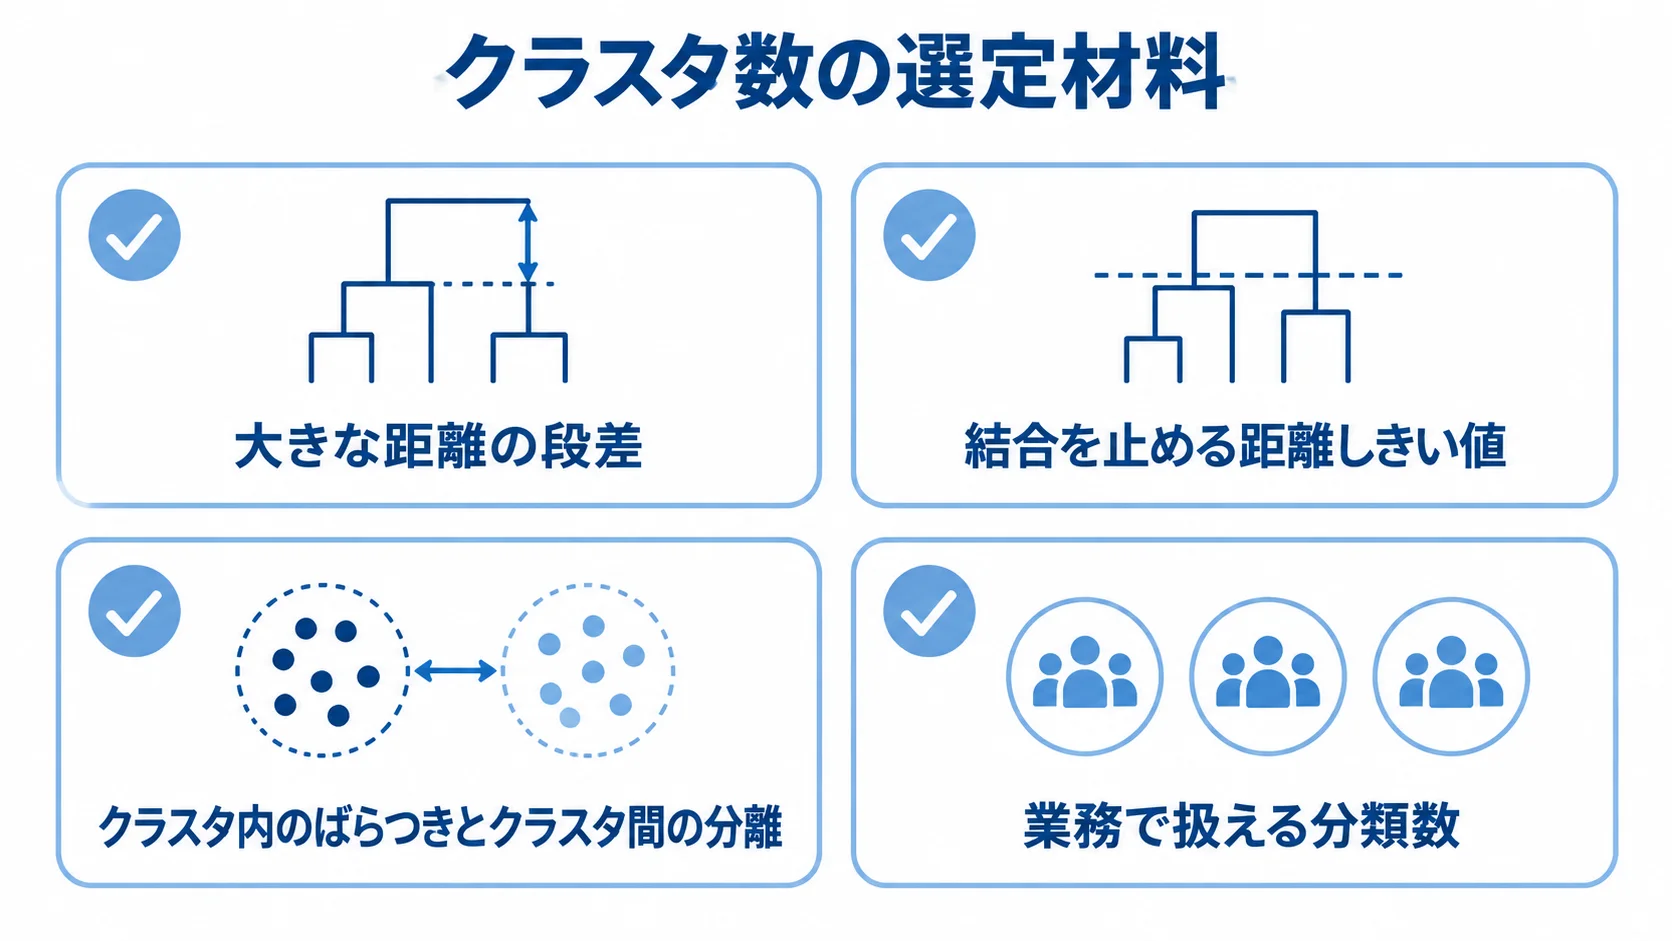
デンドログラムで大きな距離の段差がある位置を切ると、自然なクラスタ数の候補を得られます。distance_thresholdを使うと、結合距離が一定値を超えた時点で結合を止められます。
n_clustersでクラスタ数を固定する場合は、複数の候補を用意し、クラスタ内のばらつきとクラスタ間の分離を見比べます。代表データも見ながら、顧客施策なら営業が運用できる分類数、文書の整理なら担当部署が確認できる単位を考えます。
また、細かい階層まで残しておけば、上位の大分類と下位の詳細分類を用途に応じて使い分けられます。
k平均法との違い(クラスタ数と形の扱い)
k平均法は、k個の中心を更新しながら、指定した数のクラスタを直接作ります。大規模データでも高速に使いやすい一方、クラスタが球状に近く、平均と距離が意味を持つことを前提とします。
階層的クラスタリングは結合の履歴を残すため、クラスタ数を後から選びやすいのが特徴です。ただし、全体の距離計算でメモリの負荷が大きくなる場合があります。そこで、データが大きい場合は、サンプリングや特徴量削減で樹形図の候補を探します。
最終的な割り当てだけを別の手法で行う設計もあります。どちらにするかは、速度と再計算の頻度、説明のしやすさを比べて決めます。さらに、階層を残す必要があるかも判断材料になります。
階層的クラスタリングの活用例
階層に分けておくと、顧客や文書を用途に沿って整理できます。
- 顧客の大分類・小分類:施策別に細かいグループを作る
- 文書・FAQの整理:類似文書から、カテゴリや検索導線の候補を出す
- 商品・部品の体系化:特徴が近い商品を階層化し、管理や品揃えを見直す
- センサー・設備の状態探索:似た時系列特徴から、点検対象や異常候補を確認する
分析後は、各クラスタの代表データと業務属性を確認します。さらに、中央値や分散、期間別の件数も見ておきます。
ただし、樹形図の上で近くても、現場の運用や契約条件が違えば、同じ施策が当てはまらないことがあります。そのため、クラスタはデータ上の仮説として扱い、担当者のレビューと施策の結果で意味を確かめます。
階層を保存しておくと、経営層には大分類、現場には詳細分類というように、利用者ごとに粒度を変えて結果を示せます。
下位クラスタを細かくしすぎると、一つあたりの件数が少なくなり、施策や統計の信頼性が下がります。そこで、各階層に最低限必要な件数と、統合や廃止を判断する基準をあらかじめ決めておきます。
時系列データでは、期間の違いが距離に強く反映されていないかを確認します。過去と現在を同じグループとして比べるのか、変化した状態を別のグループとして見つけるのかによって、集計期間と特徴量の作り方が変わります。
サンプルや期間を変えた階層の安定性確認
入力データが少し変わるだけで、結合の順番や樹形図が変わることがあります。このため、期間、サンプル、特徴量の候補を変えてみて、上位の大分類が再現するかを確かめます。
再現しない場合は、特定の外れ値や一時的なイベントが構造を生んでいないかを調べます。
階層変更を業務システムに安全に反映する手順
商品分類や顧客施策では、クラスタの統合や分割によって既存のルールが変わります。そのため、変更を管理する仕組みが欠かせません。変更を反映したあとに確認できるよう、次の手順と記録項目をそろえておきます。
- 新階層を段階反映:並行表示し、担当者の承認を得てから配信や在庫ルールに反映する
- 所属を保存:旧・新モデルでの所属を残し、変更後の結果と比べる
- ノード情報を記録:ノードごとに作成日時や対象期間を残し、距離、linkage、代表データも紐づける
- 設定を保存:しきい値で階層を切る場合も、選んだ距離とクラスタ数を記録する
記録があれば、担当者はグループの理由や分類変更の影響範囲を説明できます。また、同じデータから同じ分類が得られた設定も、あとから追えます。
階層的クラスタリングで起きやすい失敗と対策
linkageの比較を省いた解釈
singleは鎖状のクラスタを作りやすく、completeは外れ値の影響を受けることがあります。そのうえで、Ward、average、completeなどを比べ、データの形と業務上の解釈が合うかを確かめます。
距離のスケールや欠損の扱い漏れ
スケールの異なる特徴量や欠損をそのまま扱うと、距離の測り方と結合の順番が変わります。前処理、距離、欠損補完のルールを記録しておき、別の期間でも同じ結果になるかを確かめます。
データ数が多いときの全件での樹形図作成
データ数が多くなると、階層的クラスタリングでは距離計算とメモリの負荷が大きくなります。そこで、代表サンプルの利用や特徴量削減のほか、接続制約やMiniBatch系の手法を検討します。
処理時間と精度のトレードオフを測ったうえで、方法を選びます。
階層的クラスタリングのチェックリスト
分析の設定から運用までを、次の点で確かめておくと、手順を見直しやすくなります。
- 距離の定義を決め、標準化や欠損、外れ値、カテゴリ表現を確認したか。
- linkageの候補を比べ、デンドログラムを保存したか。
- クラスタ数または距離しきい値の理由を記録したか。
- 代表データと業務属性をレビューしたか。
- 処理時間、再計算の頻度、階層の更新方法を運用に反映したか。
粒度を選べる探索手法としての階層的クラスタリング
階層的クラスタリングは、近いデータを順に結合し、その過程をデンドログラムに残します。クラスタ数を後から変えられ、大分類と小分類を同じ結果から検討できる点が利点です。
結果と計算量を左右するのは、距離、linkage、前処理です。さらに、外れ値やデータ規模も影響します。
樹形図の見た目だけでクラスタを確定せず、代表データと再現性、業務での利用単位を確かめます。大規模データでは、サンプルで階層を探索し、処理負荷に合う手法を運用に組み合わせる設計が現実的です。
よくある質問(FAQ)
階層的クラスタリングを使うときによくある疑問に答えます。
Q. 階層的クラスタリングとは何ですか?
データ間の距離をもとにクラスタを段階的に結合または分割し、樹形図で階層構造を作る教師なし学習です。
Q. Ward、complete、average、singleはどう使い分けますか?
結合するクラスタ間の距離の定義が異なります。Wardは分散、completeは最大距離、averageは平均距離、singleは最小距離を使います。そのため、データの形と外れ値への感度を比べて選びます。
Q. クラスタ数はどう決めますか?
クラスタ数は、デンドログラムの段差、距離しきい値、クラスタ内外の分離を合わせて決めます。さらに、代表データと業務で扱える粒度も判断の材料になります。数値だけでなく、利用者の解釈も確かめます。
Q. k平均法との違いは何ですか?
k平均法はk個のクラスタを直接作ります。一方、階層的クラスタリングは結合過程を残すため、複数の粒度を後から選べます。ただし、大規模データでは、k平均法のほうが計算しやすい場合があります。
Q. 大量データにも使えますか?
使えますが、距離計算とメモリの負荷が大きくなります。そのため、サンプリングや特徴量削減のほか、接続制約や別のクラスタリング手法を比べ、処理時間と結果の妥当性を確かめます。
参考資料
距離や結合基準、クラスタリング手法の仕様を確かめたいときは、次の資料が参考になります。
- scikit-learn User Guide「Clustering」
- scikit-learn「AgglomerativeClustering」
- Google for Developers「What is clustering?」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。