
Hugging Faceのシステム開発は、要件整理から定着までの六段階を順に進めます。各段階でモデルや推論場所を選び、業務KPIに沿った運用を目指します。
このあと、全体像、六つの段階、費用相場と見積もりの確認項目を順に見ていきます。
▼全体ガイドの記事
・Hugging Faceのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Hugging Faceのシステム開発の全体像
Hugging Faceは、モデル、データセット、コード、デモ、推論基盤を組み合わせて機械学習機能を作るプラットフォーム群です。販売管理や顧客管理の完成済みパッケージとは、性格が異なります。
業務システムとして使うには、導入に加えて、業務データや既存システムとの連携と運用体制の設計が必要です。
Hubを中心としたモデルとデータの管理
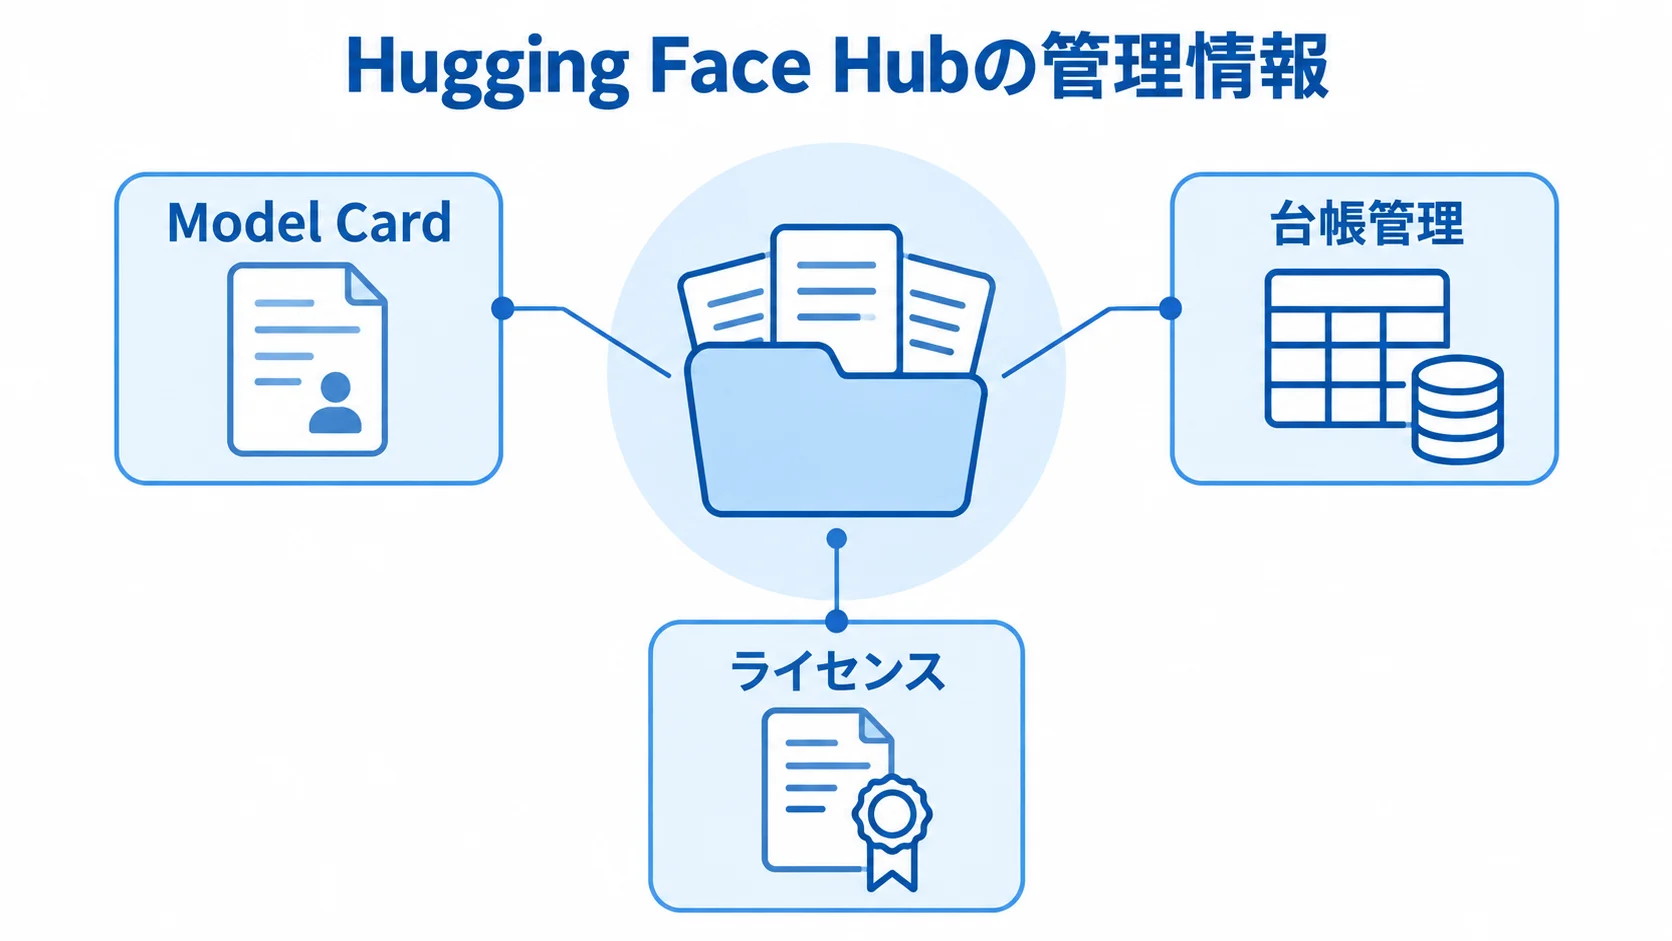
Hugging Face Hubは、モデル、データセット、Spaces、コードを保管・共有するレジストリです。
- Model Card:用途、制限、学習データ、評価結果、ライセンスを記録できます
- 台帳管理:モデル名、採用コミット、カード確認日、ライセンス、評価スコアを残します
- ライセンス:Apache 2.0やMITのほか、商用利用に条件があるOpenRAIL系、Llama系コミュニティライセンス、非商用ライセンスもあります
コードやデータを使うときは、各プロジェクトのライセンスを確認するよう、Hugging Face公式ドキュメントも案内しています(出典: Hugging Face公式ライセンス一覧、2026年8月確認)。
業務システムを構成する六つの部品
社内文書検索を例にすると、業務システムは次のような部品で組み立てられます。
- 画面:利用者が操作するWeb画面やチャット画面
- 業務API:業務システムとAI機能をつなぐ
- RAG基盤:文書や商品情報を検索する
- 推論基盤:Hugging Faceのモデルを呼び出す
- 評価・監査ログ、監視・運用管理:品質と稼働状況を記録・監視し、運用する
Spacesは、デモや社内ツールを短期間で見せる場として便利です。ただし、基幹業務の本番画面をそのまま置く場所ではありません。そのため、本番画面は業務アプリ側に設計します。
社内文書検索では、まず利用者の権限を確認してから文書を検索します。検索結果はモデルへ渡し、回答と参照元をログに残します。
本番環境では、SSOやRBACによる権限管理、入力のマスキングを業務アプリ側に用意します。加えて、タイムアウトや再試行、監査ログ、障害時の代替手段も備えます。
Hugging Faceのシステム開発の進め方
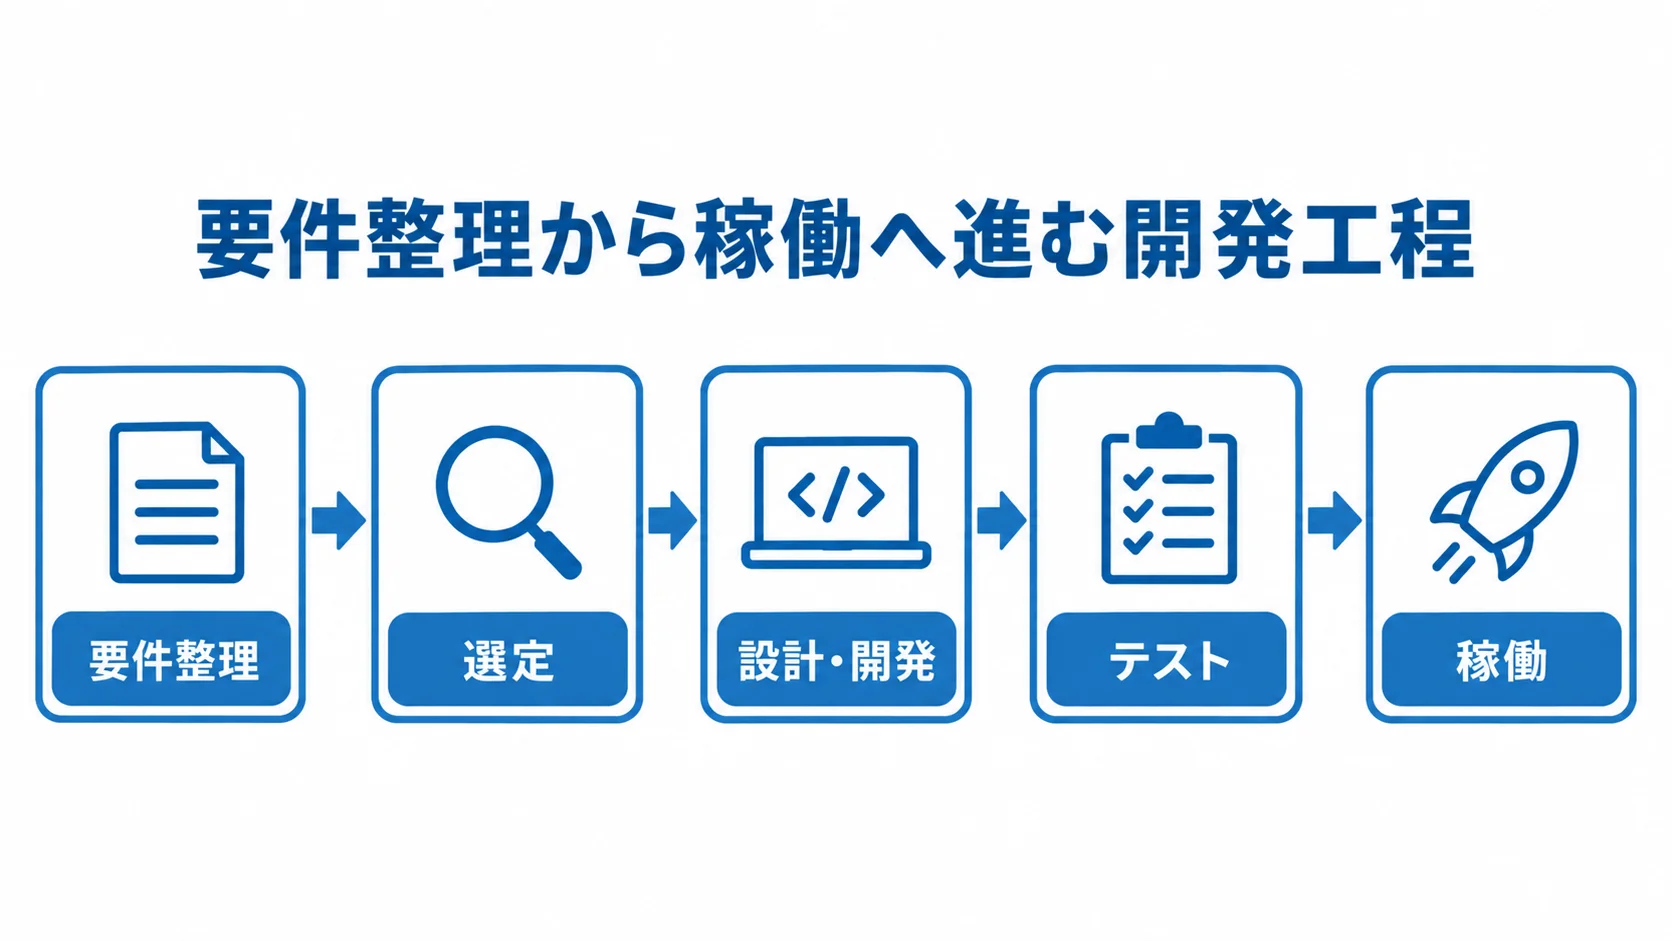
開発は六段階で進み、業務KPIとデータの制約を起点に、各段階で成果物と合格条件を決めていきます。まず要件整理と選定で方式を決め、設計・開発で形にします。その後、テストと稼働を経て、定着へ進みます。
1. 要件整理:業務KPIと利用範囲の決定
まず、解決したい業務上の損失を定義します。KPIは、対象業務ごとに設定します。
- 問い合わせ分類:一次回答までの時間
- 文書検索:検索から判断までの時間
- 画像検査:見逃し率と再検査率
正解率に加え、根拠提示率と処理時間も測ります。1件あたりの推論費用や、担当者の修正率も対象です。
まず利用者と業務、入力形式を整理します。そのうえで、月間リクエスト数、許容応答時間、誤回答の影響を見ておきます。さらに、個人情報・機密情報の有無、保存期間、最終判断者も決めます。
人の承認を必須にするか、低リスク業務の自動処理を許すかによって、必要な精度と監査の設計が変わります。また、現場、法務、情報システム部門で要件を確認すると、手戻りを減らせます。
2. 選定:RAG・微調整・推論場所の比較
業務に合う方式を選ぶため、次の違いを評価します。
- 既存モデル:モデルをそのまま使う
- RAG:最新の規程や商品情報を検索して回答する
- 微調整:定型分類や出力形式を安定させる
- 比較順:ベースモデル、RAG、微調整後を小さな評価セットで比べる
モデルの対応言語とタスクを確認します。必要なVRAM、量子化、速度も見ます。さらに、コンテキスト長とライセンスを確認し、学習データや既知の制限も把握します。
自社データでの性能は、実際の質問と正解回答を少なくとも業務シナリオ別に分けて評価します。モデルカードの評価値は参考にとどまり、性能を保証するものではありません。
推論場所は、簡易検証ならInference Providers、本番の専用エンドポイントならInference Endpointsが候補になります。
自社VPCや既存クラウドの統制を優先する場合は、SageMakerやAzure、Vertex AIを比べます。Kubernetesやオンプレミスの GPUも候補に加えます。
3. 設計・開発:業務APIとAI基盤の分離
設計・開発では、次の要点を分けて決めます。
- システム構成:画面、業務API、検索、推論、ログを疎結合にし、交換可能なモデル呼び出し口を設ける
- RAG処理:文書を取り込み、分割・埋め込み・検索・再ランキングする
- 回答生成:プロンプトを作り、回答と参照元を返す
- 版の記録:モデルとデータを固定し、Hubのリポジトリ・コミット、ライブラリ、コンテナ、プロンプト、評価データを記録する
検索インデックスの作成日時も記録し、環境ごとの差を抑えて変更時の状態を追えるようにします。さらに、モデルを交換できる構成にしておけば、ライセンスの変更や性能不足にも応じられます。
APIキーなどのシークレットは、コードへ直接書かず、権限を限定して保管します。また、個人情報を扱う入力には、マスキングか閉域化を実装します。
4. テスト:精度だけでなく業務品質の測定
テストでは、次の品質項目を確認します。
- テスト工程:単体、連携、性能、セキュリティ、受入を分ける
- RAG:検索文書、参照元、権限を確かめ、根拠がなければ「分からない」と返すかを見る
- 分類精度:全体正解率に加え、重要クラスの適合率・再現率と人の修正割合を見る
- 性能:平均応答時間、ピーク時の95パーセンタイル、同時実行数、タイムアウト率、GPUメモリ、スケールアップ時間を測る
- 安全性:マルウェア、pickle、trust_remote_code、プロンプトインジェクション、機密出力、ログへの個人情報混入を試す
受入テストへ進む前に、数値で合格基準を合意しておきます。
5. 稼働:段階リリースとロールバックの準備
公開は全社一斉ではなく、対象を絞って次の順に進めます。
- 部署や処理量を限定し、シャドーモードで回答だけを提示します。最終判断は担当者が行い、誤回答と修正内容を集めます。
- 問題がなければ一部ユーザーの業務へ組み込み、KPI達成後に対象範囲を広げます。
監視項目ごとに責任者を決めます。監視するのは、応答時間、エラー率、利用量です。さらに、GPU稼働時間や回答拒否率、根拠提示率、ユーザー評価も見ます。
指標はダッシュボードで確認し、しきい値を超えたら通知します。そのうえで、新旧モデルを同じ評価データで比べます。
性能が悪化した場合に備え、モデル、プロンプト、インデックスを一体で旧版へ戻せるようにします。
6. 定着:利用ルールと改善サイクルの運用
利用者が守るルールとして、次の事項を明文化します。
- 質問範囲:得意な質問と不得意な質問
- 回答の確認:回答を信頼しすぎてはいけない業務
- 情報と承認:個人情報の入力範囲と人が承認する手順
誤りの報告を改善につなげるため、フィードバックの受付担当と対応期限を決めます。改善が見えないと利用率が下がるため、この決め事が欠かせません。
利用率と業務時間の削減を、月次または四半期ごとに確認します。あわせて、エラーや問い合わせ、モデル評価、費用も見ます。
文書が更新されたときは、RAGのインデックスを更新します。また、モデルやライブラリを変えたときは、回帰評価をします。
EU向けの業務では、欧州委員会の案内によると、2026年8月2日からGPAI提供者への執行権限が適用されます。対象となる場合は、モデル文書、リスク評価、ログの管理責任を法務と確認します(出典: 欧州委員会GPAIガイドライン、2026年8月確認)。
Hugging Faceのシステム開発にかかる費用相場
日本では、Hugging Faceを使った業務システム開発の一律な平均価格は公表されていません。そこで以下の金額は、一般的な開発規模と公式クラウド価格を組み合わせた編集上の推定として示します。
費用は、税別の初期開発費とクラウド実費を分けて比べます。データ整備費や保守費も、別の項目として見ます。ここに示す数字は、個別案件の確定見積もりではありません。
初期開発費の規模別の見積もり
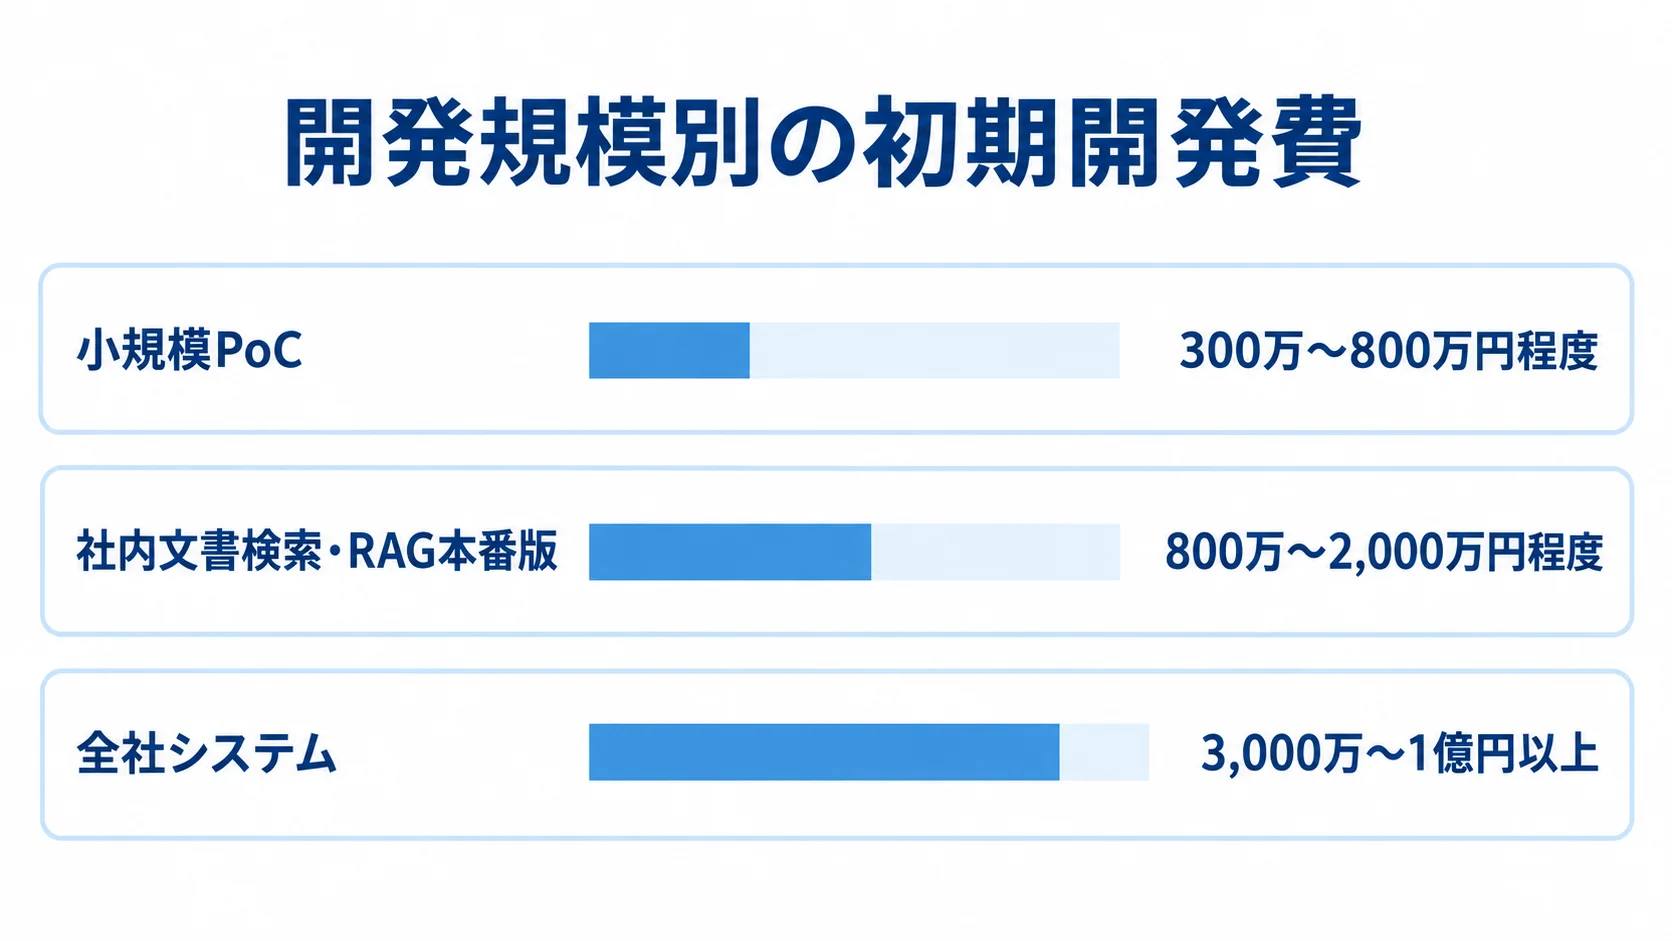
初期開発費は、PoCの検証範囲から全社運用まで、規模や期間によって変わります。
- 小規模PoC:300万〜800万円程度、期間は1〜3か月が目安。1モデル、限定データ、簡易UI、評価ログで実現性とKPIを確認
- 社内文書検索・RAG本番版:800万〜2,000万円程度、期間は3〜6か月の推定レンジ。取り込み、権限連動、SSO、監視、評価、既存連携を含む
- 複数部署の業務AI:1,500万〜5,000万円程度、期間は6〜12か月が目安。データ整備、LoRAなどの微調整、MLOpsを含む
- 全社システム:3,000万〜1億円以上、期間は9〜18か月以上になる可能性があります。複数モデル、高可用性、災害対策、基幹連携、厳格な監査を含む
これらはリサーチノートに基づく推定です。金額は、データ量や連携数で大きく変わり、SLAやセキュリティ要件によっても変わります。
Hub料金・GPU費用・保守費の切り分け
Teamは1ユーザー月額20ドル、Enterpriseは1ユーザー月額50ドルからの表示です。Enterpriseの料金は契約内容によって変わります(出典: Hugging Face公式料金ページ、2026年8月確認)。
業務アプリ開発費やGPU稼働費は、プラン料金に含まれません。プランは、ユーザー数や非公開リポジトリの要否で選びます。監査ログやSSO、データ所在地、サポートの要否も判断材料になります。
GPU費用は、インスタンスの稼働時間とレプリカ数で変わります。あわせて、機種ごとの1時間単価も確認します。
- T4:1時間0.50ドル
- L4:1時間0.80ドル
- L40S:1時間1.80ドル
- A100:1時間2.50ドル
- H200:1時間5.00ドル(出典: Hugging Face Inference Endpoints公式料金、2026年8月確認)
1ドル150円、730時間、レプリカ1台で単純計算すると、上の順に約5.5万円、約8.8万円、約19.7万円、約27.4万円、約54.8万円です。
この試算には、為替変動、ストレージ、通信の費用が含まれていません。ログ、オートスケール、冗長化の費用も含めていません。
開発中は停止時間を設け、本番は最小レプリカを小さくして、バッチとリアルタイム処理を分けると、費用を抑えられます。
待ち時間の許容度が低く、停止やスケール遅延を許せない業務では、常時稼働や複数レプリカが必要になります。
保守費は、初期費用の年15〜25%程度が一般的な目安です。Hugging Faceの案件では、再評価、脆弱性確認、推論ランタイム更新の範囲によって契約額が変わります。
見積もりを取る際のポイントとチェックリスト
見積もりを各社で比べるには、「AI機能一式」の一行にまとめず、項目ごとに分けてもらう必要があります。要件やデータ、モデル、評価が基本です。画面やAPI、検索、推論、セキュリティも、同じように分けます。
テストや移行については、項目ごとの成果物と工数を示してもらいます。教育や保守も、同じ形で書いてもらいます。
RFPに書く入力・出力・評価条件
依頼の前に、入力と出力、評価条件を次の観点で整理します。
- 業務とデータ:対象業務、利用者数、データの種類・件数、更新頻度、月間リクエスト数
- 利用環境:希望応答時間、対応言語、既存システム、利用可能なクラウド、個人情報の有無
- 評価条件:正解データの作り方、評価方法、許容誤答、根拠表示、人の承認の要否
前提が曖昧だと、ベンダーごとに置く条件がずれてしまいます。そうなると、金額だけでなく完成物も比べにくくなります。
モデル候補は一つに絞りすぎず、商用利用や再配布の条件、学習データの出所を確かめます。また、Gated Modelの手続き、Safetensors対応、trust_remote_codeの要否も見ておきます。
Microsoft Foundryの案内も、第三者ライセンスやSafetensors形式、trust_remote_code不要などを選定条件に挙げています(出典: Microsoft Foundry公式Hugging Faceモデル案内、2026年8月確認)。
ベンダー選定と責任分界
責任の分かれ目は、技術や引き渡し、契約の面から確認します。セキュリティの面は、下の項目で見ます。
- 技術経験:Transformers、PyTorch、RAG、微調整、GPU設計、既存連携
- 実装と引き渡し:SSO、RBAC、監査ログ、評価データ、コード、IaC、モデル設定、手順書
- 契約条件:権利、障害対応時間、代替策、更新承認者、脆弱性対応期限、費用上限、クラウド所有者
- サービスの安全機能:安全機能の内容も確認する
Inference Endpointsでは、TLSやSOC 2 Type 2、ログ30日保存が案内されています。PrivateLinkによるPrivate Endpointなども案内しています(出典: Hugging Face Inference Endpoints公式セキュリティ、2026年8月確認)。
業務データの保存や送信、アクセス権限が自社の要件に合うかは、自社で確認する責任が残ります。
見積書の追加費用の発生条件
追加費用の発生条件と見積もりの前提を、明記してもらいます。
- 追加費用の要因:データの欠損・重複、既存APIの利用不可、GPUクォータ不足、評価データの人手作成
- 見積もり前提:データ量、画面数、連携先数、モデル数、同時実行数
- 環境・試験条件:環境数、レプリカ数、テストケース数
PoCから本番へ移る条件も確認します。成果物にデモ画面だけを含むのか、再利用可能なAPIや評価レポート、運用設計まで含むのかで、次工程の費用が変わります。
終了時に継続、改善して再評価、中止のどれを選ぶかを決められるよう、KPIと撤退条件を提案書や契約書に入れます。
よくある質問(FAQ)
費用や方式は要件によって変わります。以下の数字は相場の目安として捉え、自社データと運用条件で評価してください。
Hugging FaceではRAGとファインチューニングのどちらを選べばよいですか?
社内文書や最新情報を参照する場合は、まずRAGを検討します。一方、定型分類や出力形式を安定させたい場合は、微調整が候補になります。
両方を一度に導入せず、同じ評価データでベースモデル、RAG、微調整の順に比べます。そうすると、費用と効果を判断しやすくなります。
機密情報を扱うシステムでもHugging Faceを使えますか?
使える可能性はあります。ただし、サービス名だけで安全と判断することはできません。自社の情報セキュリティ審査を通します。
確認するのは、Private EndpointやVPC、PrivateLink、暗号化です。加えて、SSOやRBAC、ログの範囲、入力データの学習利用も確かめます。
モデルファイルの検査や個人情報のマスキングも、要件に入れます。閉域網やオンプレミスが必要な場合は、Inference Endpointsに加えて、専用クラウドや自社GPU運用も比べます。
開発会社にはどこまで依頼できますか?
要件整理、データ整備、モデル選定を依頼できます。RAGや微調整、評価データ作成のほか、API・画面開発やクラウド構築も対象です。
セキュリティ審査、テスト、運用保守まで依頼できます。会社ごとの得意分野を踏まえて、連携や現場教育、更新、障害対応の実績と責任分界を確かめます。
Hugging Faceを使った業務システムの事例はありますか?
Kustomerは顧客データでBERT系モデルを微調整し、評価後にSageMakerエンドポイントで推論しています。
会話分類では、データ整理、分類対象の選定、受信メールの予測を行います。この事例は、データ準備や評価、業務フローへの組み込みも必要だと示しています(出典: Hugging FaceとAWSによるKustomer事例、2026年8月確認)。
まとめ
Hugging Faceのシステム開発は、Hubのモデルを業務へ組み込む総合的な設計です。六段階に分けて、KPIやデータ、推論場所を確認します。さらに、ライセンスや安全性、運用責任も見ていきます。
段階ごとに確かめておくと、PoCで止まることや、本番後に精度が下がることを防ぎやすくなります。
小さな評価セットと見積もり条件の準備
代表的な業務の質問や分類データを集め、許容精度と応答時間を整理します。情報の持ち出し条件や月間利用量も、あわせて確かめます。
RAGや微調整、専用推論、既存クラウドで複数案を作り、開発費とクラウド費を分けて見積もります。
モデルの魅力だけでなく、業務成果と継続運用まで比べることが、成功につながります。
発注前に揃える六つの確認項目
発注前には、六つの確認項目を揃えます。業務KPIと対象データ、モデルとライセンスを先に固め、推論場所やセキュリティ、運用と責任分界も確認します。各項目に担当者と合格基準を置くと、開発会社へ必要なシステム要件を明確に伝えられます。
▼全体ガイドの記事
・Hugging Faceのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。