
ハイパーパラメータチューニングは、学習前に人が決める設定値を複数の候補から比べ、検証データで性能が高くなる組み合わせを探す作業です。
ただし、検証スコアを上げるだけでは本番で良いモデルとは限りません。データ分割と評価指標を一緒に管理し、計算時間やモデルの複雑さ、データリークにも注意が必要です。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」で詳しく解説しています。
ハイパーパラメータチューニングとはモデルの設定値を比較する工程
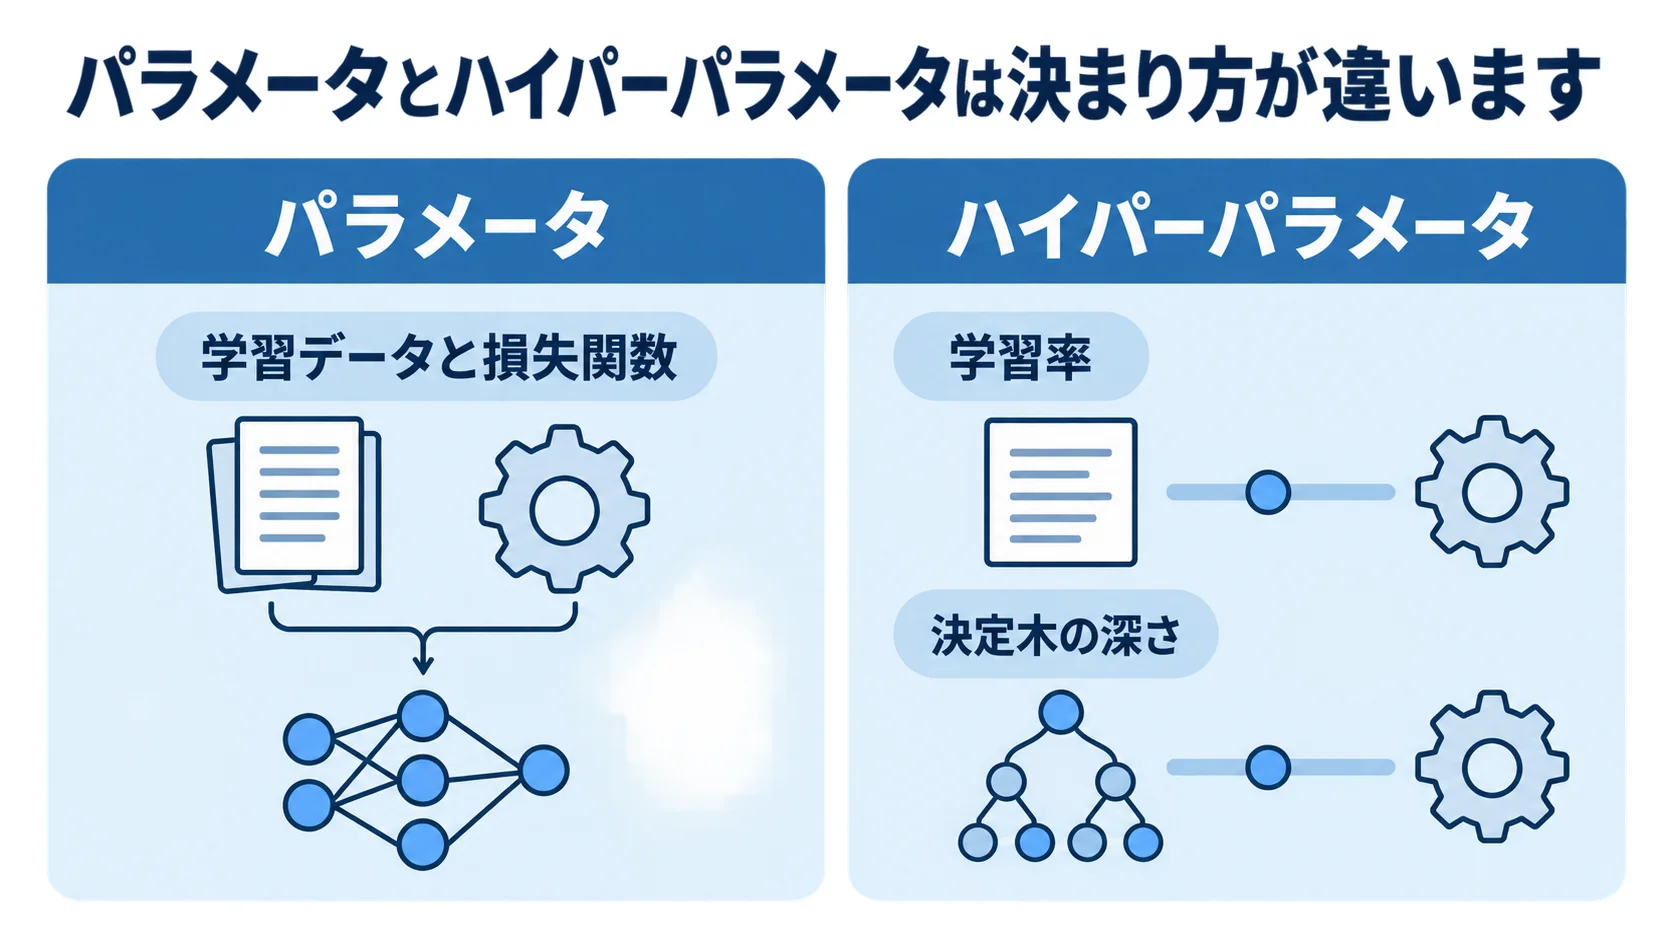
機械学習では、データから自動的に決まる重みや係数をパラメータと呼びます。一方、学習を始める前に人が設定する値がハイパーパラメータです。学習率や決定木の深さ、正則化係数のほか、ランダムフォレストの木の本数やニューラルネットワークの層数などが該当します。
チューニングは、候補値を一定の評価手順で試し、採用する設定を決めるプロセスです。
パラメータとハイパーパラメータの決まり方の違い
線形回帰の係数やニューラルネットワークの重みは、学習データと損失関数を使って最適化されます。これに対して、学習率や木の深さは、学習処理の外側で指定します。
両者を混同すると、チューニングの対象を取り違えたり、学習後の重みを手作業で調整しようとしたりします。まずは、モデルのドキュメントで各設定値の役割を確認しておきます。
チューニングが必要な理由
同じアルゴリズムでも、設定値によって未学習(アンダーフィッティング)と過学習のバランスが変わります。そのため、設定値は候補を比べて選ぶ必要があります。たとえば、決定木を深くしすぎると学習データには合いやすくなりますが、未知データへの汎化性能が下がることがあります。
同じデータ分割と評価指標で比べておくと、設定を勘で決めずに済み、採用理由を説明しやすくなります。
代表的な探索方法とグリッド・ランダム・ベイズ最適化
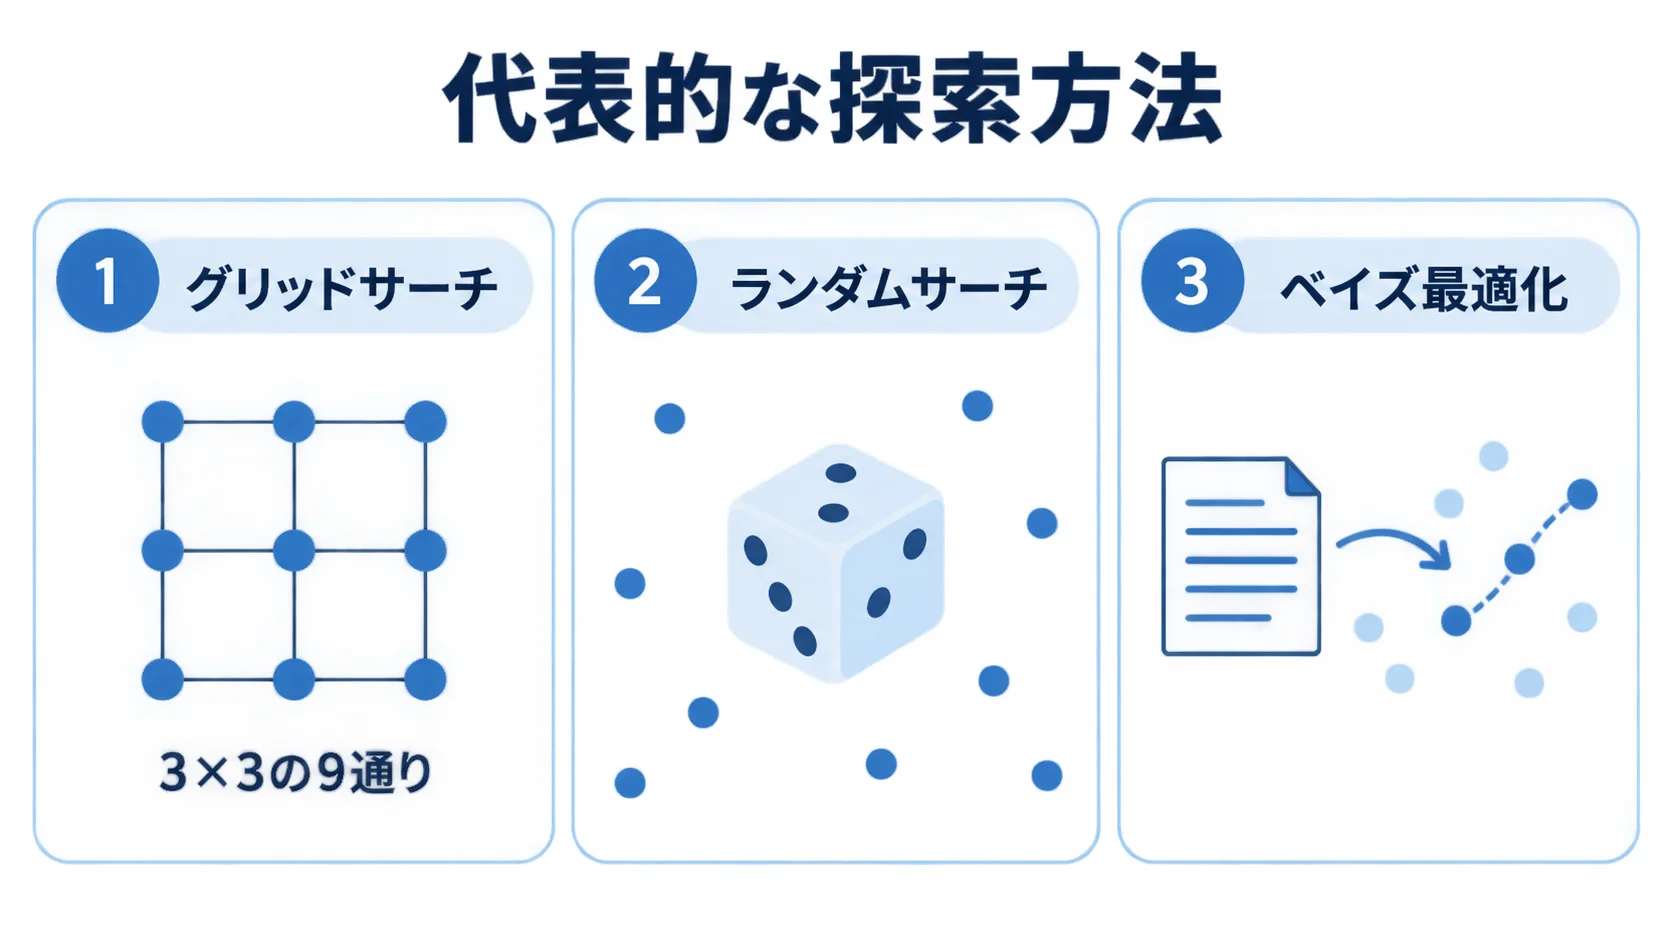
候補の組み合わせを網羅するグリッドサーチ
グリッドサーチは、あらかじめ指定した候補値のすべての組み合わせを評価する方法です。たとえば、学習率を0.01、0.1、1、木の深さを3、5、8と指定すると、3×3の9通りを試すことになります。
候補数が少なく探索範囲が狭い場合は、結果を再現しやすいという利点があります。一方で、設定項目が増えると試行数は掛け算で増えるため、計算コストに注意が必要です。
限られた試行回数で広く探るランダムサーチ
ランダムサーチは、指定した分布や候補からランダムに組み合わせを選び、決めた回数だけ評価します。特に、重要な設定が一部に限られる場合は、すべての組み合わせを均等に試すグリッドサーチより、限られた計算量で有望な領域を見つけやすいことがあります。結果を後から再現できるよう、乱数シード、試行回数、探索した範囲を記録しておきます。
過去の結果から次の候補を選ぶベイズ最適化
ベイズ最適化は、これまでの設定と評価結果から、次に試すと有望な候補を推定します。1回の学習に時間がかかるモデルや、探索する設定値が多い場合には、計算を節約できる可能性があります。
ベイズ最適化は、実装や停止条件、並列化の設計が複雑になりやすいため、まずはグリッドサーチやランダムサーチで基準を作り、改善余地が明確な案件で導入を検討します。
交差検証と評価指標のセット設計
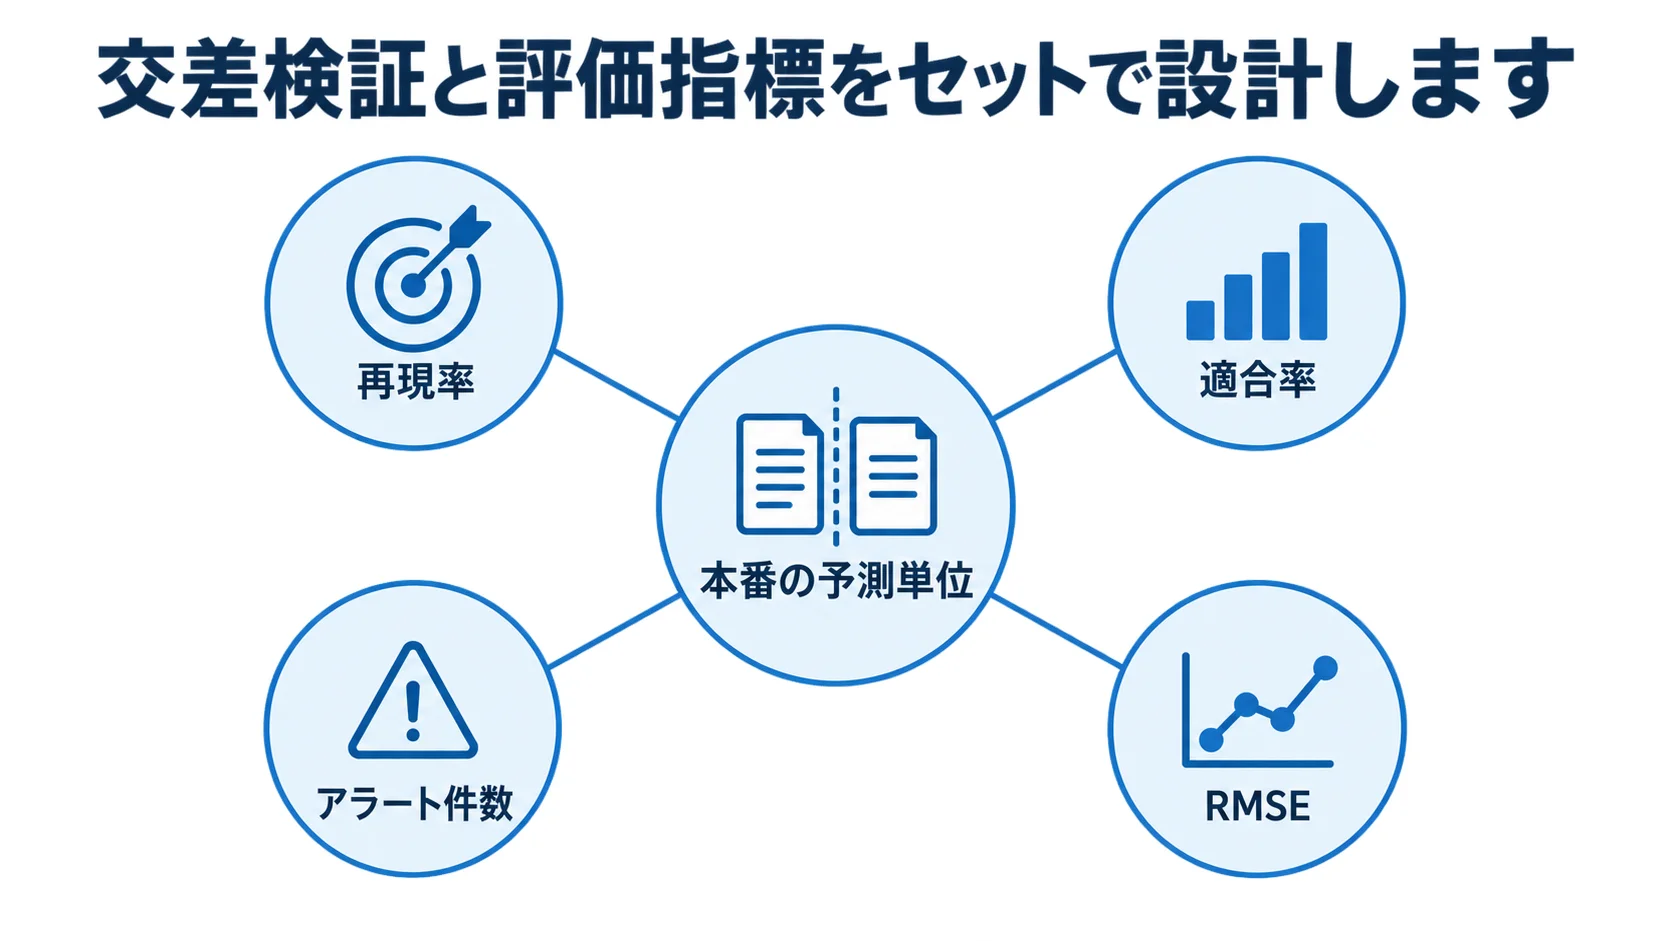
ハイパーパラメータの候補を比べるとき、1回のホールドアウト分割だけで判断すると、分割の偶然に左右された候補を選んでしまうことがあります。このため、scikit-learnのGridSearchCVやRandomizedSearchCVでは、交差検証の分割方法を指定して各候補を評価できます。分類ではクラス比率を保つ、同じ顧客をまたがない、時系列では順序を守るなど、本番の予測単位に合う分割を選びます。
評価指標は、業務上の失敗と結びつけて選びます。accuracyや決定係数の高さだけで決めると、見逃しや欠品といった失敗を防げないことがあるためです。たとえば、不正検知で見逃しが高コストなら再現率を、確認業務の負荷が問題なら適合率やアラート件数を、需要予測で大きな欠品を避けたいならRMSEを見ます。
複数の指標を使う場合は、最終的にどの指標で採用候補を決めるかを事前に定義しておきます。
実務での探索範囲の決め方と段階的な絞り込み
探索は、次の流れで段階的に進めます。
- 目的と評価指標を定義する:予測対象、本番の利用単位、許容できない失敗の明文化
- 基準モデルを作る:既定値や単純なモデルによる、改善前の性能と実行時間の記録
- 探索範囲を現実的に決める:モデルの仕様とデータ量から見た、試す値の上限と下限
- 粗い探索から始める:ランダムサーチなどで有望な領域を探し、必要なら範囲を絞る。
- 最終候補をテストする:調整に使わなかったテストセットで、最終性能を一度だけ確かめる。
実験表には、データ期間や前処理、分割方法といった条件を残します。さらに、乱数シードや候補値も記録しておきます。結果の欄には、平均スコアとそのばらつき、学習時間、モデルサイズを書き込みます。
最高スコアの候補が、推論速度、説明しやすさ、運用費用まで含めて最適とは限りません。また、候補を比べた記録が残っていれば、データを更新したあとも同じ条件で再評価できます。
チューニングで起きやすい失敗と対策
検証データを何度も見ることによる過学習
候補を大量に試し、検証スコアを見ながら探索範囲や特徴量を何度も変えると、モデルだけでなく選択の過程そのものが検証データに適合してしまいます。
モデル選択用の交差検証と、最後まで触らないテストセットは分けておき、テスト結果を見て再調整しない運用にします。
分割前に行う前処理によるデータリーク
全データの平均で標準化したり、全期間の情報で特徴量を作ったりしてから交差検証を行うと、検証foldの情報が学習側へ漏れます。
そこで、前処理とモデルをPipelineにまとめ、各foldの学習データだけで前処理のパラメータを学習させます。時系列の場合は、将来の値を参照していないかも確認します。
候補数の増加による計算費用の膨張
候補数、fold数、モデルの学習時間を掛け合わせると、試行回数は急速に増えます。このため、まずは小さいデータのサンプルや低い試行回数で処理の妥当性を確かめ、改善幅が大きい設定に絞ってから本番データで実行します。
並列で実行する場合は、CPUやメモリ、クラウド料金に加えて、他の処理への影響も記録しておきます。
ハイパーパラメータチューニングのチェックリスト
チューニングを進める前に、次の5項目を確かめます。
- チューニングの目的と業務上の成功指標の定義
- 学習、検証、テストの役割の分離
- 本番のデータ生成過程に合う交差検証の選択
- 前処理、特徴量選択、モデルの各fold内での処理
- 探索範囲と試行回数、乱数シード、ライブラリのバージョンの記録
評価の段階では、次の2項目も確かめておきます。
- スコアに加えて、推論時間・費用・説明可能性・保守性の比較
- 最高スコアの候補を、テストセットで一度だけ確認すること
評価設計と一体で進めるハイパーパラメータチューニング
ハイパーパラメータチューニングは、モデルの設定値を候補から比較し、未知データでの性能と運用条件のバランスを探す工程です。
グリッドサーチは小さな候補を網羅するとき、ランダムサーチは広い範囲を限られた回数で探すとき、ベイズ最適化は高コストな評価を効率化したいときに候補になります。
重要なのは探索手法の名前より、データリークを防ぎ、業務の失敗コストに合う評価指標を選び、テストセットを最後まで保つことです。
基準モデルとの差分、採用理由、再評価条件を実験記録に残すと、精度改善を本番運用につなげやすくなります。
よくある質問(FAQ)
チューニングを始めるときに多い疑問と、その答えです。
Q. ハイパーパラメータチューニングとは何ですか?
学習前に設定する値の候補を比べ、検証データで性能と運用条件のバランスがよい組み合わせを選ぶ作業です。学習で自動的に決まる重みや係数を直接調整する作業ではありません。
Q. グリッドサーチとランダムサーチはどちらを使うべきですか?
候補が少なく網羅的に比べたい場合はグリッドサーチ、探索範囲が広く試行回数を制限したい場合はランダムサーチが合っています。まずランダムサーチで有望な範囲を探し、必要なら狭い範囲をグリッドサーチで確認する方法もあります。
Q. 交差検証は必ず使う必要がありますか?
必須ではありませんが、データが少ない場合や、1回の分割の偶然に左右されたくない場合に有効です。ただし、時系列、グループ単位、クラス比率など、本番のデータ生成過程に合う分割方法を選ぶことが前提になります。
Q. 最高スコアのモデルをそのまま採用すればよいですか?
最高スコアのモデルは、テストセットでの最終性能に加えて、推論速度、費用、説明可能性、重要な顧客や期間での誤りを確認したうえで、業務上許容できるかを判断します。
Q. チューニングでデータリークを防ぐにはどうしますか?
前処理や特徴量選択は、各foldの学習データ内で実行し、分割前に全データへ適用しないようにします。
Pipelineで前処理とモデルをまとめ、最後まで調整に使わないテストセットを残しておくと、リークと選択バイアスを抑えやすくなります。
参考資料
本記事で扱ったグリッドサーチ、ランダムサーチ、交差検証の仕様は、次のscikit-learn公式ドキュメントで確認できます。
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックもご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。