
InfluxDBのシステム開発は、要件整理、製品・構成の選定、設計・開発の順に進みます。その後はテスト、稼働、定着へと続き、全体は6フェーズです。各フェーズで判断事項と次工程へ進む条件を確かめると、業務判断やアラートにつながります。
全体像は、▼の完全ガイドでも確認できます。
▼全体ガイドの記事
・InfluxDBのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
InfluxDBのシステム開発の全体像
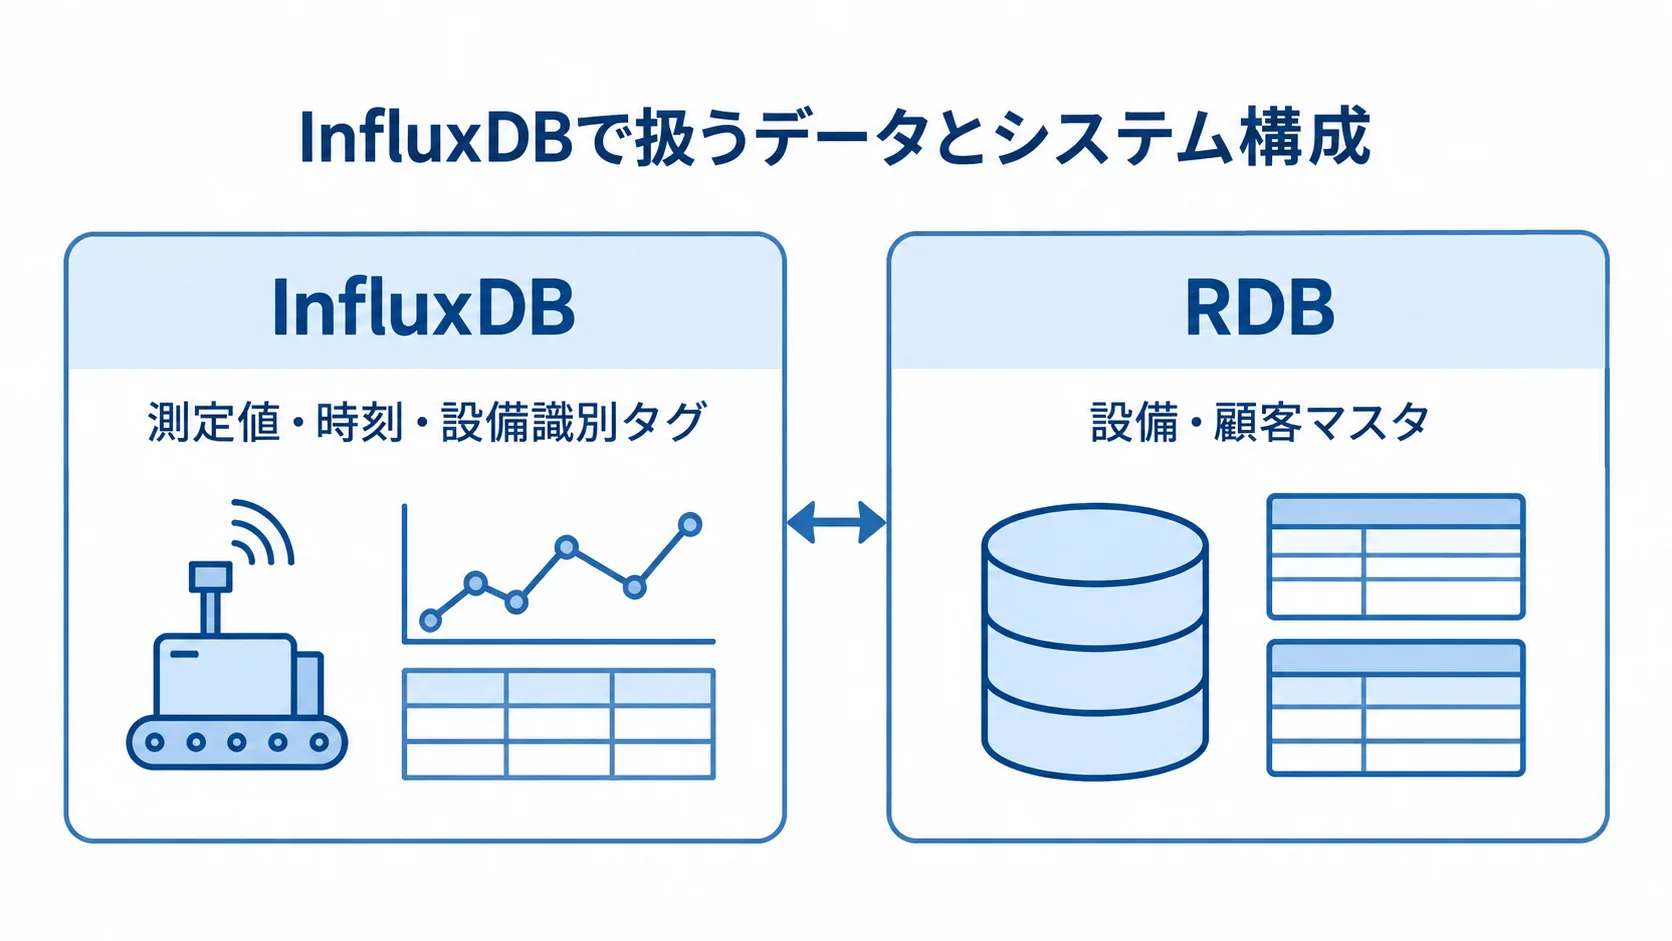
InfluxDBは、時刻とともに増え続ける温度、電力、設備振動、CPU使用率、通信量、アプリケーションのメトリクスなどを扱う時系列データベースです。
顧客、商品、受注などのマスタや取引を扱うRDBとは得意分野が異なるため、すべての業務データをInfluxDBだけで管理せず、役割を分けます。
InfluxDBで扱うデータとシステム構成
構成は、データの収集から保存、確認、業務対応までを一つの流れとして組み立てます。
- 収集経路:センサーやアプリのデータをMQTT、HTTP、OPC-UAなどで運び、Telegrafまたは独自APIからInfluxDBへ書き込む経路です。
- 確認と通知:保存データはGrafanaや業務Web画面で確認し、しきい値超過時はメール・チャット・電話・チケット管理へ通知する。
- データ配置:設備・顧客マスタはPostgreSQL等のRDB、測定値・時刻・設備識別タグはInfluxDBに分けて保存する。
- 業務要件:閲覧者、判断内容、後続作業まで具体化する。「温度を保存する」のような記述は、業務要件としては足りません。
- 通知条件:10分移動平均が基準超過なら通知し履歴を残す、という条件で、画面・アラート・権限・ログの範囲が定まります。
Core、Enterprise、Cloudの使い分け
製品は、用途、可用性、運用体制に合う構成から選びます。
- Core:オープンソースの単一ノード構成で、エッジ、開発、小規模用途に向きます。
- Enterprise:高可用性、読み取りレプリカ、長期分析、セキュリティ、サポートを含む製品です(InfluxData公式発表、2025年)。
- 選定基準:無料か有料かを基準にせず、停止許容時間、保持年数、復旧担当、認証方式、データ増加で判断する。
- Cloud Serverless:利用量に応じて課金され、サーバーの調達や更新を抑えられる方式。
- AWS連携:AWS基盤を使うなら、連携するAWSサービスも併せて比べる。
両エディションは、2025年にGA(一般提供)となりました(出典: InfluxData公式発表、2025年)。
単一テナント、閉域接続、SLA、性能分離が必要な場合は、DedicatedやEnterpriseを検討します。
AWSの既存基盤と運用を統合したい場合は、Amazon Timestream for InfluxDBも比較します。
AWS公式ドキュメントでは、InfluxDBのAPIやツールを使えるマネージド時系列DBと説明されています。そのうえで、AWS監視、IAM、バックアップ方針との整合性を確認して選びます。
InfluxDBのシステム開発の進め方
開発では、業務課題とデータ契約を先に固めてから実装します。データベースを先に作って用途を探す進め方とは、順番が逆になります。
6フェーズは、要件整理、選定、設計開発、テスト、稼働、定着の順です。
各段階で、判断事項と次工程へ進む条件を押さえます。
フェーズ1:要件整理でデータと業務目的を定義
要件整理では、業務上の目的を明らかにし、データの条件を具体化します。
- 業務課題:課題を1〜2個に絞り、予知保全・電力削減・異常検知・SRE対応ごとに成果指標を置く。
- 現場業務:閲覧帳票、異常を知りたい時間、通知後の作業を現場に聞き、As-IsとTo-Beを整理する。
- 規模と負荷:センサー数、項目、毎秒書込数、ピーク増加率、保持期間、検索範囲、同時利用者数の仮置き。
- データモデル:設備・拠点IDや機器種別はタグ、個体ごとの値や測定値はフィールドの候補。
- タグ設計:タグの追加を抑え、設計はデータモデル表に残す。
ユーザーIDや一意なリクエストIDを無制限にタグへ入れると、カーディナリティが増えます。カーディナリティは、メモリ、インデックス、クエリ性能、クラウド料金に影響します。そのため、データモデル表を成果物に含めるよう、開発会社へ求めます。
チェックでは、目的やKPI、発生元や欠損、時刻と単位の統一を確かめます。
個人情報や営業秘密の扱い、RPO・RTO・バックアップ期間も押さえます。
さらに、MES・SCADA・ERP・監視基盤との連携先も確かめます。要件が曖昧なまま見積もると、後から画面や連携が増え、費用が膨らみやすくなります。
フェーズ2:選定で製品と運用方式を決定
製品と収集方式は、運用条件とデータの発生元を基準に決めます。
- 製品候補:Core、Enterprise、Cloud Serverless、Cloud Dedicated、AWSのマネージドサービスを比べる。
- 運用条件:書込量、保持年数、直近値・過去集計の利用頻度を見て、可用性、閉域網・SSO、復旧担当も確認する。
- PoC後の構成:小規模PoCはCoreやServerlessで始め、本番化条件を満たしてから構成を変える進め方もあります。
- 収集方式:OS・クラウド指標はTelegraf、設備イベントはMQTTと、発生元に合わせて使い分ける。
- 連携体制:産業機器はOPC-UAゲートウェイ、業務アプリは独自APIを候補にし、所有者と一次対応者は選定会議に加える。
比較表には、ライセンスやデータセンター、可用性などの基本条件を書きます。
保持期間からバックアップ、監視、権限までの運用条件も、同じ表に入れます。
移行のしやすさ、サポート窓口、解約時のデータ取り出しも、比較の観点に含めます。
こうした観点を揃えておけば、導入後にデータが使えない、通知を誰も見ないといった問題を減らせます。InfluxDBの実績は、開発会社を判断する材料の一つです。
提案書と見積書では、実データの負荷試験、タグ設計、欠損・再送処理を確かめます。また、Grafanaや業務画面、IaCと設計書の納品可否も、提案書と見積書で押さえます。
フェーズ3:設計・開発でデータ契約と運用を実装
設計では、データの扱い方と、収集・画面・セキュリティの要件を固めます。
- データ契約:measurementまたはテーブル、タグ、フィールド、単位、時刻精度、保持期間、集計方法の固定。
- 時刻と単位:温度は摂氏に統一し、送信時刻と受信時刻を区別したうえで、遅延データの再計算要否も定める。
- 重複対策:重複送信を許すか一意キーを持たせるかを決めておき、二重集計や二重通知を防ぐ。
- 再送設計:ローカルバッファ、再送回数、指数バックオフ、失敗ログ、死信データの保管場所を設ける。
- 収集構成:拠点が多く回線が不安定な場合は、ゲートウェイ等で一時受信し、復旧しやすい形にする。
一方で、InfluxDBへ直接書き込む構成が適する場合もあります。Grafanaを使うと、画面の初期費用を抑えられます。ただし、承認、設備マスタ、対応履歴などの業務機能は、RDBを使うWeb画面に分けます。
セキュリティでは、TLS、最小権限のトークン、管理者と閲覧者のRBACを決めます。さらに、SSO、秘密情報の保管、操作ログを決め、バックアップ暗号化とネットワーク分離も設計します。
作業員ID、位置情報、顧客設備情報を扱う場合は、項目ごとに権限と保存期間を定義します。そのため、安全性は製品名よりも、設計と運用の中身で判断します。
個人情報保護委員会のガイドラインは、委託先の安全管理措置や再委託管理を論点にしています(出典: 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」)。
そのうえで、開発会社との契約には、アクセス範囲と事故報告を盛り込みます。ログや、データの返却・消去も、契約条件に加えます。
フェーズ4:テストで実データに近い障害を再現
テストでは、性能、データ品質、移行後の数値を確かめます。
- 性能試験:通常時とピーク時の書込性能、直近値の取得、長期集計のクエリ時間を測る。
- 運用試験:Grafanaの同時利用、アラートの発火と解除、バックアップ復元を試し、目標値と実測値を記録する。
- 性能改善:許容できない場合は、タグ数、クエリ、集計、保持期間、インスタンスサイズを見直す。
- 品質試験:センサー停止、異常値、時刻ずれ、未来時刻、遅延到着、重複送信を試す。
- 障害試験:回線断、ゲートウェイ再起動、InfluxDB停止を再現し、欠損の空欄・補間・推定値の扱いを決める。
補間値を実測値と同じ色で示すと、判断を誤るおそれがあります。そのため、画面でデータ品質を見分けられるようにします。
移行では、旧バージョン、InfluxQL・Flux、バケット、保持ポリシーを確かめます。ダッシュボードやバックアップ復元も、対象に含めます。クエリ言語や保持期間が変わると数値が一致しない場合があるため、この確認は欠かせません。
同じ期間の集計値は、移行前後で照合します。
差分の許容範囲と切り戻し条件を承認してから、本番へ移行します。
フェーズ5:稼働で監視と切り戻しを用意
本番稼働では、段階的な展開、監視、障害時の手順を整えます。
- 段階展開:全拠点への一斉展開は避け、代表的な1拠点か一部のセンサーから始める。
- 監視項目:書込量、エラー率、遅延、欠損率、クエリ時間、容量、アラート件数を監視対象とします。
- 稼働判定:現場担当者が画面で判断し、通知に対応して履歴を残せるかを見る。
- 運用手順:デプロイ、設定、バックアップ・復元、再起動、再送、通知抑止、問い合わせ先を手順として記す。
- 障害切り分け:センサー、ネットワーク、ゲートウェイ、InfluxDB、Grafana、通知先ごとに、確認ログを決めておく。
復旧できない場合に備え、切り戻しの条件と、その間に発生したデータの補完方法を稼働前に合意しておきます。
フェーズ6:定着でデータを業務改善に活用
定着には、現場の役割と定期的な運用レビューが欠かせません。
- 運用設計:技術より運用が原因になる場合が多いため、毎日の閲覧者、確認するアラートと時間、引継ぎ先、記録場所を定める。
- 現場研修:通常値、異常の見分け方、通知後の手順に絞った説明。
- 定期確認:月次または四半期ごとに、データ量、タグ種類、カーディナリティ、保持期間、クエリ遅延、欠損率を見直す。
- 費用・性能:誤検知やクラウド請求額を確かめ、高頻度データや不要なタグを整理する。
- 引き継ぎ:更新、移行、API、スキーマ、Grafana定義、IaCを、自社で再現できる状態にする。
長期分析用の集計データを別に持てば、料金と性能を分けて管理できます。
InfluxDBのシステム開発にかかる費用相場
費用は、データベースの利用料を含む開発の作業全体で決まります。作業は、要件定義、収集、データモデル、画面、アラートに分けて見ます。さらに、連携、テスト、移行、教育、保守も、別の作業として見ます。
示す金額は、業務システム開発の公開相場とリサーチノートのQ&Aを、InfluxDBの収集・可視化・連携に当てはめた見積前の目安です。
金額は、センサー数、拠点数、データ量、可用性、連携先で変わります。そのため、特定の金額を保証するものではありません。
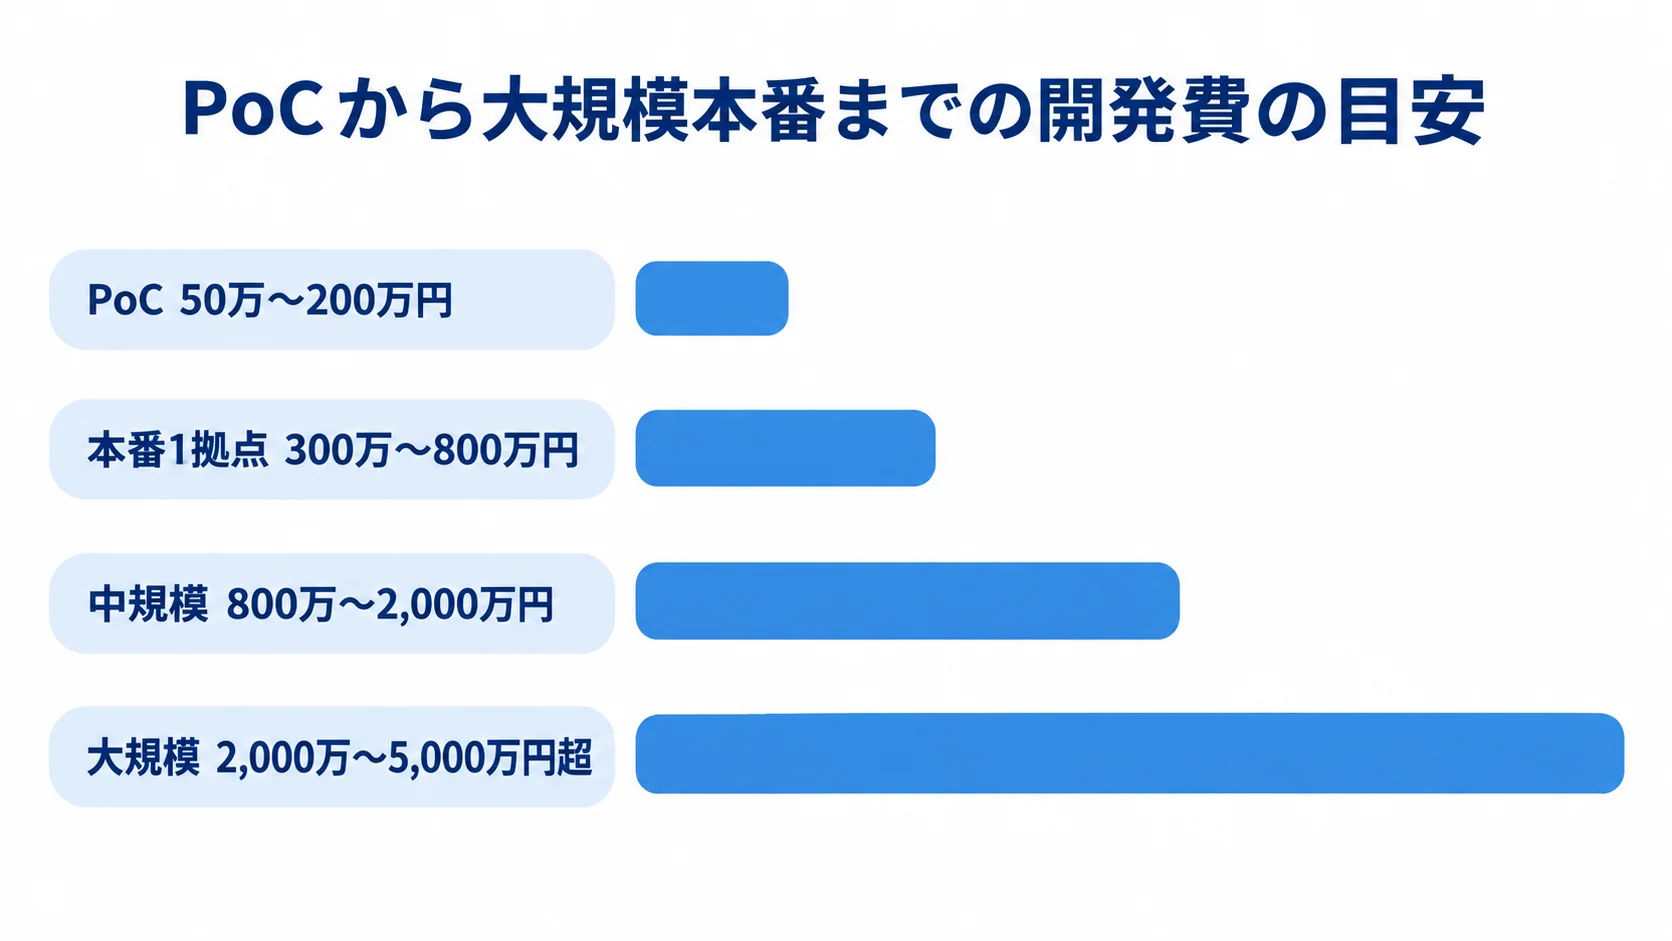
PoCから大規模本番までの開発費の目安
開発費は対象範囲や規模で異なるため、段階ごとに見積もります。
- PoC:開発費の目安は50万〜200万円程度です。
- PoC期間:2〜6週間程度。実機準備やデータ加工が必要な場合は延びます。
- 本番1拠点:収集API、欠損・再送、画面、しきい値通知、バックアップ、運用手順を含む場合の目安は、300万〜800万円程度、2〜4か月程度です。
- 中規模:複数拠点やMQTT・OPC-UA、ERP・MES連携を含む例で、800万〜2,000万円程度、4〜8か月程度。
- 大規模:高可用性・災害復旧・閉域網・監査・複数拠点を含む場合、2,000万〜5,000万円超、6〜18か月程度になる可能性があります。
PoCは、センサーやログを1〜数種類に絞り、Telegraf、InfluxDB、Grafanaで試作する形です。この段階で、性能と業務価値を確かめます。
中規模案件には、権限、履歴移行、監視、教育も含まれます。一方、大規模案件は、機能数に加えて、現場調整、データ整備、稼働時間帯の制約でも金額が増減します。
見積もりでは、要件定義、基本・詳細設計、実装の工数を分けて示してもらいます。テスト、移行、教育、管理の工数も、別に示してもらいます。
「ダッシュボード一式」では、画面数、パネル数、権限、アラート条件、更新間隔が分かりません。そのため、前提と対象外を明記してもらいます。
Cloud利用料と保守費は開発費と分けて試算
クラウド利用料と保守費は、開発費と分けて試算します。料金は、2026年8月時点のInfluxData公式ページで確認しています(出典: InfluxData「InfluxDB Pricing」、2026年8月確認)。
- Data In・クエリ:Data Inは1MBあたり0.0025ドル、クエリ100回は0.012ドルです。
- 保存・送信:ストレージは1GB・時0.002ドル、Data Outは1GBあたり0.09ドルです。
- 契約条件:無料枠やプラン上限があるため、最新の料金ページと契約プランの確認が要ります。
- 試算例:1日10GBを書き込み、平均300GB保持、月100GB送信、月10万Queryの場合、Data Inは750ドル/月です。
- 試算合計:同条件では、ストレージ432ドル、Data Out 9ドル、クエリ12ドルで、合計約1,203ドルです。
1ドル150円を仮置きすると、約18万円になります。為替、実データ量、圧縮率、保持期間によって変わるほか、無料枠、税、クラウド通信費でも変動します。
この試算は、料金の仕組みを理解するためのものです。ただし、予算を確定するには、実測データを使います。
セルフマネージドのCoreは、ライセンス費を抑えやすい方式です。一方で、サーバー、オブジェクトストレージ、監視、バックアップ、アップデート、障害対応は、自社か委託先が担います。
EnterpriseやDedicatedは、商用機能やサポートが増えるため、価格が個別見積になる場合があります。
保守費は、まず初期開発費の年15〜20%程度を一般的な目安として試算します。
24時間監視、SLA、クラウド利用料、データ量超過、追加画面、バージョンアップは、別項目で確認します。
InfluxDBのシステム開発で見積もりを取るポイント
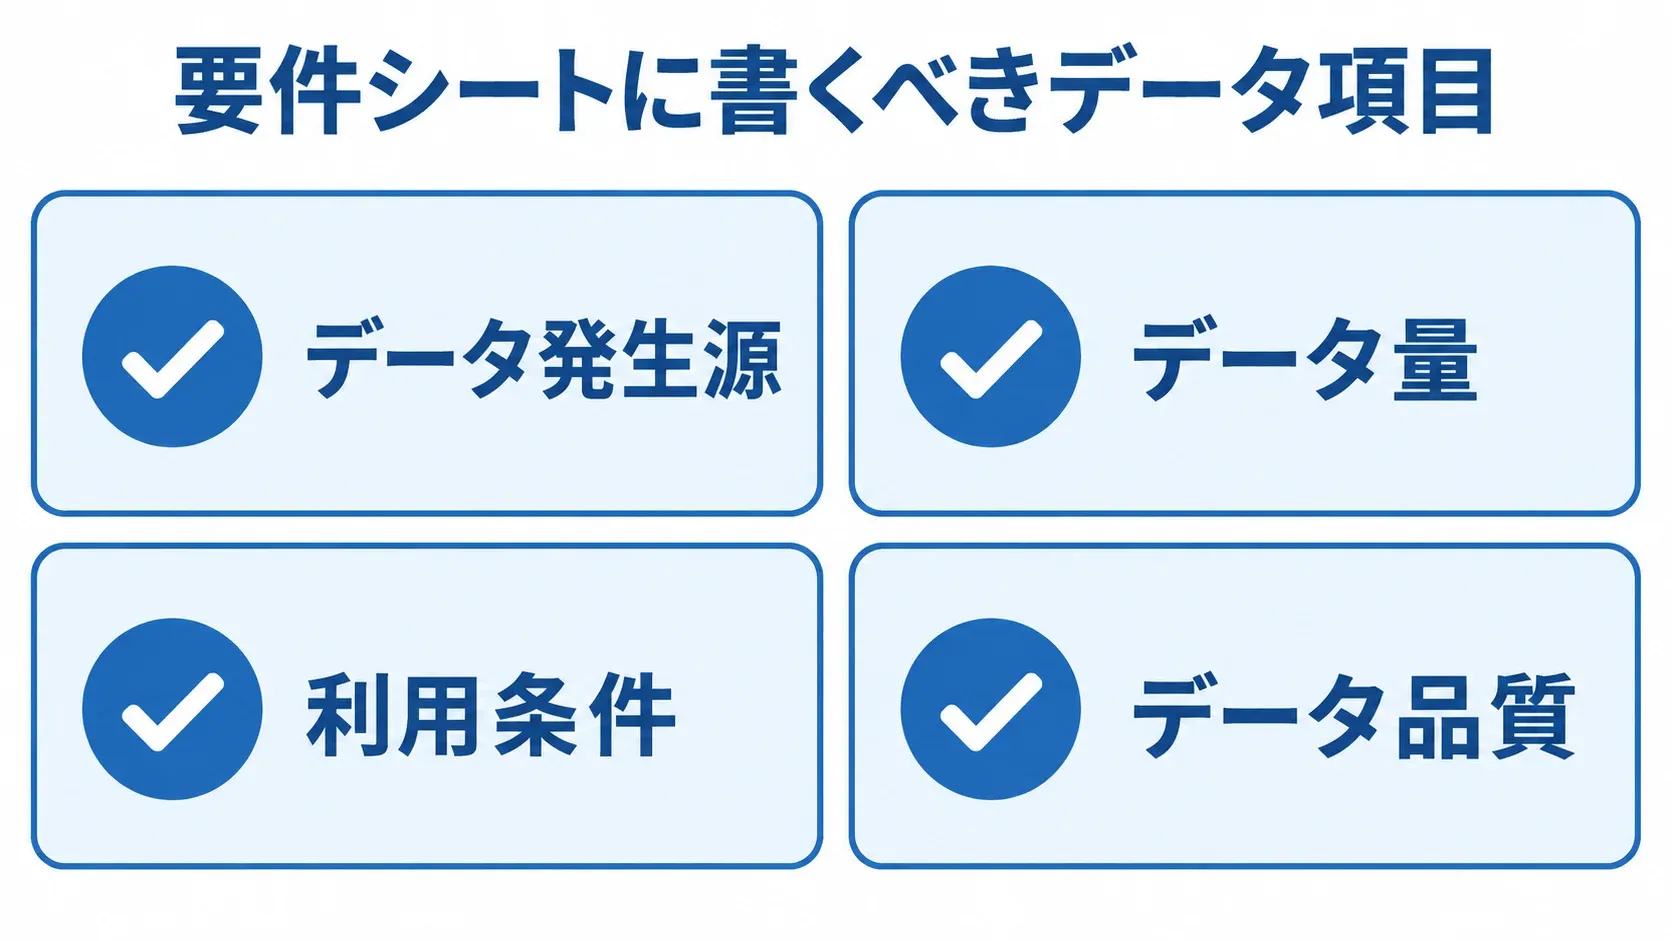
データ量や画面数の数字は、見積もりの前提を十分に示しません。そこで、発注前に要件シートをまとめ、候補会社へ同じ前提を渡します。
要件シートには、発生元と書込レート・ピーク、保持期間を記します。クエリ利用、同時利用者、連携先、障害時の業務影響も、同じシートに書きます。
提案内容と見積もりの差を比べると、金額の裏にある設計品質を判断しやすくなります。
要件シートに書くべきデータ項目
見積もりの前に、規模、利用条件、品質、情報管理の前提を揃えておきます。
- データ発生源:センサー・ログの種類、拠点数、機器台数、1台あたりの送信間隔を記載する。
- データ量:ピーク書込量、日量、保持期間、過去データの移行量の記録。
- 利用条件:直近値の表示秒数、集計期間、通知条件・通知先、利用者と権限を定める。
- 見積精度:条件が揃うと、DB規模、ゲートウェイ台数、クエリ・画面工数を算出できる。
- データ品質:欠損、重複、遅延、時刻・単位のずれ、交換時の機器ID変更の記載。
欠損を通知するか、補間するか、後から再送するかが未定なら、複数案と費用差を出してもらいます。
個人情報や設備の機密情報について、国外クラウドへの保存可否とログの保存期間も、見積もり前に明示します。
開発会社を比較するときの確認項目
開発会社は、技術対応から納品後の運用まで同じ条件で比べます。
- 技術実績:InfluxDB 3、1.x・2.xからの移行、Telegraf、MQTT、OPC-UA、Grafana、RDBの経験の有無。
- 検証・障害対応:実データPoCや負荷試験の実施、欠損等の設計、連絡体制と対応時間。
- 導入後の支援:業務聞き取りからモデル説明、教育、定着支援まで担えるかを見る。
- 費用内訳:開発・製品・クラウド・監視・保守費を分け、初年度と2年目以降を比べる。
- 納品物:要件定義書、構成図、データモデル、API・画面仕様、テスト結果の提出可否。
運用手順、バックアップ・復元手順、ソースコード、IaC、教育資料も確かめます。データ契約や復旧手順がないと、担当者が替わったときに運用が止まるおそれがあるからです。
安い見積もりに潜むリスクと対策
安い見積もりは、対象範囲と運用時の負担を確かめます。
- 対象範囲:安価な見積もりは直接書き込みを前提にし、バックアップ、通知、権限、移行、教育を外していることがあります。
- 運用費:OSSでも、運用工数や監視、更新、障害対応、バックアップ先の費用は発生する。
- 総保有コスト:見積額に加え、3年間のTCOと、障害時の担当・復旧時間を比べる。
- 小規模検証:PoCの成功条件を決め、1拠点・数種類のセンサー・画面1つ・通知1種類で試す。
- 本番移行条件:性能、欠損時の復旧、現場判断を評価し、展開条件と再利用範囲を契約に定める。
InfluxDBのシステム開発でよくある質問
導入では、製品機能に加えて、既存システムとの役割分担、データ量、運用担当者、費用の変動を同時に考えます。
発注前によく出る質問に、判断の観点から答えます。
InfluxDBとMySQLやPostgreSQLはどのように使い分けますか?
InfluxDBは、時刻に沿って増える測定値やメトリクスの書き込み、範囲検索、集計に向いています。
顧客、商品、受注、請求、設備マスタ、対応履歴など、整合性が重要なデータはRDBで管理します。両者はIDで連携させる構成が一般的です。
InfluxDB Cloud Serverlessの料金はどう見積もりますか?
Data In、クエリ、ストレージ、Data Outに分け、1日または1か月の実測値をもとに試算します。保持期間や画面利用者、自動集計の有無で、ストレージ、クエリ回数、Data Outは変わります。
まずPoCで実データを測り、そのうえで本番の予算を決めます。
料金ページは、契約直前に公式情報で再確認します。
小規模な導入でも要件定義やPoCは必要ですか?
必要です。大きな要件定義書までは要らず、目的、代表データ、書き込み量、保持期間、画面、アラート、成功条件を定めれば進められます。
2〜6週間程度のPoCで、実データに近い負荷と障害を確認します。本番化の条件を明確にしておくと、不要な機能へ先に投資するリスクを抑えられます。
作業員IDや位置情報をInfluxDBに保存しても問題ありませんか?
保存の可否は、扱う情報と管理方法を見て判断します。
- 保存判断:必要性、保存期間、アクセス権、暗号化、監査ログ、委託先管理の確認。
- 個人情報:作業員IDや位置情報を、匿名化や仮名化できないかを検討する。
- 閲覧制限:閲覧者と利用目的に応じた、RBACやSSOによる制限。
- 契約条件:委託契約、再委託、事故報告、データ返却・消去を、担当者と詰める。
本番へ進む前に、法務・情報セキュリティ担当と契約条件を確かめます。
まとめ
InfluxDB開発は、要件整理、選定、設計開発、テスト、稼働、定着の順に進めると、技術の選択を業務の成果に結び付けやすくなります。
要件整理では、目的、データ量、保持期間、欠損時の扱いを決めます。選定では、Core、Enterprise、Cloud、AWSの運用負担と可用性を比べます。
設計では、タグの増やし過ぎを避け、InfluxDBとRDBの役割を分けます。
発注前に確認する最終チェック
発注前には、要件、費用範囲、納品物、検証条件を確認します。
- 要件数値:センサー数、書込レート・ピーク、保持期間、クエリ数、利用者数を、数値で書き出す。
- 機能と費用:画面、通知、連携先を明記し、開発・クラウド・保守費の内訳を分けておく。
- 運用・納品:バックアップと復元、監視、障害対応、更新の体制に加え、成果物、コード、IaC、移行範囲。
- 検証条件:実データPoCの成功条件と、本番展開・切り戻しの条件について合意しておく。
小規模検証から本番展開へ
本番へ広げる前に、代表的な現場とデータで検証します。
- 小規模PoC:全社一斉は避け、代表データや現場を選んで、短期間で性能、品質、画面、通知対応を検証する。
- 本番計画:結果から保持期間、集計、タグ、クラウド構成を見直し、費用と運用体制に反映する。
- 導入目標:異常の早期発見や意思決定の改善を目指し、継続利用へつなげる。
▼全体ガイドの記事
・InfluxDBのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。