
社内生成AIシステム開発は、まず対象業務とデータを整理し、方式を選ぶところから始まります。そのうえで、権限を保つRAGや業務連携を設計し、テストと定着まで進めます。この流れで進めると、業務の判断や作業を速くできます。
▼全体ガイドの記事
・社内生成AIシステム開発の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
社内生成AIシステムの全体像
社内生成AIシステムは、社内資料を参照しながら回答や文書作成、要約、翻訳を支援し、業務フローにも関わる企業向けの業務基盤です。
扱う文書には、社内規程やマニュアル、FAQ、営業資料などがあります。議事録や製品資料も対象になります。
認証や検索、権限の管理に加えて、ログや回答評価、管理者機能も設計します。
RAGと権限管理を組み合わせた業務システム
中核になるRAG(検索拡張生成)は、社内文書を検索し、関連箇所をLLMに渡して回答を作ります。
モデルの記憶だけに頼る場合と比べ、社内固有の情報を回答に反映しやすい仕組みです。
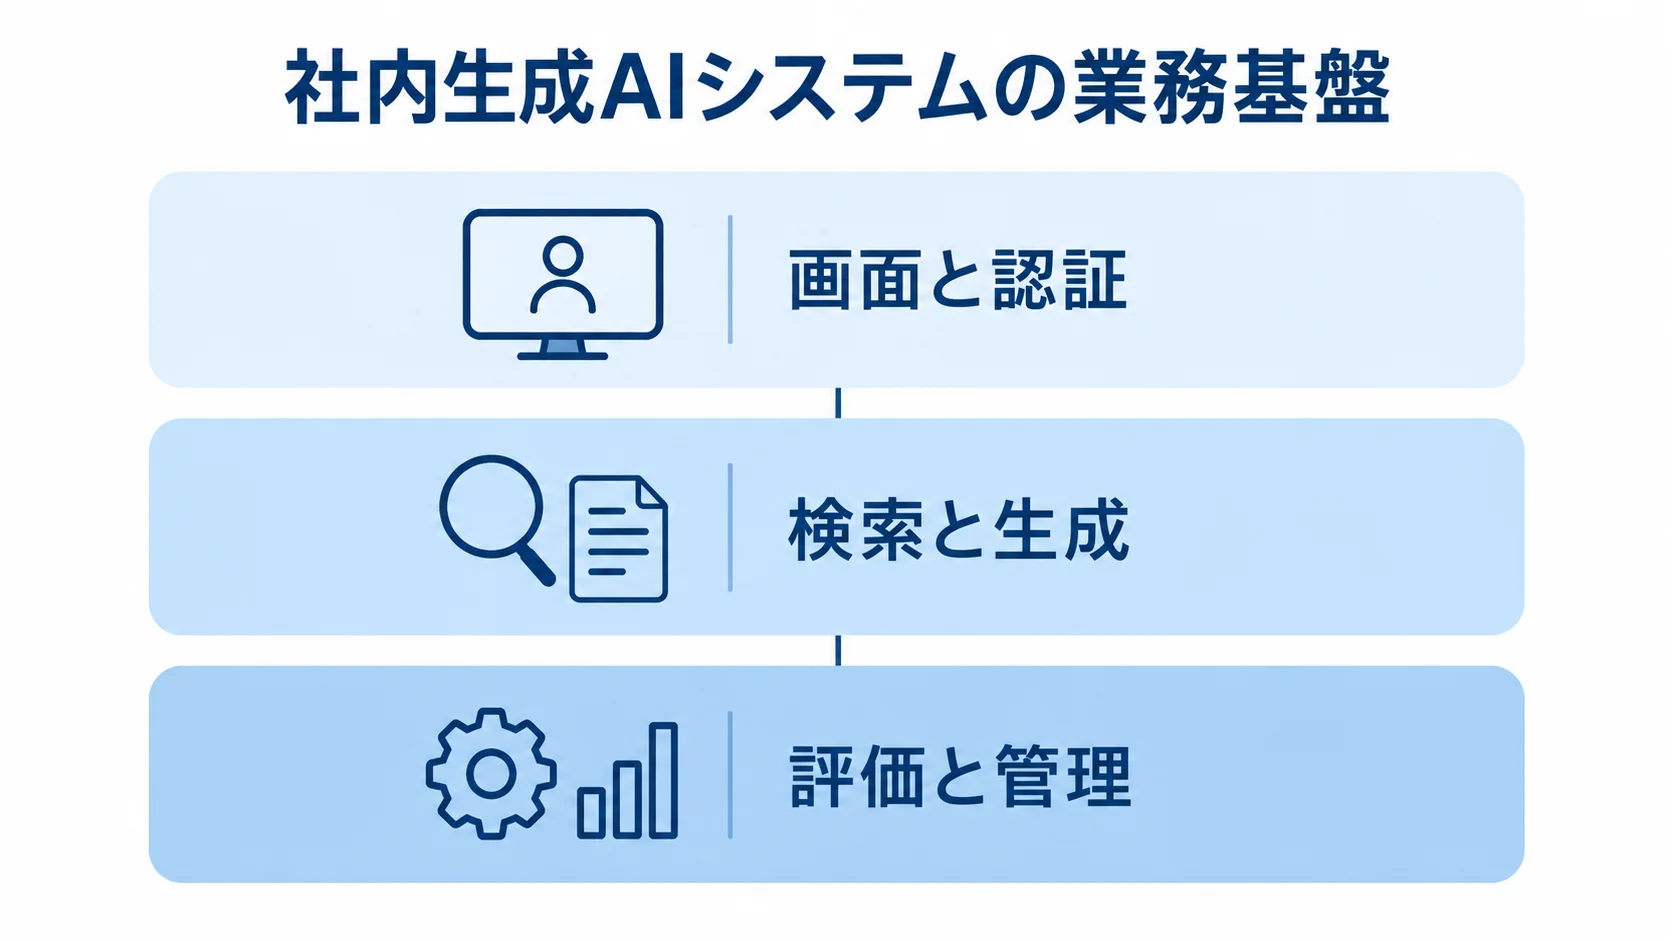
社内生成AIの画面から回答評価までは、役割の異なる層に分けて組みます。
- 画面と認証:チャットUIとSSO認証を用意します。
- 検索と生成:APIゲートウェイや業務オーケストレーション、LLM、文書検索を組み合わせます。
- 評価と管理:回答生成やログ、評価、管理機能を設けます。
文書処理には分割と埋め込みがあり、ベクトル検索と再ランキングで関連箇所を選び出します。
回答には参照元も表示します。
認証にはMicrosoft Entra IDなどを使い、部署・役職・案件単位のRBACまたはABACと組み合わせて権限を管理します。
登録した文書がすべて全社員に見せてよいものとは限りません。そのため、検索結果にも元データの権限を引き継がせます。特に、権限のない文書を回答の根拠に使わない設計が欠かせません。
回答できない場合は無理に生成せず、担当部署へ引き継ぐ条件を、精度の調整より先に決めておきます。
既製サービス、クラウド構築、スクラッチの使い分け
方式は、社内文書の検索だけを行うか、業務システムへの登録や申請まで行うかで選びます。標準機能から専用環境まで、構築の範囲と運用の場所が方式ごとに変わります。
- 標準機能:法人向けAIやSaaSで要件を満たせる場合に選びます。
- クラウドRAG:Azure OpenAI、Amazon Bedrock、Google Vertex AIなどを使って構築します。
- 個別開発:SaaSとSIerの組み合わせ、または業務ロジックを含む開発で実現します。
- 専用環境:プライベートクラウドやオンプレミスに置いて運用します。
社内文書の検索だけであれば、標準機能やクラウドRAGから始めやすい選択肢です。
CRMやERPへの登録、申請、照会まで自動化する場合は、業務連携を含む開発が必要です。
ファインチューニングは最初には選ばず、文書の更新や根拠表示にはまずRAGを検討します。部署ごとに参照範囲を変えたい場合も、RAGから検討します。
回答の語調や定型出力は、プロンプトテンプレートや評価データで改善できる場合があります。
要件はMUSTとWANTに分け、最初の対象業務は一つに絞っておきます。そうすると、予算と期間を管理しやすくなります。
最初に測定する業務効果
AIを使い始めた後の変化を比べられるよう、導入前に指標を決めておきます。
- 問い合わせ対応:問い合わせ件数、回答時間、担当者へのエスカレーション率を測ります。
- 営業支援:提案書の初稿作成時間と、参照資料を探す時間を測ります。
- 業務全般:検索時間と文書作成時間、一次回答率と申請処理時間を測ります。
情シス問い合わせでは、問い合わせ分類と回答時間を導入前の基準値として残しておきます。
NTTデータの社内生成AIサービスの公開事例では、利用者の時間削減や継続利用の意向が紹介されています。ただし、他社と同じ効果が得られるとは限りません。
自社では、利用者数や質問数、文書量を先に把握しておきます。
回答を確認する担当者の工数も記録し、効果を検証できる指標として扱います。
社内生成AIシステム開発の進め方
社内生成AIシステムの開発は6フェーズで進めると、PoCと本番運用の境目が明確になります。
各段階で次へ進む条件を定めておき、精度と権限、コストに加えて、運用責任と利用者の行動も確かめます。
各段階で作る成果物と、その判断基準も具体的に決めておきます。
フェーズ1:要件整理による対象業務とデータの絞り込み
対象業務とデータを絞るときは、利用場面、文書の状態、取り扱う情報を一緒に確認します。業務の選び方と文書の扱いは互いに影響するため、要件整理では対象業務から成果物、リスクまでを一つの流れで決めます。
- 業務と対象:誰がいつ何を尋ね、何を早めたいかを決めます。パスワードや端末の問い合わせに、規程やFAQで答える例もあります。
- 候補業務:1日あたりの質問数が多く、評価しやすく、人が誤回答を確認できる対象を選びます。
- 文書と正本:所有者、更新日、機密区分を調べ、保存先と権限、重複や廃止の有無も確かめます。そのうえで、どの版を正とするか、更新責任者、対象外文書を決めます。
- 成果物:ユースケース一覧とデータ台帳を作り、利用者・権限一覧やMUST/WANT表も用意します。
- リスクと指標:KPIとリスク一覧を作ります。個人情報や営業秘密、顧客情報の扱いと、ソースコードや契約書の扱いを確認します。
法務・情報セキュリティ部門には、PoCの前の段階で相談しておきます。入力の可否と委託先、海外保管、学習利用は、この相談で確認できます。
ログの保存と削除の方法も要件整理で決め、PoCの後まで確認を先送りしないようにします。
経済産業省が2026年3月31日に公開したAI事業者ガイドライン第1.2版は、リスク管理の基準として参照できます。
フェーズ2:選定での方式・モデル・パートナーの比較
既製の法人向けAI、クラウドRAG、既存ポータルやTeamsへの組み込みを、候補として比べます。
- セキュリティ:権限の継承と参照元の表示、学習利用、データの保管場所を確認します。
- 運用と移行:ログ保存期間、モデル変更時の移行性、障害時にどこまでを誰が受け持つかを比べます。
- 導入範囲:API連携や利用者教育を含め、各社の条件をそろえます。
RAGでは、文書分割とメタデータ、検索方式を確かめます。さらに、再ランキングや回答へ渡す文書数も確認します。
モデルは一つに固定せず、回答品質と応答時間を比べます。
選定では、入力・出力料金とデータ保護契約も比べます。
ファイルサーバーやSharePoint、社内Wiki、業務DBなど、接続先ごとにコネクタと追加費用を確認します。
開発会社には同じ質問セットで評価してもらい、デモの印象だけで決めないようにします。
評価項目には、正答率と根拠提示率を入れます。加えて、回答不能時の拒否率と権限違反ゼロも含めます。
平均応答時間と1回当たりの推定コストも測ります。また、PoCを本番へ拡張した実績も確認します。
設計書やプロンプトの納品範囲、運用担当者への引き継ぎ方法も、選定の条件に入れます。
フェーズ3:設計開発での権限と改善機能の組み込み
設計開発では、権限と文書処理、回答確認、業務操作を一体で設計します。組み込む機能は、システム構成から業務操作まで5つの領域にまたがります。
- システム構成:画面と認証、APIの役割を決めます。LLMと検索、ログ、管理画面の役割も決めます。
- 認証と権限:SSOと多要素認証を使い、部署・役職・案件属性を検索条件へ渡します。
- 文書処理:PDF・表・画像の読み取りと分割を設計します。メタデータ付与、重複除去、再インデックスも含めます。
- 回答と記録:根拠文書のタイトル、該当箇所、更新日を示します。低評価やコピーの履歴、質問分類、参照文書も残します。
- 業務操作:検索と登録を分けます。対象や金額、宛先、承認者を画面で確かめてから実行します。
元データの権限を取得できない接続先は、取り込み時か検索時に範囲を確認します。
権限変更の反映時間も要件に含めます。
たとえば、「休暇残日数を教えて」は参照処理、「休暇を申請して」は登録処理にあたります。特に、登録や送信は、AIが直接確定しない設計にします。
プロンプトインジェクションや過剰な権限、秘密情報の出力、意図しない外部送信も、脅威モデルに含めます。
フェーズ4:テストでの精度・安全性・コストの測定
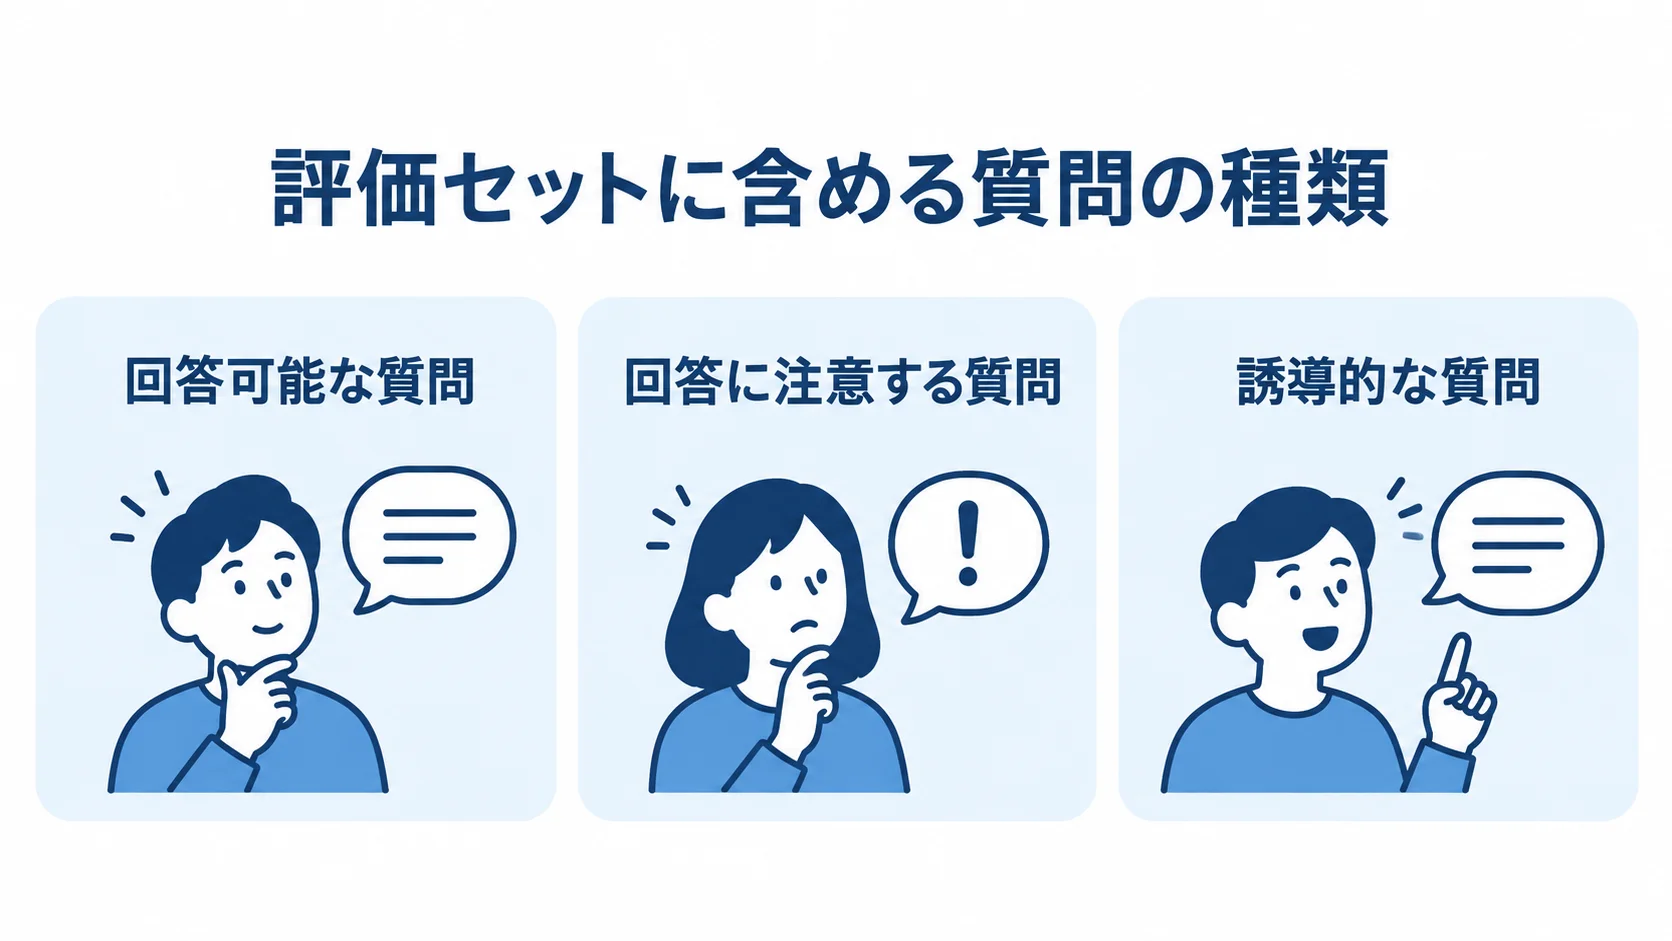
実際の質問を匿名化した評価セットと、意図的に難しくした質問を組み合わせます。
- 回答可能な質問:正答がある質問と複数文書をまたぐ質問を含めます。
- 回答に注意する質問:古い文書や回答不能、権限外の情報を尋ねます。
- 誘導的な質問:誤った前提を含む質問への対応を確かめます。
正解率に加え、根拠が回答を支えるか、引用先を開けるかを判定します。
答えられないときに「確認できない」と回答できるかも確かめます。
一般社員が人事、法務、経営会議の文書を検索できないことを確認します。
さらに、退職者や異動者の権限が反映され、秘密情報が外部へ送信されないことも検証します。
監査ログには、利用者と時刻、質問を残します。また、参照文書やモデル、回答結果も、必要な範囲で残るかを確認します。
個人情報を扱う場合は、個人情報保護委員会が出した生成AI利用に関する注意喚起も、確認材料にします。
想定ピーク時の同時利用者数と平均応答時間、タイムアウト率を測定します。1質問当たりのトークン量、検索基盤の費用、失敗時の再試行回数も記録します。
たとえば、根拠提示率90%以上、権限違反0件、平均応答8秒以内といった具合に、業務別の合格ラインを決めます。1回当たりの予算上限も定めます。未達の場合は本番化を延期します。
フェーズ5:稼働での責任者と段階展開の決定
本番稼働は、対象部門と質問範囲を絞って始めます。全社一斉の公開は避けます。
- 稼働判定:要件、未解決の不具合、セキュリティ審査を確認します。
- 運用体制:データ更新の責任者、問い合わせ窓口、障害時の代替手段を決めます。
- 利用条件:月額上限と利用規程を整えます。
利用規程には、入力禁止情報と、回答をそのまま意思決定に使わないことを記載します。
根拠の確認方法と、人へ相談する条件も明記します。
最初の部門で操作説明と短い研修を行い、利用者が回答を評価する習慣をつくります。
Teamsや社内ポータルから使えるようにすると、別の画面を開く手間を減らせます。
連携先ごとに、権限と通知、データ送信先を文書にまとめます。障害時の動作と、どこまでを誰が受け持つかも、同じ文書に書いておきます。
フェーズ6:定着でのデータ・回答・運用の改善
月次または隔週で、利用状況と低評価の回答を見直します。原因に応じて、改善先を決めます。
- 文書の不足:正解となる文書がない質問を洗い出します。
- 検索の問題:正しい文書を取り出せているかを見直します。
- 回答や権限の問題:指示の曖昧さや権限による非表示を調べます。
質問を分類すると、どこを直すかを判断できます。直す先は、文書更新と検索設定、プロンプト、モデルのいずれかです。
評価の高い質問はテンプレート化し、よく使われる部門アシスタントに反映します。
文書の更新責任者とSLAを定めておきます。規程の旧版が検索されると、業務上のリスクになります。そのため、変更管理に正本の登録と旧版の除外を含め、差分確認と再インデックスも対象にします。
テスト質問を再実行し、モデルやクラウドの仕様変更にも備えます。
プロンプトや評価セット、インデックス設定、ログを、自社で確認できる状態に保ちます。
効果を見るときは、利用者数だけでなく、導入前後の業務指標を比べます。
指標には、検索時間や問い合わせ件数、一次回答率を含めます。また、文書作成時間と誤回答の是正時間も確認します。
継続利用率と1質問当たりのコストも比べます。
効果が低い場合は、原因を切り分けます。研修不足や対象業務の選定、データ品質を調べ、機能追加を急がず、運用の改善を優先します。
社内生成AIシステムの費用相場とコストの内訳
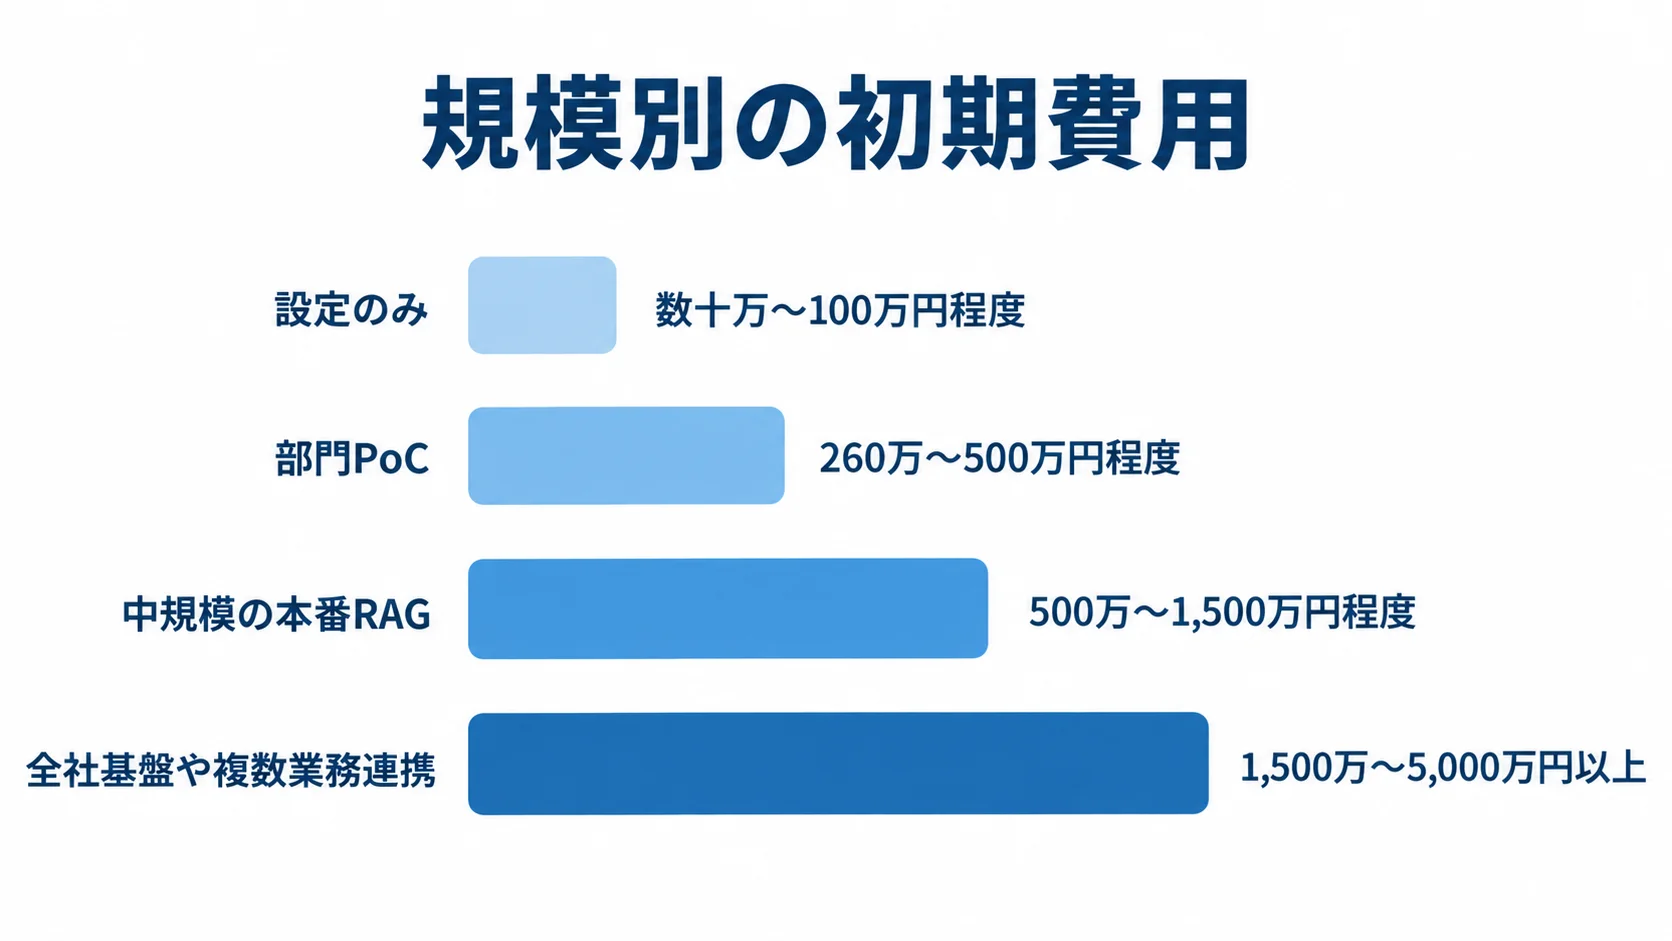
社内生成AIの費用は、設定のみなら数十万〜100万円程度、部門PoCなら260万〜500万円程度が目安です。中規模の本番RAGは500万〜1,500万円程度で、全社基盤や複数業務連携は1,500万〜5,000万円以上です。
この数字は、公開価格と構成要件から整理した参考レンジで、市場統計ではありません。
文書整備と個別コネクタ、セキュリティ審査は別見積もりになります。保守とLLM/API従量課金も、別見積もりの扱いになります。
見積もりの金額は、含まれる範囲を確認してから比べます。
規模別の初期費用と期間
小規模の法人AI設定と利用規程・SSO整備では、既存契約や利用者数によって初期費用が変わります。導入期間は、構成と対象規模で違ってきます。公開価格も、比べる材料になります。
- 部門PoC:260万〜500万円程度、期間は2営業日〜2か月程度が目安です。
- 中規模の本番RAG:500万〜1,500万円程度、設計からテストまで3〜6か月程度です。
- 全社基盤や複雑な連携:1,500万〜5,000万円以上、期間は6〜12か月以上の場合があります。
部門PoCには、文書の取り込みや質問セットの作成、評価、研修が含まれる場合があります。
サイオステクノロジーは、RAGを用いた社内ナレッジ活用AIチャットの導入を公開しています。同サービスは最短2営業日で、初期費用260万円(税抜)から、月額10万円からです(出典:サイオステクノロジー、2025年)。
公開価格を基準に、データ整備や個別連携を加えて見積もります。
中規模の本番RAGには、複数のデータソースや部署別の権限、監査ログが含まれます。
Teams連携と回答評価も含みます。
全社基盤では認証や権限が複雑になります。そのため、データ移行や審査、教育、運用設計も必要です。
オンプレミスやローカルLLMは、数千万円から変動します。GPUや冗長化の条件に加え、モデル更新や電力、保守も影響します。
初期費用の内訳(人件費・データ・連携・安全性)
初期費用の見積もりでは、作業範囲ごとに金額を分けて確認します。
- 企画と設計:企画や要件定義、UI、アーキテクチャを含めます。
- データと連携:文書の数や状態を洗い出し、移行を確認します。RAG検索や認証と権限、外部連携も含めます。
- 評価と導入:プロンプトや評価、セキュリティテスト、研修を確認します。
文書の所有者が不明、旧版が多い、部署ごとに権限が違う場合は、データ整備や権限整理が開発より大きな工数になることがあります。
SCSKは、「生成AI統合活用基盤」の初期導入を300万円(税抜)として公開しています。サポートサービスは150万円/年(税抜)です(出典:SCSK、2024年)。この価格は、すべての企業の本番総額を示すものではありません。
追加のRAG環境やTeams連携、Azure環境のカスタマイズは、別途確認します。精度評価や機能追加は、要件に応じて確認します。公開価格は、見積書の妥当性を考える基準として使えます。
ランニングコストの積み上げ(LLM以外の費用を含む)
運用費はLLM/APIだけでなく、検索や保守、文書更新などを含めて計算します。
- 基盤費:クラウドやベクトルDB、検索エンジン、埋め込み生成の費用を確認します。
- 運用費:監視やログ、バックアップを含め、保守と文書更新も見積もります。
- 継続改善費:回答評価と利用者教育の費用も見積もります。
LLMの単価だけで見積もると、アクセス制御や検索基盤の費用を見落とします。そのため、利用者数や日々の質問数、入出力トークンを前提に含めます。保存期間とピーク時間も、あわせて前提にします。
AWSの公式コスト例では、テキスト型の概念実証が月40米ドルです。また、高度にスケーラブルなRAG検索エンジンは月1,500米ドル、エージェント型概念実証は月840米ドルです(出典:Amazon Web Services、2026年参照)。
同じAWSでも、費用は文書数やクエリ数、VPCで変わります。検索サービスやガードレール、モデルによっても違います。
クラウドの例示額には、開発会社の人件費は含まれません。そのため、システム全体の月額とは分けて考えます。
外貨換算やAPI価格の変更、モデル切り替えに備え、月額上限とアラートを設定します。
利用増加時の従量課金や低評価回答の再生成を試算し、キャッシュやログ保存期間も見積もります。
平均利用時と繁忙期を分けて月額を見積もると、稟議の後の予算超過を防ぎやすくなります。
社内生成AIシステムの見積もりを取る際のポイント
見積もりの精度は、発注者が渡す前提条件で決まります。そのため、対象業務や利用者数、文書量を同じ資料にまとめます。更新頻度やデータソース、認証方式も、一緒に記します。
必要な連携や評価方法、導入期限、運用担当者も記載します。
3社程度へ同じ条件で依頼します。
「社内生成AI一式」のように要件が曖昧だと、会社ごとに範囲が変わります。そのため、含まれる作業を明確にし、安い見積もりが後から追加費用になるのを防ぎます。
RFPに書くデータ・権限・評価条件
RFPや要件メモには、見積もりと評価に必要な前提をまとめます。
- 利用と文書:部門と利用者数、月間・日次の質問数を記載します。文書形式や容量、更新頻度も書きます。
- 接続と権限:保存先やSSO、多要素認証を示します。部署別の制御と根拠表示、ログ期間も挙げます。
- 安全と運用:機密情報や外部送信、学習利用の扱いを明記します。回答禁止条件と障害時の人手対応も含めます。
評価には、正解率に加えて、自社の質問による評価セットが要ります。評価セットは30〜100問程度とし、各問に正解と根拠文書を定めます。さらに、許容回答や、回答してはいけない条件も書いておきます。
質問数は企業ごとに調整できます。同じセットを使えば、各社を同じ条件で比べられます。そのうえで、根拠提示率や拒否の適切さ、応答時間、コストを比べます。
評価セットに機密情報がある場合は、匿名化または安全な検証環境を求めます。
見積書の比較と別途費用の確認
工程別の金額と契約条件を分けて見ると、各社の見積範囲を比べやすくなります。
- 工程:要件定義と設計、開発、データ移行を分けます。テストや研修、リリース支援、保守も分けて記します。
- 費用区分:固定費と従量費、初年度と2年目以降、標準機能と追加開発を分けます。
- 変更時の単価:文書や利用者、モデルの追加費用を確認します。連携先や審査工数の追加費用も確かめます。
各社の数字は、区分をそろえて初めて比べられます。
クラウド費用と開発会社の運用費も、別に確認します。
価格に加えて、成果物の所有権と撤退条件も、契約前に確かめます。設計書やデータ変換スクリプト、プロンプトのほか、評価セットやログの取り出し方法を明記します。API仕様やインデックス設定を納品するかも確認します。
PoCが基準に届かない場合は、本番契約へ自動で移らないことを契約に盛り込みます。
クラウドやモデルの変更可否、障害時の復旧担当も決めておきます。
質問項目による安全性の確認
ベンダーの回答を具体的にするため、契約や検証方法について質問します。
- データ利用:入力をモデルの学習に使わない契約か、保存リージョンはどこかを尋ねます。
- 権限と攻撃対策:権限変更の反映時間や検索テスト、インジェクション検知を確認します。
- 個人情報:マスキングの可否と、標準機能か追加開発かを聞きます。
海外保管や第三者提供の有無も確かめます。回答が「対応可能」だけの場合は、実証方法と責任者を確認します。
低評価の回答を誰が確認し、何営業日以内に文書や検索設定を直すかも決めておきます。
モデル障害やクラウド停止、文書管理停止、誤回答による影響に備えます。
停止、縮退、人への引き継ぎ手順を用意し、保守範囲に評価、文書更新を含めるか定めます。モデル変更と脆弱性対応の担当範囲も明確にします。
社内生成AIシステムについてよくある質問(FAQ)
導入前によく相談される疑問を取り上げます。答えは、方式や扱う情報によって変わります。自社の業務や文書、権限、利用量に当てはめて考えます。
社内生成AIシステムはChatGPTの法人版だけで十分ですか?
標準機能で、権限管理やログ、利用規程、評価を満たせるなら、法人向けAIの設定から始められる場合があります。
SharePointや業務DB連携、部署別の検索制御が要るなら、RAGや業務システム連携を含む開発が必要です。根拠表示や申請、登録が必要な場合も、開発の対象になります。
要件整理でMUSTを決めてから、方式を選びます。
RAGとファインチューニングはどちらを先に選べばよいですか?
社内文書を検索して根拠付きで回答するなら、通常はRAGを先に検討します。文書の更新を検索インデックスに反映しやすく、参照元や権限も管理しやすいためです。
回答形式や語調は、プロンプトや評価で改善します。固有の出力パターンが必要な場合に、ファインチューニングを検討します。
社内生成AIシステムのPoCはどのくらいの期間が必要ですか?
PoCの期間は、対象部門やデータの範囲によって変わります。画面の作成と本番運用の完成度は、分けて考えます。
- 期間の目安:認証と文書管理を使い、対象を絞る場合は数日〜2か月程度です。
- 品質の確認:正答率や根拠提示、権限遮断を測ります。応答時間と1回当たりのコストは、あわせて押さえます。
- 投資判断:利用者の継続意向も確認し、本番化の条件で次の投資を決めます。
機密情報を扱う社内生成AIシステムは安全ですか?
安全性は、契約、技術、社内運用を合わせて確かめます。LLMの名称だけで判断すると、確認が抜けやすくなります。確認は、契約とデータ、技術的な制御、環境と運用、利用者の対応の4つの面で行います。
- 契約とデータ:学習利用と保管場所、海外保管、第三者提供を確認します。
- 技術的な制御:認証や権限継承、入力制御を確かめます。ログや監査、権限外文書の検索可否も含めます。
- 環境と運用:機密度に応じて、クラウドや閉域、プライベートクラウド、オンプレミスから選びます。
- 利用者の対応:危険な情報を入力しない規程と、誤回答を人が確認する手順を整えます。
開発会社を選ぶときに最も重視すべき点は何ですか?
自社と似たデータ、権限、利用規模での本番運用実績を確認します。
RAG評価や権限テスト、データ更新、ログ監査を、誰が担当したかを尋ねます。PoC後の移行や改善についても尋ねます。
3社程度へ同じ評価セットとRFPを渡し、価格や成果物を比べます。運用範囲と将来の移行性も、あわせて比べます。
まとめ
6フェーズと本番化の条件の社内共有
本番化へ進む前に、開発の段階と対象業務、費用の目安を社内で共有します。社内で判断するときは、開発の流れ、PoCの準備、設定と部門PoCの費用、本番の参考額の4点を押さえます。
- 開発の流れ:要件整理、選定、設計開発、テスト、稼働、定着の6段階で進めます。
- PoCの準備:質問数や効果を測れる業務を一つ選びます。
- 設定と部門PoC:設定のみは数十万〜100万円程度、部門PoCは260万〜500万円程度です。
- 本番の参考額:中規模RAGは500万〜1,500万円程度、全社基盤や複雑な業務連携は1,500万〜5,000万円以上です。
文書の所有者や更新日、機密区分、権限を整理してから、PoCへ進みます。
公開価格と市場統計は、意味が異なります。文書整備や個別連携、審査は別に発生します。保守と従量費も別途かかります。
見積もりの比較(精度・安全性・運用費)
回答が流暢かどうかに加えて、安全性や運用、契約条件をそろえ、発注先を比べます。
- 品質と安全:権限外の情報を出さず根拠を示し、回答不能時は人へ引き継げるか確かめます。
- 評価と運用:RFPに評価セットや受入基準を記載します。運用責任者と月額上限も書きます。
- 契約と移行:成果物の所有権、撤退・移行条件を確認し、導入後の改善体制も比べます。
▼全体ガイドの記事
・社内生成AIシステム開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。