
在庫配置最適化システム開発は、6つのフェーズを順に進めます。最初は要件整理で、次に選定、設計・開発・連携と続きます。その後、テストと効果検証、段階稼働を経て、定着で終わります。この流れに沿うと、在庫とサービスレベルの両立につながります。
全体像は在庫配置最適化システム開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・在庫配置最適化システム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
在庫配置最適化システム開発の全体像
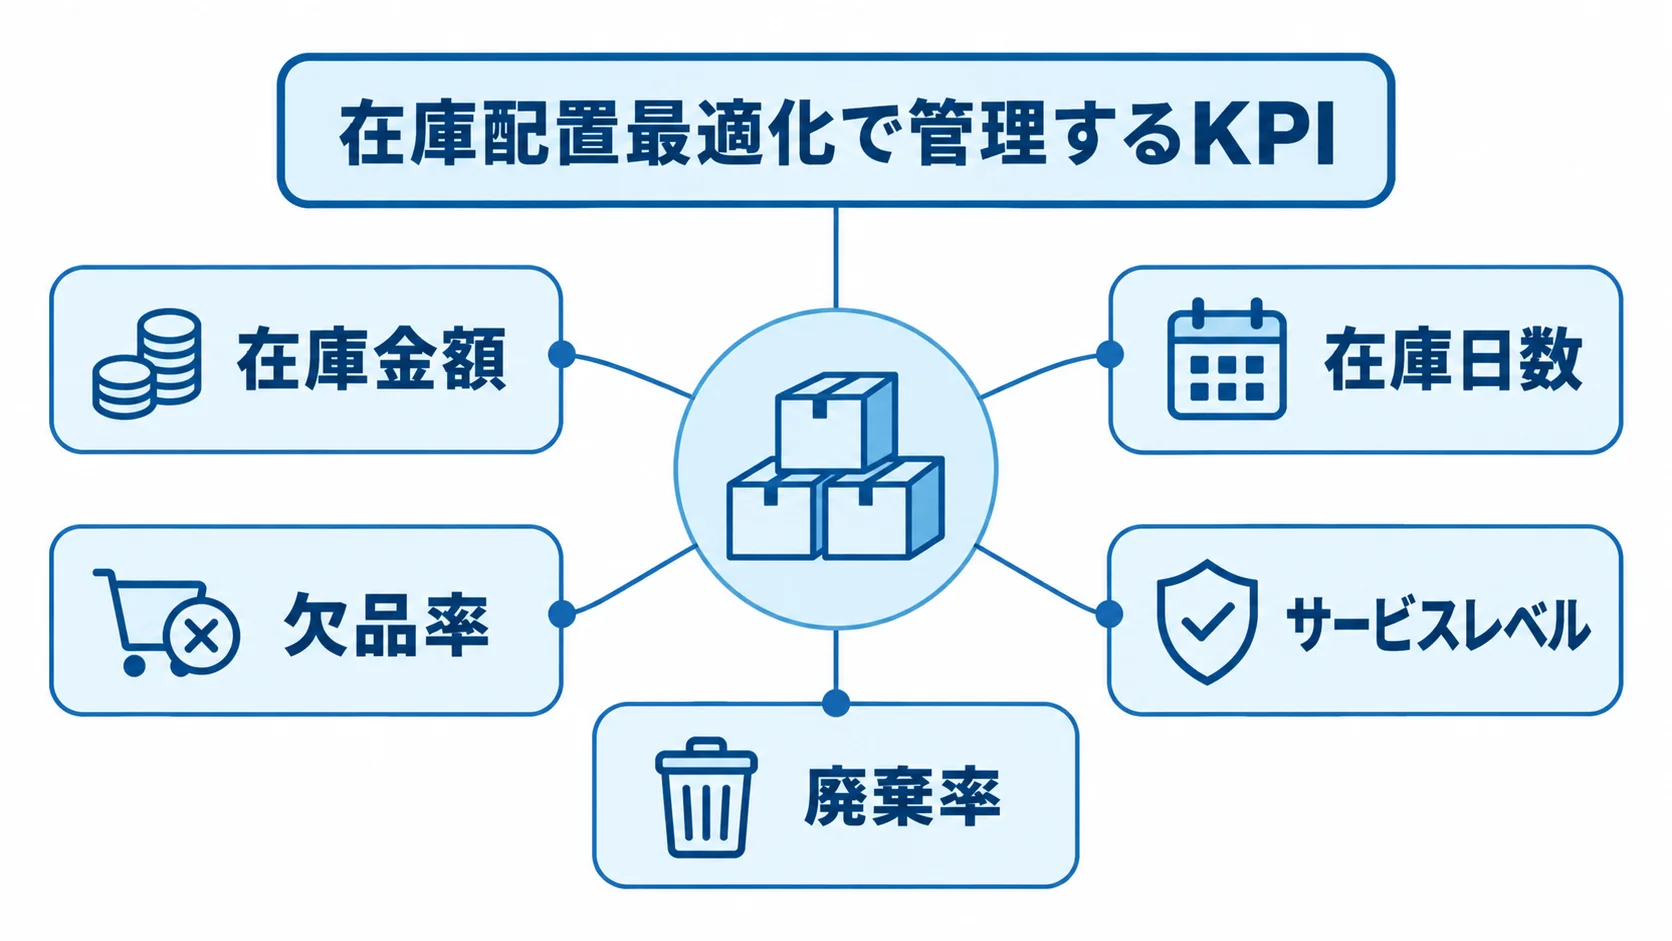
在庫配置最適化では、欠品を抑えて納期やサービスレベルを守りながら、総コストを適正化します。
在庫金額だけを小さくする仕組みではありません。
総コストには、保管、廃棄、緊急輸送も含まれます。
最適化する対象を社内で共有しておくと、後工程の要件と見積もりがぶれにくくなります。
在庫管理システムとの違い
在庫管理は現在庫を記録する役割で、配置最適化は将来の補充量や配分を計算する役割です。計算に使うデータも、両者で異なります。
- 在庫管理:入荷、出荷、棚卸し、ロケーションの記録と現在庫の把握
- 配置最適化:将来の補充量や配分の計算
- 計算データ:販売履歴、受注、入荷予定、リードタイム、発注ロット、安全在庫、拠点間輸送条件
現在庫が不正確だと、アルゴリズムの提案も誤ります。そのため、導入前に商品、拠点、仕入先のマスタを統一し、帳簿在庫と実在庫の差を確認しておきます。
連携対象には、POS、受注、出荷のデータが含まれます。購買や生産も対象になります。
ERP、WMS、販売管理、BIとも連携します。特に、データの欠損や商品コードの表記揺れは、AIを追加する前に直しておきます。
最適化する範囲とKPI
関係者によって重視する指標は異なります。同じKPIだけを追うと、在庫削減が欠品増加を招くことがあります。
- 経営層:在庫金額、キャッシュフロー
- SCM責任者:在庫回転率、サービスレベル
- 物流責任者:拠点配置、輸送費
- 現場:欠品対応、入力負荷
最低限、在庫金額、在庫日数、在庫回転率を在庫の指標として押さえます。
欠品率、サービスレベル、廃棄率、緊急輸送費、予測誤差も、セットで管理します。
目標には、「在庫金額を10%削減する」に加えて、重要SKUのサービスレベルを維持する目標も含めます。
欠品率を現状より悪化させず、拠点間移動と緊急出荷を減らす条件も定めます。
サービスレベルは、注文に対して在庫で即時対応できた割合など、自社業務に合う定義を先に決めておきます。
目標と制約が決まれば、計算ロジックと導入効果を検証しやすくなります。
在庫配置最適化システム開発の進め方
業務とデータを整理してから段階的に進めると、開発会社への丸投げによる失敗を減らせます。
進め方は6つのフェーズに分け、各フェーズで成果物と判断基準を残します。
第1フェーズ:要件整理と業務・データ診断
要件整理では、まず対象範囲を決め、次に現場の業務条件とデータの状態を確認します。
- 対象の商品カテゴリ、拠点、倉庫、店舗、工場、仕入先、期間を決めます。SKU数や拠点数に加え、季節性や欠品時の代替可否も押さえます。
- 業務条件を棚卸しし、補充判断や例外処理の実態を現場に確認します。
- 業務フロー、現行システム一覧、データ項目表、マスタ責任者表、課題一覧、KPI定義、対象範囲を要求整理書にまとめます。
- 過去12〜24か月の販売、受注、出荷、在庫、購買、入荷実績を確認し、欠損率やマスタ不整合も数値化します。
- 「連携できるはず」と推測せずサンプルデータを取得し、粒度、更新頻度、履歴保持を実データで確かめます。
確認する条件は、賞味期限、最低発注量、発注ロット、輸送リードタイム、入荷曜日、拠点ごとの保管上限です。
現場にはExcelや電話で行っている補充判断、例外処理、手動上書きの理由を聞きます。
第2フェーズ:開発会社・製品の選定
選定では、知名度や機能数だけでなく、業界、拠点構成、既存ERP/WMSとの連携実績を確認します。候補は得意領域ごとに比較します。
- 計画パッケージ:在庫配置や需要予測に強い製品
- 大規模SI:基幹システムを含む構築
- AIモデル開発会社:個別ロジックの開発
- 受発注・在庫SaaS:標準機能を使った導入
標準機能と個別開発の範囲を分けて提案する会社は、将来費用と責任分界を把握しやすい傾向です。
RFPには、対象SKU・拠点、KPI、連携、計算頻度を記します。
さらに、What-ifシミュレーション、承認、手動上書き、操作ログ、権限も盛り込みます。
障害時の手動運用、移行、教育、保守も記載します。そのうえで、最低でも3社に同じ条件で提案を依頼します。
PoCの範囲、検証用データ、成功基準、納品物、追加費用の条件は、各社でそろえます。また、マスタ整備、モデル再学習、稼働後の改善を誰が担うかも、選定表に入れます。
第3フェーズ:設計・開発・連携
設計から連携まで、業務上の判断根拠を確認できる形で組み立てます。
- システム設計:データモデル、ロジック、画面と権限の設計
- 承認・例外処理:承認フローと例外時の扱い
- 計算手法:課題に合わせた予測・最適化手法の組み合わせ
- データ連携:API、ETL、CSVなどからの方式の選定
- 処理頻度:商品ごとの計算間隔の調整
手法には、統計的な需要予測、機械学習、線形計画・混合整数計画、ヒューリスティックがあります。手法を選ぶときは、高度さよりも、配分理由を担当者が確認できることが重要です。
まず、商品、拠点、仕入先の項目対応表を作ります。在庫、受注、出荷、入荷予定、リードタイムも、同じように対応表にします。また、日次計算で足りる商品と時間単位で更新する商品を分けると、処理量と運用費を抑えられます。
画面には、推奨値、計算日、前提条件、欠品リスク、上書き理由、承認者を表示します。このため、現場が例外を安全に処理できるようにします。
第4フェーズ:テストと効果検証
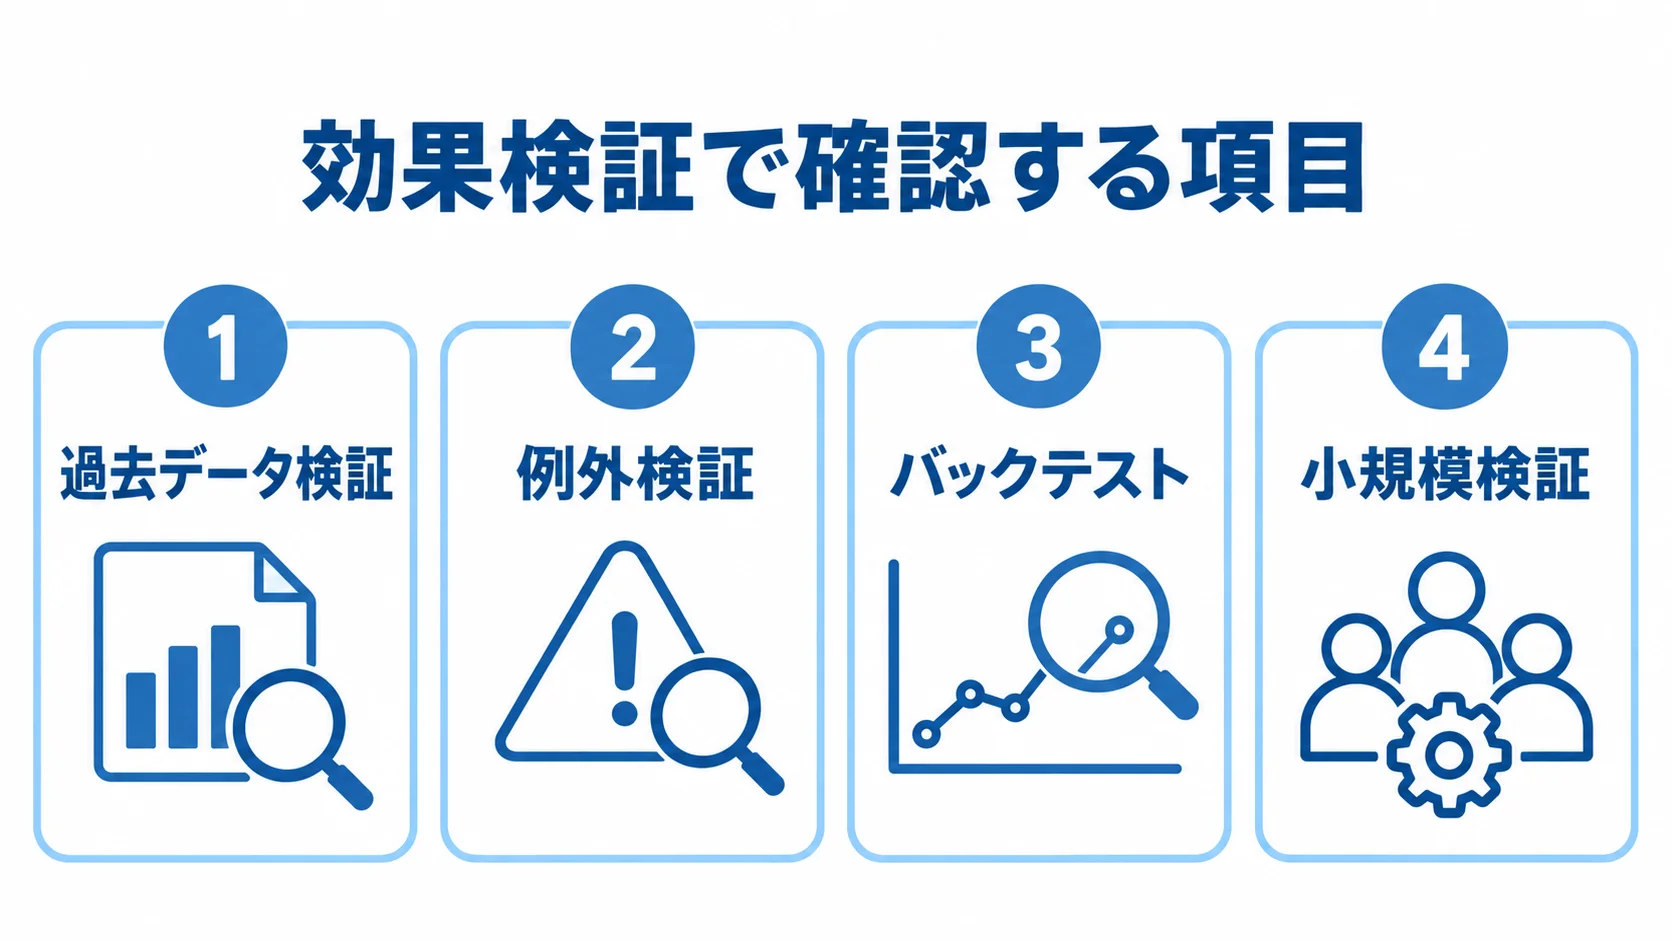
テストでは、過去データや例外ケースを使い、推奨値と導入効果を段階的に確かめます。
- 過去データ検証:通常月、繁忙期、キャンペーン、需要急増の各場面
- 例外検証:納期遅延、欠品、拠点停止、返品、商品終売の再現
- バックテスト:学習期間と評価期間を分けた検証
- 小規模検証:商品カテゴリや店舗群を限定したPoC
- 受入基準:予測誤差、欠品率、サービスレベル、在庫日数、廃棄、緊急輸送、作業時間
株式会社データフォーシーズは、大手アパレル企業の公開事例として、AI需要予測による店舗別配分と在庫調整の自動化を紹介しています(出典: 株式会社データフォーシーズ「AI需要予測に基づく最適発注モデル」掲載事例、2025年確認)。
画面やAPIの動作を確かめるほか、通常月などでは推奨値の妥当性を現行の判断と比べます。例外ケースでも、現行の判断とシステム推奨を照らし合わせます。
バックテストでは、過去の実績を未来の情報として誤って使わないようにします。
また、PoCでは配分提案が販売機会と在庫に与える影響を確認します。推奨値を採用しない理由も記録し、現場の修正結果を次のモデル改善に使います。
合否を在庫削減率だけで決めず、説明可能性、操作性、データ更新の安定性、異常時の復旧手順も確かめます。
第5フェーズ:稼働と段階展開
本番切替では、小規模な稼働確認と障害時の備えを整えてから展開します。
- 段階稼働:対象を絞った本番稼働
- 業務確認:推奨から発注・実績反映までを一連で確かめる
- 切替判定:移行データと本番運用の条件の確認
- 障害対応:障害やAPI停止に備えた手動運用の準備
- 物流計画:物流の改善にも在庫配置データを活用
導入は1カテゴリ・1〜2拠点から始め、全社同時には進めません。最初の拠点では、データ連携、推奨値の確認、承認、発注、拠点間移動、実績の戻しを、ひとつの業務サイクルとして回します。
旧Excelを残す場合は、二重入力の期間、正とするデータ、終了条件を決めておきます。切替の判定では、まず移行データの件数と金額を確認します。そのうえで、連携エラーや未処理受注、権限、バックアップ、問い合わせ窓口も確認します。
クラウド障害やAPI停止に備えて、直近の承認済み補充表を出力し、手動運用へ切り替えられるようにします。
物流効率化法では、すべての荷主・物流事業者への努力義務が2025年度から実施されています。一方で、一定規模以上の特定事業者への義務は2026年度から実施されています(出典: 国土交通省「物流効率化法」関連資料、2026年)。
物流計画では、出荷頻度や積載、荷待ちの改善も検討します。
第6フェーズ:定着と継続改善
稼働後はKPIと例外を見直し、運用体制と改善手順を継続して整えます。
- 月次または週次でKPIと予測誤差を確認し、需要急変や手動上書きが多い商品を例外リストにします。
- 欠品や過剰在庫が続く拠点の原因を調べ、販促計画の未連携ならデータを、リードタイム変動なら制約を直します。
- 合理的な現場判断は上書きルールに取り込みます。業務責任者、データ・マスタ責任者、システム管理者、ベンダーの役割を分けます。
- 再学習頻度、マスタ変更承認、障害連絡先、脆弱性対応、バックアップ、契約終了時のデータ返却を定めます。
- 推奨値の見方、例外処理、手動上書き、問い合わせ方法を手順書と研修で伝え、導入効果を毎月共有します。
在庫配置最適化システムの費用相場とコスト内訳
専用システムの価格は、対象範囲、SKU・拠点数、既存システムとの連携によって変わります。また、予測モデル、制約条件、画面、移行、教育も費用に影響します。
公開されている価格が少ないため、在庫管理、受発注、SCP、AI需要予測などの近接案件から整理した目安を示します。予算は、要件整理のあとに同じ前提で相見積もりを取って確定します。
導入パターン別の費用目安
導入形態ごとに初期費用と期間を比べると、予算の規模を整理しやすくなります。特に標準SaaSは、月額も確認しておくと役立ちます。
- 標準SaaS:在庫の見える化を優先する場合、初期0〜150万円程度、月額1.5万〜40万円程度、1〜3か月
- クラウドSCP・パッケージ:設定・連携を加える場合、初期500万〜3,000万円程度、3〜9か月
- AI・独自ロジック開発:AI需要予測や独自の在庫配置ロジックを個別開発する場合、1,500万〜5,000万円程度、6〜18か月
- 大規模刷新:5,000万〜3億円以上の場合もある
示した金額は、専用の在庫配置最適化システム開発費ではありません。
たとえば、TS-BASE受発注の公開料金例には、初期50万円・月額14万円、初期67万円・月額18万円、初期95万円・月額25万円があります(出典: 竹田印刷株式会社「TS-BASE受発注 料金のご案内」、2026年確認)。各推定レンジも、拠点数や連携本数によって変わるため、金額は断定できません。
初期費用とランニングコストの内訳
見積もりでは、初期費用と運用費を分けて、各作業やサービスの範囲を確認します。
- 初期費用:要件定義・企画、業務・画面・データ設計、連携、予測・最適化ロジック、開発、テスト、移行、教育
- 運用費:クラウド、ライセンス、API・ETL、データ保管、監視、保守、問い合わせ、脆弱性対応、再学習、マスタ更新、追加教育
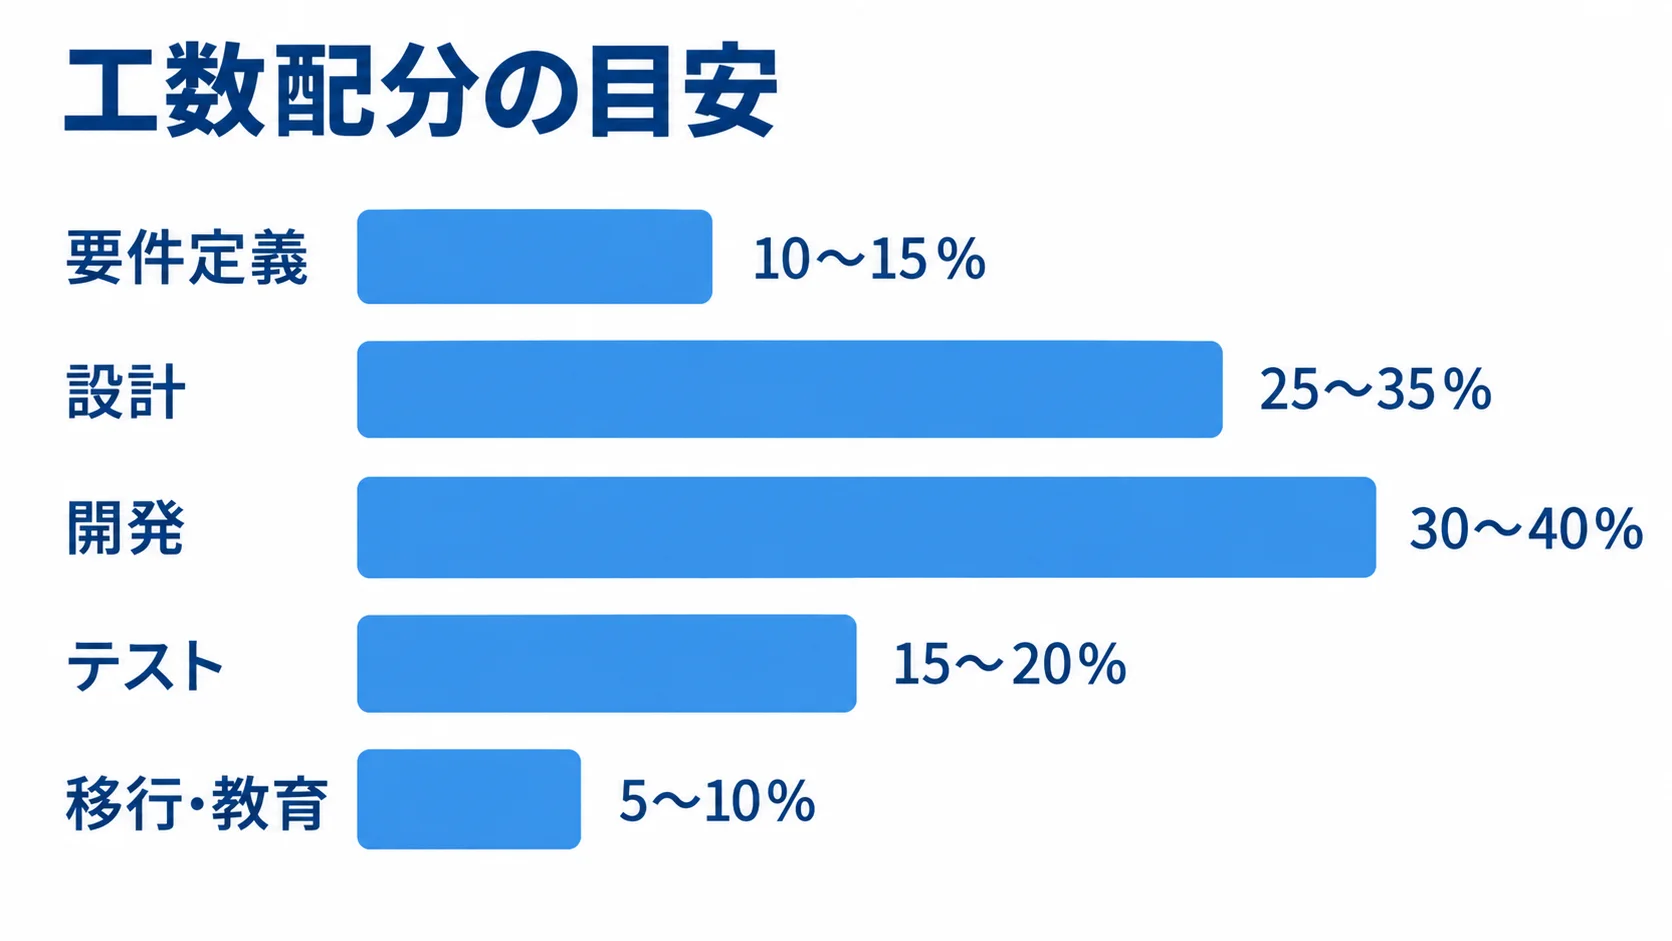
工数配分は、要件定義10〜15%、設計25〜35%、開発30〜40%、テスト15〜20%、移行・教育5〜10%程度が確認の材料になります。ただし、要件の複雑さによって変動します。
年間保守は、初期費用の10〜20%程度とする提案もあります。なお、AIモデルや大規模連携は別途費用です。3〜5年のTCO(総所有コスト)は、クラウド移行、運用、改修も含めて比較します。
見積もりを取る際のポイントとチェックリスト
見積もりの差は、開発会社の単価だけでなく、作業範囲から生まれます。そのため、データ移行、マスタ整備、PoC、現場教育、稼働後の改善が別紙扱いになっていないかを確認します。
比較表は、費用と保守の二つの面から欄を分けて作ります。費用の面では、初期費用、月額・年額、連携費、移行費を並べます。教育費や追加改修単価も欄に入れ、保守の面では、保守範囲と契約終了時のデータ返却を確認項目にします。
要件とデータ前提の整理
見積もり条件をそろえるため、RFPの要件と確認するデータをまとめます。
- RFP:対象拠点・SKU・期間、更新頻度、予測粒度、制約、発注・配分・移動、利用者数、権限、既存システム、データ量、連携方式
- データ確認:商品・拠点コードの一意性、販売実績の欠損、返品・キャンセルの扱い、在庫評価単価、入荷予定の更新、リードタイムの実績、発注ロット、廃番・新商品の扱い
「最適化」が何を指すのかも明示しておきます。在庫金額の最小化、欠品率の抑制、輸送費の削減、利益の最大化では、必要なデータや画面、計算結果が異なるためです。
データ品質が低い場合は、開発費にデータクレンジングを含め、業務側の担当者と期限を決めます。データ準備を発注先だけに任せると、稼働直前の追加費用や遅延につながりやすくなります。
複数社の同じ条件での比較
候補会社の業務理解、実績、連携経験、提案範囲は、同じ条件で確認します。
- 体制と実績:類似業界・拠点規模の実績、データサイエンティストと業務コンサルタントの体制
- 検証力:ERP・WMS・販売管理との連携経験、需要急増や納期遅延への対応
- 提案範囲:標準、設定、個別開発、将来対応の区分
製品のデモだけでなく、自社のサンプルデータで試し、その結果を説明してもらいます。
大規模な計画製品を扱う会社と、AIモデルを個別開発する会社では得意領域が異なります。
SAP IBPは需要・供給・在庫計画を統合し、What-ifシミュレーションや多階層在庫最適化を提供しています(出典: SAP「SAP Integrated Business Planning 機能」、2026年確認)。
製品機能に加えて、既存ERPとの連携、導入パートナーの設定範囲、運用担当者の育成、追加開発の境界も確認します。
リスク・セキュリティ・保守の見積もり
在庫配置は発注・生産・出荷に影響し、システム停止が事業停止につながる可能性があります。そのため、停止時の備えと保守条件も見積もりに含めます。
- セキュリティ:多要素認証、最小権限、通信・保存時の暗号化、操作ログ、脆弱性対応、API認証
- 復旧と契約:バックアップ、復旧目標、委託先の責任分界、データの保管場所・保持期間・削除方法、再委託先
- 保守と納品:対応時間帯、重大度別の初動、精度監視、再学習、OS・ミドルウェア更新、仕様変更、データ形式、API仕様、計算ロジック説明、手順書、ログ出力
個人情報や取引先情報を扱う場合は、機微情報の扱いを踏まえて、上の各条件を確認します。
初期見積もりが安くても、保守や追加改修の条件が不透明なら、3〜5年の総額が高くなることがあります。
在庫配置最適化システム開発でよくある質問
「AIならすぐ在庫が減るか」「小規模でも効果が出るか」「既存ERPを置き換える必要があるか」という質問に答えます。
在庫配置最適化システムはAIだけで実現できますか?
在庫配置最適化には、AIや統計モデルによる需要予測に加えて、発注ロット、納期、保管容量、輸送条件を計算に含める必要があります。さらに、欠品時の優先順位も制約として扱います。
データ欠損や在庫のずれがある場合は、マスタと業務の整備を優先します。
拠点数やSKU数が少なくても導入する価値はありますか?
導入する価値はあります。ただし、最初から大規模な個別開発にする必要はありません。
まずは、1カテゴリ・1〜2拠点で過去データを使ったバックテストを行います。作業時間、欠品、過剰在庫、緊急出荷の改善度を確認します。効果があれば、対象の拠点や商品を広げ、初期投資と現場負担を抑えます。
既存のERPやWMSを置き換えずに導入できますか?
置き換えずに導入できる場合が多いです。既存基盤と最適化機能の役割を分け、連携時の確認点も整理します。
- 既存ERP・WMS:実績・入出庫の記録基盤としての役割
- 最適化システム:予測、補充、配分、What-if分析の担当
- 連携運用:項目と更新タイミングをそろえ、障害時の手動運用を決めます。
導入効果や投資回収期間はどのように試算しますか?
まず基準値を置き、シナリオと総コストを比べて試算します。
- 基準値:過去12〜24か月の在庫金額、保管費、廃棄、欠品による販売機会損失、緊急輸送費、発注・補充の作業時間
- TCO比較:在庫と欠品を同時に改善する複数シナリオを作り、導入費、月額、保守、社内運用工数を含めて比べる
- リスク評価:予測精度だけで投資回収を断定せず、繁忙期や需要急変も考慮し、保守的なケースと期待ケースを分ける
まとめ:小さく検証し、現場で使える最適化
開発は要件整理から定着まで、6つのフェーズを順に進みます。各段階で業務とデータの確かさを確認します。
成功の判断には、在庫削減率に加えて、欠品率、サービスレベル、廃棄、輸送費、作業時間をあわせて評価します。
特に、推奨値の根拠を現場が理解し、必要に応じて修正できることが大切です。
導入前に確認する5つの要点
導入前の計画では、目的から運用まで次の5項目を一続きで確認します。
- 目的とKPI:在庫配置の判断基準
- 対象と制約:SKU、拠点、業務条件
- データ品質:マスタと実績の確かさ
- 連携と責任分界:既存システムとの接続
- 運用体制:稼働後の改善担当
これらを要求整理書とRFPに落とし込み、同じデータと成功基準で複数社を比較します。
PoCでは、通常時に加えて、需要急増や納期遅延も再現します。あわせて、説明可能性と手動運用も検証します。
最初の一歩は現状データの棚卸し
導入判断の出発点として、代表的な商品と拠点のデータを集めて小さく検証します。
- 主要カテゴリと代表拠点を選び、販売、受注、出荷、在庫、購買、入荷予定のデータを集めます。
- 現行の補充判断とシステム推奨を比べる小規模な検証計画を作ります。
- 要件、費用、効果、リスクを同じ資料で整理し、在庫管理の延長か計画基盤かを判断します。
▼全体ガイドの記事
・在庫配置最適化システム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。