
逆強化学習(IRL)は、専門家の行動データから報酬関数を推定する方法で、行動の背後にある目的をモデル化します。
通常の強化学習が報酬を与えて方策を学ぶのに対し、IRLは軌跡から報酬の構造を逆算します。ロボットの模倣、運転行動の分析、業務の意思決定ルール抽出、報酬設計の補助などに使われます。
AI駆動開発の基本や工程ごとの活用方法、費用・期間への影響については、無料ホワイトペーパー「【2026年最新版】AI駆動開発の完全ガイドブック」をダウンロードできます。で詳しく解説しています。
専門家の行動から報酬を推定する逆強化学習の仕組み
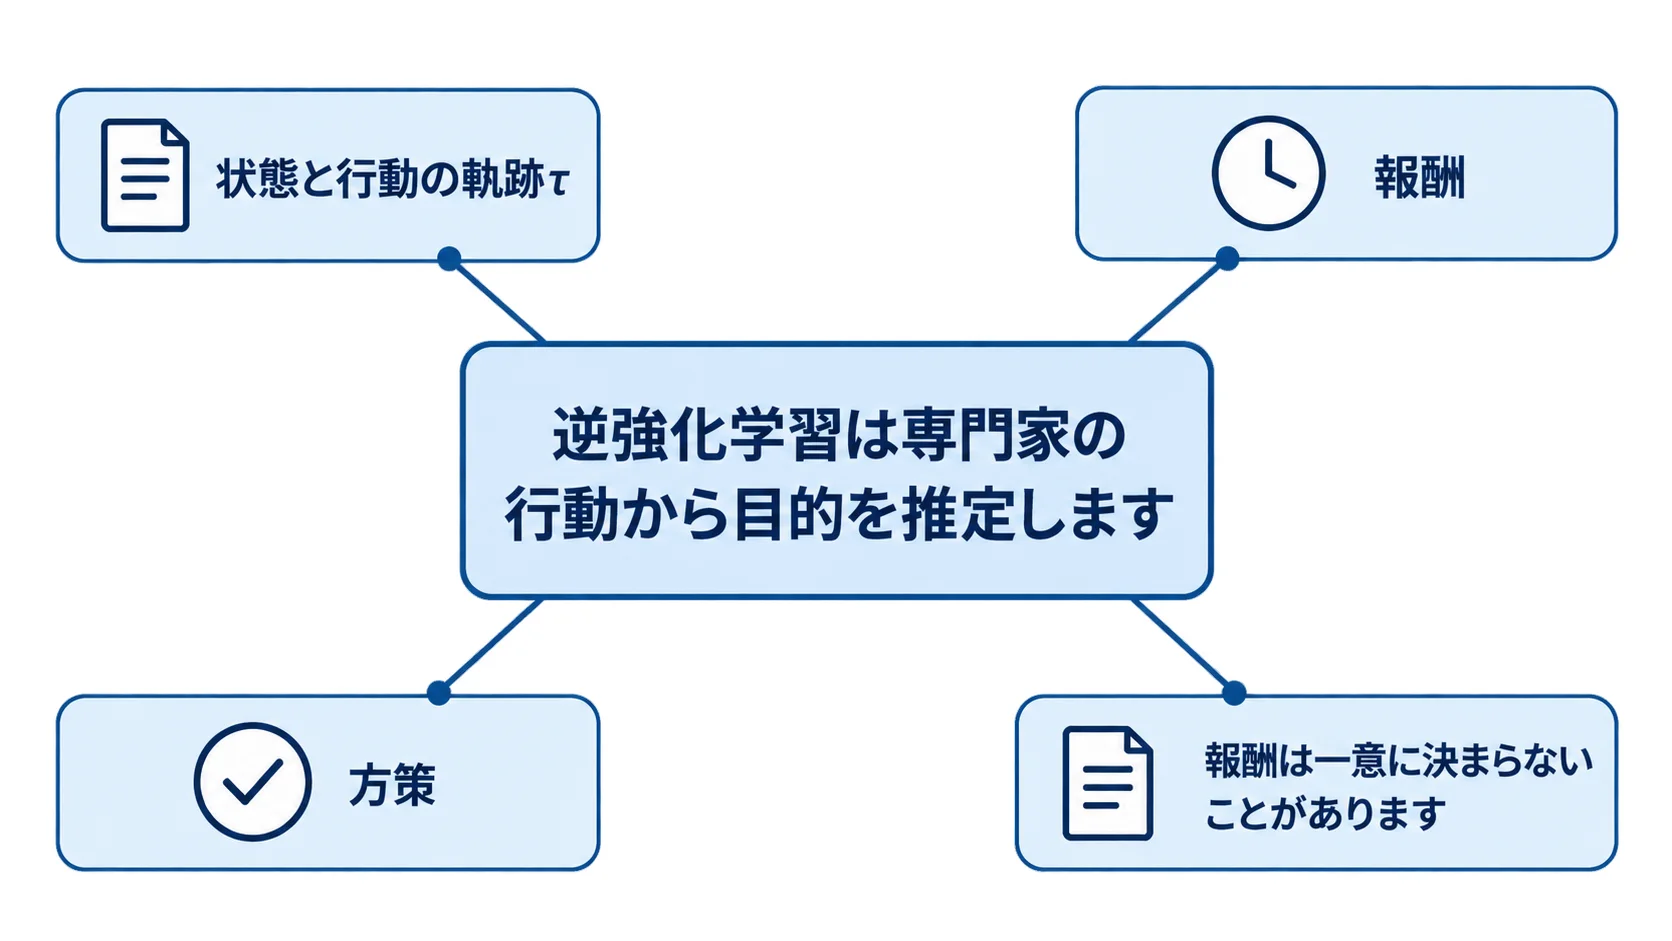
まず、状態と行動の軌跡τから、専門家が最大化すると考えられる報酬Rwを推定します。そのうえで、その報酬で強化学習を行い、専門家に近い、または望ましい方策を得ます。また、OpenAIの解説でも、観測行動の背後にあるコスト関数を学ぶ問題としてIRLを位置づけています。
同じ行動を複数の報酬で説明できる点
たとえば、ある目的地へ最短で進む行動は、距離を最小化した結果とも、時間を最小化した結果とも説明できます。観測されていない制約や好みを追加すると、複数の報酬関数が同じ軌跡を説明できます。そこで、最大エントロピーなどの仮定、正則化、追加データを使って解釈を絞ります。
単発の行動より軌跡全体を使う理由
報酬は将来の状態や遅れて表れる結果に左右されるため、状態・行動・次状態・終了までの軌跡を使います。成功例だけでなく、失敗や迷い、制約を守った例も含めると、何を避けるかを学びやすくなります。
逆強化学習と模倣学習の学ぶ対象の違い
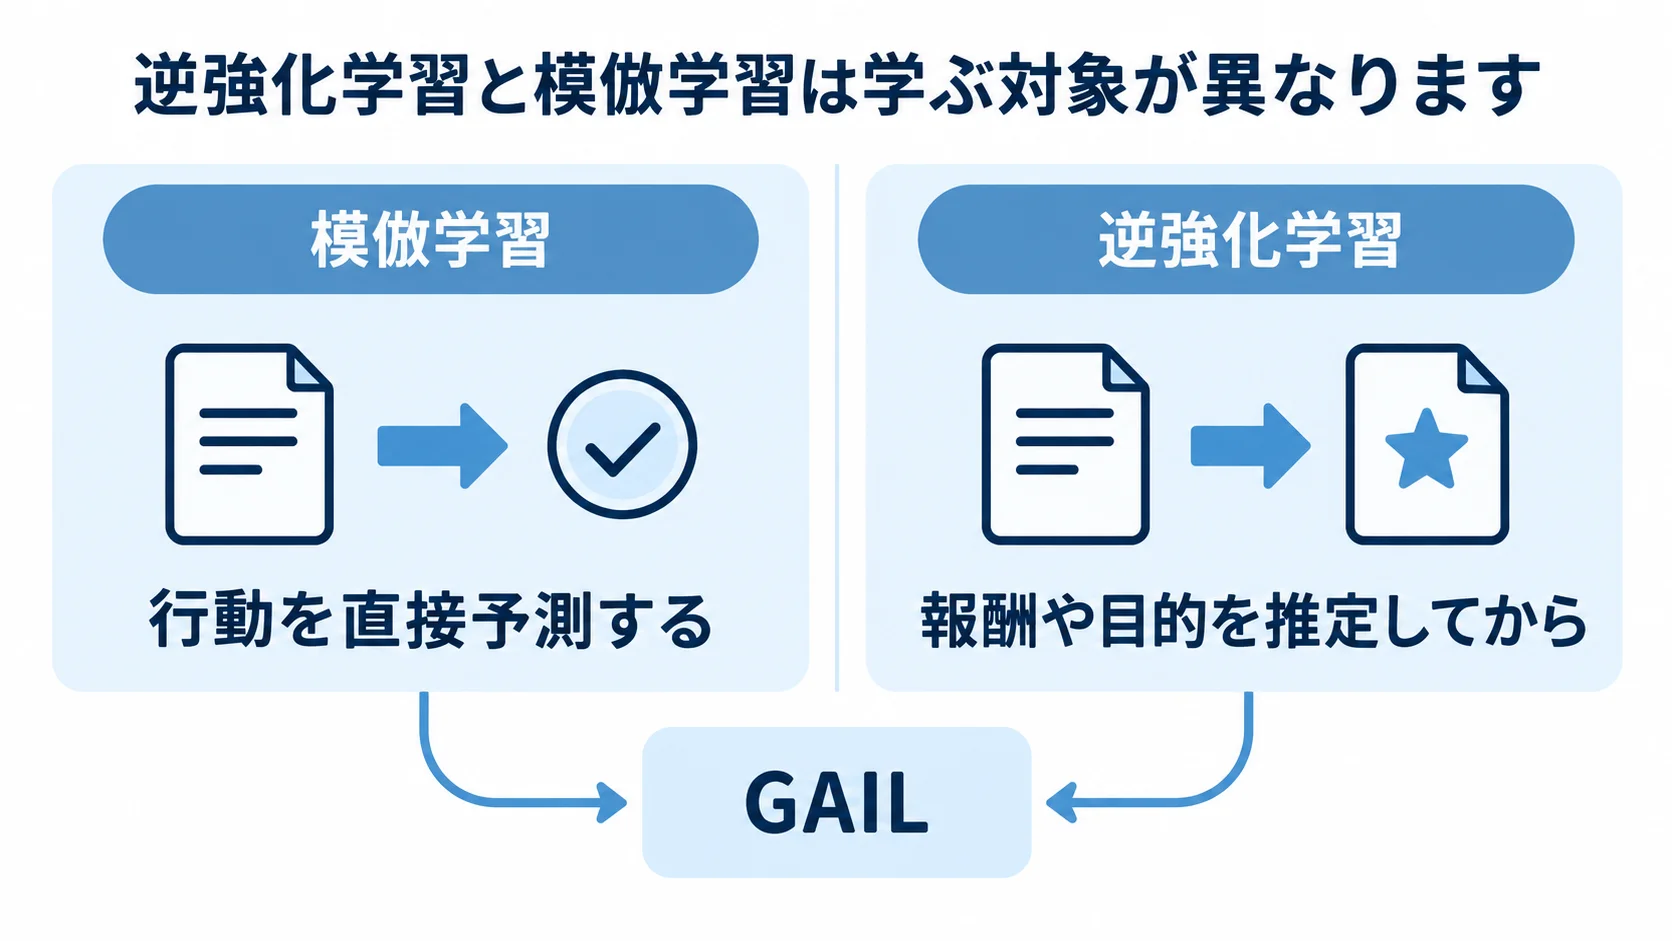
模倣学習は、専門家の状態から行動を直接予測する行動方策を学びます。
逆強化学習は、行動を生んだ報酬や目的を推定してから、別の状態でも行動を決めます。
そのため、未知の状況へ一般化しやすい可能性があります。ただし、報酬推定と再学習の工程が増えます。
- 行動クローニング:状態から専門家の行動を教師あり学習で直接予測する方法。
- IRL:専門家の軌跡から報酬を推定し、その報酬で方策を学ぶ方法。
- GAIL:方策の軌跡と専門家の軌跡を識別器で区別し、模倣を促す方法。
代表的なIRLの種類と選び方
線形報酬IRLは、状態の特徴に重みを付けて足し合わせた形で報酬を表すため、解釈しやすい方法です。
最大エントロピーIRLは、専門家の軌跡を確率的な方策の結果として扱い、同じ報酬でも多様な行動を許します。
深層IRLは、ニューラルネットワークで報酬を表現できます。ただし、データ量、計算、解釈性が課題です。
観測データが少ないと、報酬がノイズや偶然を学んでしまいます。そこで、特徴量、正則化、報酬の滑らかさによって推定を絞り、状態・行動の範囲も制限します。そのうえで、推定報酬から再生成した軌跡が専門家のデータを説明できるかを確認します。
専門家データの品質から始める設計
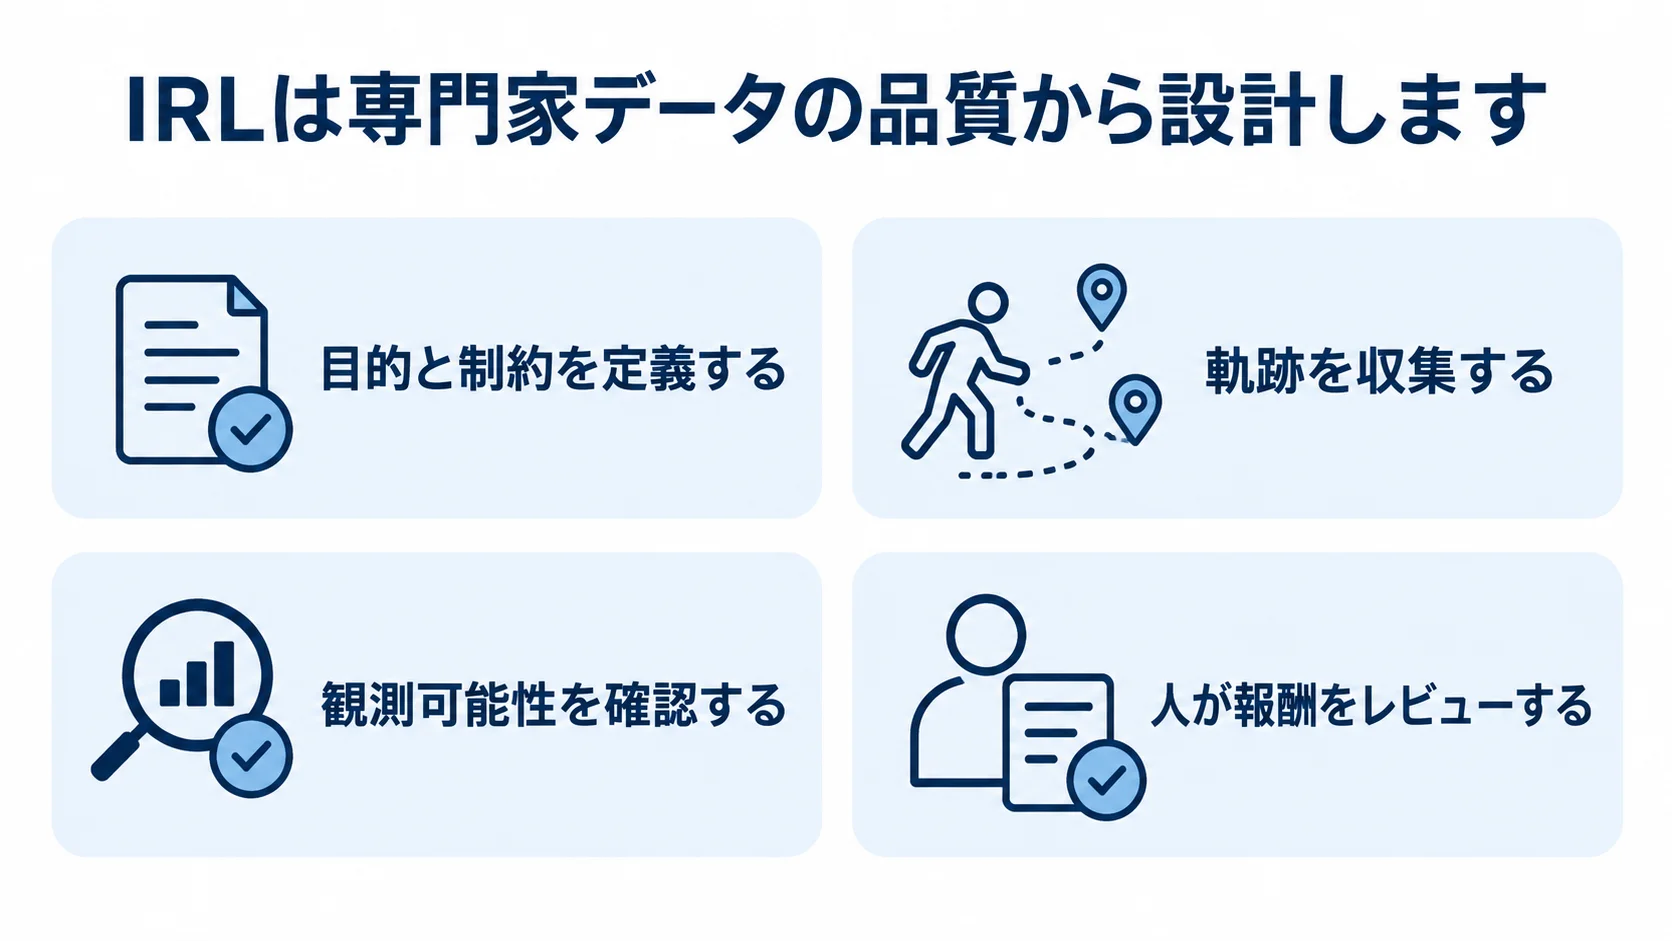
報酬の推定は、専門家データがどれだけ目的を表しているかに左右されるため、まずデータの作り方を確かめます。
- 目的と制約を定義する:専門家の意図とみなす対象の決定と、禁止事項の明記。
- 軌跡を収集する:状態、行動、時刻、結果、環境条件、成功と失敗の記録。
- 観測可能性を確認する:専門家が見ていない情報を特徴量に混ぜないこと。
推定の段階では、報酬の表し方を比べ、再現した軌跡を評価し、最後に人が報酬を確かめます。
- 報酬表現を選ぶ:線形、最大エントロピー、ニューラル表現の比較。
- 再現軌跡を評価する:専門家との一致に加えて、未知条件での安全性。
- 人が報酬をレビューする:重み、特徴、行動の意味を確かめてから運用へ移す。
専門家の行動が常に最適だとは限りません。そのため、時間制約、疲労、組織ルールをデータに含めるほか、例外処理も入れて、単純な頻度を「望ましい報酬」と取り違えないようにします。
個人や部署による違いは分けて扱い、特定の人の癖を全体の目的として学習させない設計が必要です。
軌跡の再現と未知状況の安全性の評価
専門家の行動との一致や軌跡の尤度、到達率に加えて、報酬推定を再現できるかを測ります。さらに、訓練データにない初期状態や環境変化、制約条件のもとで方策を実行し、危険な行動や報酬の抜け道がないかを確かめます。
目的推定の正しさを示すには、単純な一致率に加えて、報酬の解釈性も確かめる必要があります。解釈性は、特徴量の重み、状態ごとの報酬、反実仮想的な行動の比較を人が見て確認します。そのうえで、報酬モデルだけを公開せず、データの出所、個人情報、推定の不確実性を記録し、適用範囲も明示します。
逆強化学習で起きやすい失敗と対策
専門家の偶然の癖を目的として学ぶ失敗
複数の専門家や期間、環境のデータを含め、再現性のある特徴と個人に固有の特徴を分けて扱います。
推定報酬による危険な行動
安全制約を報酬の罰則だけに任せると、危険な行動を防ぎきれません。そこで、行動マスクや上限、承認といった制約を報酬とは別に実装し、停止手順も用意します。
報酬の一意性への過信
複数の報酬候補を比べ、推定の不確実性と適用範囲を明示します。
逆強化学習による報酬の推定
逆強化学習は、専門家の軌跡から報酬関数や目的を推定し、その報酬で別の状況の方策を学ぶ方法です。模倣学習より意図を扱える可能性がある一方で、報酬が一意に決まらないことや、データの偏りという課題があります。
複数の専門家や環境からデータを集め、再現性や未知条件での安全性、報酬の解釈性を評価します。
推定した目的は、人のレビューと行動の制約を組み合わせて初めて、本番の自動判断に使えます。
よくある質問(FAQ)
逆強化学習に関してよくある疑問に、順に答えます。
Q. 逆強化学習とは何ですか?
専門家の状態と行動の軌跡から、その行動を生んだ報酬や目的を推定する方法です。
Q. 模倣学習との違いは何ですか?
模倣学習は行動を直接予測するのに対し、逆強化学習は報酬や目的を推定してから方策を学びます。
Q. 報酬は一意に推定できますか?
一意に決まるとは限りません。そのため、正則化や追加データ、最大エントロピーなどの仮定で候補を絞ります。
Q. どのようなデータが必要ですか?
状態、行動、時刻、結果、環境条件を含む複数の専門家の軌跡が必要です。失敗例や例外も有用です。
Q. 推定報酬をそのまま本番で使えますか?
未知条件での安全評価と人のレビューを経て、行動制約や停止・ロールバックを用意したうえで使います。
参考資料
本文の内容を確認するために参照した資料です。
- OpenAI「GANs・IRL・energy-based models」
- OpenAI Spinning Up「Key Concepts in RL」
- OpenAI Spinning Up「Key Papers in Deep RL」
▼開発を相談する前に読みたい無料ホワイトペーパー
・【2026年最新版】AI駆動開発の完全ガイドブックをダウンロードできます。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。