
ITシステムのアラート対応に必要な機能は、検知から自動化まで4つの段階で整理できます。
各機能の役割と、どこまでを標準と考えるべきかを、発注企業(情シス)の視点から一次データとあわせて解説します。全体像をまだ把握していない方は、まずITシステムアラート対応の完全ガイドから読むことをおすすめします。
- 検知・通知:異常の発見と、必要な担当者への連絡
- 集約・抑止:重複やノイズの整理
- 優先度・エスカレーション:対応順と連絡経路の設定
- 一次対応・自動化:定型対応と記録の効率化
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
異常を検知し通知する基本機能
アラート対応の出発点は、システムの異常を検知して担当者へ通知する基本機能です。この機能がないと、障害は誰にも気づかれないまま進んでしまいます。
検知の対象は、サーバーの死活、CPUやメモリのリソース使用率、レスポンス時間、エラーログの出現など多岐にわたります。それぞれに「どの値を超えたら異常とみなすか」という閾値を設定するのが基本です。
閾値監視と異常検知のロジック
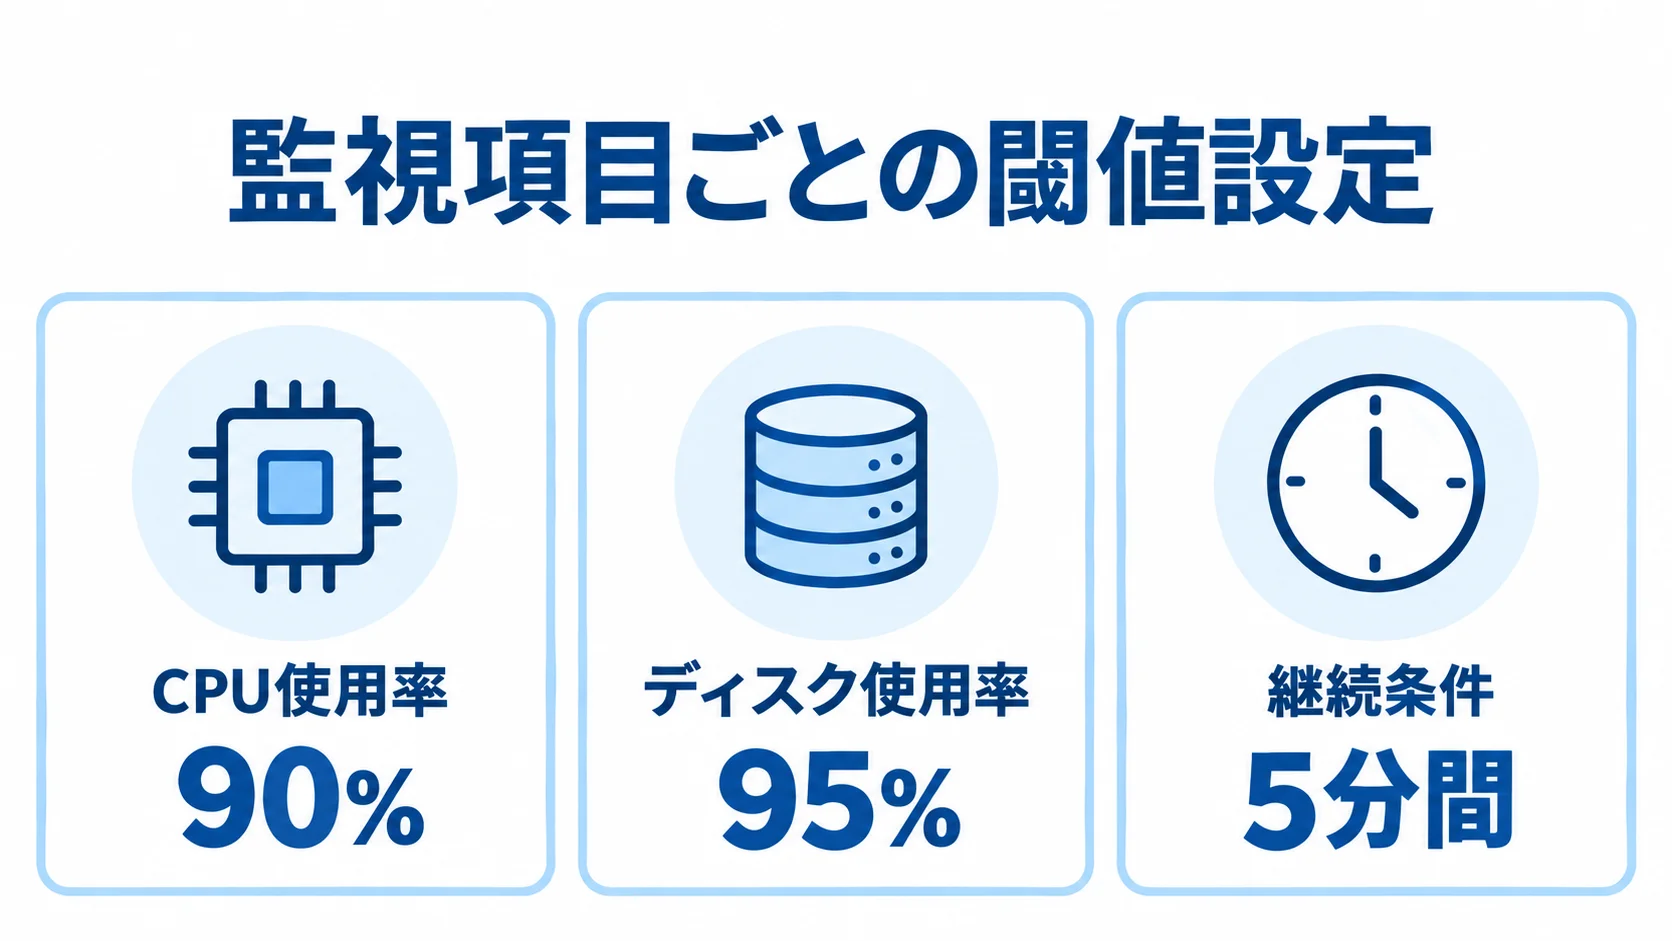
検知機能の中核は閾値監視で、CPU使用率が90%を超えたら警告、ディスク使用率が95%を超えたら重大、というように段階的な閾値を監視項目ごとに設定します。加えて、瞬間的なスパイクで誤検知しないよう、「5分間継続したら通知する」といった継続条件も組み合わせることが重要です。継続条件がないと、一過性の負荷でアラートが乱発され、後述するノイズの温床になります。
こうした検知ロジックを担う代表的なツールには、OSSのZabbixや、クラウド型のDatadog、New Relic、サーバー監視に強いMackerelがあります。Zabbixはライセンスが無料で柔軟な閾値設定ができる一方、構築と維持に相応の工数がかかります。DatadogやNew Relicはホスト数やメトリクス量に応じた従量課金で、中規模なら月数万円から数十万円が目安です。
どのツールを使うにせよ、検知機能は「何を・どの値で・どれだけ継続したら異常とするか」という設計の質が、その後のアラート対応全体の精度を左右します。
マルチチャネル通知と通知経路の機能
検知した異常を確実に担当者へ届けるのが通知機能です。メール、チャット(SlackやTeams)、電話、SMSなど複数のチャネルに対応し、アラートの重要度に応じて経路を使い分けられることが求められます。たとえば重大なアラートは電話で確実に担当者を呼び出し、軽微なものはチャットへの投稿にとどめる、といった出し分けができると、対応の優先度が自然に伝わります。
通知機能で見落とされがちなのが、当番(オンコール)のスケジュール管理です。誰がいつ対応当番なのかをシステムが把握し、その時間帯の当番者に通知を届ける仕組みがないと、休暇中の担当者にアラートが届いて誰も対応しない、という事態が起きます。
また、通知が届いても一定時間応答がなければ次の担当者へ自動転送する機能が備わっていると、通知の取りこぼしを防げます。通知機能は、単に飛ばすことに加えて、確実に対応できる人へ届けるところまでを担う必要があります。
ノイズを抑える集約・抑止機能
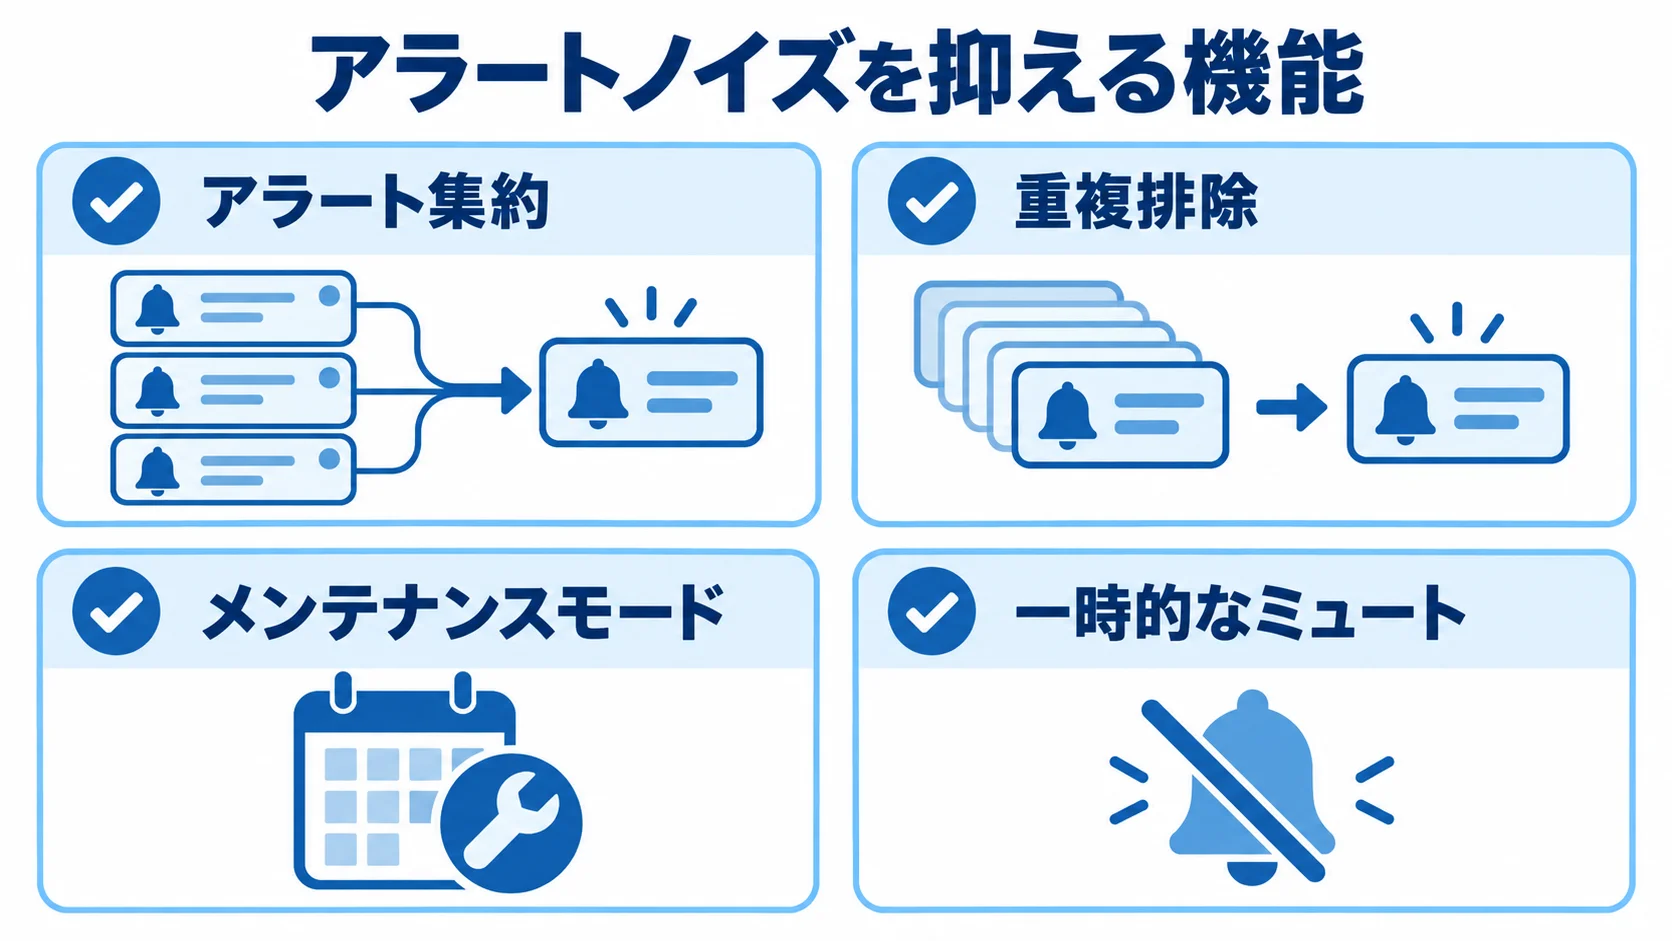
アラート対応を実用的にするには、検知・通知と並んで、ノイズを抑える集約・抑止機能が必要です。検知機能をそのまま動かすと、関連する複数のアラートが同時に多発し、担当者は何が本当の原因なのか分からなくなります。この「アラートの洪水」を整理する機能が、アラート疲れを防ぐうえで欠かせません。
アラート集約・重複排除の機能
集約機能は、関連する複数のアラートを一つにまとめる仕組みです。たとえばデータベースサーバーがダウンすると、それに依存するWebサーバーやバッチ処理からも次々とエラーアラートが発生します。
これらを個別に通知すると数十件の通知が一斉に飛びますが、集約機能があれば「根本原因はDBダウンである」という一つのアラートにまとめられます。そのため、担当者は枝葉のアラートに惑わされず、原因に直接アプローチできます。
あわせて重要なのが重複排除で、同じ事象のアラートが繰り返し発生した場合に、一定時間まとめて「同種のアラートが○件発生」と集約し、通知の連打を防ぎます。件数を見かけ上減らすだけでなく、対応すべき事象の本質を浮かび上がらせることで、検知機能がいくら高精度でも、担当者が通知の量に押し流される事態を防げます。
抑止・メンテナンスモードの機能
計画的なメンテナンス作業中は、意図的にサービスを停止したり再起動したりするため、その間のアラートは不要です。抑止機能(メンテナンスモード)は、特定の期間や対象に対してアラートを一時的に止める仕組みです。これがないと、作業のたびに大量のアラートが飛び、担当者が本物の障害と作業由来の通知を区別できなくなります。
メンテナンスモードは、計画作業とアラート対応を切り分けるための必須機能です。抑止機能のもう一つの用途は、既知の事象に対する一時的なミュートです。原因が分かっていてすでに対応中のアラートが鳴り続けると、新たに発生した別の障害を見落とす原因になります。
こうした見落としを防ぐには、対応中のアラートを一定時間ミュートし、解決後に自動で監視を再開する仕組みが役立ちます。担当者は、今この瞬間に注意すべき事象に集中できます。集約・抑止機能は地味ですが、アラート対応の現場が破綻せずに回るかどうかを左右する、極めて実務的な機能群です。
優先度判定とエスカレーション機能
アラートが検知され、ノイズが整理されたら、次は「そのアラートにどう対応するか」を導く機能が必要です。この役割を担うのが、優先度判定とエスカレーション機能です。すべてのアラートを同じ重みで扱うと対応が間に合わないため、重要度に応じて対応スピードと担当者を変える仕組みが欠かせません。
重大度(Severity)判定とSLA連動の機能
優先度判定機能は、検知したアラートに重大度(Severity)のレベルを割り当てます。一般的には「重大・警告・情報」の3段階や、それをさらに細分化したレベルが使われます。重大はサービス全体が止まるなど即時対応が必要なもの、警告は放置すると重大化する恐れがあるもの、情報は記録のみで対応不要なもの、という具合です。
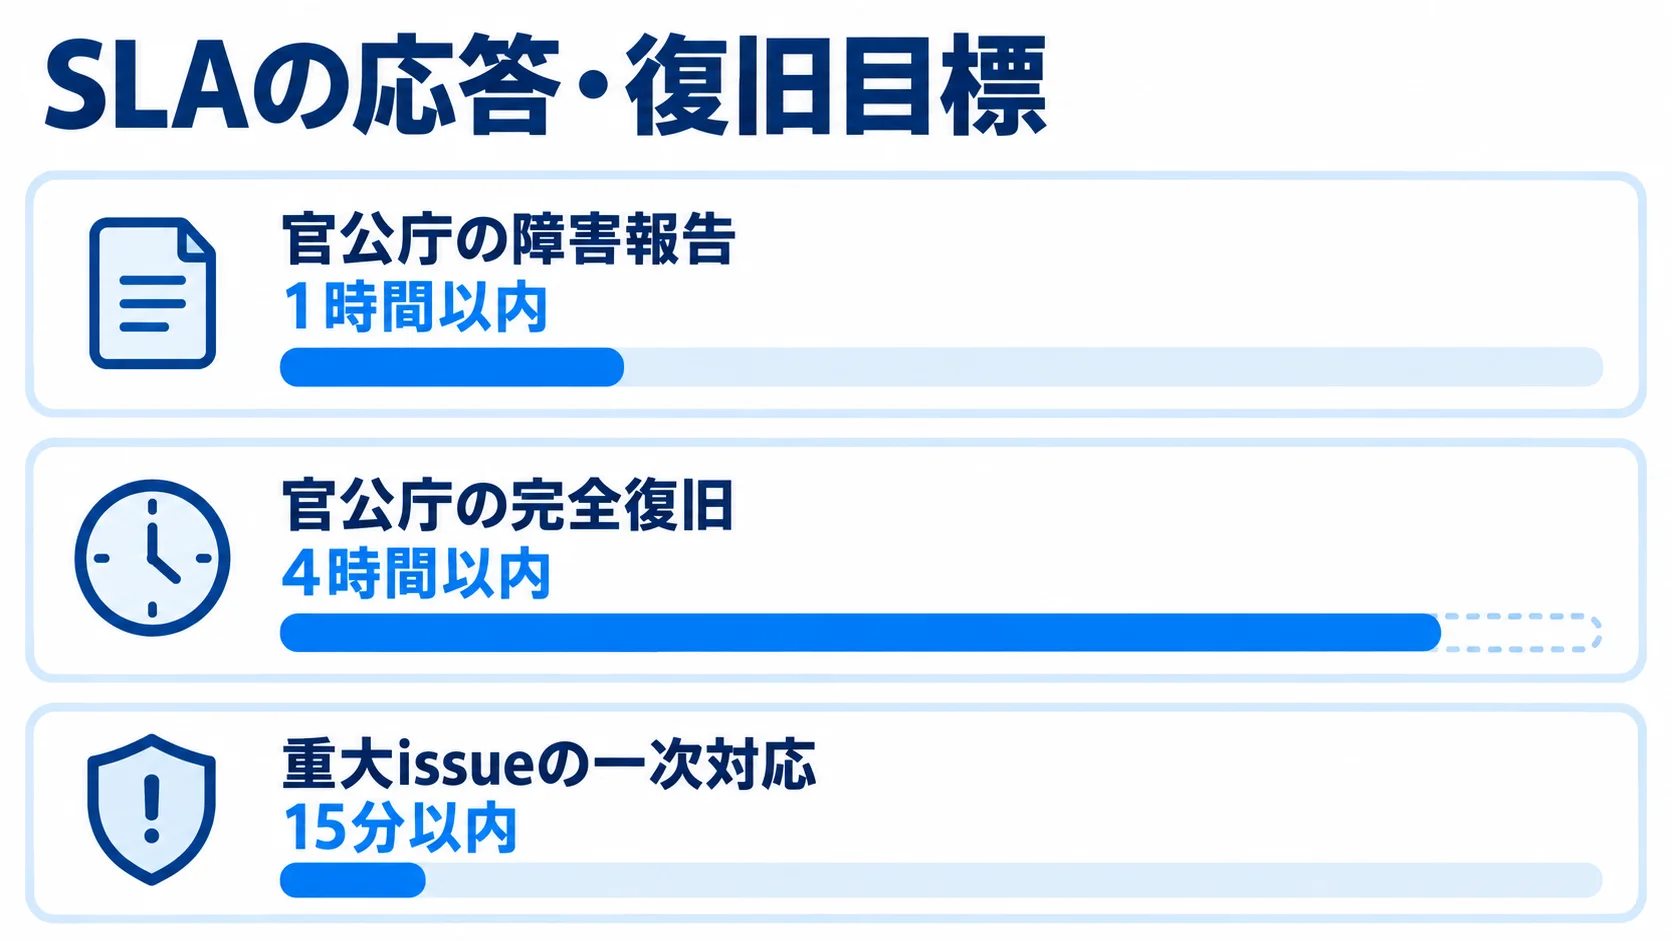
この判定が、後続の通知経路や対応スピードを決める起点になります。優先度は、SLA(サービス品質保証)の応答・復旧目標と連動させると実効性が高まります。たとえば官公庁の仕様例では、障害発生から1時間以内に内容と予想作業時間を報告し、原則4時間以内に完全復旧する、といった目標が定められます。
さらに、クラウド事業者の例では、重大issueに15分以内の一次対応を保証するサービスもあります。アラートの優先度を、こうしたSLAの数値目標と紐づけることで、「このアラートは何分以内に初動すべきか」が機能として明確になります。優先度判定は、SLAを形だけの目標で終わらせないための実装そのものです。
段階的エスカレーションと記録の機能
エスカレーション機能は、アラートに対応する担当者を段階的に引き上げる仕組みです。最初に一次対応者へ通知し、一定時間内に応答がなければ二次対応者やリーダーへ、それでも収束しなければ管理者や経営層へと、自動的に通知範囲を広げます。これにより、最初の担当者が気づかなかった場合でも、対応が滞留せず必ず誰かに引き継がれます。
MSPへ一次対応を委託する場合は、このエスカレーション基準を契約段階で明文化しておくと、丸投げを防げます。あわせて必要なのが、対応履歴を記録する機能です。いつアラートが発生し、誰が確認し、どう対処して、いつ収束したかを時系列で残すことで、後から振り返って原因分析や再発防止に活かせます。
この記録は、SLAの達成状況を証明する材料にもなり、ベンダーとの契約評価や、経営層への報告にも使えます。優先度判定・エスカレーション・記録の3機能がそろって初めて、アラートは「鳴って終わり」にせず、「対応され、学びに変わる」サイクルになります。
一次対応の自動化とAIOps機能
基本機能が整ったうえで、運用負荷をさらに下げるのが、一次対応の自動化とAIOps(AIによる運用高度化)の機能です。これらは必須ではありませんが、アラート対応を「人が反応する」段階から「仕組みが自律的に処理する」段階へ進める発展的な機能群です。中小企業でも、部分的に取り入れることでROIを出せる領域です。
自動復旧(オートリメディエーション)の機能
自動復旧機能は、特定のアラートが発生したとき、あらかじめ定義した対処を人手を介さず自動実行する仕組みです。たとえばプロセスが停止したら自動で再起動する、ディスク使用率が閾値を超えたら一時ファイルを自動削除する、といった定型的な一次対応を機械に任せます。これにより、夜間に発生する軽微な障害の多くが、担当者を起こすことなく自動で収束し、MTTR(平均修復時間)の短縮につながります。
注意すべきは、自動復旧をすべてのアラートに適用しないことです。原因が分からないまま自動で再起動を繰り返すと、根本原因が隠蔽され、問題が深刻化する恐れがあります。そのため、自動復旧は「原因と対処が明確で、繰り返し発生する定型的な事象」に限定し、それ以外は人による判断に委ねるのが原則です。
自動化はアラート対応の負荷を確実に下げますが、適用範囲を見極める設計の質が、その効果と安全性を左右します。
AIOpsによる予兆検知と相関分析の機能
AIOpsの機能は、過去のメトリクスやログのパターンを学習し、固定の閾値では捉えきれない異常を検知します。たとえば、通常とは異なるアクセス傾向やリソースの揺らぎを「いつもと違う」と検出することで、明確な閾値超えが起きる前に予兆を捉えられます。
また、複数のアラートの相関を分析し、「これらは同一の根本原因から派生している」と自動で関連づけることで、原因究明の時間を短縮します。ただし、AIOpsは大企業向けの大がかりな仕組みというイメージが先行しがちです。JUASの調査でも、AIの運用活用は約78%が検討中・未検討の段階にとどまっています。
中小企業には、いきなり全面導入するより、まず誤検知の多い特定の監視項目で、AIによる異常検知を試すスモールスタートが現実的です。riplaはフルスクラッチ受託と国内運用保守の立場から、既存の監視を活かしつつ、効果の出る範囲から自動化・AIOpsを段階導入する設計を支援しています。発展機能は、必要な範囲を見極めて取り入れることが、投資を無駄にしないコツです。
まとめ
ITシステムのアラート対応機能は、4つの層で成り立っています。基本機能は異常を検知して確実に通知し、集約・抑止機能は洪水を防ぎます。優先度判定とエスカレーション機能が対応を導き、自動復旧とAIOpsの発展機能が負荷を下げます。
それぞれの機能が連携して初めて、アラートは対応につながります。検知があってもノイズに埋もれ、通知があっても誰が対応するか定まらなければ、対応は進みません。
ZabbixやDatadog、Mackerelといったツールは、これらの機能を提供しています。ただ、自社にどの機能がどこまで必要かは、システムの事業影響度によって変わります。
機能を検討するときは、最新の機能をすべてそろえるより、自社の運用に本当に必要な機能を見極めることが大切です。まずは検知・通知・優先度判定という基本機能を確実に整え、運用が回り始めてから、集約・抑止や自動化を段階的に足していくのが堅実です。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、必要な機能から無理なく整えるアラート対応の設計を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。