
RFP(提案依頼書)と要件定義では、監視項目と閾値、SLAの数値、対応範囲を、具体的な数値とともに明文化することが欠かせません。この記事は、ITシステムのアラート対応に関するRFPと要件定義書、提案依頼書の書き方を、要件定義に特化し、発注企業(情シス)の視点から実務的に書いています。
「24時間監視してほしい」のような表現では、各社の提案を比べにくく、契約後のトラブルにもなります。全体像がまだの方は、まずITシステムアラート対応の完全ガイドからお読みください。
▼全体ガイドの記事
・ITシステムアラート対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視項目と閾値を定義する要件の書き方
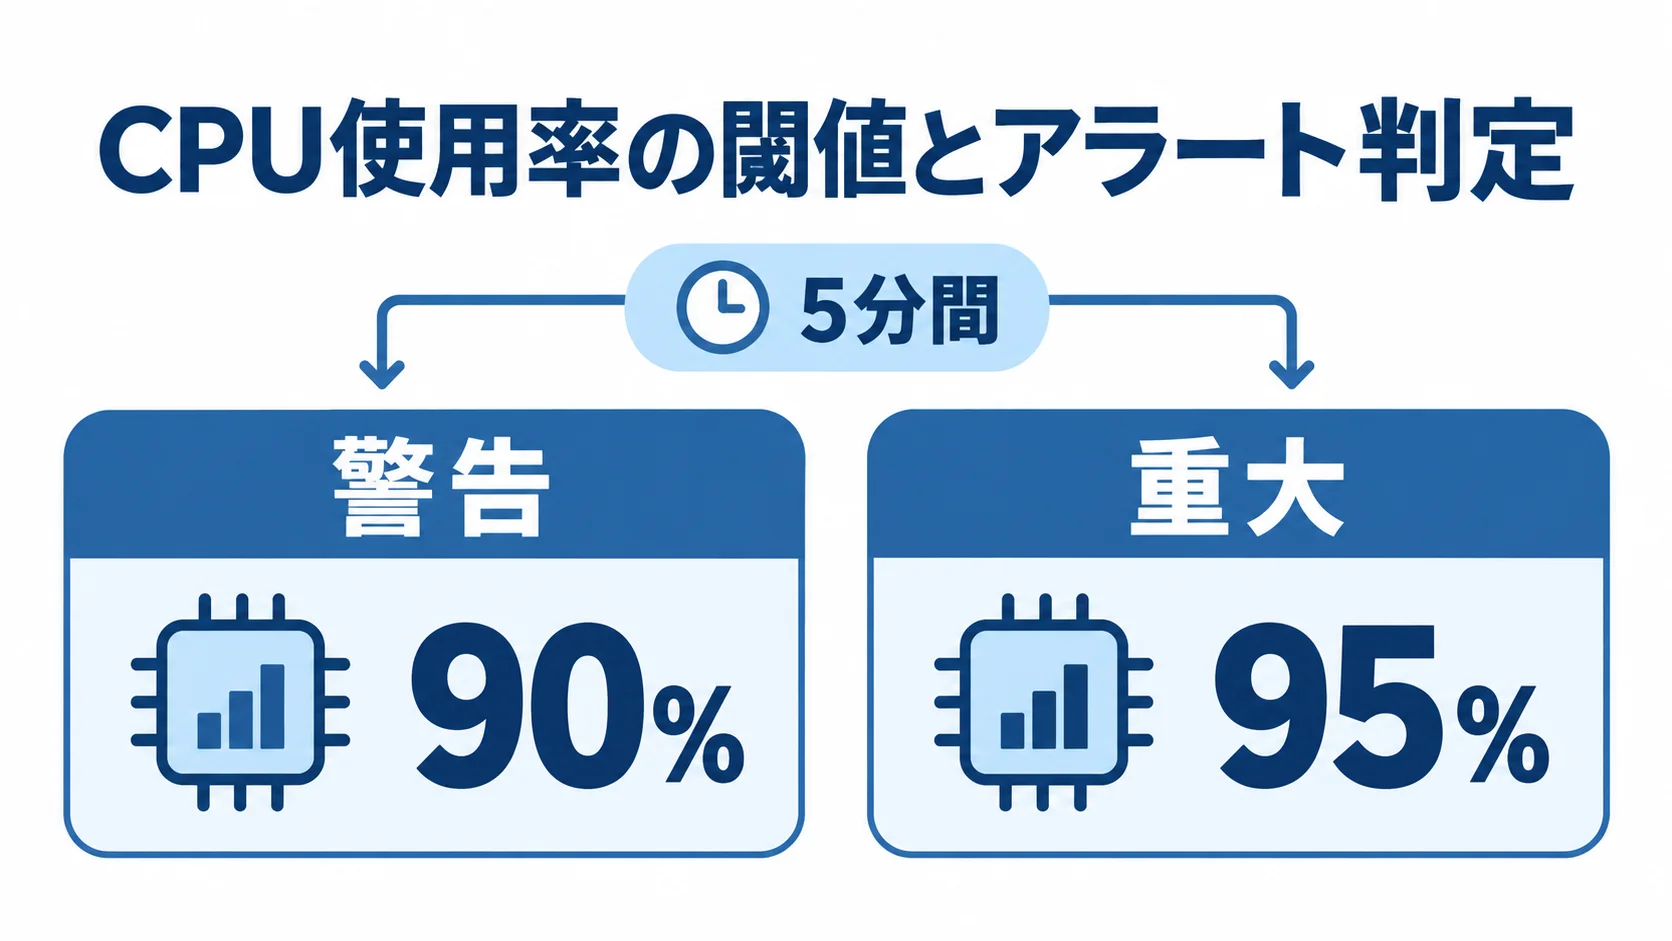
アラート対応のRFPで最初に明文化したいのは、何を、どの値で監視し、どうなったらアラートとするかという、監視項目と閾値です。
ここが曖昧なままだと、ベンダーは自社の標準パッケージに当てはめて提案しがちで、自社にとって本当に重要な監視が抜け落ちることがあります。そこで、要件定義の段階から監視対象を具体的に列挙しておくことが出発点になります。
監視対象とアラート条件の一覧化
監視対象ごとに、どの閾値を超えたらアラートにするかを決め、瞬間の値で判断するのか、何分継続したら判断するのかを書き添えます。
たとえば「CPU使用率が90%を5分間継続したら警告、95%を5分間継続したら重大」のように数値で書き切っておくと、各社の提案のばらつきを防げます。
この一覧には、自社のシステム構成図を添付するのが効果的です。構成図から、どのサーバーがどのサービスを支え、どこと連携しているかをベンダーが理解でき、提案の精度が上がります。
逆に、構成情報を伏せたまま「よしなに監視してほしい」と頼むと、提案が偏りやすくなります。安全側に倒して過剰な監視を提案する場合もあれば、最低限の監視にとどめる場合もあります。
監視項目と閾値の一覧は、RFPの土台です。ここが固まらないと、SLAも対応範囲も定まりません。監視対象は、次の2つに分けてまとめます。
- 基盤の監視:サーバーの死活、CPU・メモリ・ディスクのリソース、ネットワーク疎通
- アプリケーションの監視:レスポンス時間、エラーログ、特定プロセスの稼働状況
監視ツール選定基準の要件への組み込み
RFPでは、監視ツールの前提条件も要件に含めると、提案の比較がしやすくなります。既存でZabbixを使っているなら「Zabbixの運用を引き継げること」を条件にし、新規ならクラウド型のDatadogやNew Relicを想定します。
また、Mackerelといった選択肢のうち、どの方向性を想定しているかを示しておきます。ツールによって費用構造が異なるため、ここを明示しないと見積もりの前提がそろいません。
たとえばZabbixはライセンスが無料ですが、構築と維持に工数がかかるため、その工数を誰が負担するのかを要件で確認する必要があります。
DatadogやNew Relicは、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万円から数十万円が目安です。
ツールの選定基準を要件に組み込むことは、技術の選択であると同時に、コストを管理する手段にもなります。要件定義で次の2点まで踏み込んで書いておくと、後の隠れコストを防げます。
- ライセンス費の負担者:発注者か受注者か
- 費用増の試算:将来の監視対象の増加に伴う費用の増え方
SLAの数値要件の定義
アラート対応のRFPで最も重要で、費用にも直結するのがSLA(サービス品質保証)の数値要件です。SLAは「どれだけの品質で対応するか」を約束する指標で、稼働率・初報応答時間・復旧時間といった数値で定義します。
ここを曖昧にしておくと、いざ障害が起きたときに「いつまでに対応してくれるのか」が決まらず、トラブルにつながります。
稼働率と許容ダウンタイムの定義
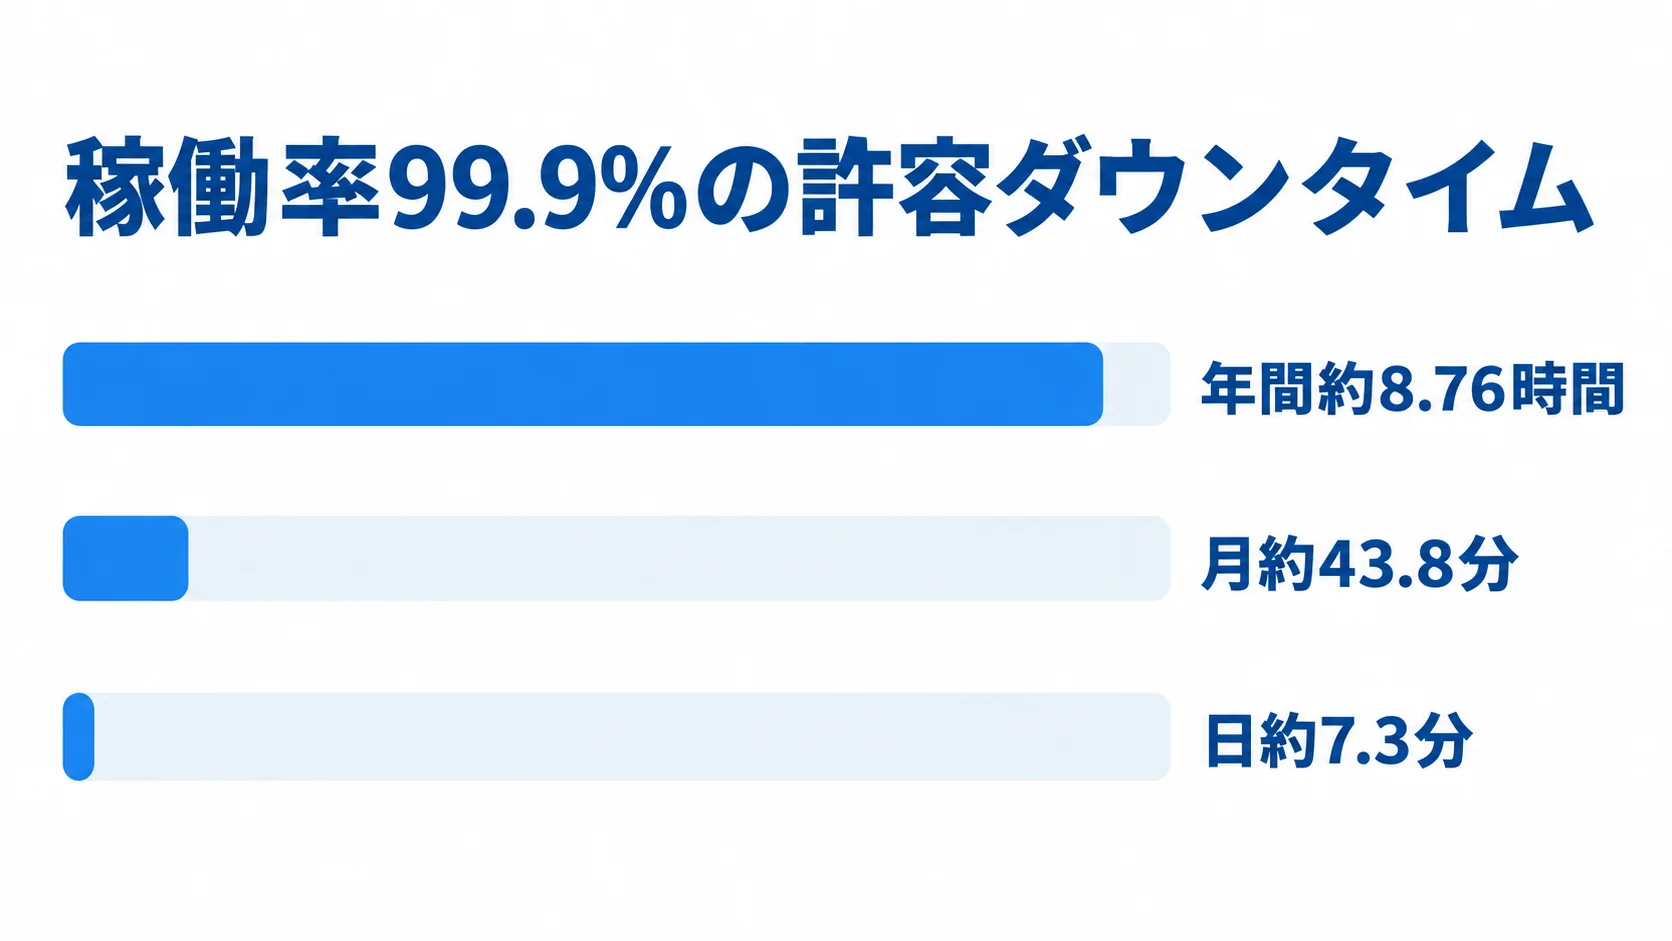
SLAの数値要件では、稼働率を「99.9%」「99.99%」のように定義しますが、その数値が何を意味するかを正確に理解しておく必要があります。
「9」が一つ増えるだけで、許容できる停止時間は劇的に短くなります。注意すべきは、その「9」を一つ増やすごとに、運用コストが段階的に跳ね上がる点です。99.99%を実現するには冗長構成や即時復旧の体制が要り、待機人員や設備への投資が膨らみます。
要件定義では、「高い稼働率を」と一律に求めるよりも、自社のシステムが本当にその水準を必要としているかを、事業影響度から逆算して決めることが肝心です。
すべてを99.99%にすると過剰投資になり、本当に守るべきシステムに資源を集中できなくなります。稼働率の要件は、安全と費用のバランスを示す大切な数値です。
99.9%と99.99%の差は、年・月・日のどの単位で見るかで実感が変わります。
- 稼働率99.9%:年間約8.76時間、月約43.8分、日約7.3分
- 稼働率99.99%:年間約52.6分、月約4.38分、日約4.4秒
初報応答時間と復旧目標時間の数値設定
稼働率と並んで定義すべきなのは、アラート発生から対応開始・復旧までの時間です。参考として、官公庁の仕様例では、障害発生から1時間以内に現地到着・対処開始、1時間以内に内容と予想作業時間を報告、原則4時間以内に完全復旧という目標が示されています。
クラウド事業者では、重大なissueに15分以内の一次対応を保証する例や、検知から60分以内に通知し12時間以内に復旧する例もあります。
これらの数値を要件に定めるときは、「努力目標型」か「保証型」かを区別することが重要です。努力目標型は、「○分以内を目指す」という努力義務にとどまり、未達でも責任は問われません。
保証型は未達の場合にサービスクレジット(料金の減額)などのペナルティを伴います。一般的な目標としては、重大障害は2時間以内に対応開始、完全解決は24時間以内とする例があります。
要件定義では、自社にとってどの時間目標が必要かを見極め、それを保証型にするか努力目標型にするかを、費用とのバランスで決めることが求められます。この区別を曖昧にすると、いざというとき「目標は書いてあったが保証ではなかった」という事態を招きます。
要件に定める時間は、次の2つです。
- 初報応答時間:アラート検知から第一報(初報)を入れるまでの時間
- 復旧目標時間:完全復旧を目指す時間
クラウド責任共有を前提にした監視範囲の定義
国内エンタープライズ・システム市場のクラウド比率は約5割に達しています(IDC Japan、2022年)。そのため、アラート対応の要件定義でもクラウドを前提にすることが当たり前になっています。
クラウドには「責任共有モデル」という考え方があり、どこまでがクラウド事業者の責任で、どこからが利用者側の責任かを正しく切り分けたうえで、監視範囲を定義する必要があります。
クラウド事業者と利用者の監視責任の境界
クラウドの責任共有モデルでは、物理サーバーやネットワークなどの基盤はクラウド事業者が責任を持ちます。その上で動くOS・ミドルウェア・アプリケーションは、利用者側の責任になるのが一般的です。
要件定義では、この境界を踏まえて「自社で監視すべき範囲」を明確にします。クラウド基盤そのものの障害は、利用者側では手出しができず、事業者からの情報提供を待つしかありません。だからこそ、利用者責任の範囲をきちんと監視する体制が、アラート対応の前提になります。
注意すべきは、クラウド基盤の障害が起きたとき、事業者側の補償はサービスクレジット(料金の一部返金)にとどまり、それ以上の損害賠償は期待できないのが通例だという点です。
つまり、クラウド基盤の障害による事業損失は、最終的に利用者が負うことになります。要件定義では、この前提を踏まえて、クラウド基盤障害時の自社の対応手順や、後述する自衛策まで含めて書くことが重要です。
「クラウドだから安心」と監視範囲を曖昧にすると、いざ基盤障害が起きたときに何もできず、状況把握すらできない事態に陥ります。
RFPに書く項目は、次の2つです。
- 利用者側の監視範囲:OS・ミドルウェア・アプリケーションの監視項目
- 基盤障害時の対応:事業者からの情報提供を前提にした自社の対応手順
監視のブラックボックス化を防ぐ自衛策の要件
クラウド化で見落とされがちなのが、「監視のブラックボックス化」というリスクです。クラウド基盤の内部は利用者から見えないため、障害の原因がクラウド側にあるのか自社側にあるのかを切り分けられず、対応が滞ることがあります。
要件定義では、こうしたブラックボックス化を緩和する自衛策を盛り込みます。さらに踏み込んだ自衛策として、アーキテクチャ設計まで要件に含めることも検討に値します。
自衛策は隠れコストになりやすいため、要件定義の段階でコストと効果を天秤にかけ、本当に必要なシステムに限って適用します。
riplaはフルスクラッチ受託の立場から、クラウドの責任境界を踏まえた監視範囲の整理と、過不足のない自衛アーキテクチャの設計を支援しています。
盛り込む自衛策は、次の2つです。
- 外形監視:外部からサービスの応答を定期的に監視し、クラウド側に依存せず生死を把握
- マルチリージョン化:一つのリージョンが障害を起こしても、別のリージョンでサービスを継続
隠れコストを潰す対応範囲の定義
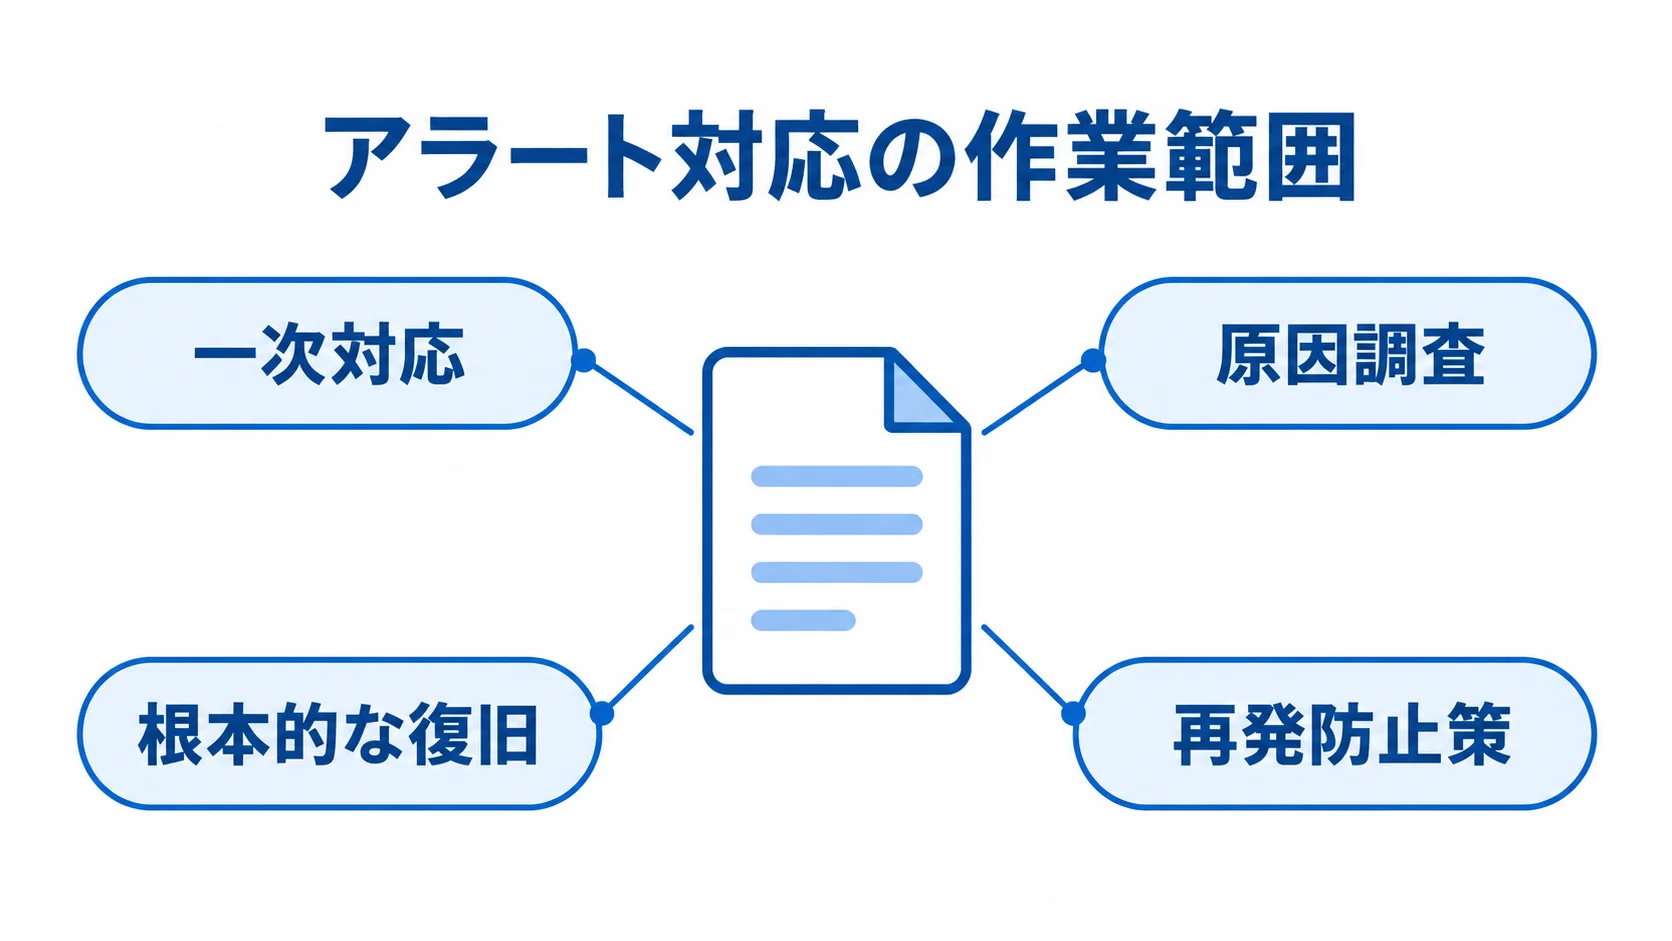
アラート対応のRFPで最後に詰めるべきなのが、対応範囲の定義です。「アラートに対応する」という言葉の中身は幅広く、どこまでを基本料金に含み、どこからを追加費用とするかが曖昧だと、契約後に想定外の請求が発生します。隠れコストを潰すには、対応範囲を細かく書き分けることが欠かせません。
一次対応・原因調査・復旧の線引き
アラート対応は、検知後の一次対応(再起動やプロセス復旧などの定型対処)に始まり、原因調査、根本的な復旧、再発防止策の実施へと段階が進みます。
RFPでは、このうちどこまでが月額の基本料金に含まれ、どこからがスポット対応(追加費用)になるのかを明記します。一次対応のみが基本料金で、原因調査や復旧はスポット扱いになる契約も珍しくありません。この線引きが曖昧だと、障害のたびに想定外の費用が積み上がります。
サービス会社の例では、監視5,000円/台、障害対応10,000円/台、フルマネージド20,000円/台といった台数課金もあります。RFPで料金体系を明示的に問うことで、各社の対応範囲と費用構造を横並びで比較できるようになります。対応範囲の線引きは、見積もりの妥当性を判断する基準そのものです。
月額の基本料金とスポット対応の費用は、サービス内容ごとに目安が分かれます。
- 運用・監視:24時間365日の死活・リソース監視が月5万〜20万円、障害対応は営業時間内なら月3万〜8万円
- 緊急対応・スポット:24時間緊急対応を含めると月10万〜20万円、スポット対応は1件3万〜10万円
「安すぎる見積もり」を見抜く要件チェック
RFPで複数社から提案を集めると、際立って安い見積もりが出てくることがあります。しかし、安さの裏には必ず理由があります。多くの場合、対応範囲が狭い、SLAが努力目標型でしかない、工数の上限が低く設定されているといった「削られた部分」が隠れています。
要件定義の段階で対応範囲とSLAを数値で固めておけば、安すぎる見積もりがどこを削っているかを見抜けます。これらを要件として明記し、提案書での回答を求めることで、見かけの安さに惑わされず、実質的なコストパフォーマンスで比較できます。
riplaはフルスクラッチ受託と国内運用保守の立場から、対応範囲を曖昧にしない要件定義の整理を支援し、契約後の隠れコストを未然に防ぐお手伝いをしています。要件定義の精度こそが、健全なベンダー選定の前提条件です。
見抜くために確認したいのは、次の2点です。
- SLAと工数:保証型か努力目標型か、月内の対応工数に上限があるか
- 対応範囲と料金:24時間対応や原因調査・復旧が基本料金に入るか、ツールのライセンス費が別途請求されないか
まとめ
RFPと要件定義を過不足なく組み立てるには、監視の範囲と水準、対応範囲を、数値を添えて押さえることが欠かせません。監視項目と閾値を一覧にし、SLAの数値を定めたうえで、クラウド責任共有を前提にした監視範囲と対応範囲の線引きを決めると、過不足がなくなります。
本文では、稼働率99.9%と99.99%の許容ダウンタイムの違いや、官公庁仕様の1時間以内報告・4時間以内復旧といった具体例も示しました。
費用相場を月5万〜20万円といった数値で押さえておくと、各社の提案を同じ土俵で比較できるようになります。
要件定義では、「とにかく手厚く」よりも、自社のシステムの事業影響度に照らして必要な水準を数値で見極めることが大切です。
過剰なSLAは費用を膨らませ、曖昧な対応範囲は隠れコストを生みます。まずは監視項目の一覧化から着手し、SLAと対応範囲を数値で固めていってください。
riplaはフルスクラッチ受託と国内運用保守を組み合わせ、過不足のない要件定義とベンダー選定を一貫して支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。